무료 이미지 역검색
무료 이미지 역검색은 텍스트 키워드 대신 사진 자체를 단서로 삼아 웹에서 같거나 닮은 이미지를 찾는 방식입니다. FaceCheck.ID처럼 얼굴에 특화된 검색 엔진은 여기에 한 단계 더 들어가, 단순한 픽셀 유사도가 아니라 얼굴 특징을 기준으로 같은 사람이 등장한 페이지를 찾아냅니다.
일반 이미지 역검색과 얼굴 검색의 차이
구글 이미지, Bing, Yandex 같은 일반 역검색 엔진은 색상, 형태, 텍스처, 그리고 그 이미지가 포함된 페이지의 텍스트 맥락을 함께 본다. 그래서 똑같은 파일이 여러 사이트에 복사된 경우는 잘 잡지만, 다른 옷, 다른 조명, 다른 각도에서 찍힌 같은 사람은 잘 못 찾는다.
얼굴 검색은 다르게 작동한다. 사진에서 얼굴을 잘라내고, 눈 사이 거리, 코의 형태, 턱선 같은 기하학적 특징을 벡터로 변환한 뒤, 인덱싱된 얼굴들과 그 벡터를 비교한다. 그 결과 다음과 같은 일이 가능해진다.
- 한 사람의 여러 다른 사진을 찾아냄(같은 파일이 아니어도)
- 수년 전 사진과 최근 사진을 같은 인물로 연결
- 닉네임이나 이름이 다른 여러 SNS 계정을 같은 얼굴로 묶음
얼굴 기반 무료 검색의 실제 활용
얼굴 검색은 단순한 이미지 출처 찾기를 넘어선다.
- 로맨스 스캠 확인: 데이팅 앱이나 카카오톡, 인스타 DM에서 만난 상대의 사진이 다른 이름으로 다른 곳에 올라와 있는지 확인
- 캣피싱 점검: 프로필 사진이 모델, 군인, 의사 등 무관한 사람의 도용 사진인지 확인
- 익명 계정 추적: 가해성 글을 올리는 익명 프로필이 본인 SNS와 연결되는지 검토
- 자기 얼굴 점검: 본인 사진이 동의 없이 광고, 사기성 페이지, 성인 사이트에 쓰였는지 확인
- 실종자 또는 미상 인물 단서 찾기: 공개 게시물 범위 안에서 동일 얼굴의 다른 등장 페이지 탐색
일반 역검색은 “이 사진이 어디 쓰였나”를 답하지만, 얼굴 검색은 “이 사람이 어디 등장하는가”에 답한다.
결과 해석에서 흔한 오해
무료라는 점 때문에 가볍게 다루기 쉽지만, 얼굴 매칭 결과는 신중하게 읽어야 한다.
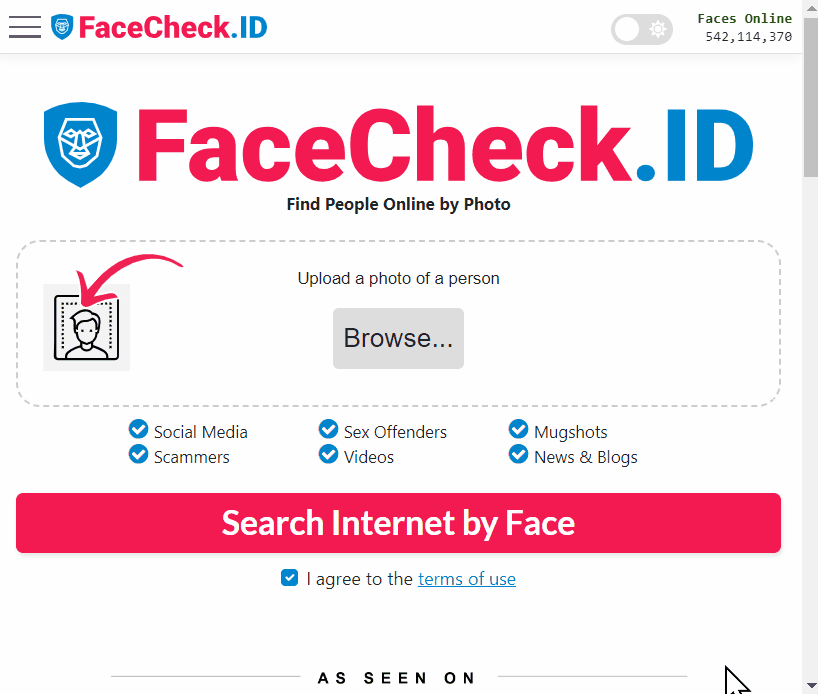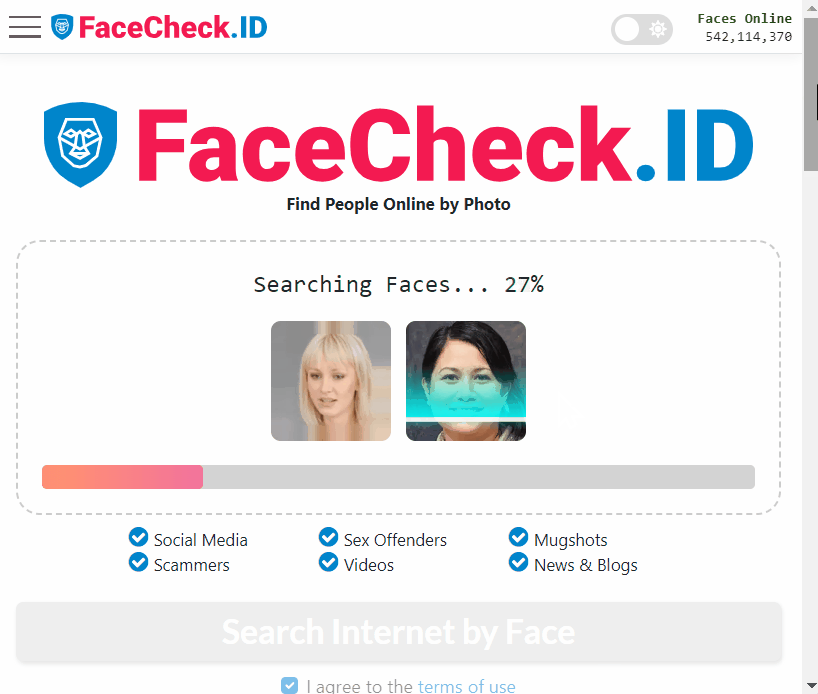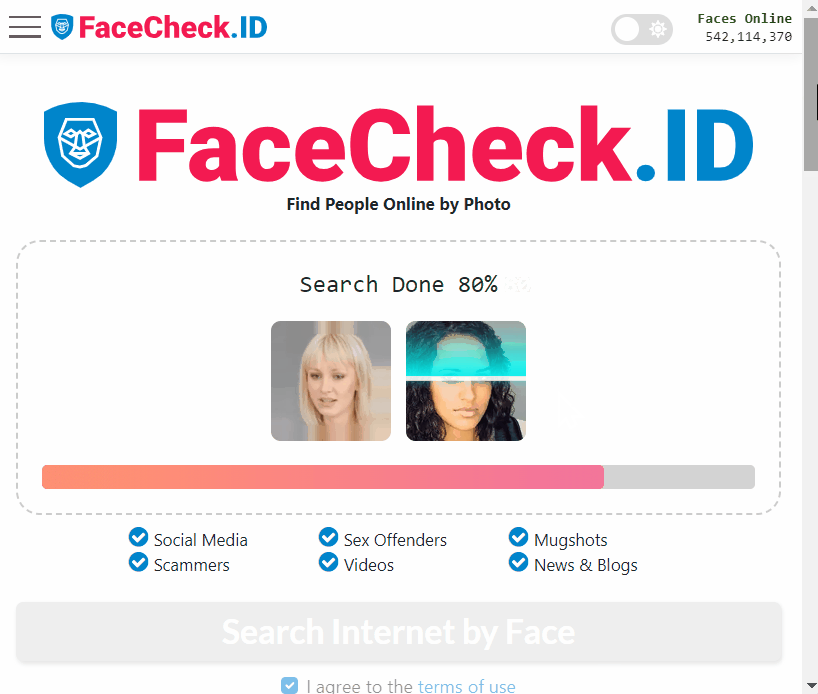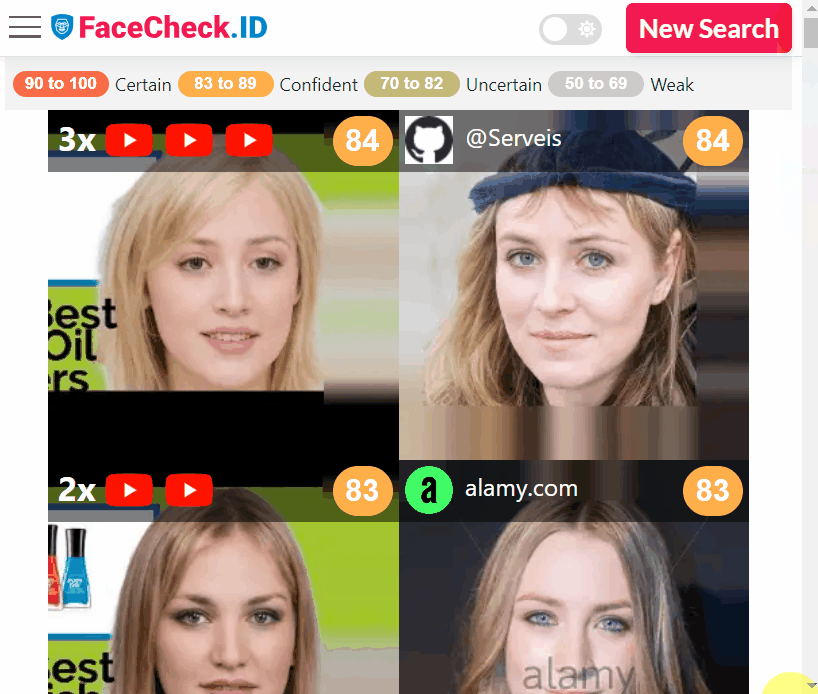
- 매칭 점수는 확률이다. 점수가 높다고 해서 동일 인물이 100% 보장되는 것은 아니며, 점수가 낮다고 무조건 다른 사람이라고 단정할 수도 없다.
- 닮은꼴은 생각보다 흔하다. 형제, 자매, 우연한 닮은꼴이 상위 결과로 올라올 수 있다.
- 이미지 품질이 결과를 좌우한다. 정면, 양호한 조명, 가림 없는 얼굴이 가장 안정적인 결과를 낸다. 옆모습, 마스크 착용, 저해상도, 강한 필터는 매칭률을 떨어뜨린다.
- 공개 인덱스에 있는 페이지만 검색된다. 비공개 계정, 폐쇄형 커뮤니티, 다크웹의 일부 영역은 결과에 반영되지 않는다.
- 같은 사진이 여러 곳에 재업로드되어 있으면 다중 결과가 단일 사실로 보이기도 한다. 출처가 같은 한 장의 사진이 10개 페이지에 퍼진 것일 수 있다.
무료 검색이 증명하는 것과 증명하지 못하는 것
얼굴 역검색은 실마리를 제공하는 도구이지, 신원 확인 도장이 아니다. 결과는 “이 얼굴이 이 페이지에 등장한다”는 사실만 보여주며, 그 페이지의 이름, 직업, 거주지 같은 서술 정보가 진짜인지는 별개의 문제다. 사기범도 진짜 이름으로 SNS를 쓸 수 있고, 결백한 사람도 도용된 프로필의 피해자일 수 있다.
조사 목적으로 쓸 때는 얼굴 매칭을 여러 단서 중 하나로 다루는 것이 안전하다. 동일 얼굴이 등장한 페이지들의 게시 시점, 작성 패턴, 다른 사진과의 일관성, 상호 연결되는 계정 정보를 함께 봐야 의미 있는 결론에 가까워진다. 무료 도구로 단서를 모으고, 판단은 사람이 한다는 원칙을 잊지 않는 것이 좋다.
자주 묻는 질문
“무료 이미지 역검색”에서 ‘무료’는 정확히 무엇을 뜻하나요? (얼굴 인식 검색엔진 기준)
대개 ‘기본 검색(일정 횟수/낮은 해상도/일부 결과)’만 무료이고, 전체 결과 열람·고급 필터·대량 조회·알림/모니터링 같은 기능은 유료(프리미엄/크레딧)인 경우가 많습니다. 또한 “무료”라도 검색 속도 제한(대기열), 결과 일부 가림, 워터마크, 계정 생성 요구 등 ‘비금전적 비용’이 붙을 수 있어 약관과 표시 범위를 확인하는 것이 안전합니다.
무료 얼굴 이미지 역검색 도구들 사이에서 결과 품질 차이가 크게 나는 이유는 무엇인가요?
주로 (1) 어떤 웹/도메인을 얼마나 넓게 수집·색인하는지(커버리지), (2) 얼굴 검출·정렬·품질평가·임베딩 생성 같은 전처리 품질, (3) 매칭 임계값/민감도 튜닝, (4) 중복 제거·클러스터링·스팸/스크랩 사이트 처리 같은 후처리, (5) 결과 랭킹(정렬) 로직 차이 때문에 품질 격차가 생깁니다. 무료 서비스는 계산비용을 줄이기 위해 검색 범위나 정밀도를 보수적으로 운영하는 경우도 있습니다.
무료 이미지 역검색에 올리는 얼굴 사진은 어떤 형태가 ‘최소 노출’에 유리한가요?
검색 정확도를 크게 해치지 않는 범위에서 ‘얼굴만’ 포함하도록 타이트하게 크롭하고, 배경의 위치·차량번호·명찰·문서·아이 이름 같은 부가 식별정보는 가리거나 제거하는 것이 좋습니다. 가능하면 EXIF(촬영 위치/시간 등 메타데이터)를 제거한 사본을 사용하고, 본인·피해자 보호가 필요한 상황이라면 원본을 그대로 업로드하지 말고 ‘필요 최소한’만 제출하는 원칙을 권장합니다.
무료 이미지 역검색 결과에서 ‘원본 출처(최초 게시물)’를 찾으려면 무엇을 우선 확인해야 하나요?
먼저 결과 목록에서 가장 오래돼 보이는 날짜/맥락이 아니라, 실제로는 (1) 동일 이미지 파일의 해상도·워터마크 유무·크롭 여부, (2) 페이지 게시일/수정일과 이미지 파일 경로(예: CDN, 캐시, 리사이즈 버전), (3) 같은 이미지가 반복되는 스크랩/집계 사이트인지 여부를 확인해 ‘2차 유통 페이지’를 걸러야 합니다. 그런 다음 원문 링크, 작성자 계정, 원본 업로드 플랫폼(뉴스/블로그/포럼 등)으로 거슬러 올라가 교차검증하는 방식이 안전합니다.
FaceCheck.ID 같은 얼굴 인식 역검색 서비스를 ‘무료 이미지 역검색’과 함께 쓸 때, 가장 현실적인 조합은 무엇인가요?
실무적으로는 1) 일반 무료 역검색(동일 사진/재업로드 출처 추적에 강점)으로 원본·재게시 경로를 먼저 넓게 훑고, 2) 얼굴 인식 검색엔진(예: FaceCheck.ID)으로 ‘같은 사람의 다른 사진’ 후보를 추가로 확보한 뒤, 3) 두 경로에서 나온 링크들을 서로 교차 대조해 중복·오탐·스크랩을 정리하는 흐름이 효율적입니다. 다만 FaceCheck.ID를 포함해 얼굴 인식 결과는 ‘동일인 확정’이 아니라 ‘후보 단서’로만 다루고, 최종 판단은 페이지 맥락(프로필 정보·게시 이력·다른 사진·원문 출처)으로 검증하는 방식이 안전합니다.
무료-이미지-역검색 관련 추천 게시물
-
Yandex에서 이미지 역검색하는 방법(그리고 Google과의 차이점)
무료 서비스를 비교하고 있다면 무료 이미지 역검색 도구 목록에서 다른 선택지도 확인할 수 있습니다.