人脸识别系统:工作原理、最佳开源模型与生产级 API
如果你正在构建任何需要匹配人脸、通过照片验证身份,或在数据集中搜索某张人脸的应用,就必须了解现代人脸识别在底层究竟如何工作。不是营销宣传中的版本,而是从原始像素到编码个人独特面部几何特征的 512 维嵌入向量这一完整流程。
本文将拆解完整的人脸识别流程,比较 2026 年最佳的开源模型,展示真实的性能数据,并说明何时适合自行构建系统,何时更适合使用生产级 API。
在这篇文章中,我们将要讨论
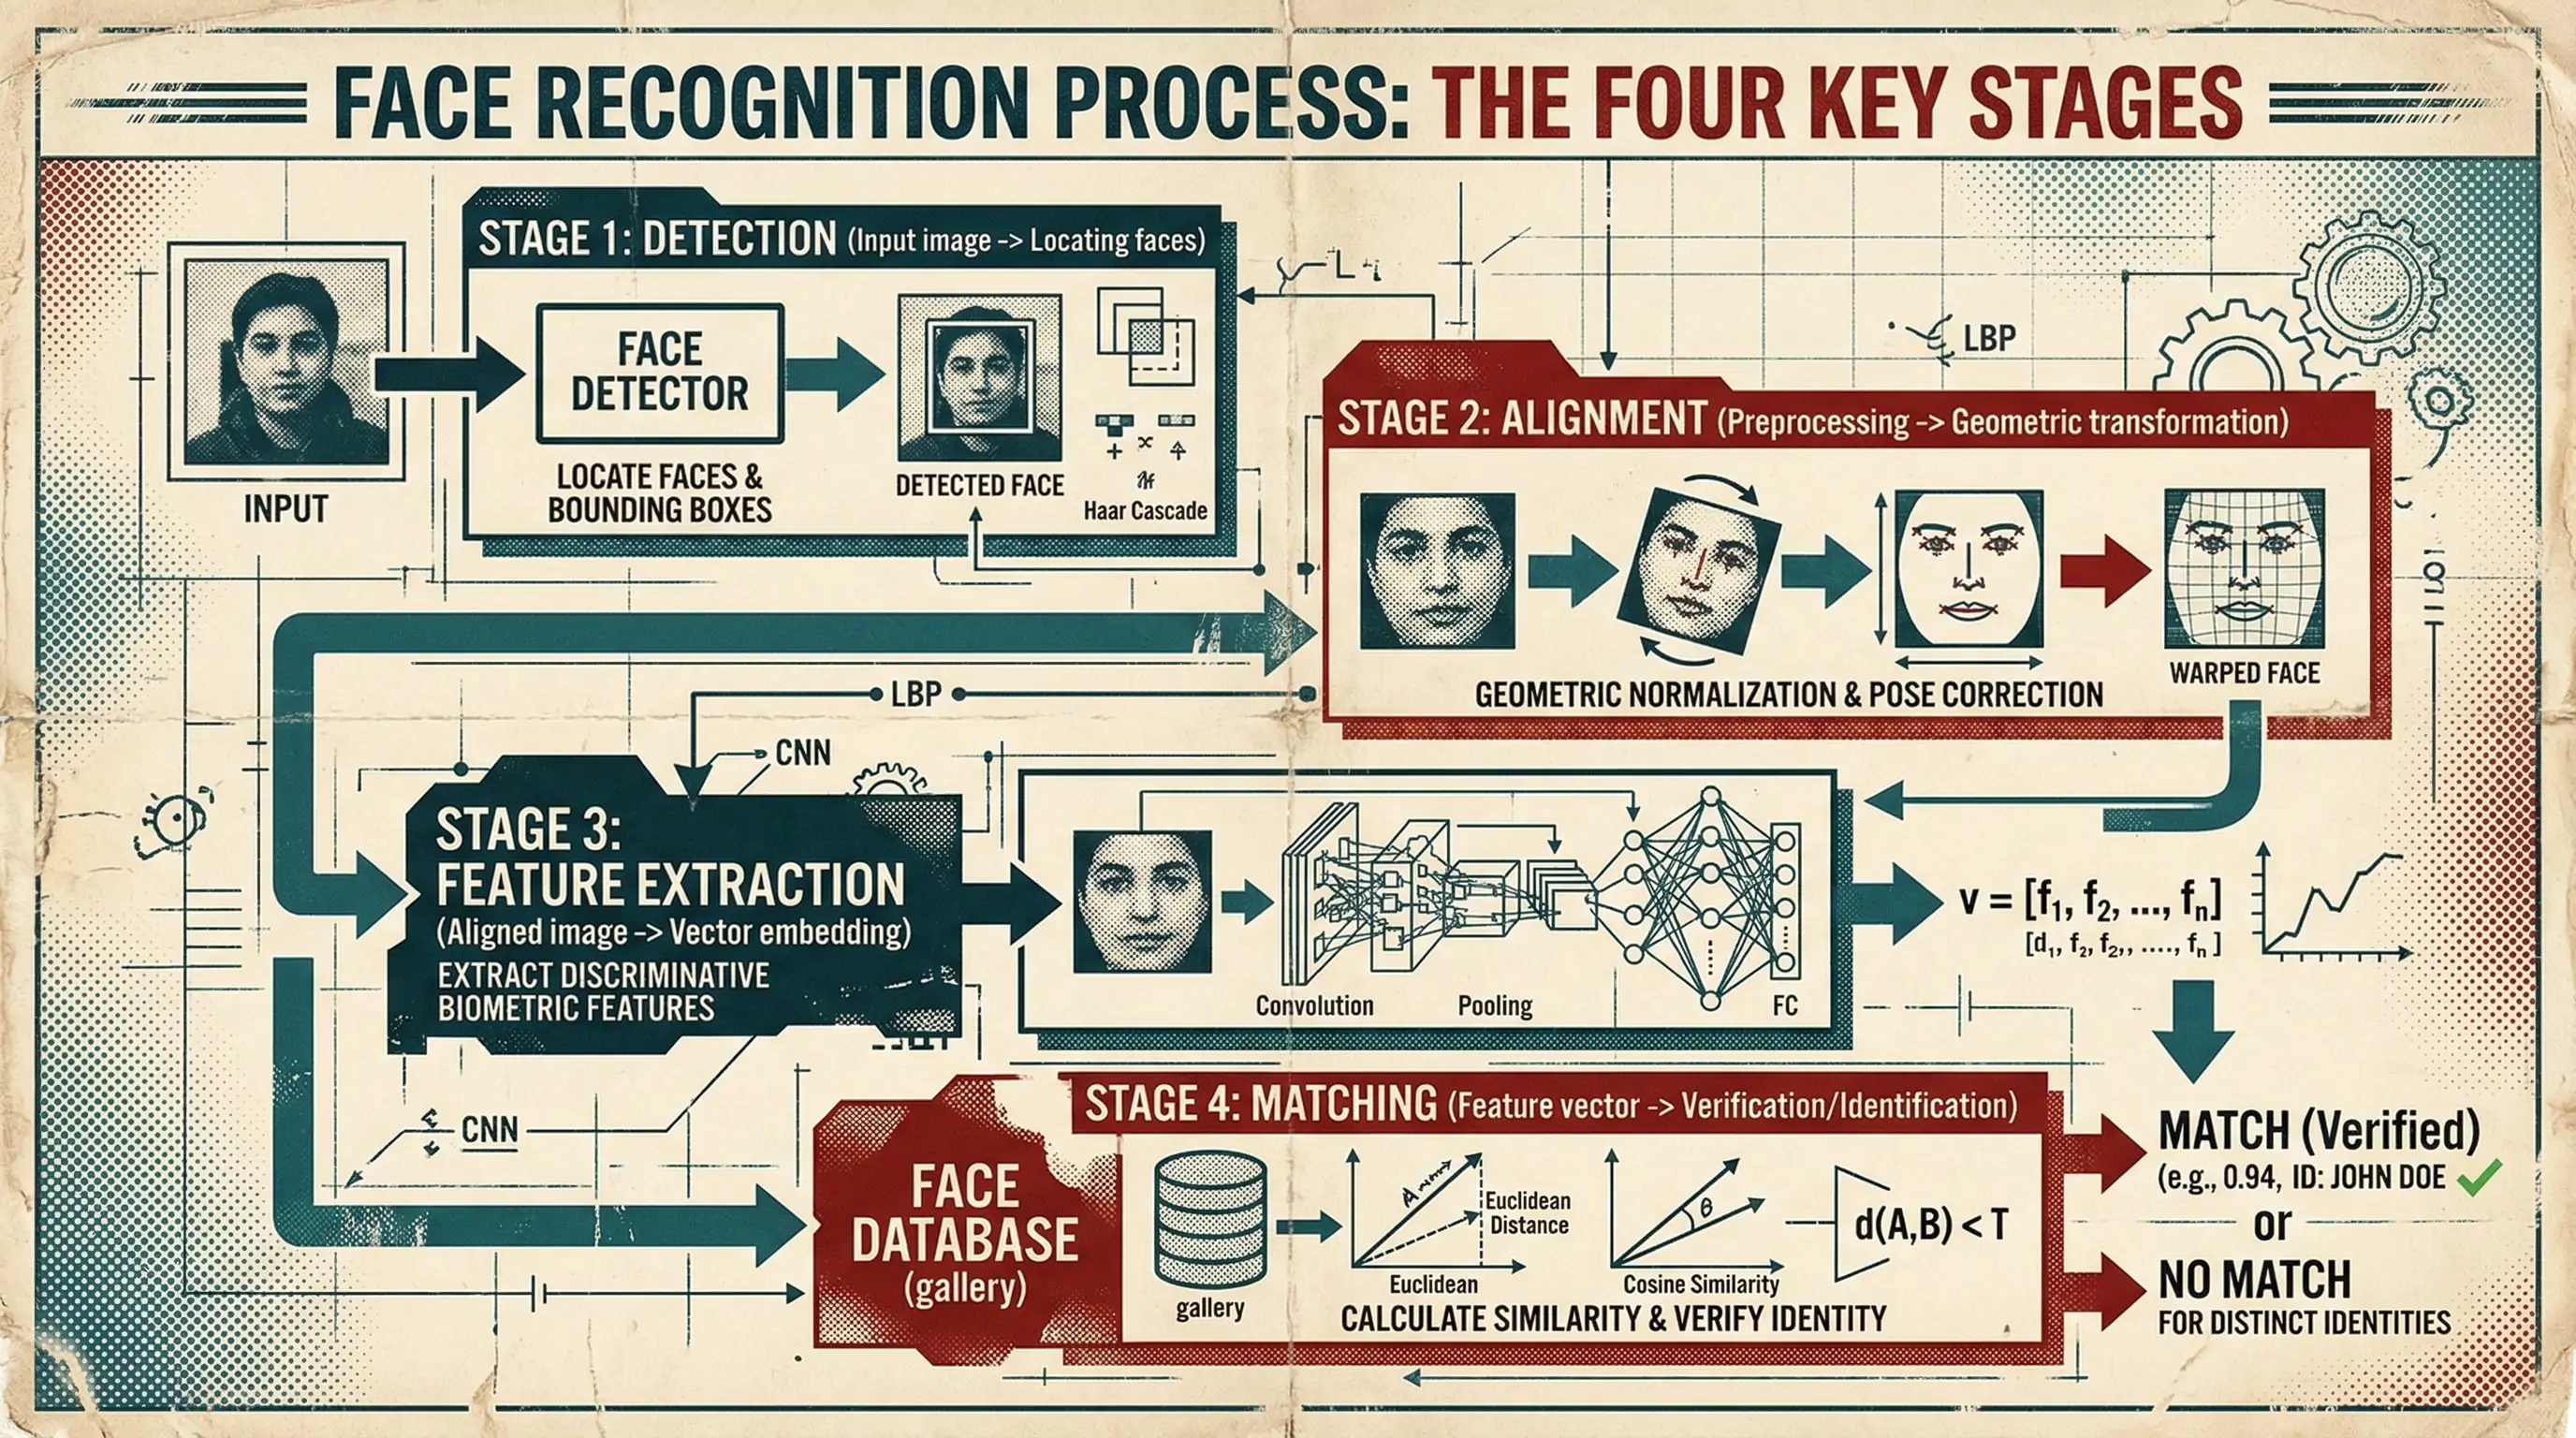
人脸识别流程:四个阶段
每个现代人脸识别系统都遵循相同的基本流程,无论它运行在一台 35 美元的 Raspberry Pi 上,还是运行在政府机构的 GPU 集群中。理解这四个阶段,有助于你评估任何模型或 API。
阶段 1:人脸检测
在识别人脸之前,首先要找到它。人脸检测接收一张图像,并输出其中每张人脸周围的边界框。这听起来很简单,但许多系统正是在这一环节的生产环境中失败。
标准模型:
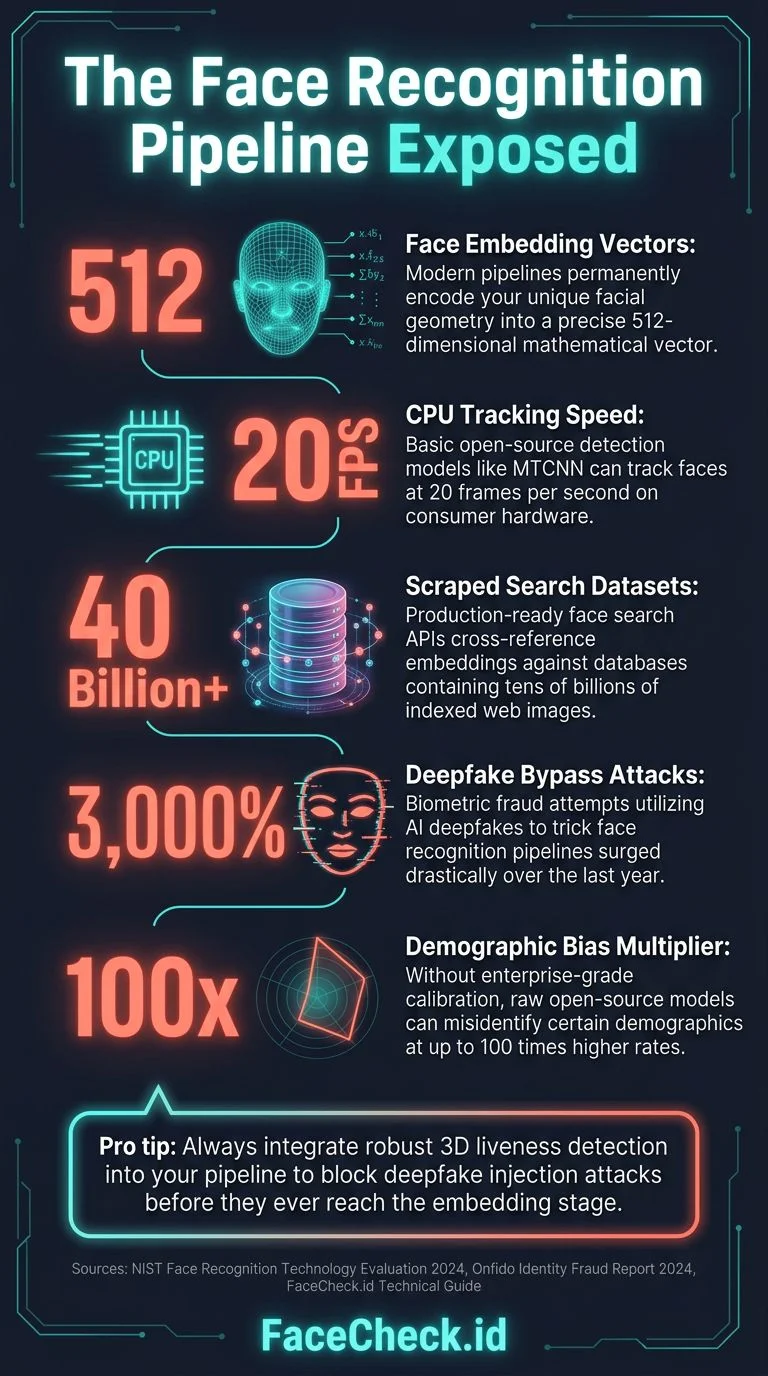
- MTCNN(多任务级联卷积网络):自 2016 年以来一直是人脸检测的主力模型。它采用三级级联结构:候选网络(P-Net)寻找候选区域,精炼网络(R-Net)过滤误报,输出网络(O-Net)优化边界框并输出面部关键点。至今仍被广泛使用。对正面人脸准确,但难以处理极端角度和遮挡。在现代 CPU 上约可达到 20 FPS。
- RetinaFace:检测准确率方面的顶尖模型。它是基于[特征金字塔网络](https://arxiv.org/abs/1612.03144)骨干构建的单阶段检测器。除边界框外,还会返回五个面部关键点(双眼、鼻子和嘴角)。能很好地处理多种尺度。如果准确率比速度更重要,它通常是首选。在 GPU 上约为 15 FPS,在 CPU 上更慢。
- SCRFD(用于高效人脸检测的样本与计算重分配):速度冠军。专为移动端和边缘部署设计,能以 RetinaFace 级别的准确率达到其 3 至 10 倍的速度。提供从 50 万到 3,400 万参数的多种模型规模。如果要部署到移动端或需要实时处理,这正是你需要的模型。
- BlazeFace:Google 推出的模型,专为 [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide) 设计。速度极快(在移动 GPU 上可达到 200 FPS 以上),但会牺牲一些困难角度下的准确率。适合需要处理每一帧的实时视频应用。
检测中真正重要的因素: 困难案例并不是光线良好的自拍照,而是监控录像、脸宽只有 50 像素的合照、极端侧脸,以及被太阳镜或口罩部分遮挡的人脸。检测模型决定了整个系统的性能上限。如果检测阶段漏掉一张脸,后续任何处理都无法弥补。
多人脸问题: 当图像中包含多张人脸时,你需要决定对哪张脸生成嵌入。可选策略包括选择最大的人脸、最居中的人脸、质量分数最高的人脸,或者对所有人脸生成嵌入并交由下游逻辑处理。每种选择都有不同的失败模式。对合照中的所有人脸生成嵌入会导致索引膨胀和搜索结果含糊;只选择最大的人脸则会漏掉站在后排的人。大多数生产系统会对高于最小尺寸阈值的所有检测人脸生成嵌入(通常要求双眼之间为 40 至 60 像素),并将它们作为独立条目关联到同一张源图像。
将人脸质量评分作为把关机制: 在计算昂贵的嵌入之前,运行 SER-FIQ 或 MagFace 的质量分支等轻量级质量评估器,可以阻止垃圾数据进入索引。模糊裁剪、严重遮挡和过曝人脸都会生成低置信度嵌入,从而污染搜索结果。在检测阶段拒绝低于质量阈值的人脸,能显著提高下游精确率并节省 GPU 计算资源。这是整个流程中投资回报率最高的优化之一。
用于身份验证的人脸防伪: 在验证场景中,呈现攻击检测(PAD)至关重要。纸质照片、屏幕回放和 3D 面具都可能欺骗基于嵌入的系统。CDCN 或 PatchNet 等模型可以检测这些攻击,但每张人脸会增加 5 至 15 毫秒延迟,并需要额外的模型维护。如果你构建的应用允许用户控制输入图像,例如门禁、KYC 或身份认证,就必须加入防伪功能,否则系统必然会被利用。
阶段 2:人脸对齐
检测到人脸后,需要对其进行标准化。不同头部姿态、相机角度和拍摄距离都会改变人脸在原始图像中的外观。对齐会将每张检测到的人脸转换到标准化位置:双眼水平、面部居中、尺度一致。
标准方法使用检测阶段得到的五个关键点(左眼、右眼、鼻尖、左嘴角、右嘴角)计算相似变换。该变换会将检测到的人脸映射为 160x160 像素的标准裁剪图,并将双眼放在固定像素坐标上。
教程经常忽略这一步,但它至关重要。对齐中仅 2 度的旋转误差,就可能让识别准确率下降 1% 至 3%。大多数开源流程会自动完成对齐,但如果你要自行构建,请使用 FaceNet 的对齐规范(160x160、指定眼部坐标)作为标准。大多数现代模型都是按这一规范训练的。
对齐对关键点准确率的敏感性: RetinaFace 的关键点平均约有 2 像素误差。该误差会沿对齐变换传播,导致准确率下降 1% 至 5%,尤其是在较小的人脸裁剪图中,因为 2 像素占整张脸宽度的比例更大。一些生产系统会在初始检测后运行二次的 68 点或 98 点关键点优化,例如 Adrian Bulat 的 face-alignment,以实现更精确的对齐。当使用场景要求最高准确率时,每张人脸额外增加的 3 至 5 毫秒是值得的,尤其是在一次错误判断就会造成后果的 1:1 验证中。
阶段 3:特征提取(嵌入)
这是人脸识别的核心。深度神经网络接收对齐后的人脸图像,并输出一个固定长度的向量(通常为 512 维),称为嵌入或特征向量。该向量是对这张脸独特特征的紧凑数值表示。
同一个人的两张脸,无论光照、表情、年龄(在合理范围内)或相机如何变化,都应在向量空间中产生彼此接近的嵌入。不同的人则应产生相距较远的嵌入。
技术原理:
网络架构通常是经过修改的 Inception-ResNet 或 ResNet,并使用数百万张人脸图像进行训练。真正的关键创新在于训练时使用的损失函数,而不是架构本身。
- Softmax 损失(基线):将人脸识别视为分类问题。它能够工作,但生成的嵌入在角度空间中分离得不够好,如今在人脸识别中已基本淘汰。
- 三元组损失:FaceNet 推广的方法。网络通过比较锚点、正样本和负样本组成的人脸三元组进行学习,让同一身份的嵌入更接近,不同身份的嵌入更远。训练时需要谨慎挖掘困难三元组,能够生成区分度很高的嵌入。
- ArcFace 损失:截至 2026 年,可以说是生产级人脸识别系统中使用最广泛的损失函数。它在特征向量与相应类别权重之间的角度空间中加入加性角度间隔惩罚,与余弦间隔方法相比,能产生更紧密的类内聚类和更宽的类间距离。[InsightFace](https://github.com/deepinsight/insightface) 项目提供了参考实现,大多数顶尖模型都使用 ArcFace 或其变体进行训练,例如 AdaFace 的自适应间隔就是建立在 ArcFace 公式之上的。如果你要训练或微调自己的人脸识别模型,ArcFace 是默认起点。
- CosFace 损失:向 Softmax 损失加入余弦间隔,迫使网络生成同一身份内部聚类更紧密、不同身份之间分离更明显的嵌入。
- SphereFace / A-Softmax:2017 年提出的原始角度间隔方法。具有重要历史意义,但已基本被 ArcFace 和更现代的损失函数取代。
输出: 一个包含 512 个浮点数并通过 L2 归一化映射到单位超球面的向量。一张脸的全部信息被压缩为 2KB 数据,随后被存储、索引和比较。
归一化陷阱: 许多开发者忘记在比较前对嵌入进行 L2 归一化。未经归一化的嵌入会产生极不一致的相似度分数。这是一个很难诊断的常见错误,因为它“基本可用”:测试时匹配结果的相对顺序可能看起来正确,但绝对相似度分数会随图像漂移,导致基于阈值的决策不可靠。FaceNet512 默认生成归一化嵌入,但如果使用自定义模型或通过 ONNX 导出,务必验证输出嵌入位于单位超球面上,即其 L2 范数等于 1.0。
生产部署:ONNX Runtime 与量化: 基准测试中的速度数据假设在干净的 GPU 环境中进行 FP32 推理。生产环境中的大多数系统会通过 ONNX Runtime 使用 INT8 量化部署,使推理时间缩短至原来的二分之一或三分之一,同时准确率损失很小(在 LFW 上通常低于 0.1%)。流程是:将 PyTorch 或 TensorFlow 模型导出为 ONNX,使用约 1,000 张人脸图像组成的校准数据集运行 ONNX Runtime 量化工具,然后部署量化后的模型。这样可以在同一硬件上将“每张脸 10 毫秒”降到“每张脸 3 至 4 毫秒”,而在处理数十亿张图像时,这一点极其重要。
混合精度推理: 在 GPU 上对骨干网络使用 FP16、对最终嵌入层使用 FP32,既可以避免本文后面提到的浮点精度问题,又能获得 1.5 至 2 倍加速。这是在完整 FP32(准确但慢)和完整 FP16(快速,但可能在不同硬件上生成细微不同的嵌入)之间的实用折中方案。
用于边缘部署的嵌入蒸馏: 你可以通过知识蒸馏,训练一个较小的学生网络(如约有 100 万参数的 MobileFaceNet)来模仿 FaceNet512 的嵌入。学生模型能以 10 倍速度达到超过 95% 的准确率,因此适合无法承担 GPU 成本的移动端和边缘部署。关键在于,无须使用人脸身份标签从头训练学生模型,只需让它在无标签人脸数据上复现教师模型的嵌入,因此所需算力少得多,也不需要带身份标签的数据集。
阶段 4:匹配
给定两个人脸嵌入,如何判断它们是否属于同一个人?有两种方法:
余弦相似度: 计算两个嵌入向量夹角的余弦值。范围为 -1 到 1,其中 1 表示完全相同。根据模型和使用场景,判断“同一个人”的典型阈值为 0.4 至 0.6。它简单、快速,并且由于 FaceNet512 嵌入经过 L2 归一化,效果很好。
欧氏距离: 计算向量之间的 L2 距离。对于归一化嵌入,它在数学上等价于余弦相似度(d = sqrt(2 - 2*cos_sim))。一些系统更偏好这种表达方式。
用于搜索(1:N 匹配): 当你需要在包含数百万张人脸的数据库中查找某张脸时,暴力比较速度太慢。应使用近似最近邻(ANN)搜索:
- FAISS(Facebook AI 相似度搜索):标准工具库。支持 GPU 加速及多种索引类型(IVF、HNSW、PQ),能在数毫秒内搜索 10 亿个向量。免费且开源。
- Milvus:专门构建的向量数据库,底层使用 FAISS,并增加了持久化、扩展和 API 层。
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/):如果不想自行运行基础设施,可以选择这些托管向量数据库。
对于包含 1,000 万张人脸的数据库,在单个 GPU 上经过良好调优的 FAISS HNSW 索引,可以在 5 毫秒内返回前 10 个匹配结果。
FAISS 索引类型的选择极其重要。 IVF-PQ 提供出色的压缩效果(每个向量仅占 8 至 16 字节,而非 2KB),但对于临界匹配会损失准确率,因为量化误差可能将真实匹配推到阈值以下。HNSW 能保持准确率,但由于要存储完整浮点向量和图结构,会多使用 4 至 8 倍内存。对于 1,000 万至 10 亿规模的数据,IVF-HNSW 混合索引能提供最佳平衡。大多数团队最初会根据教程推荐选择错误的索引类型,直到 6 个月后遇到限制,才不得不重建整套索引基础设施。在确定索引类型之前,应使用真实的数据量和查询模式测试你的具体工作负载。
ANN 索引的冷启动问题: HNSW 和 IVF 索引需要达到最低向量数量才能良好运作。当向量少于约 1 万个时,暴力搜索实际上比索引搜索更快,因为索引开销(图遍历、质心比较)超过了计算本身。在早期增长阶段应从暴力搜索(FAISS IndexFlatIP)开始,等数据库超过 5 万至 10 万个向量后再迁移到 ANN 索引。
使用二进制编码进行预筛选: 为每个嵌入计算二进制哈希(通过二值化或 SimHash),可以在昂贵的浮点比较前先进行低成本的汉明距离预筛选。这样能在召回率损失很小的情况下,将候选集缩小 90% 以上。具体方法是:在每个完整嵌入旁存储一个 256 位或 512 位二进制编码。查询时,先计算查询编码与所有二进制编码之间的汉明距离(使用 CPU POPCNT 指令可极快完成),选取排名前 1% 至 5% 的候选项,再仅对这些候选项计算精确余弦相似度。当数据集超过可用 GPU 显存时,这种两阶段方法尤其有效。
使用人脸属性进行重排序: 初始嵌入搜索返回候选项后,第二轮可使用估计属性(年龄范围、性别、肤色、面部毛发)过滤明显的错误匹配。如果查询人脸被估计为一名 25 岁女性,而候选匹配被估计为一名 60 岁男性,那么无论嵌入相似度分数多高,几乎都可以确定是误报。这种简单启发式方法只需极少计算成本,就能减少 30% 至 50% 的误报,是生产级人脸搜索中最未被充分利用的技术之一。
视频中的时间一致性: 如果匹配的是视频而非静态图像,对同一跟踪人脸在多帧中的嵌入求平均,可以显著提高准确率(在困难基准上通常提高 5% 至 10%)。轨迹级嵌入聚合严格优于帧级匹配。具体方法是:使用人脸跟踪器(如 SORT 或 DeepSORT)关联跨帧检测结果,为每次检测计算嵌入,然后利用质量加权平均将它们聚合成单个“轨迹嵌入”,其中质量权重来自检测阶段的人脸质量分数。
最佳开源人脸识别模型(2026 年)
FaceNet512
黄金标准。 FaceNet512 是 Google FaceNet 架构的 512 维嵌入变体,与原始的 128 维版本相比,提供更大、区分能力更强的嵌入空间。
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- 架构:Inception-ResNet-v2 骨干网络,生成 512 维嵌入
- 许可证:MIT(宽松许可证,允许商业使用)
- LFW 准确率:99.65%
- 嵌入大小:512 维
- 包含内容:可配合标准检测流程(MTCNN、[RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface))实现端到端识别
- Python API:可通过
deepface库或独立实现使用
结论: 如果你要在 2026 年构建人脸识别系统,FaceNet512 是一个可靠起点。它准确率出色,512 维嵌入具有很强的区分能力,采用宽松的 MIT 许可证,并拥有广泛的生态支持。
FaceNet(Google,原始 128 维版本)
这款模型在 2015 年推广了嵌入方法。它引入了三元组损失训练,让网络通过比较锚点、正样本和负样本组成的人脸三元组进行学习。
- 原始论文:"FaceNet:用于人脸识别与聚类的统一嵌入"(Schroff 等,2015 年)
- 代码仓库:有多个实现(davidsandberg/facenet 是经典的 TensorFlow 版本)
- 许可证:MIT
- LFW 准确率:99.63%(原始版本),使用现代训练方法最高可达 99.75%
- 嵌入大小:128 维
- 架构:Inception-ResNet-v1 或 Inception-ResNet-v2
结论: 它在历史上非常重要,至今仍表现良好。128 维嵌入更紧凑,但区分能力略低于 512 维的 FaceNet512 变体。如果你需要更小的嵌入存储空间,或在有内存限制的 TensorFlow 环境中工作,可以使用它。
DeepFace(Facebook/Meta)
不要将它与 Python 库 deepface(小写)混淆。Meta 的 DeepFace(2014 年)是最早使用深度学习进行人脸识别的方法之一,在 LFW 上达到了接近人类的准确率。
如今更相关的项目是 Serengil 开发的 deepface Python 库:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- 代码仓库:github.com/serengil/deepface
- 许可证:MIT
- 功能:封装库,通过统一 API 支持多个后端模型,包括 FaceNet512、FaceNet、VGG-Face、OpenFace、DeepID、Dlib、SFace
- 包含内容:身份验证、搜索、面部属性分析(年龄、性别、种族、情绪)
- 易用性:API 极其简单
结论: 原型开发和实验的最佳选择。统一 API 让你只需更改一个参数即可切换模型。在生产环境中,若要获得更高性能和更强控制能力,最好直接使用 FaceNet512。
dlib
这是由 Davis King 维护、带有 Python 绑定的 C++ 库,其中包含一个使用 300 万张图像数据集训练的人脸识别模型。
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- 代码仓库:github.com/davisking/dlib
- 许可证:Boost 软件许可证(宽松许可证)
- LFW 准确率:99.38%
- 嵌入大小:128 维
- 检测方式:基于 HOG(快速、适合 CPU)和基于 CNN(更准确)
结论: 非常稳定,经过实战验证的 C++ 实现,并提供优秀的 Python 绑定。准确率低于 FaceNet512,但可靠性极高。如果你使用 C++,或需要不依赖 PyTorch/ONNX 的轻量级解决方案,它是不错的选择。
AdaFace
这是一款较新的模型(2022 年),专门解决图像质量差异问题。标准模型使用高质量图像训练,在低分辨率或模糊输入上性能会下降。AdaFace 会在训练期间根据图像质量调整间隔惩罚。
- 代码仓库:github.com/mk-minchul/AdaFace
- 许可证:MIT
- 主要优势:在低质量图像(监控、远距离摄像头)上表现更好
- LFW 准确率:99.82%
- IJB-C TAR@FAR=1e-4:97.39%(在困难基准上优于大多数开源模型)
结论: 当输入图像质量较低时应使用它。对于监控、闭路电视分析或任何无法控制图像质量的场景,AdaFace 的效果明显优于标准模型。
性能对比表
| 模型 | LFW(%) | 嵌入 | 速度(毫秒/张脸) | 许可证 |
|---|---|---|---|---|
| FaceNet512(IR-v2) | 99.65 | 512 维 | 约 10 毫秒(GPU) | MIT |
| FaceNet(IR-v1) | 99.63 | 128 维 | 约 12 毫秒(GPU) | MIT |
| AdaFace(R100) | 99.82 | 512 维 | 约 9 毫秒(GPU) | MIT |
| dlib ResNet | 99.38 | 128 维 | 约 25 毫秒(CPU) | Boost |
| VGG-Face2 | 99.43 | 2048 维 | 约 15 毫秒(GPU) | CC BY-SA |
LFW(自然环境下的标注人脸)是标准基准,但它实际上已经被攻克。所有现代模型的得分都超过 99%。真正的差异会出现在更困难的基准上,例如 IJB-C(多样化条件)和 TinyFace(低分辨率)。
关于基准与现实的说明: 这些速度数据是在 GPU 已预热的情况下,对单张人脸进行 FP32 推理所得。在生产环境中使用 ONNX Runtime INT8 量化,速度通常可提高 2 至 3 倍。但也要记住,完整流程——检测、对齐、质量评分和嵌入——所需时间是仅提取嵌入的 3 至 5 倍。在单张 A100 GPU 上,完整流程的现实端到端吞吐量为每秒 200 至 400 张人脸,而不是仅嵌入基准测试可能暗示的每秒数千张。
开源模型与生产系统之间的差距
教程不会告诉你的是:在 Jupyter notebook 中运行人脸识别模型是最容易的部分。构建一个能够大规模实际运行的生产系统,需要解决一长串任何模型都无法替你处理的工程问题。大多数团队都严重低估了成本和时间。一个看似“把模型接上就行”的项目,最终会变成耗时 12 至 24 个月的工程,并且在准备投入生产前就可能轻易消耗 50 万至 200 多万美元,这还不包括持续运营成本。
基础设施账单
用于提取嵌入的 GPU 算力。 在数十亿张图像上运行人脸检测和嵌入提取,不可能用笔记本电脑完成。一张 NVIDIA A100 GPU 通过完整的检测、对齐和嵌入流程,每秒大约能处理 200 至 400 张人脸。若要在合理时间内处理 10 亿张图像(例如一周以内),需要由 40 至 80 张 GPU 组成的集群持续运行。按云服务价格计算,每轮处理需要 5 万至 15 万美元;随着模型改进或流程变更,你还需要重新处理。直接购买硬件则意味着投入 30 万至 80 万美元购置 GPU 服务器,此外还要承担机架空间、电力、散热以及维护人员的成本。
大规模存储。 10 亿个人脸嵌入,每个包含 512 个浮点数(2KB),仅向量数据就约为 2TB。再加上原始图像、缩略图、元数据和索引结构,总存储量会达到数百 TB 乃至数 PB。云端用于向量索引的高性能 NVMe 存储,每月每 GB 约为 0.10 至 0.25 美元。若有 50TB 热存储,仅维持运行每月就要花费 5,000 至 12,500 美元。
向量搜索基础设施。 根据索引类型和可用内存,FAISS 在单台机器上的上限约为 1 亿至 5 亿个向量。超过这个规模后,就需要跨多个分片进行分布式搜索,并配置负载均衡、容错副本以及足够的内存来容纳索引。面向 10 亿以上向量的生产级分布式 FAISS 或 Milvus 部署,通常需要 8 至 16 台大内存机器(每台至少 256GB 内存),云计算成本每月为 1.5 万至 4 万美元。
网络与带宽。 抓取数十亿张图像意味着要下载数 PB 数据。主要云服务商每 GB 出站流量收费 0.05 至 0.09 美元,仅数据传输就可能花费数万美元。你还需要在爬虫、GPU 处理节点和存储后端之间配置高吞吐量内部网络。
网络级人脸搜索引擎的基础设施总成本估算: 持续云服务费用每月 3 万至 8 万美元;或者前期投入 50 万至 150 万美元购买硬件,再加上每月 1 万至 2 万美元的电力、带宽和维护费用。这还仅仅是基础设施成本,尚未计算任何工程师编写应用代码的费用。
工程时间表
构建生产级人脸搜索系统不是黑客松项目。对于由 3 至 5 名资深工程师组成的团队,现实时间表如下:
第 1 至 3 个月:核心流程。 让检测、对齐和嵌入提取稳定运行。构建基本向量索引。处理从本地文件导入图像。这是“有趣”的阶段,一切似乎进展顺利,演示效果也令人印象深刻。
第 3 至 6 个月:网络抓取基础设施。 为主要平台构建爬虫。处理速率限制、验证码、登录限制、动态渲染(大量使用 JavaScript 的网站)、图像去重和内容过滤。你会发现,每个社交媒体平台都有不同的反抓取措施,导致爬虫每周失效。还要构建监控系统,以检测爬虫何时无声失败。由于网络环境混乱且具有对抗性,仅这一阶段就可能比预期更久。
第 6 至 9 个月:扩展性与可靠性。 原型在 100 万张人脸上有效,现在要让它支持 1 亿张。你会发现 FAISS 索引已无法装入内存,于是需要实现分片。修复导入流程中的竞态条件。为下载失败的 15% 图像构建重试逻辑。处理损坏图像、声称是 JPEG 但实际不是的图像、带 EXIF 旋转标记的图像和下载不完整的图像。增加监控、告警和日志,以便系统在凌晨 3 点发生故障时你能知道。
第 9 至 12 个月:质量与准确率。 你会意识到,大规模运行时的误报率不可接受。于是实现人脸质量评分以过滤垃圾嵌入,针对不同使用场景调优阈值,并构建反馈机制,让错误匹配可以被标记和调查。随后发现由于浮点精度差异,模型在不同 GPU 架构上会产生不同结果,并花两周时间追查原因。
第 12 至 18 个月:生产加固。 构建带身份认证、速率限制和使用量追踪的 API 层。增加 GDPR/CCPA 合规功能:退出机制、数据删除请求和审计日志。实现结果缓存,构建管理工具,编写文档,处理安全审计,对所有组件进行负载测试,并修复此前不知道存在的内存泄漏。
第 18 至 24 个月:持续运营。 网站更改布局后,爬虫会失效。随着新类型图像出现,模型会发生漂移。磁盘会被写满,索引需要重建。用户会报告你从未预料到的边缘案例。有人发现系统会对卡通人脸返回高置信度匹配,于是你需要增加“真实人脸”过滤器。这些工作永远不会结束。
你将遇到的完整问题清单
除基础设施和时间外,以下是团队从头构建人脸识别系统时会遇到的所有主要问题。这些问题来自真实生产系统,而不是理论上的担忧。
数据质量噩梦:
- 垃圾进,垃圾出。 互联网上充斥着表情包、AI 生成人脸、绘画、照片翻拍、杂志封面和雕像。检测器会在其中全部找到“人脸”,并生成污染索引的嵌入。你需要分类器来过滤合成人脸、插画人脸、分辨率极低的裁剪图和非摄影内容。构建和维护这些过滤器本身就是一个项目。
- 重复和近似重复图像。 同一张照片会以不同裁剪、水印、压缩程度和颜色调整出现在数十个网站上。如果不去重,一张热门照片会生成数百个实际上来自同一图像的“匹配”,淹没真正结果。感知哈希(pHash、dHash)有所帮助,但并不完美。你需要多层去重:URL 级去重(简单)、感知哈希去重(捕获缩放和重新压缩的副本),以及嵌入级去重(捕获同一张脸从略微不同角度拍摄的照片)。每一层都能发现其他层遗漏的内容,而你花在去重上的时间会比预期更多。
- 年龄和外貌变化。 某人大学时期照片的人脸嵌入,可能无法匹配其 15 年后的照片。体重变化、衰老、整容、面部毛发和不同发型都会影响识别准确率。没有任何模型能完美处理这些变化。当系统无法跨越 20 年时间差匹配同一个人时,用户会责怪你的系统。
- 人口统计偏差。 主要使用西方人或白人数据集训练的开源模型,在其他人群上的表现更差。跨族裔准确率差距比 LFW 所显示的更大,因为 LFW 中约 77% 是白人。全球部署时,不同人口群体在困难基准上的准确率差异可达 5% 至 15%。使用 MS-Celeb-1M 训练的 FaceNet512 等模型继承了该数据集的人口偏差。为了实现公平性能,应使用平衡数据集(如 BUPT-Balancedface)微调,或采用考虑人口统计特征的训练策略。如果不分别评估不同种族群体的准确率,你可能会发布一个对部分用户效果良好、对其他用户效果很差的系统。这不仅是伦理问题,也是产品质量和法律责任问题。
- EXIF 方向处理。 网络上约 15% 至 20% 的图像带有 EXIF 方向标签,如果忽略,就会导致人脸横置或上下颠倒。大多数人脸检测器无法找到旋转的人脸。这种问题在测试中很容易被忽略,因为测试图像通常方向正确,但在生产环境中会造成严重的隐性准确率损失。始终应将 EXIF 方向校正作为图像处理流程的第一步。
- 渐进式 JPEG 和 WebP 解码失败。 某些图像库在处理部分下载的渐进式 JPEG 或截断的 WebP 文件时,会无声地产生损坏的像素数据。人脸检测器可能仍会在损坏伪影中找到一张“脸”,并生成垃圾嵌入。处理前必须验证图像完整性,确认文件能够无错误解码,并且生成的像素缓冲区尺寸合理。否则,损坏图像会无声地污染索引。
最初并不明显的工程问题:
- 嵌入版本管理。 当你升级模型时——而你一定会升级,因为准确率改进很重要——数据库中的每个嵌入都会与新模型的输出不兼容。你只能选择重新为整个数据库生成嵌入(成本高、耗时长,并要求保留所有原始图像)、迁移期间运行并行索引(基础设施成本翻倍),或维持向后兼容(复杂,并限制改进能力)。不存在好的解决方案,只有相对不那么痛苦的方案。
- 浮点确定性。 同一张图像在不同 GPU 型号、不同 CUDA 版本,甚至不同批量大小下处理时,都可能因浮点运算产生略有不同的嵌入。这些差异很小(1e-6 至 1e-4),但会累积:一个匹配在一台机器上的得分可能是 0.401,在另一台上则是 0.399,从而翻转二元阈值判断。这会让调试变得极其痛苦。GPU 驱动更新尤其危险:NVIDIA 驱动更新可能在 CUDA 层改变浮点行为。使用 535.x 驱动计算的嵌入,可能与同一图像在 545.x 驱动上的结果不同。在生产环境中,这意味着必须固定整个集群的驱动版本,并在每次更新后验证嵌入一致性。
- 并发与竞态条件。 多个爬虫同时导入人脸,用户在索引更新期间查询,删除请求在搜索结果组装过程中到达。向量数据库不像 SQL 数据库那样拥有成熟的事务支持。你会遇到人脸仅被部分索引、查询返回陈旧结果,或删除操作没有传播到所有分片的情况。
- 内存管理。 FAISS 索引采用内存映射,但查询性能高度取决于索引有多少能装入内存。随着索引增长,操作系统从内存中逐出索引页时,查询延迟会不可预测地激增。OOM 终止总会发生在最糟糕的时刻。你将不得不深入了解 Linux 内存管理、交换空间设置和 [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access) 拓扑。冷启动后的预热也是一个麻烦:FAISS HNSW 索引采用内存映射,因此服务器重启后,最初几百次查询会慢 10 至 100 倍,因为索引页尚未载入内存。你需要在接受生产流量前通过预热阶段预加载索引,否则每次部署后的第一批用户都会遭遇极差的延迟。
- 无声失败。 网站更改 HTML 后,爬虫停止工作。驱动更新后,GPU 处理节点开始生成 NaN 嵌入。磁盘写满后,新人脸无声地停止建立索引。这些故障不会抛出错误,只会悄悄降低系统质量。如果没有全面监控和异常检测,直到用户投诉前你都不会知道。
- FAISS 刷新问题。 向 IVF 索引添加新嵌入时,Voronoi 单元会变得不平衡,搜索质量逐渐下降,直到重新训练量化器。在网络规模下,重新训练意味着对完整数据集执行数小时 GPU 计算。团队通常会批量添加数据并每周或每月重新训练,这意味着新导入的人脸无法立即以完整准确率被搜索。你始终需要在时效性与搜索质量之间取舍,没有免费的午餐。
- 跨索引分片的分数校准。 当索引分布在多台机器上时,不同分片的原始相似度分数不能直接比较,因为每个分片的嵌入分布不同。要有意义地合并结果,需要按分片进行分数归一化(队列归一化、Z-norm、T-norm)。如果不校准,分片 A 的 0.45 可能代表强匹配,而分片 B 的 0.45 只代表一般匹配,合并后的结果就会不可靠。
- 分布式搜索中的扇出问题。 搜索 N 个分片意味着每次查询要进行 N 次网络往返。如果任何分片变慢(GC 暂停、磁盘 I/O 峰值、网络抖动),整个查询都会变慢。P99 延迟取决于最慢分片的 P99,而且随着分片增加会进一步恶化。对冲请求(发送重复请求并采用最先返回的结果)和自适应超时等技术,对维持可接受的尾部延迟至关重要。
准确率与匹配问题:
- 阈值调优永远不会“完成”。 随着数据库增长,最佳相似度阈值会发生变化。数据库包含 100 万张人脸时,0.45 的阈值可在精确率和召回率之间取得良好平衡;当增长到 1 亿张时,仅因为近似长相的人更多,同一阈值就会产生十倍误报。你需要自适应阈值或后处理重排序。底层数学规律毫不留情:数据库从 100 万增长到 1 亿再到 10 亿张人脸时,前 k 个相似度分数的分布会向上移动,因为存在更多近似长相的人。在 100 万张人脸时产生 0.1% 误报率的固定阈值,到 10 亿张时可能产生 10% 误报率。你需要对此分布建模并动态调整阈值,否则就只能接受精确率随规模下降。
- 开放集与封闭集识别。 大多数基准评估的是封闭集性能,即保证查询对象存在于数据库中。现实中的人脸搜索是开放集:查询人脸可能根本不在索引中。开放集评估需要完全不同的指标(固定 FPIR 下的 TPIR,而不是 Rank-1 准确率),其失败模式是错误匹配,而不是错误排序。在封闭集基准上达到 99% 的系统,部署到开放集环境后可能有 10% 的错误匹配率,因为即使真实匹配不存在,它仍会自信地返回“最接近”的人脸。正确处理“未找到匹配”与找到正确匹配同样重要。
- 相似长相和撞脸者。 在包含 1 亿以上人脸的数据库中,许多互不相关的人,其嵌入会异常接近。数据库越大,错误匹配越多。用户会经常报告“认错人”的结果。你需要制定处理策略,例如使用多张照片验证、上下文信号(姓名、地点)和人工审核队列。
- 姿态不变识别仍然困难。 即使是 FaceNet512,在偏航角超过正负 60 度后,性能也会显著下降。侧脸与正脸匹配的准确率,相比正脸与正脸匹配可能下降 10% 至 20%。在监控场景中,大多数人脸都不是正面,因此实际准确率远低于基准所显示的水平。采用三维感知增强训练的模型或 UV-GAN 等架构有所帮助,但会增加复杂性。如果输入数据中存在大量偏转角度,应将其视为首要准确率问题,而不是边缘案例。
- 对抗性输入。 用户会提交 AI 生成人脸、深度伪造、变形图像和带有故意扰动的照片。有些人是在测试系统,另一些则试图操纵结果。系统需要对这些输入具备一定鲁棒性,否则会为虚假人脸返回高置信度匹配。
- 照片修改。 滤镜、美颜应用、浓妆和修脸软件。Instagram 中的现实与真实世界并不相同。这些修改足以改变面部几何特征,从而影响嵌入相似度。经过重度滤镜处理的自拍照,可能无法匹配同一个人的未处理照片。
- 一张脸,多个嵌入。 一个人可能在不同平台、角度和年份中拥有数百张在线照片。你是将它们作为独立匹配全部返回,还是聚类为单一身份?大规模聚类(数亿张人脸)计算成本高昂,而且会引入自身的错误模式:过度合并(将两个不同的人合并)和合并不足(未能关联同一个人的照片)。
运营难题:
- 反抓取军备竞赛。 每个主要社交媒体平台都会主动阻止爬虫。它们会更改页面结构、添加验证码、检测无头浏览器、按 IP 限速、识别请求模式,有时还会提供诱饵内容。你的抓取基础设施始终处在军备竞赛中。今天有效的爬虫,下周可能就被完全封锁。维护爬虫是一项持续的工程成本,而不是一次性建设。
- 变化率建模。 不同来源的更新频率不同。名人新闻网站每小时都会出现新照片;个人社交媒体资料可能数年不变。根据历史变化率智能安排重新抓取,可以在重要位置保持索引更新的同时,将带宽成本降低 60% 至 80%。否则,你要么过度抓取静态来源,浪费带宽和资金;要么抓取动态来源不足,提供陈旧结果。
- CDN 与地理内容差异。 同一个 URL 可能会根据请求者所在位置、设备 User-Agent 或 Cookie 返回不同图像。爬虫建立索引的图像可能与用户看到的不同,从而产生令人困惑的“匹配结果与页面内容不一样”报告。某些 CDN 会先提供低分辨率占位图,直到真实浏览器将图像滚动到视口中。你必须处理这些边缘情况,否则就要接受一定比例的幽灵结果。
- 存储成本增长。 图像存储量会线性增长,而且永不停歇。如果未来可能需要重新生成嵌入,就不能删除原图。缩略图、元数据、嵌入向量、索引文件和备份副本都会不断累积。随着系统成熟,存储账单会加速增长。只为第一年存储量做预算的团队,往往会被第三年的成本震惊。
- 大规模合规请求。 GDPR 赋予个人要求删除其数据的权利。有人提交退出请求时,你需要:在整个数据库中找到由其人脸生成的所有嵌入并删除;确保爬虫再次发现原始图像时不会重新添加;并为审计目的记录删除操作。在大规模环境中,这需要专门工具和工程投入。[欧盟人工智能法案](https://artificialintelligenceact.eu/)还对包括人脸识别在内的高风险 AI 系统提出额外要求:强制合格评定、偏差测试、透明度义务和人工监督机制。
- 退出机制的实现比听起来更难。 你不能只删除嵌入,还必须防止爬虫再次遇到同一张脸时重新建立索引。这要求维护一个由已退出人脸嵌入组成的“黑名单”索引,并在写入每个新嵌入前进行检查。该黑名单本身必须足够快,因为每次插入都要查询它;同时也引发了数据保留问题:为了进行匹配,你必须永久保存已退出者的人脸嵌入,也就是说,为了满足删除请求,你反而要保留生物识别数据。这种法律矛盾真实存在,而且在许多司法辖区尚未解决。
- 公开抓取数据的同意问题。 根据 GDPR,从公开社交媒体资料处理生物识别数据是否合法,仍存在法律争议。多个欧盟数据保护机构已对人脸识别公司作出不利裁决,尤其是多个欧盟成员国针对 Clearview AI 的决定。法律风险取决于司法辖区、数据来源和使用场景。这不是假设中的未来问题,而是正在被积极执法的领域。
- 审计轨迹的存储成本。 如果记录每次搜索查询和返回的每个匹配结果——合规要求可能会强制这样做——审计日志的增长速度可能超过实际人脸数据。一个每天处理 100 万次搜索、每次返回 10 个结果的系统,每天约会生成 1,000 万条审计记录。保留期限通常根据司法辖区要求为 1 至 7 年,因此数据会持续累积。应将审计存储视为主要成本中心,而不是事后考虑。
- 事件响应。 当系统错误匹配一张脸,并且有人根据该错误结果采取行动时,该怎么办?你需要审计轨迹来说明每个结果如何生成,能够解释匹配决策,并建立处理争议的流程。当有人质疑匹配时,仅仅说“余弦相似度为 0.47,超过了 0.42 的阈值”并不能令人满意。GradCAM 等技术可以显示哪些面部区域促成了匹配,有助于解决争议并建立信任。这不仅是良好的工程实践,根据所在司法辖区,也可能是法律要求。
- 模型与依赖老化。 CUDA 版本、Python 版本、[ONNX Runtime](https://onnxruntime.ai/) 版本和操作系统更新都会随时间变化,并可能以隐蔽方式破坏推理流程。固定版本会有所帮助,直到你需要安装安全补丁。你会花费出乎意料的大量时间处理依赖管理和环境可复现性。
- 团队知识集中。 构建 FAISS 索引层的工程师理解分片逻辑,调优爬虫的工程师知道哪些网站需要特殊处理。当这些人离职时——在一个持续 18 至 24 个月的项目中,人员流动很常见——关键知识也会随之流失。文档有所帮助,但永远无法完整记录那些不明显决策背后的“原因”。
真实成本汇总
对于一个搜索公共互联网的网络级人脸搜索系统:
- 工程团队:3 至 5 名高级工程师,工作 12 至 24 个月 = 60 万至 250 万美元的薪酬及管理成本
- 基础设施(第一年):40 万至 100 万美元的云服务或硬件成本
- 基础设施(持续):每月 3 万至 8 万美元(每年 36 万至 96 万美元)
- 法律与合规:初始评估 5 万至 20 万美元,另加持续法律顾问费用
- 第一年总成本:140 万至 370 万美元
- 第二年及以后总成本:每年 50 万至 120 万美元的基础设施及工程维护费用
而且,这还是针对最终能够正常运行的系统。许多团队会先花费 6 至 12 个月和超过 50 万美元,才意识到问题比预估更困难,随后转向 API 解决方案。
何时自行构建,何时使用 API
适合自行构建的情况:
- 你拥有少于 10 万张人脸的封闭数据集(员工证件、客户照片)
- 系统需要在本地或隔离网络中运行
- 你拥有能够处理模型优化、阈值调优和边缘案例的机器学习工程师
- 使用场景是验证(1: 1),而不是针对网络进行搜索(1:N)
- 你有预算和时间投入一个持续多年的工程项目
适合使用 API 的情况:
- 你需要在公共互联网(社交媒体、新闻、网站)中搜索人脸
- 你不想构建和维护网络抓取与索引流程
- 你现在就需要结果,而不是等待 12 至 24 个月的开发
- 你需要系统随网上新发布的内容持续更新
- 你希望由他人处理 GDPR 合规、退出请求和欧盟人工智能法案要求
- 你希望避免超过 100 万美元的前期基础设施和工程成本
- 你的核心产品本身不是人脸搜索,工程时间更适合投入真正的产品
FaceCheck.id 人脸搜索 API
对于需要在公共网络上进行人脸搜索、但不想从头构建基础设施的开发者,FaceCheck.id 提供 REST API,可处理完整流程:检测、嵌入,以及在持续更新的索引中搜索来自社交媒体、新闻网站和更广泛网络的公开人脸图像。
FaceCheck.id 使用专门针对网络级搜索优化的专有人脸识别模型。开源模型需要自行部署和调优,而其专有模型则针对互联网人脸搜索的挑战进行了专门训练和微调,包括处理差异极大的图像质量、多样的光照条件、人口多样性,以及持续抓取索引的巨大规模。这种专有方法使其能够独立迭代模型性能,并以通用开源模型无法做到的方式针对具体搜索流程进行优化。为了使系统达到极难且极其昂贵才能从头复现的水平,已经投入了多年的工程开发、测试和改进。
API 的功能:
你发送一张人脸图像,API 会返回在互联网上找到的匹配人脸,以及置信度分数和来源 URL。匹配、索引和网络级基础设施全部由其服务器处理。上文提到的所有 GPU 集群、抓取流程、向量搜索基础设施、合规工具和持续维护,都是他们要解决的问题,而不是你的问题。
API 基础信息:
- RESTful JSON API
- 通过 API 密钥进行身份认证
- 发送 Base64 编码的图像或图像 URL
- 返回:包含相似度分数、来源 URL 和缩略图预览的匹配结果数组
- 速率限制和价格随用量扩展
典型集成:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
API 使用场景:
- 交友应用验证:让用户验证匹配对象的照片是否出现在真实的社交媒体资料中
- 品牌保护:检查是否有人使用你团队的照片创建虚假商业资料
- 尽职调查平台:在背景调查或 KYC 流程中增加人脸搜索
- 反欺诈系统:标记那些使用了在互联网其他地方以不同姓名出现的照片的账户
- OSINT 工具:构建包含网络级人脸匹配的调查工具
为何使用它,而不是自行构建:
构建一个搜索公共网络的人脸搜索引擎,需要:(1) 能够发现并下载数十亿张图像的网络级抓取流程;(2) 价值数十万美元、用于运行人脸检测和嵌入提取的 GPU 基础设施;(3) 拥有数 TB 内存、能够实时查询完整索引的分布式向量搜索系统;(4) 持续重新抓取以保持索引更新;(5) 用于处理退出请求、数据删除请求和监管要求的合规基础设施;(6) 由 3 至 5 名工程师组成的全职维护团队;以及 (7) 在首个可用版本发布前等待 12 至 24 个月。这是一个价值数百万美元、且持续成本高昂的工程项目。由 FaceCheck.id 专有模型和经过实战验证的基础设施支持的 API,只需一次 HTTP 调用即可提供所有这些能力。
上述开源模型非常适合构建封闭系统中的人脸识别,例如员工门禁、照片库整理和自定义验证流程。但如果你的使用场景是“在互联网上搜索这张脸出现在哪里”,那么从一个可运行的模型到一个可运行的产品之间存在巨大的工程鸿沟。FaceCheck.id API 弥合了这一差距,让你能在数天内发布可用产品,而不是耗费数年。
开始使用: 访问 facecheck.id/en/Face-Search/API,查看文档、价格并注册 API 密钥。
常见问题
哪个开源人脸识别模型最准确?
采用 Inception-ResNet-v2 骨干网络的 FaceNet512,目前在大多数基准上表现出色,在 LFW 上达到 99.65%。对于低质量图像场景(监控、闭路电视),AdaFace 在 IJB-C 等困难基准上表现更好,其 TAR@FAR=1e-4 时达到 97.39%。
我可以将开源人脸识别模型用于商业用途吗?
可以。FaceNet512、FaceNet、DeepFace、dlib 和 AdaFace 都采用宽松许可证(MIT 或 Boost)发布,可以用于商业产品。但请注意所在司法辖区针对生物识别数据处理的法律限制(GDPR、BIPA、欧盟人工智能法案),无论软件采用何种许可证,这些规定都同样适用。
训练自己的人脸识别模型需要多少数据?
你不需要从头训练。上述预训练模型使用了涵盖 10 万至 50 万个身份、共 500 万至 1,200 万张图像的数据集进行训练。除非有特定领域需求,否则直接使用这些预训练模型即可。微调通常需要 1 万至 10 万张图像。从头训练则需要数百万张图像和大量 GPU 资源。
人脸验证和人脸搜索有什么区别?
人脸验证(1:1)通过直接比较两个嵌入,回答“这两张照片是不是同一个人?”人脸搜索(1:N)则通过将一个嵌入与包含数百万个对象的数据库比较,回答“这个人出现在哪里?”验证的计算相对简单。搜索需要高效的最近邻索引(FAISS、Milvus);如果是网络级搜索,还需要庞大的抓取和索引基础设施,建设和运营成本可能高达数百万美元。
人脸识别在低质量图像上的准确率如何?
准确率会随图像质量显著下降。对于清晰的正面照片,现代模型可达到 99% 以上准确率。在模糊监控画面或脸宽不到 50 像素的照片中,准确率可能下降到 80% 至 90%,甚至更低。AdaFace 专门用于比标准模型更好地处理质量变化。对于任何系统,分辨率更高的输入图像都会显著改善结果。姿态同样重要:即使是高分辨率图像,侧脸的准确率也可能比正脸低 10% 至 20%。
构建人脸搜索引擎需要多少成本?
对于搜索公共互联网的网络级系统,第一年预计需要 140 万至 370 万美元(工程团队、基础设施和法律成本),之后每年持续成本为 50 万至 120 万美元。对于在少于 10 万张人脸的私有数据库中搜索的封闭系统,成本会低得多,一台 GPU 服务器和一名工程师即可处理。成本取决于搜索数据库的规模,以及是否需要抓取网络来填充数据库。
构建生产级人脸识别系统需要多长时间?
对于简单的验证系统(与已知数据库进行 1:1 匹配),经验丰富的工程师可以在 1 至 2 周内构建可用原型,并在 1 至 3 个月内达到生产就绪状态。对于网络级人脸搜索系统(针对互联网进行 1:N 搜索),由 3 至 5 名工程师组成的团队通常需要 12 至 24 个月,才能构建出足够可靠、可用于生产的系统。抓取、扩展和合规挑战会在核心机器学习工作之外增加大量时间。
构建真正有价值的东西。对于封闭系统,可以从 FaceNet512 开始。但如果你需要网络级人脸搜索,请问问自己:真的愿意花费 140 万至 370 万美元,招聘一支高级工程师团队,并等待 12 至 24 个月,才得到第一个可用结果吗?你完全可以跳过 GPU 集群、抓取噩梦、合规难题和多年的工程开发,通过 FaceCheck.id API,在不到 5 分钟内获得首批搜索结果,起步价仅为 1 美元。
阅读更多关于通过自拍搜索
什么是最准确的反向图片搜索?
想通过一张照片找到某人的真实身份?不是所有反向图片搜索引擎都能搞定人脸识别。Google 擅长搜产品和地标,Yandex 在俄语内容上更强,但要找人的话,你需要专门为人脸识别设计的工具。搞清楚哪个平台能准确匹配你上传的照片,别在一堆不相关的结果里浪费时间。
在其他语言中的主题
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
PimEyes vs FaceCheck:哪个更适合寻找面孔?