Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
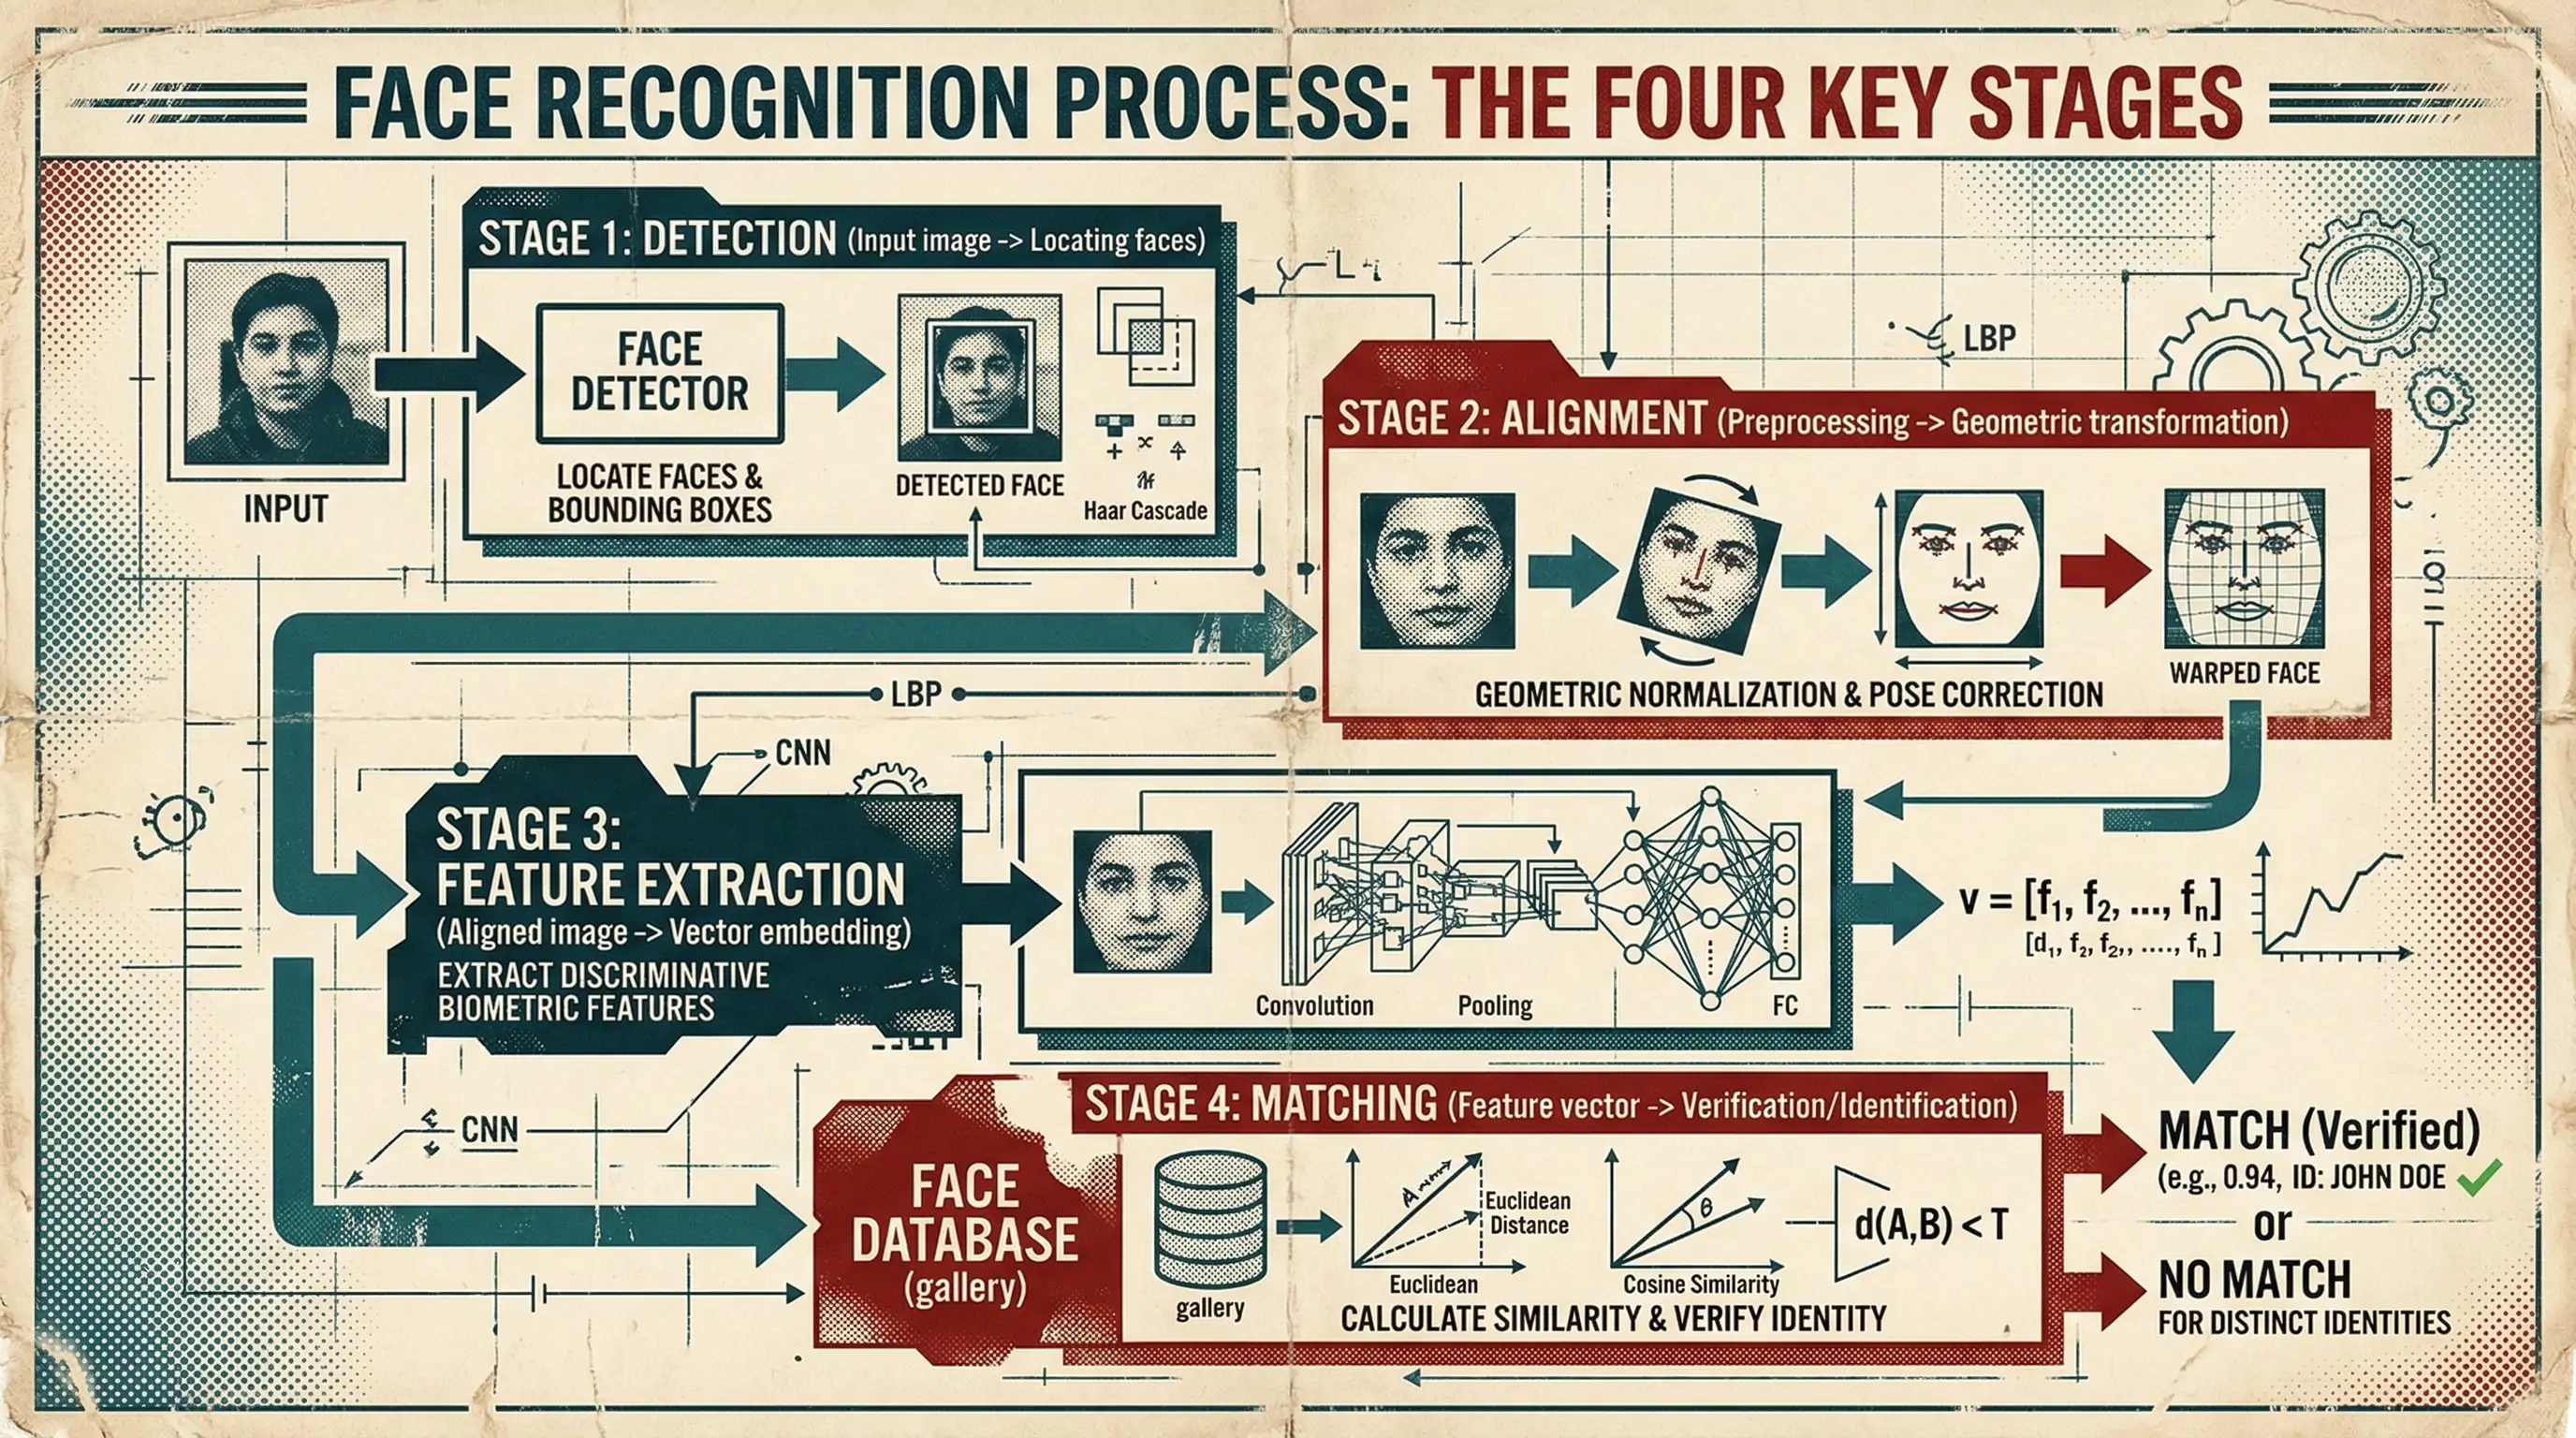
Wenn Sie eine Anwendung entwickeln, die Gesichter abgleichen, Identitäten anhand von Fotos verifizieren oder ein Gesicht in einem Datensatz suchen soll, müssen Sie verstehen, wie moderne Gesichtserkennung unter der Haube tatsächlich funktioniert. Nicht die Marketingversion. Sondern die echte Verarbeitungspipeline – von Rohpixeln bis zu einem 512-dimensionalen Einbettungsvektor, der die einzigartige Gesichtsgeometrie einer Person codiert.
Dieser Artikel erläutert die vollständige Gesichtserkennungspipeline, vergleicht die besten verfügbaren Open-Source-Modelle des Jahres 2026, zeigt reale Leistungswerte und erklärt, wann es sinnvoll ist, ein eigenes System zu entwickeln, und wann eine produktionsreife API die bessere Wahl ist.
In diesem Artikel werden wir diskutieren
Die Gesichtserkennungspipeline: vier Phasen
Jedes moderne Gesichtserkennungssystem folgt derselben grundlegenden Pipeline, unabhängig davon, ob es auf einem 35-US-Dollar-Raspberry Pi oder einem GPU-Cluster einer Regierungsbehörde läuft. Wenn Sie diese vier Phasen verstehen, können Sie jedes Modell und jede API besser beurteilen.
Phase 1: Gesichtserkennung
Bevor Sie ein Gesicht identifizieren können, müssen Sie es zunächst finden. Die Gesichtserkennung analysiert ein Bild und gibt Begrenzungsrahmen um jedes vorhandene Gesicht aus. Das klingt einfach, doch genau hier scheitern viele Systeme im Produktivbetrieb.
Die Standardmodelle:
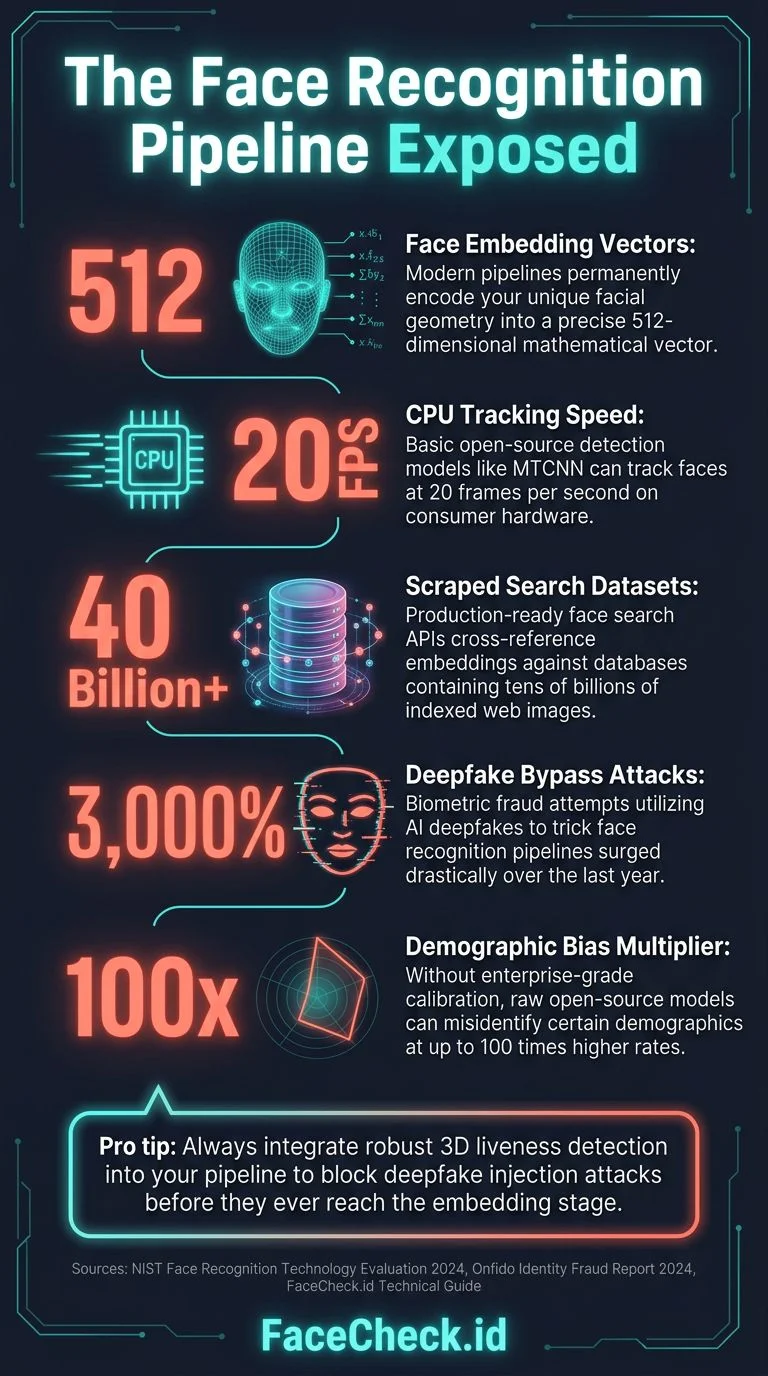
- MTCNN (Multi-task Cascaded Convolutional Networks): Seit 2016 das Arbeitstier der Gesichtserkennung. Dreistufige Kaskade: Das Proposal Network (P-Net) findet mögliche Regionen, das Refine Network (R-Net) filtert Falschpositive heraus und das Output Network (O-Net) verfeinert die Begrenzungsrahmen und gibt Gesichtslandmarken aus. Noch immer weitverbreitet. Präzise bei frontalen Gesichtern, aber schwächer bei extremen Winkeln und Verdeckungen. Erreicht auf einer modernen CPU etwa 20 FPS.
- RetinaFace: Führend bei der Erkennungsgenauigkeit. Einstufiger Detektor auf Basis eines [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Gibt Begrenzungsrahmen sowie fünf Gesichtslandmarken zurück: Augen, Nase und Mundwinkel. Kommt mit unterschiedlichen Größen gut zurecht. Die erste Wahl, wenn Genauigkeit wichtiger als Geschwindigkeit ist. Etwa 15 FPS auf einer GPU, langsamer auf einer CPU.
- SCRFD (Sample and Computation Redistribution for Efficient Face Detection): Der Geschwindigkeitschampion. Für Mobil- und Edge-Bereitstellungen entwickelt. Erreicht die Genauigkeit von RetinaFace bei 3- bis 10-facher Geschwindigkeit. Mehrere Modellgrößen mit 0,5 bis 34 Millionen Parametern. Wenn Sie auf Mobilgeräten bereitstellen oder Echtzeitverarbeitung benötigen, ist dies das passende Modell.
- BlazeFace: Googles Beitrag, entwickelt für [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Extrem schnell – mehr als 200 FPS auf mobilen GPUs –, nimmt dafür aber bei schwierigen Winkeln gewisse Genauigkeitseinbußen in Kauf. Gut für Echtzeit-Videoanwendungen, bei denen jedes Einzelbild verarbeitet werden muss.
Was bei der Erkennung wirklich zählt: Die schwierigen Fälle sind keine Selfies bei guter Beleuchtung. Es sind Überwachungsaufnahmen, Gruppenfotos mit nur 50 Pixel breiten Gesichtern, extreme Seitenprofile und teilweise durch Sonnenbrillen oder Masken verdeckte Gesichter. Ihr Erkennungsmodell bestimmt die Obergrenze des gesamten Systems. Übersieht es ein Gesicht, kann keine nachgelagerte Verarbeitung diesen Fehler beheben.
Das Problem mehrerer Gesichter: Enthält ein Bild mehrere Gesichter, müssen Sie entscheiden, welches davon eingebettet werden soll. Mögliche Strategien sind das größte Gesicht, das am stärksten zentrierte Gesicht, das Gesicht mit dem höchsten Qualitätswert oder die Einbettung aller Gesichter mit anschließender Auswahl durch die nachgelagerte Logik. Jede Entscheidung hat andere Fehlermodi. Werden auf Gruppenfotos alle Gesichter eingebettet, wächst der Index unnötig an und die Suchergebnisse werden mehrdeutig; wird nur das größte Gesicht ausgewählt, fehlt möglicherweise die Person in der hinteren Reihe. Die meisten Produktivsysteme betten alle erkannten Gesichter oberhalb einer Mindestgröße ein – üblicherweise 40 bis 60 Pixel zwischen den Augen – und speichern sie als separate Einträge, die mit demselben Quellbild verknüpft sind.
Bewertung der Gesichtsqualität als Zugangskontrolle: Wenn vor der Berechnung aufwendiger Einbettungen ein leichtgewichtiger Qualitätsschätzer wie SER-FIQ oder der Qualitätszweig von MagFace ausgeführt wird, gelangen unbrauchbare Daten gar nicht erst in den Index. Unscharfe Ausschnitte, starke Verdeckungen und überbelichtete Gesichter erzeugen Einbettungen mit geringer Zuverlässigkeit, die die Suchergebnisse verschlechtern. Gesichter unterhalb eines Qualitätsschwellenwerts bereits in der Erkennungsphase abzulehnen, verbessert die nachgelagerte Präzision erheblich und spart GPU-Rechenzyklen. Dies ist eine der Optimierungen mit dem höchsten ROI in der gesamten Pipeline.
Schutz vor Gesichts-Spoofing bei der Verifizierung: In Verifizierungsszenarien ist die Erkennung von Präsentationsangriffen (PAD) entscheidend. Papierausdrucke, Bildschirmwiedergaben und 3D-Masken können einbettungsbasierte Systeme täuschen. Modelle wie CDCN oder PatchNet erkennen solche Angriffe, erhöhen die Latenz jedoch um 5 bis 15 ms pro Gesicht und erfordern zusätzliche Modellpflege. Wenn Sie eine Anwendung entwickeln, bei der Benutzer das Eingabebild kontrollieren – etwa Zugangskontrolle, KYC oder Authentifizierung –, müssen Sie einen Anti-Spoofing-Schutz integrieren, andernfalls wird das System ausgenutzt werden.
Phase 2: Gesichtsausrichtung
Sobald ein Gesicht erkannt wurde, muss es normalisiert werden. Unterschiedliche Kopfhaltungen, Kamerawinkel und Entfernungen verändern das Erscheinungsbild eines Gesichts im Rohbild. Bei der Ausrichtung wird jedes erkannte Gesicht in eine standardisierte Position transformiert: waagerechte Augen, zentriertes Gesicht und einheitliche Skalierung.
Der Standardansatz verwendet die fünf Landmarken aus der Erkennung – linkes Auge, rechtes Auge, Nasenspitze, linker Mundwinkel und rechter Mundwinkel –, um eine Ähnlichkeitstransformation zu berechnen. Dadurch wird das erkannte Gesicht auf einen kanonischen Bildausschnitt von 160 × 160 Pixeln abgebildet, bei dem die Augen feste Pixelkoordinaten einnehmen.
Dieser Schritt wird in Tutorials häufig übersehen, ist aber entscheidend. Ein Rotationsfehler von 2 Grad bei der Ausrichtung kann die Erkennungsgenauigkeit um 1 bis 3 % senken. Die meisten Open-Source-Pipelines erledigen dies automatisch. Wenn Sie jedoch eine eigene Lösung entwickeln, sollten Sie die FaceNet-Ausrichtungsspezifikation – 160 × 160 Pixel und festgelegte Augenkoordinaten – als Standard verwenden. Auf dieser Grundlage wurden die meisten modernen Modelle trainiert.
Abhängigkeit der Ausrichtung von der Landmarkengenauigkeit: Die Landmarken von RetinaFace weisen im Durchschnitt einen Fehler von etwa 2 Pixeln auf. Dieser Fehler setzt sich in der Ausrichtungstransformation fort und kann die Genauigkeit um 1 bis 5 % verschlechtern, insbesondere bei kleineren Gesichtsausschnitten, bei denen 2 Pixel einen größeren Anteil der gesamten Gesichtsbreite ausmachen. Einige Produktivsysteme führen nach der ersten Erkennung eine zweite Landmarkenverfeinerung mit 68 oder 98 Punkten aus, etwa mit face-alignment von Adrian Bulat. Die zusätzlichen 3 bis 5 ms pro Gesicht lohnen sich, wenn der Anwendungsfall maximale Genauigkeit verlangt – insbesondere bei der 1:1-Verifizierung, bei der eine einzige falsche Entscheidung erhebliche Folgen haben kann.
Phase 3: Merkmalsextraktion (Einbettung)
Dies ist der Kern der Gesichtserkennung. Ein tiefes neuronales Netz verarbeitet das ausgerichtete Gesichtsbild und gibt einen Vektor fester Länge – üblicherweise mit 512 Dimensionen – aus, der als Einbettung oder Merkmalsvektor bezeichnet wird. Dieser Vektor ist eine kompakte numerische Darstellung der einzigartigen Merkmale des Gesichts.
Zwei Gesichter derselben Person sollten unabhängig von Beleuchtung, Gesichtsausdruck, Alter – in vernünftigen Grenzen – oder Kamera Einbettungen erzeugen, die im Vektorraum nahe beieinanderliegen. Zwei unterschiedliche Personen sollten Einbettungen erzeugen, die weit voneinander entfernt sind.
Technische Funktionsweise:
Die Netzwerkarchitektur ist üblicherweise ein modifiziertes Inception-ResNet oder ResNet, das mit Millionen von Gesichtsbildern trainiert wurde. Die wichtigste Innovation liegt nicht in der Architektur selbst, sondern in der beim Training verwendeten Verlustfunktion.
- Softmax-Verlust (die Ausgangsbasis): Behandelt Gesichtserkennung als Klassifikationsproblem. Funktioniert, erzeugt aber Einbettungen, die im Winkelraum nicht deutlich genug voneinander getrennt sind. Für die Gesichtserkennung weitgehend überholt.
- Triplet-Verlust: Der durch FaceNet populär gewordene Ansatz. Das Netzwerk lernt durch den Vergleich von Anker-/Positiv-/Negativ-Tripeln von Gesichtern. Einbettungen derselben Identität werden näher zusammengeführt, während Einbettungen unterschiedlicher Identitäten weiter auseinanderbewegt werden. Erfordert beim Training eine sorgfältige Auswahl schwieriger Tripel. Erzeugt sehr trennscharfe Einbettungen.
- ArcFace-Verlust: Im Jahr 2026 vermutlich die am häufigsten verwendete Verlustfunktion in produktiven Gesichtserkennungssystemen. Fügt im Winkelraum zwischen dem Merkmalsvektor und dem zugehörigen Klassengewicht eine additive Winkelabstandsstrafe hinzu. Dadurch entstehen engere Cluster innerhalb einer Klasse und größere Abstände zwischen Klassen als bei Ansätzen mit Kosinusabstand. Das Projekt [InsightFace](https://github.com/deepinsight/insightface) stellt die Referenzimplementierung bereit, und die meisten aktuellen Spitzenmodelle werden mit ArcFace oder einer seiner Varianten trainiert – beispielsweise baut der adaptive Abstand von AdaFace auf der ArcFace-Formulierung auf. Wenn Sie ein eigenes Gesichtserkennungsmodell trainieren oder feinabstimmen, ist ArcFace der übliche Ausgangspunkt.
- CosFace-Verlust: Ergänzt den Softmax-Verlust um einen Kosinusabstand und zwingt das Netzwerk dadurch, Einbettungen zu erzeugen, die innerhalb derselben Identität enger gruppiert und zwischen unterschiedlichen Identitäten stärker getrennt sind.
- SphereFace / A-Softmax: Der ursprüngliche Ansatz mit Winkelabstand aus dem Jahr 2017. Historisch bedeutsam, inzwischen aber weitgehend durch ArcFace und modernere Verlustfunktionen ersetzt.
Die Ausgabe: Ein Vektor aus 512 Gleitkommazahlen, der auf die Einheits-Hypersphäre L2-normalisiert wird. Sämtliche Informationen über ein Gesicht werden in 2 KB Daten komprimiert. Dieser Vektor wird gespeichert, indexiert und verglichen.
Die Normalisierungsfalle: Viele Entwickler vergessen, dass Einbettungen vor dem Vergleich L2-normalisiert werden müssen. Nicht normalisierte Einbettungen erzeugen stark schwankende Ähnlichkeitswerte. Dieser häufige Fehler ist schwer zu diagnostizieren, weil das System „größtenteils funktioniert“: Die relative Reihenfolge der Treffer kann in Tests korrekt aussehen, doch die absoluten Ähnlichkeitswerte driften zwischen Bildern, sodass schwellenwertbasierte Entscheidungen unzuverlässig werden. FaceNet512 erzeugt standardmäßig normalisierte Einbettungen. Wenn Sie jedoch ein eigenes Modell verwenden oder über ONNX exportieren, sollten Sie immer prüfen, ob die ausgegebenen Einbettungen auf der Einheits-Hypersphäre liegen, ihre L2-Norm also 1,0 beträgt.
Produktive Bereitstellung: ONNX Runtime und Quantisierung: Die Geschwindigkeitsangaben in Benchmarks setzen FP32-Inferenz auf einer unbelasteten GPU voraus. In Produktivsystemen werden Modelle meist über ONNX Runtime mit INT8-Quantisierung bereitgestellt. Dadurch sinkt die Inferenzzeit bei minimalem Genauigkeitsverlust – typischerweise unter 0,1 % auf LFW – auf ein Drittel bis die Hälfte. Der Ablauf: Exportieren Sie Ihr PyTorch- oder TensorFlow-Modell nach ONNX, führen Sie das Quantisierungswerkzeug von ONNX Runtime mit einem Kalibrierungsdatensatz aus etwa 1.000 Gesichtsbildern aus und stellen Sie das quantisierte Modell bereit. So werden aus „10 ms pro Gesicht“ auf derselben Hardware „3 bis 4 ms pro Gesicht“, was bei der Verarbeitung von Milliarden Bildern enorm wichtig ist.
Inferenz mit gemischter Genauigkeit: Wenn auf der GPU für das Backbone FP16, für die abschließende Einbettungsschicht jedoch FP32 verwendet wird, lassen sich die später in diesem Artikel beschriebenen Gleitkommapräzisionsprobleme vermeiden und gleichzeitig 1,5- bis 2-fache Geschwindigkeitssteigerungen erzielen. Dies ist ein praktischer Mittelweg zwischen vollständig in FP32 – präzise, aber langsam – und vollständig in FP16 – schnell, kann auf unterschiedlicher Hardware jedoch geringfügig abweichende Einbettungen erzeugen.
Einbettungs-Destillation für Edge-Bereitstellungen: Sie können ein kleineres Schülernetzwerk wie MobileFaceNet mit etwa 1 Million Parametern per Wissensdestillation darauf trainieren, die Einbettungen von FaceNet512 nachzuahmen. Das Schülermodell erreicht bei 10-facher Geschwindigkeit mehr als 95 % der Genauigkeit und eignet sich damit für Mobil- und Edge-Bereitstellungen, bei denen keine GPU verfügbar ist. Der entscheidende Punkt: Sie müssen das Schülermodell nicht von Grund auf mit Identitätslabels trainieren. Stattdessen lernt es, die Einbettungen des Lehrermodells auf nicht beschrifteten Gesichtsdaten zu reproduzieren. Das erfordert deutlich weniger Rechenleistung und keinen nach Identitäten beschrifteten Datensatz.
Phase 4: Abgleich
Wie entscheiden Sie anhand zweier Gesichtseinbettungen, ob sie dieselbe Person darstellen? Es gibt zwei Ansätze:
Kosinusähnlichkeit: Berechnet den Kosinus des Winkels zwischen zwei Einbettungsvektoren. Der Wertebereich reicht von -1 bis 1, wobei 1 identisch bedeutet. Ein typischer Schwellenwert für „dieselbe Person“ liegt je nach Modell und Anwendungsfall zwischen 0,4 und 0,6. Das Verfahren ist einfach, schnell und funktioniert gut, weil FaceNet512-Einbettungen L2-normalisiert sind.
Euklidische Distanz: Berechnet den L2-Abstand zwischen Vektoren. Für normalisierte Einbettungen ist dies mathematisch äquivalent zur Kosinusähnlichkeit (d = sqrt(2 - 2*cos_sim)). Manche Systeme bevorzugen diese Formulierung.
Für die Suche (1:N-Abgleich): Wenn Sie ein Gesicht in einer Datenbank mit Millionen Einträgen finden müssen, ist ein Brute-Force-Vergleich zu langsam. Verwenden Sie eine Suche nach approximativ nächsten Nachbarn (ANN):
- FAISS (Facebook AI Similarity Search): Die Standardbibliothek. Unterstützt GPU-Beschleunigung und mehrere Indextypen wie IVF, HNSW und PQ. Kann 1 Milliarde Vektoren innerhalb von Millisekunden durchsuchen. Kostenlos und quelloffen.
- Milvus: Speziell entwickelte Vektordatenbank, die intern FAISS verwendet und Persistenz-, Skalierungs- und API-Schichten ergänzt.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Verwaltete Vektordatenbanken, wenn Sie die Infrastruktur nicht selbst betreiben möchten.
Für eine Datenbank mit 10 Millionen Gesichtern kann ein gut abgestimmter HNSW-Index von FAISS auf einer einzelnen GPU die zehn besten Treffer in weniger als 5 Millisekunden zurückgeben.
Die Wahl des FAISS-Indextyps ist enorm wichtig. IVF-PQ bietet eine starke Komprimierung – 8 bis 16 Byte pro Vektor statt 2 KB –, verliert jedoch bei Grenzfällen an Genauigkeit, wenn ein echter Treffer durch Quantisierungsfehler unter den Schwellenwert fällt. HNSW bewahrt die Genauigkeit, benötigt aber 4- bis 8-mal mehr Speicher, da sowohl die vollständigen Gleitkommavektoren als auch die Graphstruktur gespeichert werden. Hybride IVF-HNSW-Indizes bieten für Größenordnungen von 10 Millionen bis 1 Milliarde Einträgen den besten Kompromiss. Viele Teams wählen anfangs aufgrund von Tutorial-Empfehlungen den falschen Indextyp und müssen sechs Monate später ihre gesamte Indexinfrastruktur neu aufbauen, sobald sie an dessen Grenzen stoßen. Testen Sie Ihren konkreten Workload mit realistischen Datenmengen und Abfragemustern, bevor Sie sich auf einen Indextyp festlegen.
Das Kaltstartproblem bei ANN-Indizes: HNSW- und IVF-Indizes benötigen eine Mindestanzahl an Vektoren, um gut zu funktionieren. Bei weniger als etwa 10.000 Vektoren ist eine Brute-Force-Suche tatsächlich schneller als eine indexierte Suche, weil der Index-Overhead – Graphdurchlauf und Zentroidvergleich – die Berechnung dominiert. Beginnen Sie in der frühen Wachstumsphase mit Brute Force (FAISS IndexFlatIP) und wechseln Sie zu einem ANN-Index, sobald Ihre Datenbank 50.000 bis 100.000 Vektoren überschreitet.
Vorfilterung mit Binärcodes: Durch die Berechnung eines binären Hashs für jede Einbettung – mittels Binärisierung oder SimHash – können Sie vor aufwendigen Gleitkommavergleichen eine günstige Vorfilterung anhand der Hamming-Distanz durchführen. Dadurch lässt sich die Kandidatenmenge bei minimalem Recall-Verlust um mehr als 90 % reduzieren. Die Idee: Speichern Sie neben jeder vollständigen Einbettung einen binären Code mit 256 oder 512 Bit. Berechnen Sie bei einer Abfrage zunächst die Hamming-Distanz zu allen Binärcodes – mit CPU-POPCNT-Befehlen extrem schnell –, wählen Sie die besten 1 bis 5 % der Kandidaten aus und berechnen Sie nur für diese die exakte Kosinusähnlichkeit. Dieser zweistufige Ansatz ist besonders effektiv, wenn der Datensatz größer als der verfügbare GPU-Speicher ist.
Neusortierung anhand von Gesichtsattributen: Die erste Einbettungssuche liefert Kandidaten. In einem zweiten Durchgang können geschätzte Attribute wie Altersbereich, Geschlecht, Hautton und Gesichtsbehaarung offensichtliche Fehlzuordnungen herausfiltern. Wird das abgefragte Gesicht als 25-jährige Frau und ein möglicher Treffer als 60-jähriger Mann eingeschätzt, handelt es sich ungeachtet des Einbettungsähnlichkeitswerts mit hoher Wahrscheinlichkeit um ein Falschpositiv. Diese einfache Heuristik kann Falschpositive bei minimalen Rechenkosten um 30 bis 50 % reduzieren und gehört zu den am wenigsten genutzten Verfahren in produktiven Gesichtssuchsystemen.
Zeitliche Konsistenz in Videos: Wenn Sie Gesichter aus Videos statt aus Standbildern abgleichen, verbessert die Mittelung von Einbettungen über mehrere Einzelbilder desselben verfolgten Gesichts die Genauigkeit erheblich – bei schwierigen Benchmarks oft um 5 bis 10 %. Die Aggregation auf Spurebene ist dem Abgleich einzelner Frames grundsätzlich überlegen. Der Ansatz: Verwenden Sie einen Gesichts-Tracker wie SORT oder DeepSORT, um Erkennungen über mehrere Frames hinweg zu verknüpfen, berechnen Sie für jede Erkennung eine Einbettung und aggregieren Sie diese durch qualitätsgewichtete Mittelung zu einer einzigen „Spureinbettung“. Als Qualitätsgewicht dient dabei der Gesichtsqualitätswert aus der Erkennungsphase.
Beste Open-Source-Modelle für Gesichtserkennung (2026)
FaceNet512
Der Goldstandard. FaceNet512 ist die 512-dimensionale Einbettungsvariante von Googles FaceNet-Architektur und bietet einen größeren und trennschärferen Einbettungsraum als die ursprüngliche 128-d-Variante.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Architektur: Inception-ResNet-v2-Backbone, das 512-d-Einbettungen erzeugt
- Lizenz: MIT (freizügig, kommerzielle Nutzung erlaubt)
- LFW-Genauigkeit: 99,65 %
- Einbettungsgröße: 512-d
- Enthält: Funktioniert mit Standard-Erkennungspipelines wie MTCNN und [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface) für eine vollständige Ende-zu-Ende-Erkennung
- Python-API: Über die Bibliothek
deepfaceoder eigenständige Implementierungen verfügbar
Fazit: Wenn Sie 2026 ein Gesichtserkennungssystem entwickeln, ist FaceNet512 ein starker Ausgangspunkt. Hervorragende Genauigkeit, 512-d-Einbettungen für hohe Trennschärfe, eine freizügige MIT-Lizenz und breite Unterstützung im Ökosystem.
FaceNet (Google, ursprüngliche 128-d-Version)
Das Modell, das den Einbettungsansatz 2015 populär machte. Es führte das Training mit Triplet-Verlust ein, bei dem das Netzwerk durch den Vergleich von Anker-/Positiv-/Negativ-Tripeln lernt.
- Originalveröffentlichung: „FaceNet: A Unified Embedding for Face Recognition and Clustering“ (Schroff et al., 2015)
- Repository: Mehrere Implementierungen; davidsandberg/facenet ist die klassische TensorFlow-Version
- Lizenz: MIT
- LFW-Genauigkeit: 99,63 % im Original, bis zu 99,75 % mit modernem Training
- Einbettungsgröße: 128-d
- Architektur: Inception-ResNet-v1 oder Inception-ResNet-v2
Fazit: Historisch bedeutsam und weiterhin leistungsfähig. Die 128-d-Einbettung ist kompakter, aber etwas weniger trennscharf als die 512-d-Variante FaceNet512. Geeignet, wenn Sie weniger Speicher pro Einbettung benötigen oder mit TensorFlow unter Speicherbeschränkungen arbeiten.
DeepFace (Facebook/Meta)
Nicht zu verwechseln mit der Python-Bibliothek deepface in Kleinschreibung. Metas DeepFace aus dem Jahr 2014 war einer der ersten Deep-Learning-Ansätze für Gesichtserkennung und erreichte auf LFW nahezu menschliche Genauigkeit.
Heute relevanter ist die deepface-Python-Bibliothek von Serengil:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repository: github.com/serengil/deepface
- Lizenz: MIT
- Funktionsumfang: Wrapper-Bibliothek mit einer einheitlichen API für mehrere Backend-Modelle: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib und SFace
- Enthält: Verifizierung, Suche und Analyse von Gesichtsattributen wie Alter, Geschlecht, ethnische Zuordnung und Emotion
- Benutzerfreundlichkeit: Extrem einfache API
Fazit: Die beste Wahl für Prototypen und Experimente. Mit der einheitlichen API können Sie durch Änderung eines einzigen Parameters zwischen Modellen wechseln. Im Produktivbetrieb sollten Sie FaceNet512 direkt einsetzen, um mehr Leistung und Kontrolle zu erhalten.
dlib
Die von Davis King gepflegte C++-Bibliothek mit Python-Bindings. Sie enthält ein Gesichtserkennungsmodell, das mit einem Datensatz aus 3 Millionen Bildern trainiert wurde.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repository: github.com/davisking/dlib
- Lizenz: Boost Software License (freizügig)
- LFW-Genauigkeit: 99,38 %
- Einbettungsgröße: 128-d
- Erkennung: HOG-basiert – schnell und CPU-freundlich – sowie CNN-basiert – genauer
Fazit: Äußerst solide, praxiserprobte C++-Software mit guten Python-Bindings. Weniger genau als FaceNet512, aber ausgesprochen zuverlässig. Eine gute Wahl, wenn Sie mit C++ arbeiten oder eine leichtgewichtige Lösung ohne Abhängigkeiten von PyTorch oder ONNX benötigen.
AdaFace
Ein neueres Modell aus dem Jahr 2022, das speziell auf Unterschiede in der Bildqualität eingeht. Standardmodelle werden mit hochwertigen Bildern trainiert und verlieren bei niedrig aufgelösten oder unscharfen Eingaben an Leistung. AdaFace passt seine Abstandsstrafe während des Trainings an die Bildqualität an.
- Repository: github.com/mk-minchul/AdaFace
- Lizenz: MIT
- Hauptvorteil: Überlegene Leistung bei Bildern niedriger Qualität, etwa aus Überwachungssystemen oder weit entfernten Kameras
- LFW-Genauigkeit: 99,82 %
- IJB-C TAR@FAR=1e-4: 97,39 %; übertrifft die meisten Open-Source-Modelle bei schwierigen Benchmarks
Fazit: Verwenden Sie AdaFace, wenn Ihre Eingabebilder von geringer Qualität sind. Für Überwachung, CCTV-Analysen und alle Szenarien, in denen Sie die Bildqualität nicht kontrollieren können, liefert AdaFace messbar bessere Ergebnisse als Standardmodelle.
Leistungsvergleich
| Modell | LFW (%) | Einbettung | Geschwindigkeit (ms/Gesicht) | Lizenz |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512-d | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128-d | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512-d | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128-d | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2048-d | ~15 ms (GPU) | CC BY-SA |
LFW (Labeled Faces in the Wild) ist der Standardbenchmark, gilt aber im Wesentlichen als gelöst. Jedes moderne Modell erreicht mehr als 99 %. Die tatsächlichen Unterschiede zeigen sich bei schwierigeren Benchmarks wie IJB-C mit vielfältigen Bedingungen und TinyFace mit niedriger Auflösung.
Hinweis zu Benchmarks und Realität: Diese Geschwindigkeitswerte beziehen sich auf FP32-Inferenz für ein einzelnes Gesicht auf einer aufgewärmten GPU. Im Produktivbetrieb mit INT8-Quantisierung über ONNX Runtime können Sie die 2- bis 3-fache Geschwindigkeit erwarten. Bedenken Sie jedoch, dass die vollständige Pipeline – Erkennung, Ausrichtung, Qualitätsbewertung und Einbettung – 3- bis 5-mal länger dauert als die reine Einbettungsextraktion. Ein realistischer Ende-zu-Ende-Durchsatz der vollständigen Pipeline auf einer einzelnen A100-GPU liegt bei 200 bis 400 Gesichtern pro Sekunde und nicht bei den Tausenden, die reine Einbettungsbenchmarks vermuten lassen.
Die Lücke zwischen Open-Source-Modellen und Produktivsystemen
Was Tutorials Ihnen nicht sagen: Ein Gesichtserkennungsmodell in einem Jupyter Notebook zum Laufen zu bringen, ist der einfache Teil. Der Aufbau eines produktiven Systems, das in großem Maßstab tatsächlich funktioniert, erfordert die Lösung einer langen Liste technischer Probleme, die kein Modell für Sie übernimmt. Die meisten Teams unterschätzen sowohl die Kosten als auch den Zeitaufwand erheblich. Ein vermeintliches Projekt nach dem Motto „einfach das Modell anschließen“ wird zu einem 12- bis 24-monatigen Entwicklungsprojekt, das bis zur Produktionsreife problemlos 500.000 bis über 2 Millionen US-Dollar verschlingen kann – laufende Betriebskosten noch nicht eingerechnet.
Die Infrastrukturkosten
GPU-Rechenleistung für die Einbettungsextraktion. Gesichtserkennung und Einbettungsextraktion für Milliarden Bilder lassen sich nicht auf einem Laptop erledigen. Eine einzelne NVIDIA A100-GPU kann in einer vollständigen Pipeline aus Erkennung, Ausrichtung und Einbettung ungefähr 200 bis 400 Gesichter pro Sekunde verarbeiten. Um 1 Milliarde Bilder in einem vernünftigen Zeitraum – beispielsweise innerhalb einer Woche – zu verarbeiten, benötigen Sie einen Cluster aus 40 bis 80 GPUs im Dauerbetrieb. Zu Cloudpreisen kostet ein einzelner Verarbeitungsdurchlauf 50.000 bis 150.000 US-Dollar. Mit jeder Modellverbesserung oder Pipelineänderung müssen Sie die Daten erneut verarbeiten. Der direkte Kauf der Hardware bedeutet 300.000 bis 800.000 US-Dollar für GPU-Server, zusätzlich zu Rackfläche, Strom, Kühlung und Personal für die Wartung.
Speicher in großem Maßstab. 1 Milliarde Gesichtseinbettungen mit jeweils 512 Gleitkommazahlen – je 2 KB – ergeben allein ungefähr 2 TB Vektordaten. Rechnet man Originalbilder, Vorschaubilder, Metadaten und Indexstrukturen hinzu, sind es Hunderte Terabyte bis hin zu wenigen Petabyte Speicher. Leistungsfähiger NVMe-Speicher für Ihre Vektorindizes kostet in der Cloud 0,10 bis 0,25 US-Dollar pro GB und Monat. Bei 50 TB aktivem Speicher sind das monatlich 5.000 bis 12.500 US-Dollar allein für den laufenden Betrieb.
Infrastruktur für die Vektorsuche. FAISS stößt auf einem einzelnen Rechner je nach Indextyp und verfügbarem RAM bei etwa 100 bis 500 Millionen Vektoren an seine Grenzen. Darüber hinaus benötigen Sie eine verteilte Suche über mehrere Shards mit Lastverteilung, Replikation zur Ausfallsicherheit und ausreichend RAM für die Indizes. Eine produktionsreife verteilte Bereitstellung von FAISS oder Milvus für mehr als 1 Milliarde Vektoren erfordert üblicherweise 8 bis 16 Rechner mit viel Arbeitsspeicher – jeweils mindestens 256 GB RAM – und kostet in der Cloud monatlich 15.000 bis 40.000 US-Dollar.
Netzwerk und Bandbreite. Das Crawlen von Milliarden Bildern bedeutet, Petabytes an Daten herunterzuladen. Bei 0,05 bis 0,09 US-Dollar pro GB ausgehendem Datenverkehr bei großen Cloudanbietern können allein die Datenübertragungen Zehntausende US-Dollar kosten. Außerdem benötigen Sie leistungsfähige interne Netzwerke zwischen Crawlern, GPU-Verarbeitungsknoten und Speicher-Backends.
Geschätzte Gesamtinfrastrukturkosten für eine Gesichtssuchmaschine im Webmaßstab: monatlich 30.000 bis 80.000 US-Dollar an laufenden Cloudkosten oder 500.000 bis 1,5 Millionen US-Dollar für Hardware im Voraus, zusätzlich zu monatlich 10.000 bis 20.000 US-Dollar für Strom, Bandbreite und Wartung. Und das betrifft nur die Infrastruktur, bevor ein einziger Entwickler eine Zeile Anwendungscode geschrieben hat.
Der Entwicklungszeitplan
Der Aufbau eines produktiven Gesichtssuchsystems ist kein Hackathon-Projekt. So sieht ein realistischer Zeitplan für ein Team aus 3 bis 5 erfahrenen Entwicklern aus:
Monate 1 bis 3: Kernpipeline. Erkennung, Ausrichtung und Einbettungsextraktion zuverlässig zum Laufen bringen. Den grundlegenden Vektorindex erstellen. Die Bildaufnahme aus lokalen Dateien ermöglichen. Dies ist der „unterhaltsame“ Teil, in dem alles gut zu laufen scheint und die Demo beeindruckend aussieht.
Monate 3 bis 6: Web-Crawling-Infrastruktur. Scraper für große Plattformen entwickeln. Ratenbegrenzungen, CAPTCHAs, Login-Barrieren, dynamisches Rendering auf JavaScript-lastigen Seiten, Bilddeduplizierung und Inhaltsfilterung bewältigen. Feststellen, dass jede Social-Media-Plattform andere Anti-Scraping-Maßnahmen einsetzt, die Ihre Crawler wöchentlich außer Gefecht setzen. Monitoring entwickeln, das stillschweigend ausgefallene Crawler erkennt. Allein diese Phase kann länger dauern als erwartet, weil das Web unübersichtlich und konfrontativ ist.
Monate 6 bis 9: Skalierung und Zuverlässigkeit. Ihr Prototyp funktionierte mit 1 Million Gesichtern. Nun muss er mit 100 Millionen funktionieren. Sie stellen fest, dass Ihr FAISS-Index nicht mehr in den Arbeitsspeicher passt. Sie implementieren Sharding. Sie beheben Race Conditions in der Aufnahmepipeline. Sie entwickeln Wiederholungslogik für die 15 % der Bilder, deren Download fehlschlägt. Sie verarbeiten beschädigte Bilder, Dateien, die angeblich JPEGs sind, aber keine sind, Bilder mit EXIF-Rotationskennzeichnungen und abgebrochene Downloads. Sie ergänzen Monitoring, Warnmeldungen und Protokollierung, damit Sie erfahren, wenn nachts um 3 Uhr etwas ausfällt.
Monate 9 bis 12: Qualität und Genauigkeit. Sie erkennen, dass Ihre Falschpositivrate in großem Maßstab inakzeptabel ist. Sie implementieren eine Bewertung der Gesichtsqualität, um unbrauchbare Einbettungen herauszufiltern. Sie stimmen Schwellenwerte für jeden Anwendungsfall ab. Sie entwickeln einen Feedbackmechanismus, mit dem schlechte Treffer markiert und untersucht werden können. Sie stellen fest, dass Ihr Modell aufgrund unterschiedlicher Gleitkommapräzision auf verschiedenen GPU-Architekturen unterschiedliche Ergebnisse liefert, und verbringen zwei Wochen mit der Fehlersuche.
Monate 12 bis 18: Härtung für den Produktivbetrieb. Sie entwickeln eine API-Schicht mit Authentifizierung, Ratenbegrenzung und Nutzungsverfolgung. Sie ergänzen Funktionen zur Einhaltung von DSGVO und CCPA: Widerspruchsmöglichkeiten, Löschanfragen und Auditprotokollierung. Sie implementieren Ergebnis-Caching. Sie erstellen Administrationswerkzeuge. Sie verfassen Dokumentation. Sie bewältigen das Sicherheitsaudit. Sie führen Lasttests für alles durch. Sie beheben Speicherlecks, von deren Existenz Sie nichts wussten.
Monate 18 bis 24: Laufender Betrieb. Crawler fallen aus, wenn Websites ihr Layout ändern. Modelle driften, wenn neue Bildtypen auftauchen. Datenträger laufen voll. Indizes müssen neu aufgebaut werden. Benutzer melden Sonderfälle, mit denen Sie nie gerechnet haben. Jemand stellt fest, dass Ihr System bei Cartoon-Gesichtern überzeugte Treffer zurückgibt, und Sie müssen einen Filter für „echte Gesichter“ ergänzen. Das hört niemals auf.
Die vollständige Liste der Probleme, denen Sie begegnen werden
Neben Infrastruktur und Zeitplan folgen hier alle wesentlichen Probleme, auf die Teams beim Aufbau eigener Gesichtserkennungssysteme stoßen. Diese Liste stammt aus realen Produktivsystemen und nicht aus theoretischen Überlegungen.
Albträume bei der Datenqualität:
- Garbage in, garbage out. Das Internet ist voll von Memes, KI-generierten Gesichtern, Zeichnungen, Fotos von Fotos, Magazincovern und Statuen. Ihr Detektor wird in all diesen Inhalten „Gesichter“ finden und Einbettungen erzeugen, die Ihren Index verunreinigen. Sie benötigen Klassifikatoren, um synthetische Gesichter, gezeichnete Gesichter, extrem niedrig aufgelöste Ausschnitte und nicht fotografische Inhalte herauszufiltern. Schon die Entwicklung und Pflege dieser Filter ist ein eigenes Projekt.
- Doppelte und nahezu doppelte Bilder. Dasselbe Foto erscheint auf Dutzenden Websites mit unterschiedlichen Ausschnitten, Wasserzeichen, Komprimierungsstufen und Farbanpassungen. Ohne Deduplizierung erzeugt ein einziges virales Foto Hunderte „Treffer“, die alle dasselbe Bild darstellen und die echten Ergebnisse verdrängen. Perzeptuelles Hashing wie pHash und dHash hilft, ist aber nicht perfekt. Sie benötigen Deduplizierung auf mehreren Ebenen: URL-Deduplizierung – trivial –, perzeptuelle Hash-Deduplizierung – erkennt skalierte und neu komprimierte Kopien – und Deduplizierung auf Einbettungsebene – erkennt dasselbe Gesicht aus leicht unterschiedlichen Winkeln. Jede Ebene findet Duplikate, die die anderen übersehen, und Sie werden mehr Zeit mit Deduplizierung verbringen als erwartet.
- Veränderungen durch Alter und Erscheinungsbild. Eine Einbettung aus dem Studienfoto einer Person stimmt möglicherweise nicht mit einem 15 Jahre später aufgenommenen Foto überein. Gewichtsveränderungen, Alterung, Schönheitsoperationen, Gesichtsbehaarung und unterschiedliche Frisuren beeinflussen die Erkennungsgenauigkeit. Kein Modell bewältigt dies perfekt. Benutzer werden Ihrem System die Schuld geben, wenn es dieselbe Person über einen Zeitraum von 20 Jahren nicht zuordnen kann.
- Demografische Verzerrung. Open-Source-Modelle, die überwiegend mit westlichen beziehungsweise kaukasischen Datensätzen trainiert wurden, schneiden bei anderen demografischen Gruppen schlechter ab. Die ethnienübergreifenden Genauigkeitsunterschiede sind größer, als LFW vermuten lässt – LFW besteht zu ungefähr 77 % aus kaukasischen Personen. Bei globaler Bereitstellung können die Genauigkeitsunterschiede zwischen demografischen Gruppen in schwierigen Benchmarks 5 bis 15 % betragen. Mit MS-Celeb-1M trainierte Modelle wie FaceNet512 übernehmen dessen demografische Verzerrung. Für eine gerechte Leistung sind die Feinabstimmung mit ausgewogenen Datensätzen wie BUPT-Balancedface oder demografiebewusste Trainingsstrategien wichtig. Wenn Sie die Genauigkeit nicht über ethnische Gruppen hinweg auswerten, liefern Sie möglicherweise ein System aus, das für manche Benutzer gut und für andere schlecht funktioniert. Dies ist nicht nur eine ethische Frage, sondern auch ein Problem der Produktqualität und rechtlichen Haftung.
- Verarbeitung der EXIF-Ausrichtung. Etwa 15 bis 20 % der Bilder im Web enthalten EXIF-Ausrichtungsinformationen. Werden diese ignoriert, stehen Gesichter seitlich oder auf dem Kopf. Die meisten Gesichtsdetektoren erkennen gedrehte Gesichter nicht. Dies ist ein stiller Genauigkeitskiller, der in Tests mit korrekt ausgerichteten Bildern leicht übersehen wird, im Produktivbetrieb aber verheerend wirkt. Wenden Sie die EXIF-Ausrichtungskorrektur immer als allerersten Schritt Ihrer Bildverarbeitungspipeline an.
- Dekodierungsfehler bei progressiven JPEG- und WebP-Dateien. Einige Bildbibliotheken erzeugen aus teilweise heruntergeladenen progressiven JPEGs oder abgeschnittenen WebP-Dateien stillschweigend beschädigte Pixeldaten. Der Gesichtsdetektor kann in den Beschädigungsartefakten dennoch ein „Gesicht“ finden und eine unbrauchbare Einbettung erzeugen. Vor der Verarbeitung müssen Sie die Bildintegrität prüfen: Die Datei muss fehlerfrei dekodiert werden können, und der resultierende Pixelpuffer muss plausible Abmessungen aufweisen. Ohne diese Prüfung verunreinigen beschädigte Bilder unbemerkt Ihren Index.
Technische Probleme, die anfangs nicht offensichtlich sind:
- Versionierung von Einbettungen. Wenn Sie Ihr Modell aktualisieren – und das werden Sie, weil Genauigkeitsverbesserungen wichtig sind –, werden sämtliche Einbettungen in Ihrer Datenbank mit den Ausgaben des neuen Modells inkompatibel. Sie können entweder Ihre gesamte Datenbank neu einbetten – teuer, zeitaufwendig und nur möglich, wenn alle Originalbilder erhalten bleiben –, während der Migration parallele Indizes betreiben – doppelte Infrastrukturkosten – oder Abwärtskompatibilität aufrechterhalten – komplex und hinderlich für Verbesserungen. Es gibt keine gute Lösung, nur weniger schmerzhafte.
- Determinismus von Gleitkommaberechnungen. Dasselbe Bild kann auf unterschiedlichen GPU-Modellen, mit verschiedenen CUDA-Versionen oder sogar bei unterschiedlichen Batchgrößen aufgrund der Gleitkommaarithmetik leicht abweichende Einbettungen erzeugen. Diese Abweichungen sind klein – 1e-6 bis 1e-4 –, summieren sich aber: Ein Treffer mit 0,401 auf einem Rechner kann auf einem anderen 0,399 erreichen und dadurch eine binäre Schwellenwertentscheidung umkehren. Das treibt Sie bei der Fehlersuche in den Wahnsinn. Besonders problematisch sind GPU-Treiberupdates: NVIDIA-Treiberupdates können das Gleitkommaverhalten auf CUDA-Ebene verändern. Eine mit Treiber 535.x berechnete Einbettung kann sich von der Einbettung desselben Bildes mit 545.x unterscheiden. Im Produktivbetrieb müssen Sie daher die Treiberversionen in Ihrer gesamten Flotte festschreiben und nach jedem Update die Konsistenz der Einbettungen überprüfen.
- Nebenläufigkeit und Race Conditions. Mehrere Crawler nehmen gleichzeitig Gesichter auf, Benutzer stellen Abfragen, während der Index aktualisiert wird, und Löschanfragen treffen ein, während Suchergebnisse zusammengestellt werden. Vektordatenbanken verfügen nicht über dieselbe ausgereifte Transaktionsunterstützung wie SQL-Datenbanken. Sie werden Situationen erleben, in denen ein Gesicht nur teilweise indexiert ist, Abfragen veraltete Ergebnisse zurückgeben oder Löschungen nicht auf alle Shards übertragen werden.
- Speicherverwaltung. FAISS-Indizes werden per Memory-Mapping eingebunden, doch die Abfrageleistung hängt stark davon ab, wie viel des Indexes in den Arbeitsspeicher passt. Mit wachsendem Index steigt die Abfragelatenz unvorhersehbar, wenn das Betriebssystem Indexseiten aus dem Speicher verdrängt. OOM-Abbrüche treten stets zum ungünstigsten Zeitpunkt auf. Sie werden sich eingehend mit Linux-Speicherverwaltung, Swap-Einstellungen und [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access)-Topologie beschäftigen. Auch das Aufwärmen nach Kaltstarts bereitet Probleme: FAISS-HNSW-Indizes werden per Memory-Mapping eingebunden, sodass die ersten paar Hundert Abfragen nach einem Serverneustart 10- bis 100-mal langsamer sind, weil die Indexseiten noch nicht in den RAM geladen wurden. Sie benötigen eine Aufwärmphase, die den Index vor Annahme des Produktivverkehrs vorlädt, andernfalls erleben die ersten Benutzer nach einer Bereitstellung katastrophale Latenzen.
- Stille Ausfälle. Ein Crawler funktioniert nicht mehr, weil eine Website ihr HTML geändert hat. Ihr GPU-Verarbeitungsknoten erzeugt wegen eines Treiberupdates NaN-Einbettungen. Ein Datenträger läuft voll und neue Gesichter werden stillschweigend nicht mehr indexiert. Diese Fehler lösen keine Fehlermeldungen aus, sondern verschlechtern das System unbemerkt. Ohne umfassendes Monitoring und Anomalieerkennung bemerken Sie sie erst, wenn sich Benutzer beschweren.
- Das FAISS-Aktualisierungsproblem. Wenn Sie einem IVF-Index neue Einbettungen hinzufügen, geraten die Voronoi-Zellen aus dem Gleichgewicht. Die Suchqualität nimmt allmählich ab, bis Sie den Quantisierer neu trainieren. Im Webmaßstab bedeutet das stundenlange GPU-Rechenzeit auf dem vollständigen Datensatz. Teams bündeln neue Einträge üblicherweise und trainieren wöchentlich oder monatlich neu. Dadurch sind neu aufgenommene Gesichter nicht sofort mit voller Genauigkeit durchsuchbar. Sie müssen stets zwischen Aktualität und Suchqualität abwägen; eine kostenlose Lösung gibt es nicht.
- Kalibrierung der Werte über Index-Shards hinweg. Wenn Ihr Index auf mehrere Rechner verteilt ist, sind rohe Ähnlichkeitswerte verschiedener Shards nicht direkt vergleichbar, weil jeder Shard eine andere Einbettungsverteilung besitzt. Sie benötigen eine shard-spezifische Normalisierung der Werte – Kohortennormalisierung, Z-Norm oder T-Norm –, um Ergebnisse sinnvoll zusammenzuführen. Ohne Kalibrierung kann ein Wert von 0,45 aus Shard A einen starken Treffer darstellen, während 0,45 aus Shard B nur mittelmäßig ist. Zusammengeführte Ergebnisse werden unzuverlässig.
- Das Fan-out-Problem bei verteilter Suche. Die Suche in N Shards bedeutet N Netzwerk-Roundtrips pro Abfrage. Wenn ein Shard langsam ist – etwa durch eine GC-Pause, einen Anstieg der Datenträger-E/A oder einen Netzwerkaussetzer –, ist die gesamte Abfrage langsam. Die P99-Latenz wird von der P99-Latenz des langsamsten Shards bestimmt und verschlechtert sich mit jedem zusätzlichen Shard. Verfahren wie Hedged Requests – doppelte Anfragen senden und die zuerst eintreffende Antwort verwenden – und adaptive Zeitüberschreitungen sind unverzichtbar, um akzeptable Tail-Latenzen aufrechtzuerhalten.
Probleme mit Genauigkeit und Abgleich:
- Die Abstimmung von Schwellenwerten ist niemals „abgeschlossen“. Der optimale Ähnlichkeitsschwellenwert verändert sich mit dem Wachstum Ihrer Datenbank. Bei 1 Million Gesichtern bietet ein Schwellenwert von 0,45 ein gutes Gleichgewicht zwischen Präzision und Recall. Bei 100 Millionen Gesichtern erzeugt derselbe Schwellenwert zehnmal mehr Falschpositive, weil mehr ähnlich aussehende Beinahetreffer vorhanden sind. Sie benötigen adaptive Schwellenwerte oder eine nachgelagerte Neusortierung. Die zugrunde liegende Mathematik ist unerbittlich: Wenn Ihre Datenbank von 1 Million auf 100 Millionen und anschließend auf 1 Milliarde Gesichter wächst, verschiebt sich die Verteilung der Top-k-Ähnlichkeitswerte nach oben, weil mehr ähnlich aussehende Beinahetreffer existieren. Ein fester Schwellenwert, der bei 1 Million Gesichtern eine Falschpositivrate von 0,1 % ergibt, kann bei 1 Milliarde eine Rate von 10 % erzeugen. Sie müssen diese Verteilung modellieren und Schwellenwerte dynamisch anpassen oder hinnehmen, dass Ihre Präzision mit der Größenordnung abnimmt.
- Open-Set- gegenüber Closed-Set-Erkennung. Die meisten Benchmarks bewerten die Closed-Set-Leistung, bei der garantiert ist, dass die abgefragte Person in der Datenbank existiert. Die Gesichtssuche in der realen Welt ist Open Set: Das abgefragte Gesicht ist möglicherweise überhaupt nicht im Index vorhanden. Die Open-Set-Bewertung erfordert völlig andere Metriken – TPIR bei fester FPIR statt Rank-1-Genauigkeit –, und der Fehlermodus sind Falschtreffer statt falscher Rangfolgen. Ein System, das bei Closed-Set-Benchmarks 99 % erzielt, kann bei einer Open-Set-Bereitstellung eine Falschtrefferrate von 10 % aufweisen, weil es selbst dann zuversichtlich das „ähnlichste“ Gesicht zurückgibt, wenn der echte Treffer nicht existiert. „Kein Treffer gefunden“ korrekt zu behandeln, ist ebenso wichtig wie das Finden korrekter Treffer.
- Doppelgänger und ähnlich aussehende Personen. In einer Datenbank mit mehr als 100 Millionen Gesichtern gibt es viele nicht verwandte Personen, deren Einbettungen überraschend nahe beieinanderliegen. Je größer Ihre Datenbank ist, desto mehr Falschtreffer treten auf. Benutzer werden regelmäßig Ergebnisse für die „falsche Person“ melden. Sie benötigen eine Strategie dafür: Verifizierung anhand mehrerer Fotos, kontextbezogene Signale wie Name und Ort sowie Warteschlangen für eine menschliche Prüfung.
- Poseninvariante Erkennung bleibt schwierig. Selbst FaceNet512 verliert bei einem Gierwinkel von mehr als plus oder minus 60 Grad erheblich an Leistung. Die Genauigkeit beim Abgleich von Profil- mit Frontalaufnahmen kann gegenüber dem Abgleich zweier Frontalaufnahmen um 10 bis 20 % sinken. In Überwachungsszenarien sind die meisten Gesichter schräg aufgenommen, sodass die reale Genauigkeit deutlich niedriger ist, als Benchmarks vermuten lassen. Modelle, die mit 3D-bewusster Augmentierung trainiert wurden, oder Architekturen wie UV-GAN helfen, erhöhen aber die Komplexität. Wenn Ihre Eingabedaten viele schräge Gesichter enthalten, sollten Sie dies als zentrales Genauigkeitsproblem und nicht als Randfall betrachten.
- Adversarielle Eingaben. Benutzer werden KI-generierte Gesichter, Deepfakes, gemorphte Bilder und Fotos mit absichtlichen Störungen einreichen. Manche testen Ihr System, andere versuchen, Ergebnisse zu manipulieren. Ihr System muss gegenüber solchen Eingaben eine gewisse Robustheit besitzen, sonst liefert es überzeugte Treffer für gefälschte Gesichter.
- Fotomanipulation. Filter, Beauty-Apps, starkes Make-up und Software zur Gesichtsanpassung: Instagram-Realität gegenüber tatsächlicher Realität. Diese Veränderungen beeinflussen die Gesichtsgeometrie stark genug, um die Einbettungsähnlichkeit zu verändern. Ein stark gefiltertes Selfie stimmt möglicherweise nicht mit einem ungefilterten Foto derselben Person überein.
- Ein Gesicht, viele Einbettungen. Von einer einzigen Person können Hunderte Fotos aus unterschiedlichen Plattformen, Perspektiven und Jahren online verfügbar sein. Geben Sie alle als separate Treffer zurück oder gruppieren Sie sie zu einer einzigen Identität? Clustering in großem Maßstab – Hunderte Millionen Gesichter – ist rechenintensiv und bringt eigene Fehlermodi mit sich: Überzusammenführung – zwei unterschiedliche Personen werden kombiniert – und Unterzusammenführung – Fotos derselben Person werden nicht miteinander verknüpft.
Betriebliche Probleme:
- Wettrüsten gegen Scraping. Jede große Social-Media-Plattform blockiert Scraper aktiv. Plattformen verändern Seitenstrukturen, fügen CAPTCHAs hinzu, erkennen Headless-Browser, begrenzen Anfragen nach IP-Adresse, erstellen Fingerabdrücke von Anfragemustern und liefern mitunter Köderinhalte aus. Ihre Crawling-Infrastruktur befindet sich in einem ständigen Wettrüsten. Ein Scraper, der heute funktioniert, kann nächste Woche vollständig blockiert sein. Die Pflege von Crawlern ist ein fortlaufender Entwicklungsaufwand und keine einmalige Aufgabe.
- Modellierung der Änderungsrate. Unterschiedliche Quellen werden unterschiedlich häufig aktualisiert. Nachrichtenseiten über Prominente veröffentlichen stündlich neue Fotos; persönliche Social-Media-Profile können jahrelang unverändert bleiben. Eine intelligente Planung erneuter Crawls anhand historischer Änderungsraten kann die Bandbreitenkosten um 60 bis 80 % senken und gleichzeitig den Index dort aktuell halten, wo es darauf ankommt. Ohne diese Planung crawlen Sie entweder statische Quellen zu häufig – Bandbreiten- und Geldverschwendung – oder dynamische Quellen zu selten – veraltete Ergebnisse.
- CDN- und geografische Inhaltsunterschiede. Dieselbe URL kann je nach Standort, User-Agent des Geräts oder Cookies des Anfragenden unterschiedliche Bilder ausliefern. Ihr Crawler kann ein anderes Bild indexieren als das, das ein Benutzer sieht, was zu verwirrenden Meldungen führt, der Treffer sehe nicht wie das Ergebnis aus. Einige CDNs liefern Platzhalter mit niedriger Auflösung, bis ein echter Browser das Bild in den sichtbaren Bereich scrollt. Sie müssen diese Sonderfälle verarbeiten oder einen gewissen Anteil an Phantomtreffern akzeptieren.
- Wachstum der Speicherkosten. Der Bildspeicher wächst linear und hört nie auf. Sie können Originale nicht löschen, wenn Sie sie möglicherweise erneut einbetten müssen. Vorschaubilder, Metadaten, Einbettungsvektoren, Indexdateien und Sicherungskopien kommen hinzu. Die Speicherrechnung steigt mit zunehmender Reife des Systems immer schneller. Teams, die nur den Speicherbedarf des ersten Jahres eingeplant haben, sind von den Kosten im dritten Jahr schockiert.
- Compliance-Anfragen in großem Maßstab. Die DSGVO gibt Personen das Recht, die Löschung ihrer Daten zu verlangen. Wenn jemand widerspricht, müssen Sie alle aus dem Gesicht dieser Person erzeugten Einbettungen in Ihrer gesamten Datenbank finden, löschen, sicherstellen, dass sie nicht erneut hinzugefügt werden, wenn Ihre Crawler die Originalbilder wiederfinden, und die Löschung zu Prüfzwecken dokumentieren. In großem Maßstab erfordert dies spezielle Werkzeuge und erhebliche Entwicklungsarbeit. Der [EU AI Act](https://artificialintelligenceact.eu/) ergänzt weitere Anforderungen an Hochrisiko-KI-Systeme einschließlich Gesichtserkennung: verpflichtende Konformitätsbewertungen, Tests auf Verzerrungen, Transparenzpflichten und Mechanismen menschlicher Aufsicht.
- Die Umsetzung von Widersprüchen ist schwieriger, als sie klingt. Sie können nicht einfach eine Einbettung löschen. Sie müssen verhindern, dass sie erneut indexiert wird, wenn der Crawler dasselbe Gesicht wiederfindet. Dafür müssen Sie einen „Sperrlisten“-Index mit Einbettungen von Personen führen, die widersprochen haben, und jede neue Einbettung vor der Indexierung damit vergleichen. Diese Sperrliste muss selbst schnell sein – sie wird bei jedem Einfügen abgefragt – und wirft eigene Fragen zur Datenspeicherung auf: Sie müssen die Gesichtseinbettung der widersprechenden Person dauerhaft speichern, um künftige Treffer zu erkennen. Das bedeutet, dass Sie biometrische Daten aufbewahren, um einer Löschanfrage nachzukommen. Diese rechtliche Spannung ist real und in vielen Rechtsordnungen ungeklärt.
- Das Einwilligungsproblem bei öffentlich gecrawlten Daten. Die Rechtsgrundlage nach der DSGVO für die Verarbeitung biometrischer Daten aus öffentlichen Social-Media-Profilen ist rechtlich umstritten. Mehrere EU-Datenschutzbehörden haben gegen Gesichtserkennungsunternehmen entschieden, insbesondere in den Clearview-AI-Entscheidungen verschiedener EU-Mitgliedstaaten. Ihr rechtliches Risiko hängt von Rechtsordnung, Datenquelle und Anwendungsfall ab. Dies ist kein hypothetisches Zukunftsproblem, sondern ein Bereich aktiver Rechtsdurchsetzung.
- Speicherkosten für Audit-Trails. Wenn Sie jede Suchanfrage und jeden zurückgegebenen Treffer protokollieren – was Compliance-Vorgaben verlangen können –, wachsen die Auditprotokolle möglicherweise schneller als die eigentlichen Gesichtsdaten. Ein System mit 1 Million Suchvorgängen pro Tag und jeweils 10 Ergebnissen erzeugt täglich etwa 10 Millionen Auditdatensätze. Aufbewahrungsfristen – je nach Rechtsordnung häufig 1 bis 7 Jahre – lassen diese Datenmenge unaufhaltsam anwachsen. Planen Sie Auditspeicher als primären Kostenfaktor und nicht als nachträglichen Zusatz ein.
- Reaktion auf Vorfälle. Was geschieht, wenn Ihr System ein Gesicht falsch zuordnet und jemand aufgrund dieses Falschtreffers handelt? Sie benötigen Audit-Trails, die zeigen, wie jedes Ergebnis zustande kam, die Möglichkeit, Abgleichsentscheidungen zu erklären, und ein Verfahren zur Bearbeitung von Einsprüchen. Wenn jemand einen Treffer anficht, ist „Die Kosinusähnlichkeit betrug 0,47 und überschritt unseren Schwellenwert von 0,42“ keine zufriedenstellende Erklärung. Verfahren wie GradCAM können zeigen, welche Gesichtsbereiche den Treffer bestimmten. Dies unterstützt die Klärung von Streitfällen und stärkt das Vertrauen. Es ist nicht nur gute technische Praxis, sondern kann abhängig von Ihrer Rechtsordnung gesetzlich vorgeschrieben sein.
- Alterung von Modellen und Abhängigkeiten. Versionen von CUDA, Python und [ONNX Runtime](https://onnxruntime.ai/) sowie Betriebssystemupdates verändern sich im Laufe der Zeit und können Ihre Inferenzpipeline auf subtile Weise beschädigen. Festgeschriebene Versionen helfen, bis Sie ein Sicherheitsupdate benötigen. Sie werden überraschend viel Zeit mit Abhängigkeitsverwaltung und reproduzierbaren Umgebungen verbringen.
- Konzentration von Teamwissen. Der Entwickler der FAISS-Indexschicht versteht die Sharding-Logik. Der Entwickler, der die Crawler abgestimmt hat, weiß, welche Websites eine Sonderbehandlung benötigen. Wenn diese Personen das Unternehmen verlassen – und bei einem 18- bis 24-monatigen Projekt gibt es Personalwechsel –, verschwindet kritisches Wissen mit ihnen. Dokumentation hilft, erfasst aber nie vollständig das „Warum“ hinter nicht offensichtlichen Entscheidungen.
Zusammenfassung der tatsächlichen Kosten
Für ein Gesichtssuchsystem im Webmaßstab, das das öffentliche Internet durchsucht:
- Entwicklungsteam: 3 bis 5 erfahrene Entwickler für 12 bis 24 Monate = 600.000 bis 2,5 Millionen US-Dollar an Gehältern und Gemeinkosten
- Infrastruktur (Jahr 1): 400.000 bis 1 Million US-Dollar an Cloud- oder Hardwarekosten
- Infrastruktur (laufend): 30.000 bis 80.000 US-Dollar pro Monat beziehungsweise 360.000 bis 960.000 US-Dollar pro Jahr
- Recht und Compliance: 50.000 bis 200.000 US-Dollar für die erste Bewertung sowie laufende Rechtsberatung
- Gesamtkosten im ersten Jahr: 1,4 bis 3,7 Millionen US-Dollar
- Gesamtkosten ab dem zweiten Jahr: 500.000 bis 1,2 Millionen US-Dollar pro Jahr für Infrastruktur und technische Wartung
Und das gilt für ein System, das funktioniert. Viele Teams investieren 6 bis 12 Monate und mehr als 500.000 US-Dollar, bevor sie erkennen, dass das Problem schwieriger ist als angenommen, und auf eine API-Lösung umsteigen.
Wann Sie selbst entwickeln und wann Sie eine API verwenden sollten
Entwickeln Sie selbst, wenn:
- Sie einen geschlossenen Datensatz mit weniger als 100.000 Gesichtern haben, etwa Mitarbeiterausweise oder Kundenfotos
- Das System lokal oder in einem isolierten Netzwerk betrieben werden muss
- Sie ML-Entwickler haben, die Modelloptimierung, Schwellenwertabstimmung und Sonderfälle bewältigen können
- Ihr Anwendungsfall eine Verifizierung im Verhältnis 1: 1 und keine Suche im Verhältnis 1:N im Web ist
- Sie das Budget und den Zeitrahmen für ein mehrjähriges Entwicklungsprojekt besitzen
Verwenden Sie eine API, wenn:
- Sie Gesichter im öffentlichen Internet suchen müssen, etwa in sozialen Medien, Nachrichten und im Web
- Sie keine eigene Web-Scraping- und Indizierungspipeline entwickeln und pflegen möchten
- Sie jetzt Ergebnisse benötigen und nicht erst nach 12 bis 24 Monaten Entwicklungszeit
- Das System mit neuen online veröffentlichten Inhalten aktuell bleiben muss
- Jemand anderes DSGVO-Compliance, Widerspruchsanfragen und den EU AI Act übernehmen soll
- Sie Vorabkosten von mehr als 1 Million US-Dollar für Infrastruktur und Entwicklung vermeiden möchten
- Die Gesichtssuche nicht Ihr eigentliches Kernprodukt ist und Ihre Entwicklungszeit besser in das eigentliche Produkt investiert wird
FaceCheck.id-API für die Gesichtssuche
Für Entwickler, die das öffentliche Web nach Gesichtern durchsuchen müssen, ohne die Infrastruktur von Grund auf aufzubauen, bietet FaceCheck.id eine REST-API, die die gesamte Pipeline übernimmt: Erkennung, Einbettung und Suche in einem laufend aktualisierten Index öffentlich verfügbarer Gesichtsbilder aus sozialen Medien, Nachrichtenseiten und dem weiteren Web.
FaceCheck.id verwendet ein proprietäres Gesichtserkennungsmodell, das für die Suche im Webmaßstab optimiert ist. Im Gegensatz zu Open-Source-Modellen, die Sie selbst bereitstellen und abstimmen müssten, wurde das proprietäre Modell speziell für die Herausforderungen der Gesichtssuche im Internet trainiert und feinabgestimmt: stark schwankende Bildqualität, unterschiedliche Lichtverhältnisse, demografische Vielfalt und die enorme Größe des kontinuierlich gecrawlten Indexes. Dieser proprietäre Ansatz ermöglicht es, die Modellleistung unabhängig weiterzuentwickeln und auf die eigene Suchpipeline zu optimieren – auf eine Weise, die universelle Open-Source-Modelle nicht leisten können. Jahrelange Entwicklung, Tests und Verfeinerung haben ein System hervorgebracht, dessen Leistungsniveau von Grund auf nur äußerst schwierig und teuer nachzubilden wäre.
Was die API leistet:
Sie senden ein Gesichtsbild. Die API gibt im Internet gefundene übereinstimmende Gesichter mit Konfidenzwerten und Quell-URLs zurück. Abgleich, Indizierung und Infrastruktur im Webmaßstab werden vollständig auf Anbieterseite abgewickelt. Sämtliche zuvor beschriebenen GPU-Cluster, Crawling-Pipelines, Vektorsuchsysteme, Compliance-Werkzeuge und laufenden Wartungsaufgaben sind damit deren Problem und nicht Ihres.
Grundlagen der API:
- RESTful-JSON-API
- Authentifizierung über API-Schlüssel
- Übermittlung eines Base64-codierten Bildes oder einer Bild-URL
- Rückgabe: Liste von Treffern mit Ähnlichkeitswerten, Quell-URLs und Vorschaubildern
- Ratenbegrenzungen und Preise skalieren mit der Nutzung
Typische Integration:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Anwendungsfälle für die API:
- Verifizierung in Dating-Apps: Benutzer können prüfen, ob die Fotos eines Matches in echten Social-Media-Profilen erscheinen
- Markenschutz: Prüfen Sie, ob jemand die Fotos Ihres Teams für gefälschte Geschäftsprofile verwendet
- Due-Diligence-Plattformen: Ergänzen Sie Hintergrundprüfungen oder KYC-Abläufe um eine Gesichtssuche
- Betrugsbekämpfungssysteme: Markieren Sie Konten, deren Fotos an anderer Stelle im Internet unter anderen Namen erscheinen
- OSINT-Werkzeuge: Entwickeln Sie Ermittlungswerkzeuge mit Gesichtssuche im Webmaßstab
Warum Sie diese Lösung statt einer Eigenentwicklung verwenden sollten:
Der Aufbau einer Gesichtssuchmaschine für das öffentliche Web erfordert: (1) eine Crawling-Pipeline im Webmaßstab, die Milliarden Bilder entdeckt und herunterlädt, (2) GPU-Infrastruktur im Wert von Hunderttausenden US-Dollar für Gesichtserkennung und Einbettungsextraktion, (3) ein verteiltes Vektorsuchsystem mit mehreren Terabyte RAM, um den vollständigen Index in Echtzeit abzufragen, (4) kontinuierliches erneutes Crawlen, um den Index aktuell zu halten, (5) Compliance-Infrastruktur für Widersprüche, Löschanfragen und regulatorische Vorgaben, (6) ein Team aus 3 bis 5 Vollzeitentwicklern für die laufende Wartung und (7) 12 bis 24 Monate bis zur ersten nutzbaren Version. Das ist ein Entwicklungsprojekt im Umfang von mehreren Millionen US-Dollar mit erheblichen laufenden Kosten. Die API, die auf dem proprietären Modell und der praxiserprobten Infrastruktur von FaceCheck.id basiert, stellt all das mit einem einzigen HTTP-Aufruf bereit.
Die oben beschriebenen Open-Source-Modelle eignen sich hervorragend für geschlossene Gesichtserkennungssysteme wie Mitarbeiterzugangskontrollen, die Organisation von Fotobibliotheken oder individuelle Verifizierungsabläufe. Wenn Ihr Anwendungsfall jedoch lautet: „Durchsuche das Internet danach, wo dieses Gesicht erscheint“, ist der technische Abstand zwischen einem funktionierenden Modell und einem funktionierenden Produkt enorm. Die FaceCheck.id-API schließt diese Lücke und ermöglicht es Ihnen, ein funktionierendes Produkt innerhalb weniger Tage statt nach mehreren Jahren bereitzustellen.
Jetzt starten: Dokumentation, Preise und Registrierung für einen API-Schlüssel finden Sie unter facecheck.id/en/Face-Search/API.
FAQ
Welches Open-Source-Modell für Gesichtserkennung ist am genauesten?
FaceNet512 mit einem Inception-ResNet-v2-Backbone erzielt derzeit bei den meisten Benchmarks hervorragende Ergebnisse, darunter 99,65 % auf LFW. Bei Bildern niedriger Qualität – etwa aus Überwachung und CCTV – zeigt AdaFace in schwierigen Benchmarks wie IJB-C mit einem TAR@FAR=1e-4 von 97,39 % bessere Leistungen.
Kann ich Open-Source-Modelle für Gesichtserkennung kommerziell nutzen?
Ja. FaceNet512, FaceNet, DeepFace, dlib und AdaFace werden unter freizügigen Lizenzen wie MIT oder Boost veröffentlicht. Sie dürfen sie in kommerziellen Produkten verwenden. Beachten Sie jedoch die rechtlichen Einschränkungen für die Verarbeitung biometrischer Daten in Ihrer Rechtsordnung, etwa DSGVO, BIPA und EU AI Act. Diese gelten unabhängig von der Softwarelizenz.
Wie viele Daten benötige ich, um ein eigenes Gesichtserkennungsmodell zu trainieren?
Sie müssen nicht von Grund auf trainieren. Die oben aufgeführten vortrainierten Modelle wurden mit Datensätzen von 5 bis 12 Millionen Bildern und 100.000 bis 500.000 Identitäten trainiert. Verwenden Sie diese vortrainierten Modelle und führen Sie nur dann eine Feinabstimmung durch, wenn Sie einen speziellen domänenspezifischen Bedarf haben. Für eine Feinabstimmung werden üblicherweise 10.000 bis 100.000 Bilder benötigt. Ein Training von Grund auf erfordert Millionen Bilder und erhebliche GPU-Ressourcen.
Was ist der Unterschied zwischen Gesichtsverifizierung und Gesichtssuche?
Die Gesichtsverifizierung im Verhältnis 1:1 beantwortet die Frage „Zeigen diese beiden Fotos dieselbe Person?“, indem zwei Einbettungen direkt verglichen werden. Die Gesichtssuche im Verhältnis 1:N beantwortet die Frage „Wo erscheint diese Person?“, indem eine Einbettung mit einer Datenbank aus Millionen Einträgen verglichen wird. Die Verifizierung ist rechnerisch einfach. Die Suche erfordert eine effiziente Indizierung nächster Nachbarn mit FAISS oder Milvus sowie bei einer Suche im Webmaßstab eine massive Crawling- und Indexinfrastruktur, deren Aufbau und Betrieb Millionen kosten kann.
Wie genau ist Gesichtserkennung bei Bildern niedriger Qualität?
Die Genauigkeit nimmt mit der Bildqualität deutlich ab. Bei klaren, frontal aufgenommenen Fotos erreichen moderne Modelle eine Genauigkeit von über 99 %. Bei unscharfen Überwachungsaufnahmen oder Fotos, auf denen das Gesicht weniger als 50 Pixel breit ist, kann die Genauigkeit auf 80 bis 90 % oder darunter sinken. AdaFace wurde speziell dafür entwickelt, Qualitätsschwankungen besser als Standardmodelle zu bewältigen. In jedem System liefern Eingabebilder mit höherer Auflösung erheblich bessere Ergebnisse. Auch die Pose spielt eine Rolle: Selbst bei hochauflösenden Bildern kann die Genauigkeit bei Profilgesichtern gegenüber Frontalansichten um 10 bis 20 % sinken.
Wie viel kostet der Aufbau einer Gesichtssuchmaschine?
Für ein System im Webmaßstab, das das öffentliche Internet durchsucht, sollten Sie im ersten Jahr mit Kosten von 1,4 bis 3,7 Millionen US-Dollar für Entwicklungsteam, Infrastruktur und Rechtsberatung rechnen. Danach fallen jährlich 500.000 bis 1,2 Millionen US-Dollar an laufenden Kosten an. Bei einem geschlossenen System, das eine private Datenbank mit weniger als 100.000 Gesichtern durchsucht, sind die Kosten erheblich niedriger: Ein einzelner GPU-Server und ein Entwickler können ausreichen. Die Kosten skalieren mit der Größe Ihrer Suchdatenbank und damit, ob Sie das Web crawlen müssen, um sie zu befüllen.
Wie lange dauert die Entwicklung eines produktiven Gesichtserkennungssystems?
Für ein einfaches Verifizierungssystem – 1:1-Abgleich mit einer bekannten Datenbank – kann ein erfahrener Entwickler innerhalb von 1 bis 2 Wochen einen funktionierenden Prototyp erstellen und ihn in 1 bis 3 Monaten produktionsreif machen. Für ein Gesichtssuchsystem im Webmaßstab – 1:N-Abgleich mit dem Internet – sollten Sie mit 12 bis 24 Monaten und einem Team aus 3 bis 5 Entwicklern rechnen, bevor das System zuverlässig genug für den Produktivbetrieb ist. Crawling, Skalierung und Compliance verursachen einen enormen zusätzlichen Zeitaufwand über die eigentliche ML-Arbeit hinaus.
Entwickeln Sie etwas, das zählt. Beginnen Sie für Ihr geschlossenes System mit FaceNet512. Wenn Sie jedoch eine Gesichtssuche im Webmaßstab benötigen, sollten Sie sich fragen: Möchten Sie wirklich 1,4 bis 3,7 Millionen US-Dollar ausgeben, ein Team erfahrener Entwickler einstellen und 12 bis 24 Monate auf das erste nutzbare Ergebnis warten? Stattdessen können Sie GPU-Cluster, Crawling-Albträume, Compliance-Probleme und jahrelange Entwicklung vollständig überspringen und mit der FaceCheck.id-API innerhalb von weniger als 5 Minuten erste Suchergebnisse erhalten – bereits ab 1 US-Dollar.
Lesen Sie mehr über die umgekehrte Bildsuche
Der Aufstieg von Romance Scams: Schützen Sie Ihr Herz und Ihre Geldbörse
Liebesbetrug im Netz wird immer ausgefeilter – gefälschte Profile, erfundene Notlagen und emotionale Manipulation kosten Betroffene Millionen. Erkennen Sie die Warnsignale, bevor Sie mit gebrochenem Herzen und leerem Konto dastehen.
Zum Thema in anderen Sprachen
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Beliebte Themen
Deepfake Identität Soziale Medien Gesichtserkennung Facebook Instagram LinkedIn Gesichtssuche Doppelgänger Biometrisch FingerabdruckDer ultimative Gesichts-Suchkampf: PimEyes vs FaceCheck - Wer kommt heraus?