Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
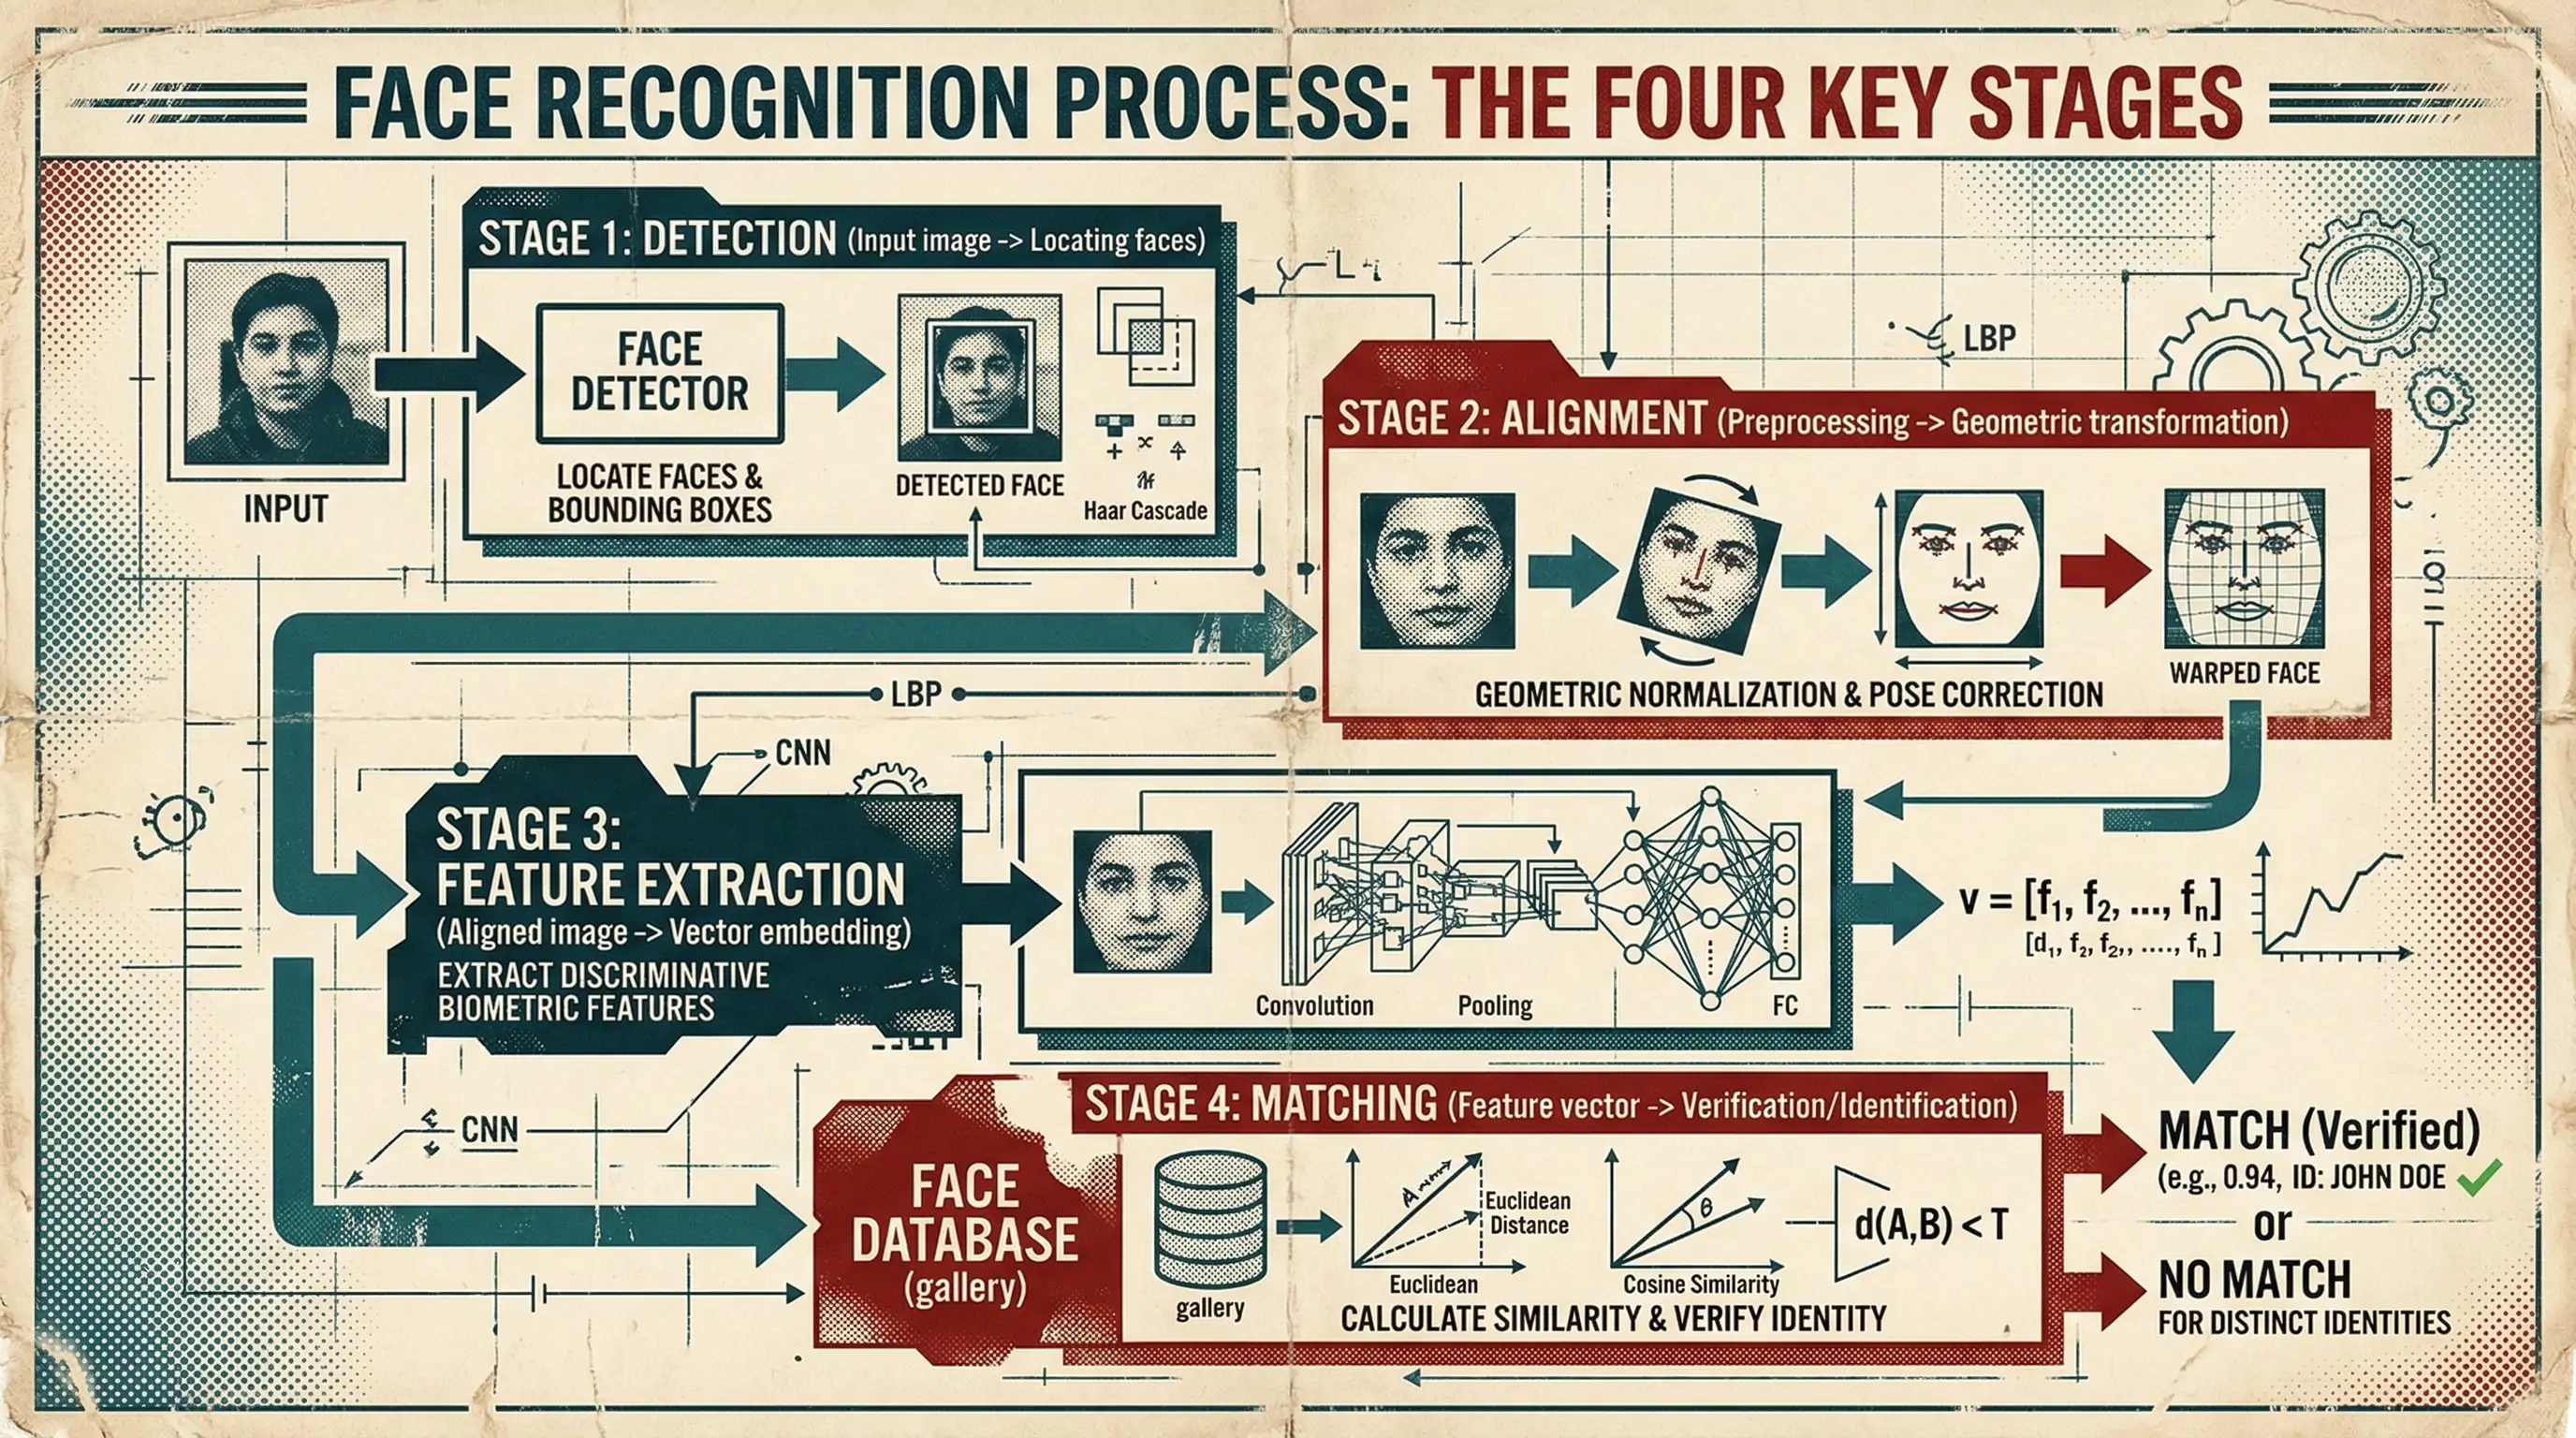
Se stai sviluppando qualcosa che deve confrontare volti, verificare identità tramite foto o cercare un volto all’interno di un set di dati, devi capire come funziona davvero il moderno riconoscimento facciale. Non la versione del marketing. La pipeline reale, dai pixel grezzi a un vettore di embedding a 512 dimensioni che codifica la geometria facciale unica di una persona.
Questo articolo analizza l’intera pipeline del riconoscimento facciale, confronta i migliori modelli open source disponibili nel 2026, mostra i dati prestazionali effettivi e spiega quando conviene sviluppare un sistema proprio anziché utilizzare un’API di produzione.
In questo articolo, andremo a discutere
- La pipeline del riconoscimento facciale: quattro fasi
- I migliori modelli open source per il riconoscimento facciale (2026)
- Tabella comparativa delle prestazioni
- Il divario tra modelli open source e sistemi di produzione
- Quando sviluppare internamente e quando utilizzare un’API
- API di ricerca facciale FaceCheck.id
- Domande frequenti
La pipeline del riconoscimento facciale: quattro fasi
Ogni moderno sistema di riconoscimento facciale segue la stessa pipeline di base, indipendentemente dal fatto che venga eseguito su un Raspberry Pi da 35 dollari o su un cluster di GPU presso un ente governativo. Comprendere queste quattro fasi ti aiuterà a valutare qualsiasi modello o API.
Fase 1: rilevamento dei volti
Prima di poter riconoscere un volto, devi individuarlo. Il rilevamento dei volti riceve un’immagine e restituisce riquadri delimitatori intorno a ogni volto presente. Sembra semplice, ma è proprio qui che molti sistemi falliscono in produzione.
I modelli standard:
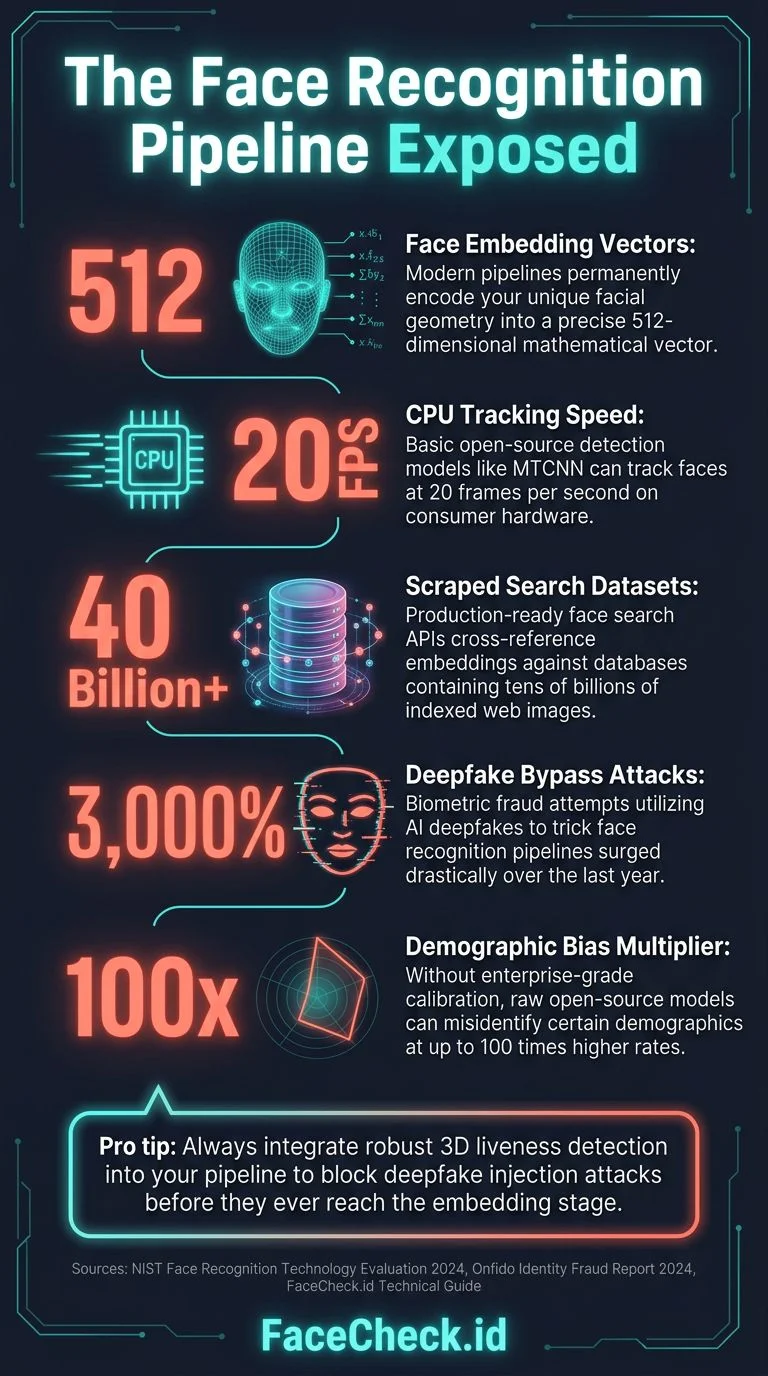
- MTCNN (Multi-task Cascaded Convolutional Networks): Il cavallo di battaglia del rilevamento facciale dal 2016. Cascata a tre fasi: la Proposal Network (P-Net) individua le regioni candidate, la Refine Network (R-Net) filtra i falsi positivi, mentre la Output Network (O-Net) perfeziona i riquadri delimitatori e restituisce i punti di riferimento facciali. È ancora ampiamente utilizzato. Accurato sui volti frontali, fatica con angolazioni estreme e occlusioni. Raggiunge circa 20 FPS su una CPU moderna.
- RetinaFace: Lo stato dell’arte per l’accuratezza del rilevamento. Rilevatore a fase singola basato su una struttura [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Restituisce riquadri delimitatori più cinque punti di riferimento facciali (occhi, naso e angoli della bocca). Gestisce bene scale diverse. È la scelta di riferimento quando l’accuratezza conta più della velocità. Circa 15 FPS su GPU, più lento su CPU.
- SCRFD (Sample and Computation Redistribution for Efficient Face Detection): Il campione della velocità. Progettato per dispositivi mobili ed edge. Raggiunge un’accuratezza paragonabile a RetinaFace con una velocità da 3 a 10 volte superiore. Disponibile in modelli di diverse dimensioni, da 0,5 milioni a 34 milioni di parametri. Se devi distribuire il sistema su dispositivi mobili o ti serve un’elaborazione in tempo reale, è ciò che fa per te.
- BlazeFace: Il contributo di Google, progettato per [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Estremamente veloce (supera i 200 FPS sulle GPU mobili), ma sacrifica parte dell’accuratezza con le angolazioni difficili. Adatto alle applicazioni video in tempo reale in cui è necessario elaborare ogni fotogramma.
Ciò che conta davvero nel rilevamento: I casi difficili non sono i selfie con una buona illuminazione. Sono i filmati di sorveglianza, le foto di gruppo in cui i volti sono larghi 50 pixel, i profili laterali estremi e i volti parzialmente nascosti da occhiali da sole o mascherine. Il modello di rilevamento determina il limite massimo dell’intero sistema. Se il rilevamento non individua un volto, nessuna fase successiva può rimediare.
Il problema dei volti multipli: Quando un’immagine contiene più volti, devi decidere quale incorporare. Tra le strategie vi sono la scelta del volto più grande, di quello più centrale, di quello con il punteggio di qualità più alto oppure l’incorporamento di tutti i volti, lasciando alla logica successiva il compito di gestirli. Ogni scelta comporta modalità di errore diverse. Incorporare tutti i volti nelle foto di gruppo gonfia l’indice e produce risultati di ricerca ambigui; scegliere solo il volto più grande fa perdere la persona in piedi nell’ultima fila. La maggior parte dei sistemi di produzione incorpora tutti i volti rilevati al di sopra di una soglia minima di dimensione, generalmente 40-60 pixel tra gli occhi, e li associa come voci separate collegate alla stessa immagine sorgente.
Il punteggio di qualità del volto come filtro: Eseguire uno stimatore di qualità leggero come SER-FIQ o il ramo dedicato alla qualità di MagFace prima di calcolare embedding costosi impedisce che dati inutilizzabili entrino nell’indice. Ritagli sfocati, occlusioni estreme e volti sovraesposti producono tutti embedding con un basso livello di affidabilità che inquinano i risultati di ricerca. Rifiutare nella fase di rilevamento i volti al di sotto di una soglia di qualità migliora drasticamente la precisione nelle fasi successive e riduce i cicli GPU necessari. È una delle ottimizzazioni con il ROI più elevato dell’intera pipeline.
Anti-spoofing facciale per la verifica: Negli scenari di verifica, il rilevamento degli attacchi di presentazione (PAD) è fondamentale. Stampe su carta, riproduzioni su schermo e maschere 3D possono ingannare i sistemi basati sugli embedding. Modelli come CDCN o PatchNet rilevano questi attacchi, ma aggiungono 5-15 ms di latenza per volto e richiedono ulteriore manutenzione del modello. Se stai sviluppando qualcosa in cui l’utente controlla l’immagine di input, come il controllo degli accessi, il KYC o l’autenticazione, devi includere funzionalità anti-spoofing, altrimenti il sistema verrà sfruttato.
Fase 2: allineamento dei volti
Dopo aver rilevato un volto, devi normalizzarlo. Pose della testa, angolazioni della fotocamera e distanze diverse modificano l’aspetto del volto nell’immagine grezza. L’allineamento trasforma ogni volto rilevato in una posizione standardizzata: occhi in orizzontale, volto centrato e scala uniforme.
L’approccio standard utilizza i cinque punti di riferimento del rilevamento (occhio sinistro, occhio destro, punta del naso, angolo sinistro della bocca e angolo destro della bocca) per calcolare una trasformazione di similitudine. In questo modo il volto rilevato viene mappato su un ritaglio canonico di 160x160 pixel, con gli occhi posizionati a coordinate fisse.
Questo passaggio viene spesso trascurato nei tutorial, ma è fondamentale. Un errore di rotazione di 2 gradi nell’allineamento può ridurre l’accuratezza del riconoscimento dell’1-3%. La maggior parte delle pipeline open source gestisce automaticamente questo aspetto, ma se stai creando una soluzione personalizzata usa come standard le specifiche di allineamento di FaceNet (160x160, coordinate specifiche per gli occhi). È lo standard sul quale è stata addestrata la maggior parte dei modelli moderni.
Sensibilità dell’allineamento all’accuratezza dei punti di riferimento: I punti di riferimento di RetinaFace presentano in media un errore di circa 2 pixel. Tale errore si propaga nella trasformazione di allineamento e può causare una riduzione dell’accuratezza dell’1-5%, soprattutto sui ritagli di volti più piccoli, nei quali 2 pixel rappresentano una proporzione maggiore della larghezza complessiva del volto. Alcuni sistemi di produzione eseguono, dopo il rilevamento iniziale, un affinamento secondario con 68 o 98 punti di riferimento, come face-alignment di Adrian Bulat, per ottenere un allineamento più preciso. I 3-5 ms aggiuntivi per volto valgono la pena quando il caso d’uso richiede la massima accuratezza, in particolare nella verifica 1:1, dove una singola decisione errata ha conseguenze.
Fase 3: estrazione delle caratteristiche (embedding)
Questo è il cuore del riconoscimento facciale. Una rete neurale profonda riceve l’immagine del volto allineato e restituisce un vettore di lunghezza fissa, generalmente di 512 dimensioni, chiamato embedding o vettore delle caratteristiche. Questo vettore è una rappresentazione numerica compatta delle caratteristiche uniche del volto.
Due volti della stessa persona, indipendentemente da illuminazione, espressione, età entro limiti ragionevoli o fotocamera, dovrebbero produrre embedding vicini nello spazio vettoriale. Due persone diverse dovrebbero invece produrre embedding molto distanti.
Come funziona tecnicamente:
L’architettura di rete è generalmente una versione modificata di Inception-ResNet o ResNet, addestrata su milioni di immagini di volti. L’innovazione principale riguarda la funzione di perdita utilizzata durante l’addestramento, non l’architettura stessa.
- Perdita softmax (la base di riferimento): Tratta il riconoscimento facciale come un problema di classificazione. Funziona, ma produce embedding che non sono ben separati nello spazio angolare. È ormai in gran parte obsoleta per il riconoscimento.
- Perdita triplet: L’approccio reso popolare da FaceNet. La rete apprende confrontando triplette di volti ancora/positivo/negativo, avvicinando gli embedding della stessa identità e allontanando quelli di identità diverse. Richiede un’attenta selezione delle triplette difficili durante l’addestramento. Produce embedding altamente discriminativi.
- Perdita ArcFace: Probabilmente la funzione di perdita più utilizzata nei sistemi di riconoscimento facciale in produzione nel 2026. Aggiunge una penalità di margine angolare additivo nello spazio angolare tra il vettore delle caratteristiche e il peso della classe corrispondente, producendo raggruppamenti intra-classe più compatti e distanze inter-classe più ampie rispetto agli approcci con margine del coseno. Il progetto [InsightFace](https://github.com/deepinsight/insightface) fornisce l’implementazione di riferimento e la maggior parte dei modelli all’avanguardia viene addestrata con ArcFace o con una delle sue varianti; il margine adattivo di AdaFace, per esempio, si basa sulla formulazione di ArcFace. Se stai addestrando o perfezionando un tuo modello di riconoscimento facciale, ArcFace è il punto di partenza predefinito.
- Perdita CosFace: Aggiunge un margine del coseno alla perdita softmax, costringendo la rete a produrre embedding raggruppati più strettamente all’interno di ogni identità e più separati tra identità diverse.
- SphereFace / A-Softmax: L’approccio originale con margine angolare del 2017. Storicamente importante, ma in gran parte superato da ArcFace e da funzioni di perdita più moderne.
L’output: Un vettore di 512 valori in virgola mobile, normalizzato L2 sull’ipersfera unitaria. Tutte le informazioni su un volto, compresse in 2 KB di dati. È questo che viene memorizzato, indicizzato e confrontato.
La trappola della normalizzazione: Molti sviluppatori dimenticano che gli embedding devono essere normalizzati L2 prima del confronto. Gli embedding non normalizzati producono punteggi di somiglianza estremamente incoerenti. È un errore comune e difficile da diagnosticare perché il sistema «funziona quasi sempre»: l’ordinamento relativo delle corrispondenze può sembrare corretto durante i test, ma i punteggi assoluti di somiglianza variano tra le immagini, rendendo inaffidabili le decisioni basate su soglie. FaceNet512 produce embedding normalizzati per impostazione predefinita, ma se utilizzi un modello personalizzato o esegui l’esportazione tramite ONNX, verifica sempre che gli embedding di output si trovino sull’ipersfera unitaria, ossia che la loro norma L2 sia pari a 1,0.
Distribuzione in produzione: ONNX Runtime e quantizzazione: I dati sulla velocità riportati nei benchmark presuppongono inferenza FP32 su una GPU senza altri carichi. In produzione, la maggior parte dei sistemi viene distribuita tramite ONNX Runtime con quantizzazione INT8, che riduce i tempi di inferenza di 2-3 volte con una perdita minima di accuratezza, generalmente inferiore allo 0,1% su LFW. Il flusso di lavoro consiste nell’esportare il modello PyTorch o TensorFlow in ONNX, eseguire lo strumento di quantizzazione di ONNX Runtime con un set di calibrazione di circa 1.000 immagini di volti e distribuire il modello quantizzato. È così che si passa da «10 ms per volto» a «3-4 ms per volto» sullo stesso hardware, un fattore estremamente importante quando si elaborano miliardi di immagini.
Inferenza a precisione mista: L’utilizzo di FP16 sulla GPU per la struttura principale, mantenendo FP32 per il livello finale degli embedding, evita i problemi di precisione in virgola mobile descritti più avanti nell’articolo, offrendo comunque un incremento della velocità di 1,5-2 volte. È una soluzione intermedia pratica tra FP32 completo, accurato ma lento, e FP16 completo, veloce ma in grado di produrre embedding leggermente diversi su hardware differenti.
Distillazione degli embedding per la distribuzione edge: È possibile addestrare una rete student più piccola, come MobileFaceNet con circa 1 milione di parametri, affinché imiti gli embedding di FaceNet512 tramite distillazione della conoscenza. Il modello student raggiunge oltre il 95% dell’accuratezza a una velocità 10 volte superiore, risultando adatto alla distribuzione su dispositivi mobili ed edge dove non è possibile permettersi una GPU. L’intuizione fondamentale è che non occorre addestrare da zero il modello student usando etichette di identità facciale: lo si addestra a riprodurre gli embedding del modello teacher su dati facciali privi di etichette, richiedendo molta meno potenza di calcolo e nessun set di dati con identità etichettate.
Fase 4: confronto
Dati due embedding facciali, come si decide se appartengono alla stessa persona? Esistono due approcci:
Somiglianza del coseno: Calcola il coseno dell’angolo tra due vettori di embedding. L’intervallo va da -1 a 1, dove 1 indica identità perfetta. Una soglia tipica per stabilire che si tratti della «stessa persona» è 0,4-0,6, a seconda del modello e del caso d’uso. È semplice, veloce e funziona bene perché gli embedding di FaceNet512 sono normalizzati L2.
Distanza euclidea: Calcola la distanza L2 tra i vettori. Per gli embedding normalizzati, è matematicamente equivalente alla somiglianza del coseno (d = sqrt(2 - 2*cos_sim)). Alcuni sistemi preferiscono questa formulazione.
Per la ricerca (confronto 1:N): Quando occorre trovare un volto in un database di milioni di elementi, il confronto a forza bruta è troppo lento. Bisogna utilizzare la ricerca approssimata dei vicini più prossimi (ANN):
- FAISS (Facebook AI Similarity Search): La libreria standard. Supporta l’accelerazione GPU e diversi tipi di indice (IVF, HNSW, PQ). Può cercare tra 1 miliardo di vettori in pochi millisecondi. Gratuita e open source.
- Milvus: Database vettoriale appositamente progettato, con FAISS alla base e livelli aggiuntivi per persistenza, scalabilità e API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Opzioni di database vettoriali gestiti, se non vuoi occuparti dell’infrastruttura.
Per un database di 10 milioni di volti, un indice HNSW FAISS ben ottimizzato su una singola GPU può restituire le 10 corrispondenze migliori in meno di 5 millisecondi.
La scelta del tipo di indice FAISS è estremamente importante. IVF-PQ offre un’eccellente compressione, con 8-16 byte per vettore anziché 2 KB, ma perde accuratezza nelle corrispondenze al limite, dove l’errore di quantizzazione spinge una corrispondenza reale al di sotto della soglia. HNSW conserva l’accuratezza, ma utilizza una quantità di memoria da 4 a 8 volte maggiore perché memorizza sia i vettori completi in virgola mobile sia la struttura del grafo. Gli indici ibridi IVF-HNSW offrono il miglior compromesso su una scala da 10 milioni a 1 miliardo di elementi. Inizialmente, la maggior parte dei team sceglie il tipo di indice sbagliato seguendo i consigli dei tutorial e deve ricostruire l’intera infrastruttura di indicizzazione 6 mesi dopo, quando ne incontra i limiti. Prima di scegliere definitivamente un tipo di indice, testa il tuo carico di lavoro specifico con volumi di dati e modelli di query realistici.
Il problema dell’avvio a freddo per gli indici ANN: Gli indici HNSW e IVF hanno bisogno di un numero minimo di vettori per funzionare bene. Con meno di circa 10.000 vettori, la ricerca a forza bruta è in realtà più veloce di quella indicizzata, perché il sovraccarico dell’indice, dovuto all’attraversamento del grafo e al confronto dei centroidi, domina il calcolo. Nella fase iniziale di crescita, parti con la forza bruta (FAISS IndexFlatIP) e passa a un indice ANN quando il database supera i 50.000-100.000 vettori.
Prefiltraggio con codici binari: Calcolare un hash binario per ogni embedding, tramite binarizzazione o SimHash, consente di eseguire un economico prefiltraggio basato sulla distanza di Hamming prima dei più costosi confronti tra valori in virgola mobile. Ciò può ridurre di oltre il 90% l’insieme dei candidati con una perdita minima di richiamo. L’idea consiste nel memorizzare un codice binario da 256 o 512 bit insieme a ogni embedding completo. Per una query, si calcola prima la distanza di Hamming rispetto a tutti i codici binari, operazione estremamente veloce con le istruzioni POPCNT della CPU, si seleziona il migliore 1-5% dei candidati e solo allora si calcola la somiglianza esatta del coseno. Questo approccio in due fasi è particolarmente efficace quando il set di dati supera la memoria GPU disponibile.
Riordinamento tramite attributi facciali: La ricerca iniziale degli embedding restituisce i candidati; un secondo passaggio basato sugli attributi stimati, come fascia d’età, genere, tonalità della pelle e barba o baffi, può filtrare le corrispondenze palesemente errate. Se il volto della query viene stimato come quello di una donna di 25 anni e una corrispondenza candidata come quello di un uomo di 60 anni, si tratta quasi certamente di un falso positivo, indipendentemente dal punteggio di somiglianza degli embedding. Questa semplice euristica può ridurre i falsi positivi del 30-50% con un costo computazionale minimo ed è una delle tecniche più sottoutilizzate nella ricerca facciale in produzione.
Coerenza temporale nei video: Se si confrontano volti provenienti da video anziché da immagini statiche, calcolare la media degli embedding su più fotogrammi dello stesso volto tracciato migliora drasticamente l’accuratezza, spesso del 5-10% nei benchmark difficili. L’aggregazione degli embedding a livello di traccia è nettamente migliore del confronto a livello di singolo fotogramma. L’approccio consiste nell’utilizzare un sistema di tracciamento dei volti, come SORT o DeepSORT, per collegare i rilevamenti tra i fotogrammi, calcolare gli embedding per ciascun rilevamento e aggregarli in un unico «embedding di traccia» usando una media ponderata per la qualità, dove il peso corrisponde al punteggio di qualità del volto ottenuto nella fase di rilevamento.
I migliori modelli open source per il riconoscimento facciale (2026)
FaceNet512
Il punto di riferimento. FaceNet512 è la variante con embedding a 512 dimensioni dell’architettura FaceNet di Google e offre uno spazio di embedding più ampio e discriminativo rispetto alla versione originale a 128 dimensioni.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Architettura: Struttura Inception-ResNet-v2 che produce embedding a 512 dimensioni
- Licenza: MIT (permissiva, consente l’uso commerciale)
- Accuratezza su LFW: 99,65%
- Dimensione degli embedding: 512 dimensioni
- Include: Funziona con le pipeline di rilevamento standard (MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)) per il riconoscimento end-to-end
- API Python: Disponibile tramite la libreria
deepfaceo implementazioni autonome
Verdetto: Se stai sviluppando un sistema di riconoscimento facciale nel 2026, FaceNet512 è un ottimo punto di partenza. Offre eccellente accuratezza, embedding a 512 dimensioni dall’elevato potere discriminativo, una licenza MIT permissiva e un ampio supporto nell’ecosistema.
FaceNet (Google, versione originale a 128 dimensioni)
Il modello che ha reso popolare l’approccio degli embedding nel 2015. Ha introdotto l’addestramento con perdita triplet, nel quale la rete apprende confrontando triplette di volti ancora/positivo/negativo.
- Articolo originale: "FaceNet: A Unified Embedding for Face Recognition and Clustering" (Schroff et al., 2015)
- Repository: Diverse implementazioni (davidsandberg/facenet è la classica versione TensorFlow)
- Licenza: MIT
- Accuratezza su LFW: 99,63% (originale), fino al 99,75% con tecniche di addestramento moderne
- Dimensione degli embedding: 128 dimensioni
- Architettura: Inception-ResNet-v1 o Inception-ResNet-v2
Verdetto: Storicamente importante e ancora molto valido. L’embedding a 128 dimensioni è più compatto, ma leggermente meno discriminativo della variante FaceNet512 a 512 dimensioni. Usalo se ti serve un embedding meno ingombrante o se lavori in TensorFlow con vincoli di memoria.
DeepFace (Facebook/Meta)
Da non confondere con la libreria Python deepface in minuscolo. DeepFace di Meta (2014) è stato uno dei primi approcci di deep learning al riconoscimento facciale e ha raggiunto su LFW un’accuratezza prossima a quella umana.
Oggi il progetto più rilevante è la libreria Python deepface di Serengil:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repository: github.com/serengil/deepface
- Licenza: MIT
- Funzionalità: Libreria wrapper che fornisce un’API unificata per diversi modelli di backend: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib e SFace
- Include: Verifica, ricerca e analisi degli attributi facciali (età, genere, etnia ed emozione)
- Facilità d’uso: API estremamente semplice
Verdetto: La scelta migliore per prototipazione e sperimentazione. L’API unificata consente di passare da un modello all’altro modificando un solo parametro. In produzione, è preferibile utilizzare direttamente FaceNet512 per ottenere prestazioni e controllo migliori.
dlib
La libreria C++ con binding Python, mantenuta da Davis King. Include un modello di riconoscimento facciale addestrato su un set di dati di 3 milioni di immagini.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repository: github.com/davisking/dlib
- Licenza: Boost Software License (permissiva)
- Accuratezza su LFW: 99,38%
- Dimensione degli embedding: 128 dimensioni
- Rilevamento: Basato su HOG (veloce e adatto alle CPU) e su CNN (più accurato)
Verdetto: C++ estremamente solido e collaudato sul campo, con validi binding Python. L’accuratezza è inferiore a FaceNet512, ma l’affidabilità è eccellente. Una buona scelta se lavori in C++ o ti serve una soluzione leggera priva di dipendenze da PyTorch/ONNX.
AdaFace
Un modello più recente, del 2022, che affronta specificamente la variabilità della qualità delle immagini. I modelli standard vengono addestrati su immagini di alta qualità e peggiorano con input a bassa risoluzione o sfocati. AdaFace adatta durante l’addestramento la propria penalità di margine in base alla qualità dell’immagine.
- Repository: github.com/mk-minchul/AdaFace
- Licenza: MIT
- Vantaggio principale: Prestazioni superiori con immagini di bassa qualità (sorveglianza, telecamere a lunga distanza)
- Accuratezza su LFW: 99,82%
- IJB-C TAR@FAR=1e-4: 97,39% (supera la maggior parte dei modelli open source nei benchmark difficili)
Verdetto: Usalo quando le immagini di input sono di bassa qualità. Per la sorveglianza, l’analisi CCTV o qualsiasi scenario in cui non puoi controllare la qualità delle immagini, AdaFace offre risultati sensibilmente migliori rispetto ai modelli standard.
Tabella comparativa delle prestazioni
| Modello | LFW (%) | Embedding | Velocità (ms/volto) | Licenza |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512-d | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128-d | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512-d | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128-d | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2048-d | ~15 ms (GPU) | CC BY-SA |
LFW (Labeled Faces in the Wild) è il benchmark standard, ma può considerarsi sostanzialmente risolto. Ogni modello moderno supera il 99%. Le differenze reali emergono nei benchmark più difficili, come IJB-C, con condizioni variabili, e TinyFace, con immagini a bassa risoluzione.
Una nota sui benchmark rispetto alla realtà: Questi dati sulla velocità si riferiscono all’inferenza FP32 su un singolo volto con una GPU già a regime. In produzione, usando la quantizzazione INT8 di ONNX Runtime, ci si può aspettare una velocità 2-3 volte superiore. Bisogna tuttavia ricordare che l’intera pipeline, rilevamento + allineamento + valutazione della qualità + embedding, richiede da 3 a 5 volte più tempo della sola estrazione degli embedding. Una capacità di elaborazione end-to-end realistica per l’intera pipeline su una singola GPU A100 è di 200-400 volti al secondo, non le migliaia che potrebbero suggerire i benchmark limitati agli embedding.
Il divario tra modelli open source e sistemi di produzione
Ecco ciò che i tutorial non dicono: eseguire un modello di riconoscimento facciale in un notebook Jupyter è la parte facile. Costruire un sistema di produzione che funzioni davvero su larga scala richiede di risolvere una lunga serie di problemi ingegneristici che nessun modello risolve al posto tuo. La maggior parte dei team sottovaluta enormemente sia i costi sia i tempi. Quello che sembra un progetto in cui «basta collegare il modello» si trasforma in un lavoro ingegneristico di 12-24 mesi, che può facilmente assorbire da 500.000 a oltre 2 milioni di dollari prima di essere pronto per la produzione, senza contare i successivi costi operativi.
Il conto dell’infrastruttura
Calcolo GPU per l’estrazione degli embedding. Eseguire il rilevamento facciale e l’estrazione degli embedding su miliardi di immagini non è un’attività da svolgere su un portatile. Una singola GPU NVIDIA A100 può elaborare all’incirca 200-400 volti al secondo attraverso una pipeline completa di rilevamento + allineamento + embedding. Per elaborare 1 miliardo di immagini in tempi ragionevoli, per esempio meno di una settimana, serve un cluster di 40-80 GPU in funzione continua. Alle tariffe cloud, ciò equivale a 50.000-150.000 dollari per ogni ciclo di elaborazione, che dovrà essere ripetuto ogni volta che il modello migliora o la pipeline cambia. Acquistare direttamente l’hardware significa spendere 300.000-800.000 dollari in server GPU, oltre allo spazio nei rack, all’alimentazione, al raffreddamento e al personale necessario per la manutenzione.
Archiviazione su larga scala. 1 miliardo di embedding facciali da 512 valori in virgola mobile, 2 KB ciascuno, equivale a circa 2 TB di soli dati vettoriali. Aggiungendo immagini originali, miniature, metadati e strutture degli indici, si arriva a centinaia di terabyte o a pochi petabyte di spazio di archiviazione. Lo storage NVMe ad alte prestazioni per gli indici vettoriali costa nel cloud da 0,10 a 0,25 dollari per GB al mese. Con 50 TB di storage ad accesso frequente, si tratta di 5.000-12.500 dollari al mese solo per mantenere operativo il sistema.
Infrastruttura per la ricerca vettoriale. FAISS su una singola macchina raggiunge un limite compreso tra circa 100 e 500 milioni di vettori, a seconda del tipo di indice e della RAM disponibile. Oltre tale soglia, serve una ricerca distribuita tra più shard, con bilanciamento del carico, replica per la tolleranza ai guasti e RAM sufficiente a contenere gli indici. Un’installazione distribuita di Milvus o FAISS adatta alla produzione e capace di gestire oltre 1 miliardo di vettori richiede generalmente 8-16 macchine con molta memoria, ciascuna con almeno 256 GB di RAM, per un costo cloud di 15.000-40.000 dollari al mese.
Rete e larghezza di banda. Effettuare il crawling di miliardi di immagini significa scaricare petabyte di dati. Con costi di traffico in uscita compresi tra 0,05 e 0,09 dollari per GB presso i principali fornitori cloud, il solo trasferimento dei dati può costare decine di migliaia di dollari. Serve inoltre una rete interna ad alta capacità tra crawler, nodi di elaborazione GPU e backend di archiviazione.
Stima del costo totale dell’infrastruttura per un motore di ricerca facciale su scala web: 30.000-80.000 dollari al mese di costi cloud continuativi, oppure un investimento iniziale da 500.000 a 1,5 milioni di dollari in hardware, più 10.000-20.000 dollari al mese per energia, larghezza di banda e manutenzione. E questa è soltanto l’infrastruttura, prima ancora che un solo ingegnere scriva una riga di codice applicativo.
La tempistica ingegneristica
Costruire un sistema di ricerca facciale per la produzione non è un progetto da hackathon. Ecco una tempistica realistica per un team di 3-5 ingegneri esperti:
Mesi 1-3: pipeline principale. Rendere affidabili il rilevamento, l’allineamento e l’estrazione degli embedding. Costruire l’indice vettoriale di base. Gestire l’acquisizione delle immagini da file locali. Questa è la parte «divertente», in cui tutto sembra procedere bene e la demo appare notevole.
Mesi 3-6: infrastruttura di crawling web. Sviluppare scraper per le principali piattaforme. Gestire limitazioni di frequenza, CAPTCHA, barriere di accesso, rendering dinamico dei siti con molto JavaScript, deduplicazione delle immagini e filtraggio dei contenuti. Scoprire che ogni piattaforma social adotta misure anti-scraping diverse, che compromettono i crawler ogni settimana. Creare sistemi di monitoraggio capaci di rilevare quando i crawler smettono di funzionare senza segnalare errori. Questa fase può da sola richiedere più tempo del previsto, perché il web è disordinato e ostile.
Mesi 6-9: scalabilità e affidabilità. Il prototipo funzionava con 1 milione di volti. Ora bisogna farlo funzionare con 100 milioni. Scoprire che l’indice FAISS non entra più nella RAM. Implementare lo sharding. Correggere le race condition nella pipeline di acquisizione. Creare logiche di ripetizione per il 15% delle immagini che non vengono scaricate. Gestire immagini danneggiate, immagini dichiarate JPEG ma che non lo sono, immagini con flag di rotazione EXIF e download troncati. Aggiungere monitoraggio, avvisi e registrazione degli eventi per sapere quando qualcosa si guasta alle 3 del mattino.
Mesi 9-12: qualità e accuratezza. Accorgersi che il tasso di falsi positivi su larga scala è inaccettabile. Implementare un sistema di valutazione della qualità facciale per filtrare gli embedding inutilizzabili. Ottimizzare le soglie per ciascun caso d’uso. Creare un meccanismo di feedback che consenta di segnalare e analizzare le corrispondenze errate. Scoprire che il modello produce risultati diversi su architetture GPU differenti a causa delle differenze nella precisione in virgola mobile e dedicare due settimane a individuarne la causa.
Mesi 12-18: consolidamento per la produzione. Creare un livello API con autenticazione, limitazione della frequenza e monitoraggio dell’utilizzo. Aggiungere funzionalità di conformità a GDPR/CCPA: meccanismi di esclusione, richieste di cancellazione dei dati e registri di audit. Implementare la cache dei risultati. Creare strumenti amministrativi. Scrivere la documentazione. Gestire l’audit di sicurezza. Sottoporre tutto a test di carico. Correggere le perdite di memoria di cui non si conosceva l’esistenza.
Mesi 18-24: attività operative continuative. I crawler smettono di funzionare quando i siti modificano il proprio layout. Le prestazioni dei modelli cambiano con la comparsa di nuovi tipi di immagini. I dischi si riempiono. Gli indici devono essere ricostruiti. Gli utenti segnalano casi limite mai previsti. Qualcuno scopre che il sistema restituisce corrispondenze con elevata sicurezza per volti dei cartoni animati e diventa necessario aggiungere un filtro per i «volti reali». Tutto questo non finisce mai.
L’elenco completo dei problemi che incontrerai
Oltre all’infrastruttura e alle tempistiche, ecco tutti i principali problemi incontrati dai team che sviluppano da zero sistemi di riconoscimento facciale. Questo elenco deriva da sistemi reali in produzione, non da preoccupazioni teoriche.
Incubi legati alla qualità dei dati:
- Dati scadenti in ingresso, risultati scadenti in uscita. Internet è pieno di meme, volti generati dall’IA, disegni, foto di fotografie, copertine di riviste e statue. Il rilevatore troverà «volti» in tutti questi contenuti e produrrà embedding che inquineranno l’indice. Servono classificatori per filtrare volti sintetici, volti illustrati, ritagli a risoluzione estremamente bassa e contenuti non fotografici. Sviluppare e mantenere questi filtri è di per sé un progetto.
- Immagini duplicate e quasi duplicate. La stessa foto appare su decine di siti con ritagli, filigrane, livelli di compressione e regolazioni cromatiche differenti. Senza deduplicazione, una singola foto virale genera centinaia di «corrispondenze» che sono tutte la stessa immagine, sommergendo i risultati reali. L’hashing percettivo, come pHash e dHash, aiuta ma non è perfetto. Serve una deduplicazione a più livelli: a livello di URL, che è banale; tramite hash percettivo, che individua copie ridimensionate e ricompresse; e a livello di embedding, che individua lo stesso volto fotografato da angolazioni leggermente diverse. Ogni livello rileva elementi che gli altri non individuano e la deduplicazione richiederà più tempo di quanto immagini.
- Cambiamenti di età e aspetto. L’embedding facciale ricavato dalla foto universitaria di una persona potrebbe non corrispondere a quello di una foto scattata 15 anni dopo. Variazioni di peso, invecchiamento, chirurgia estetica, barba o baffi e acconciature diverse influenzano tutti l’accuratezza del riconoscimento. Nessun modello gestisce perfettamente questi aspetti. Gli utenti daranno la colpa al sistema quando non riuscirà a riconoscere qualcuno a distanza di 20 anni.
- Bias demografico. I modelli open source addestrati prevalentemente su set di dati occidentali o caucasici ottengono risultati peggiori con altri gruppi demografici. Le differenze di accuratezza tra etnie sono maggiori di quanto suggerisca LFW, il cui contenuto è caucasico per circa il 77%. In una distribuzione globale, le differenze di accuratezza tra gruppi demografici possono raggiungere il 5-15% nei benchmark difficili. Modelli come FaceNet512, addestrati su MS-Celeb-1M, ne ereditano lo squilibrio demografico. Per ottenere prestazioni eque, è importante eseguire il fine-tuning su set di dati bilanciati, come BUPT-Balancedface, oppure adottare strategie di addestramento attente agli aspetti demografici. Se non valuti l’accuratezza nei diversi gruppi etnici, potresti distribuire un sistema che funziona bene per alcuni utenti e male per altri. Non si tratta soltanto di una questione etica, ma anche di qualità del prodotto e responsabilità legale.
- Gestione dell’orientamento EXIF. Circa il 15-20% delle immagini presenti sul web contiene tag di orientamento EXIF che, se ignorati, producono volti ruotati lateralmente o capovolti. La maggior parte dei rilevatori facciali non riesce a individuare volti ruotati. È un fattore che compromette silenziosamente l’accuratezza, facile da non notare durante i test, nei quali si usano immagini correttamente orientate, ma devastante in produzione. Applica sempre la correzione dell’orientamento EXIF come primissimo passaggio della pipeline di elaborazione delle immagini.
- Errori di decodifica di JPEG progressivi e WebP. Alcune librerie di immagini producono silenziosamente dati pixel danneggiati da JPEG progressivi scaricati solo in parte o da file WebP troncati. Il rilevatore facciale potrebbe comunque trovare un «volto» negli artefatti dovuti alla corruzione e produrre un embedding inutilizzabile. Prima dell’elaborazione è necessario verificare l’integrità dell’immagine, controllando che il file venga decodificato senza errori e che il buffer di pixel risultante abbia dimensioni ragionevoli. In caso contrario, le immagini corrotte inquinano silenziosamente l’indice.
Problemi ingegneristici che inizialmente non sono evidenti:
- Versionamento degli embedding. Quando aggiorni il modello, e lo farai perché i miglioramenti dell’accuratezza contano, tutti gli embedding presenti nel database diventano incompatibili con l’output del nuovo modello. Le opzioni sono: ricalcolare gli embedding dell’intero database, operazione costosa e lenta che richiede di conservare tutte le immagini originali; eseguire indici paralleli durante la migrazione, raddoppiando il costo dell’infrastruttura; oppure mantenere la retrocompatibilità, soluzione complessa che limita la capacità di miglioramento. Non esiste una buona soluzione, soltanto alternative meno dolorose.
- Determinismo in virgola mobile. La stessa immagine elaborata su modelli GPU diversi, con versioni differenti di CUDA o persino con batch di dimensioni diverse, può produrre embedding leggermente differenti a causa dell’aritmetica in virgola mobile. Le differenze sono piccole, da 1e-6 a 1e-4, ma si accumulano: una corrispondenza con punteggio 0,401 su una macchina potrebbe ottenere 0,399 su un’altra, invertendo una decisione binaria basata sulla soglia. Durante il debug, tutto ciò può diventare esasperante. Gli aggiornamenti dei driver GPU sono particolarmente insidiosi: gli aggiornamenti dei driver NVIDIA possono modificare il comportamento in virgola mobile a livello CUDA. Un embedding calcolato con il driver 535.x può essere diverso da quello ottenuto dalla stessa immagine con il driver 545.x. In produzione, ciò significa dover bloccare le versioni dei driver nell’intero parco macchine e verificare la coerenza degli embedding dopo ogni aggiornamento.
- Concorrenza e race condition. Più crawler acquisiscono volti contemporaneamente, gli utenti eseguono query mentre l’indice viene aggiornato e arrivano richieste di cancellazione mentre vengono assemblati i risultati di ricerca. I database vettoriali non offrono lo stesso supporto maturo per le transazioni dei database SQL. Si verificheranno situazioni in cui un volto viene indicizzato solo parzialmente, le query restituiscono risultati obsoleti o una cancellazione non si propaga a tutti gli shard.
- Gestione della memoria. Gli indici FAISS sono mappati in memoria, ma le prestazioni delle query dipendono fortemente dalla porzione dell’indice che riesce a entrare nella RAM. Con la crescita dell’indice, la latenza delle query aumenta in modo imprevedibile quando il sistema operativo espelle dalla memoria le pagine dell’indice. Le terminazioni per memoria esaurita si verificano nel momento peggiore possibile. Imparerai a conoscere fin troppo bene la gestione della memoria di Linux, le impostazioni di swap e la topologia [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). Anche il riscaldamento dopo gli avvii a freddo è problematico: gli indici FAISS HNSW sono mappati in memoria, quindi dopo il riavvio di un server le prime centinaia di query sono da 10 a 100 volte più lente perché le pagine dell’indice non sono ancora state caricate nella RAM. Serve una fase di riscaldamento che precarichi l’indice prima di accettare traffico di produzione, altrimenti i primi utenti dopo una distribuzione subiranno una latenza terribile.
- Errori silenziosi. Un crawler smette di funzionare perché un sito ha modificato il proprio HTML. Un nodo di elaborazione GPU inizia a produrre embedding NaN a causa di un aggiornamento dei driver. Un disco si riempie e i nuovi volti smettono silenziosamente di essere indicizzati. Questi problemi non generano errori: degradano semplicemente e in silenzio il sistema. Senza monitoraggio completo e rilevamento delle anomalie, non te ne accorgerai finché gli utenti non si lamenteranno.
- Il problema dell’aggiornamento di FAISS. Quando si aggiungono nuovi embedding a un indice IVF, le celle di Voronoi diventano sbilanciate. La qualità della ricerca peggiora gradualmente finché non si riaddestra il quantizzatore. Su scala web, il riaddestramento richiede ore di calcolo GPU sull’intero set di dati. I team generalmente raggruppano le aggiunte e riaddestrano il sistema ogni settimana o ogni mese, il che significa che i volti acquisiti di recente non sono immediatamente ricercabili con la massima accuratezza. Bisogna sempre trovare un compromesso tra aggiornamento e qualità della ricerca, senza soluzioni gratuite.
- Calibrazione dei punteggi tra gli shard dell’indice. Quando l’indice è suddiviso tra più macchine, i punteggi grezzi di somiglianza provenienti da shard diversi non sono direttamente confrontabili, perché ciascuno shard ha una diversa distribuzione degli embedding. Per unire i risultati in modo significativo, serve una normalizzazione dei punteggi per ogni shard, come normalizzazione per coorte, Z-norm o T-norm. Senza calibrazione, un punteggio di 0,45 proveniente dallo shard A potrebbe rappresentare una corrispondenza forte, mentre lo stesso 0,45 proveniente dallo shard B potrebbe indicarne una mediocre. I risultati unificati diventano inaffidabili.
- Il problema del fan-out nella ricerca distribuita. Cercare in N shard significa effettuare N round trip di rete per ogni query. Se uno shard è lento per una pausa del garbage collector, un picco di I/O su disco o un problema di rete, l’intera query rallenta. La latenza P99 è determinata dal P99 dello shard più lento e peggiora con l’aumentare del numero di shard. Tecniche come le richieste ridondanti, inviando richieste duplicate e accettando quella che torna per prima, e i timeout adattivi sono essenziali per mantenere una latenza di coda accettabile.
Problemi di accuratezza e confronto:
- L’ottimizzazione delle soglie non è mai «finita». La soglia ottimale di somiglianza cambia con la crescita del database. Con 1 milione di volti, una soglia di 0,45 offre un buon equilibrio tra precisione e richiamo. Con 100 milioni di volti, la stessa soglia produce dieci volte più falsi positivi semplicemente perché esistono più sosia quasi corrispondenti. Servono soglie adattive o un riordinamento in post-elaborazione. La matematica sottostante è implacabile: quando il database passa da 1 milione a 100 milioni e poi a 1 miliardo di volti, la distribuzione dei punteggi di somiglianza top-k si sposta verso l’alto perché aumentano i sosia quasi corrispondenti. Una soglia fissa che produce un tasso di falsi positivi dello 0,1% con 1 milione di volti potrebbe produrne uno del 10% con 1 miliardo. Occorre modellare questa distribuzione e regolare dinamicamente le soglie, oppure accettare che la precisione peggiori con la scala.
- Riconoscimento open-set rispetto a closed-set. La maggior parte dei benchmark valuta le prestazioni closed-set, nelle quali è garantito che la persona cercata esista nel database. La ricerca facciale nel mondo reale è open-set: il volto della query potrebbe non esistere affatto nell’indice. La valutazione open-set richiede metriche completamente diverse, come TPIR a un FPIR fisso anziché accuratezza rank-1, e la modalità di errore consiste nelle false corrispondenze anziché nelle classifiche errate. Un sistema che raggiunge il 99% nei benchmark closed-set potrebbe presentare un tasso del 10% di false corrispondenze in una distribuzione open-set, perché restituisce con sicurezza il volto «più vicino» anche quando la corrispondenza reale non esiste. Gestire correttamente il caso «nessuna corrispondenza trovata» è importante quanto trovare le corrispondenze corrette.
- Sosia e doppelgänger. In un database di oltre 100 milioni di volti esistono molte coppie di persone senza alcun legame i cui embedding sono sorprendentemente vicini. Più grande è il database, più false corrispondenze si vedranno. Gli utenti segnaleranno regolarmente risultati riferiti alla «persona sbagliata». Serve una strategia per gestire questo problema: verifica con più foto, segnali contestuali come nome e posizione e code di revisione umana.
- Il riconoscimento indipendente dalla posa rimane difficile. Anche FaceNet512 peggiora notevolmente oltre una rotazione orizzontale di più o meno 60 gradi. L’accuratezza nel confronto tra profilo e volto frontale può calare del 10-20% rispetto al confronto tra due volti frontali. Negli scenari di sorveglianza, la maggior parte dei volti è inclinata, quindi l’accuratezza reale è sostanzialmente inferiore a quanto suggerito dai benchmark. I modelli addestrati con aumento dei dati sensibile al 3D o architetture come UV-GAN aiutano, ma aggiungono complessità. Se i dati di input contengono molte angolazioni marcate, considera questo aspetto un problema di accuratezza di primaria importanza, non un caso limite.
- Input avversari. Gli utenti invieranno volti generati dall’IA, deepfake, immagini trasformate e foto con perturbazioni intenzionali. Alcuni stanno testando il sistema, altri cercano di manipolare i risultati. Il sistema deve offrire una certa robustezza rispetto a questi input, altrimenti restituirà corrispondenze ad alta sicurezza per volti falsi.
- Manipolazione delle foto. Filtri, app di bellezza, trucco pesante e software di ritocco facciale. La realtà di Instagram rispetto alla realtà effettiva. Queste modifiche alterano la geometria facciale abbastanza da influenzare la somiglianza degli embedding. Un selfie pesantemente filtrato potrebbe non corrispondere alla foto non filtrata della stessa persona.
- Un volto, molti embedding. Una sola persona può avere online centinaia di foto provenienti da piattaforme, angolazioni e anni diversi. Bisogna restituirle tutte come corrispondenze separate o raggrupparle in un’unica identità? Il clustering su larga scala, con centinaia di milioni di volti, è computazionalmente costoso e introduce modalità di errore proprie: sovraaggregazione, cioè unione di due persone diverse, e sottoaggregazione, cioè mancato collegamento delle foto della stessa persona.
Grattacapi operativi:
- Corsa agli armamenti contro lo scraping. Tutte le principali piattaforme social bloccano attivamente gli scraper. Modificano la struttura delle pagine, aggiungono CAPTCHA, rilevano browser headless, limitano la frequenza per indirizzo IP, identificano le impronte delle richieste e talvolta mostrano contenuti esca. L’infrastruttura di crawling è coinvolta in una corsa agli armamenti continua. Uno scraper che funziona oggi potrebbe essere completamente bloccato la settimana prossima. La manutenzione dei crawler è un costo ingegneristico continuativo, non un’attività da svolgere una sola volta.
- Modellazione della frequenza di cambiamento. Fonti diverse si aggiornano a ritmi differenti. I siti di notizie sulle celebrità ricevono nuove foto ogni ora; i profili social personali potrebbero non cambiare per anni. Una pianificazione intelligente delle nuove scansioni, basata sui tassi storici di cambiamento, può ridurre i costi della larghezza di banda del 60-80%, mantenendo più aggiornato l’indice dove conta. Senza questa pianificazione, si scansionano troppo spesso le fonti statiche, sprecando banda e denaro, oppure troppo poco quelle dinamiche, fornendo risultati obsoleti.
- CDN e variazione geografica dei contenuti. Lo stesso URL può fornire immagini differenti in base alla posizione del richiedente, allo user-agent del dispositivo o ai cookie. Il crawler potrebbe indicizzare un’immagine diversa da quella visualizzata dall’utente, generando segnalazioni confuse secondo cui «la corrispondenza non assomiglia al risultato». Alcune CDN forniscono segnaposto a bassa risoluzione finché un vero browser non scorre la pagina portando l’immagine nell’area visibile. Bisogna gestire questi casi limite oppure accettare una certa percentuale di risultati fantasma.
- Crescita dei costi di archiviazione. Lo spazio occupato dalle immagini cresce linearmente e non smette mai. Non puoi eliminare gli originali se potresti doverne ricalcolare gli embedding. Miniature, metadati, vettori di embedding, file degli indici e copie di backup. Il costo dell’archiviazione accelera con la maturazione del sistema. I team che avevano preventivato lo storage per il primo anno restano sorpresi dai costi del terzo.
- Richieste di conformità su larga scala. Il GDPR conferisce alle persone il diritto di chiedere la cancellazione dei propri dati. Quando qualcuno presenta una richiesta di esclusione, devi trovare tutti gli embedding generati dal suo volto nell’intero database, eliminarli, assicurarti che non vengano aggiunti nuovamente quando i crawler ritrovano le immagini originali e documentare la cancellazione a fini di audit. Su larga scala, ciò richiede strumenti dedicati e lavoro ingegneristico. L’[EU AI Act](https://artificialintelligenceact.eu/) aggiunge ulteriori requisiti per i sistemi di IA ad alto rischio, compreso il riconoscimento facciale: valutazioni di conformità obbligatorie, test sui bias, obblighi di trasparenza e meccanismi di supervisione umana.
- Implementare l’esclusione è più difficile di quanto sembri. Non basta eliminare un embedding; bisogna impedirne la nuova indicizzazione quando il crawler incontra nuovamente lo stesso volto. Ciò richiede il mantenimento di un indice di «blocco» degli embedding facciali esclusi e il controllo di ogni nuovo embedding rispetto a tale indice prima dell’indicizzazione. La lista di blocco deve essere a sua volta veloce, poiché viene interrogata a ogni inserimento, e solleva nuovi interrogativi sulla conservazione dei dati: l’embedding facciale della persona che ha richiesto l’esclusione deve essere conservato permanentemente per poterlo confrontare, il che significa mantenere dati biometrici per rispettare una richiesta di cancellazione. Questa tensione giuridica è reale e rimane irrisolta in molte giurisdizioni.
- Il problema del consenso per i dati pubblici sottoposti a crawling. La base giuridica prevista dal GDPR per il trattamento di dati biometrici provenienti da profili social pubblici è oggetto di controversie legali. Diverse autorità europee per la protezione dei dati si sono pronunciate contro aziende di riconoscimento facciale, in particolare nelle decisioni relative a Clearview AI in vari Stati membri dell’UE. Il rischio legale dipende dalla giurisdizione, dalla fonte dei dati e dal caso d’uso. Non si tratta di una preoccupazione ipotetica per il futuro, ma di un ambito in cui sono già in corso attività sanzionatorie.
- Costi di archiviazione dei registri di audit. Se registri ogni query di ricerca e ogni corrispondenza restituita, come potrebbe richiedere la conformità, i log di audit possono crescere più rapidamente degli stessi dati facciali. Un sistema che gestisce 1 milione di ricerche al giorno con 10 risultati ciascuna genera circa 10 milioni di record di audit quotidiani. Gli obblighi di conservazione, spesso da 1 a 7 anni a seconda della giurisdizione, fanno sì che questi dati si accumulino senza sosta. Considera lo spazio per gli audit come una voce di costo primaria, non come un aspetto secondario.
- Risposta agli incidenti. Cosa succede quando il sistema associa erroneamente un volto e qualcuno intraprende un’azione sulla base di quella falsa corrispondenza? Servono registri di audit che mostrino come è stato generato ogni risultato, la capacità di spiegare le decisioni di confronto e una procedura per gestire le contestazioni. Quando qualcuno contesta una corrispondenza, dire «la somiglianza del coseno era 0,47, quindi superiore alla nostra soglia di 0,42» non è una spiegazione soddisfacente. Tecniche come GradCAM possono mostrare quali regioni del volto hanno determinato la corrispondenza, facilitando la risoluzione delle contestazioni e aumentando la fiducia. Non è soltanto buona ingegneria: a seconda della giurisdizione, potrebbe essere un obbligo legale.
- Obsolescenza di modelli e dipendenze. Le versioni di CUDA, Python e [ONNX Runtime](https://onnxruntime.ai/), così come gli aggiornamenti del sistema operativo, cambiano nel tempo e possono compromettere la pipeline di inferenza in modi poco evidenti. Bloccare le versioni aiuta, finché non diventa necessaria una patch di sicurezza. Dedicherai una quantità sorprendente di tempo alla gestione delle dipendenze e alla riproducibilità degli ambienti.
- Concentrazione delle conoscenze nel team. L’ingegnere che ha costruito il livello di indicizzazione FAISS comprende la logica dello sharding. Quello che ha ottimizzato i crawler sa quali siti richiedono una gestione speciale. Quando queste persone lasciano l’azienda, e in un progetto di 18-24 mesi il ricambio avviene, le conoscenze essenziali se ne vanno con loro. La documentazione aiuta, ma non cattura mai completamente il «perché» delle decisioni meno ovvie.
Riepilogo dei costi reali
Per un sistema di ricerca facciale su scala web che effettua ricerche nell’Internet pubblico:
- Team di ingegneri: 3-5 ingegneri senior per 12-24 mesi = da 600.000 a 2,5 milioni di dollari tra stipendi e costi indiretti
- Infrastruttura (1º anno): da 400.000 a 1 milione di dollari in costi cloud o hardware
- Infrastruttura (continuativa): 30.000-80.000 dollari al mese (360.000-960.000 dollari all’anno)
- Aspetti legali e conformità: 50.000-200.000 dollari per la valutazione iniziale, oltre alla consulenza continuativa
- Totale 1º anno: da 1,4 a 3,7 milioni di dollari
- Totale dal 2º anno in poi: da 500.000 a 1,2 milioni di dollari all’anno per infrastruttura + manutenzione ingegneristica
E questo per un sistema funzionante. Molti team spendono 6-12 mesi e oltre 500.000 dollari prima di rendersi conto che il problema è più difficile del previsto e passare a una soluzione API.
Quando sviluppare internamente e quando utilizzare un’API
Sviluppa un sistema tuo quando:
- Hai un set di dati chiuso, come badge dei dipendenti o foto dei clienti, con meno di 100.000 volti
- Il sistema deve funzionare in locale o su una rete isolata
- Disponi di ingegneri ML in grado di gestire l’ottimizzazione dei modelli, la regolazione delle soglie e i casi limite
- Il caso d’uso riguarda la verifica (1: 1) anziché la ricerca (1:N sul web)
- Hai il budget e il tempo necessari per impegnarti in un progetto ingegneristico pluriennale
Utilizza un’API quando:
- Devi cercare volti nell’Internet pubblico, inclusi social media, notizie e web
- Non vuoi sviluppare e mantenere una pipeline di web scraping e indicizzazione
- Ti servono risultati subito, non dopo 12-24 mesi di sviluppo
- Il sistema deve rimanere aggiornato con i nuovi contenuti pubblicati online
- Vuoi che qualcun altro gestisca la conformità al GDPR, le richieste di esclusione e l’EU AI Act
- Vuoi evitare oltre 1 milione di dollari di costi iniziali per infrastruttura e sviluppo
- Il tuo prodotto principale non è la ricerca facciale e il tempo degli ingegneri può essere impiegato meglio sul prodotto vero e proprio
API di ricerca facciale FaceCheck.id
Per gli sviluppatori che necessitano di una ricerca facciale sul web pubblico senza costruire da zero l’infrastruttura, FaceCheck.id offre un’API REST che gestisce l’intera pipeline: rilevamento, embedding e ricerca in un indice continuamente aggiornato di immagini facciali pubblicamente disponibili su social media, siti di notizie e nel web in generale.
FaceCheck.id utilizza un modello proprietario di riconoscimento facciale ottimizzato per la ricerca su scala web. A differenza dei modelli open source, che dovresti distribuire e ottimizzare autonomamente, il suo modello proprietario è specificamente addestrato e perfezionato per le difficoltà della ricerca facciale su Internet: qualità delle immagini estremamente variabile, condizioni di illuminazione diverse, varietà demografica e l’enorme scala dell’indice continuamente aggiornato tramite crawling. Questo approccio proprietario consente all’azienda di migliorare in modo indipendente le prestazioni del modello e di ottimizzarlo per la propria pipeline di ricerca in modi non accessibili ai modelli open source generici. Anni di sviluppo, test e perfezionamento sono stati dedicati a far funzionare il sistema a un livello che sarebbe estremamente difficile e costoso replicare da zero.
Cosa fa l’API:
Invii l’immagine di un volto e l’API restituisce i volti corrispondenti trovati su Internet, con punteggi di affidabilità e URL delle fonti. Il confronto, l’indicizzazione e l’infrastruttura su scala web vengono gestiti lato loro. Tutti i cluster GPU, le pipeline di crawling, l’infrastruttura di ricerca vettoriale, gli strumenti di conformità e la manutenzione continuativa descritti sopra sono un loro problema, non il tuo.
Caratteristiche di base dell’API:
- API JSON RESTful
- Autenticazione tramite chiave API
- Invio di un’immagine codificata in base64 o dell’URL di un’immagine
- Restituisce: array di corrispondenze con punteggi di somiglianza, URL delle fonti e anteprime in miniatura
- Limiti di frequenza e prezzi scalabili in base all’utilizzo
Integrazione tipica:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Casi d’uso dell’API:
- Verifica nelle app di incontri: Consenti agli utenti di verificare che le foto di una persona compaiano su profili social reali
- Protezione del marchio: Controlla se qualcuno utilizza le foto del tuo team per creare falsi profili aziendali
- Piattaforme di due diligence: Aggiungi la ricerca facciale ai flussi di controllo dei precedenti o KYC
- Sistemi antifrode: Segnala gli account che utilizzano foto presenti altrove su Internet con nomi diversi
- Strumenti OSINT: Crea strumenti investigativi che includano il confronto facciale su scala web
Perché utilizzare questa soluzione anziché crearne una propria:
La costruzione di un motore di ricerca facciale che esplori il web pubblico richiede: (1) una pipeline di crawling su scala web che scopra e scarichi miliardi di immagini, (2) un’infrastruttura GPU dal costo di centinaia di migliaia di dollari per eseguire il rilevamento facciale e l’estrazione degli embedding, (3) un sistema distribuito di ricerca vettoriale con terabyte di RAM per interrogare l’intero indice in tempo reale, (4) nuove scansioni continue per mantenere aggiornato l’indice, (5) un’infrastruttura di conformità per esclusioni, richieste di cancellazione dei dati e requisiti normativi, (6) un team di 3-5 ingegneri dedicati a tempo pieno alla manutenzione e (7) 12-24 mesi prima del rilascio della prima versione utilizzabile. È un progetto ingegneristico da diversi milioni di dollari, con costi continuativi significativi. L’API, basata sul modello proprietario e sull’infrastruttura collaudata di FaceCheck.id, offre tutto questo con una singola chiamata HTTP.
I modelli open source descritti sopra sono eccellenti per costruire sistemi chiusi di riconoscimento facciale, come controllo degli accessi dei dipendenti, organizzazione di raccolte fotografiche e flussi di verifica personalizzati. Ma se il caso d’uso è «cercare su Internet dove compare questo volto», la distanza ingegneristica tra un modello funzionante e un prodotto funzionante è enorme. L’API FaceCheck.id colma questa distanza, permettendoti di rilasciare un prodotto funzionante in pochi giorni anziché in anni.
Per iniziare: Visita facecheck.id/en/Face-Search/API per consultare la documentazione, i prezzi e registrare una chiave API.
Domande frequenti
Qual è il modello open source di riconoscimento facciale più accurato?
FaceNet512, con una struttura Inception-ResNet-v2, ottiene attualmente risultati eccellenti nella maggior parte dei benchmark, con il 99,65% su LFW. Negli scenari con immagini di bassa qualità, come sorveglianza e CCTV, AdaFace mostra prestazioni migliori nei benchmark difficili come IJB-C, con un TAR@FAR=1e-4 del 97,39%.
Posso utilizzare commercialmente i modelli open source di riconoscimento facciale?
Sì. FaceNet512, FaceNet, DeepFace, dlib e AdaFace sono tutti distribuiti con licenze permissive, MIT o Boost. Puoi utilizzarli in prodotti commerciali. Devi tuttavia tenere presenti le restrizioni legali sul trattamento dei dati biometrici nella tua giurisdizione, come GDPR, BIPA e EU AI Act, che si applicano indipendentemente dalla licenza del software.
Di quanti dati ho bisogno per addestrare un mio modello di riconoscimento facciale?
Non è necessario addestrarlo da zero. I modelli preaddestrati elencati sopra sono stati addestrati su set di dati composti da 5-12 milioni di immagini appartenenti a 100.000-500.000 identità. Usa questi modelli preaddestrati ed esegui il fine-tuning soltanto se hai un’esigenza specifica per il tuo settore. Il fine-tuning richiede generalmente 10.000-100.000 immagini. L’addestramento da zero richiede milioni di immagini e notevoli risorse GPU.
Qual è la differenza tra verifica facciale e ricerca facciale?
La verifica facciale (1:1) risponde alla domanda «queste due foto ritraggono la stessa persona?» confrontando direttamente due embedding. La ricerca facciale (1:N) risponde alla domanda «dove compare questa persona?» confrontando un embedding con un database di milioni di elementi. La verifica è computazionalmente semplice. La ricerca richiede un’indicizzazione efficiente dei vicini più prossimi, come FAISS o Milvus, e, per la ricerca su scala web, un’enorme infrastruttura di crawling e indicizzazione che può costare milioni di dollari tra sviluppo e gestione.
Quanto è accurato il riconoscimento facciale sulle immagini di bassa qualità?
L’accuratezza diminuisce notevolmente con la qualità dell’immagine. Sulle foto nitide e frontali, i modelli moderni raggiungono un’accuratezza superiore al 99%. Nei filmati di sorveglianza sfocati o nelle foto in cui il volto è largo meno di 50 pixel, l’accuratezza può scendere all’80-90% o anche meno. AdaFace è specificamente progettato per gestire le variazioni di qualità meglio dei modelli standard. Per qualsiasi sistema, immagini di input a risoluzione più elevata producono risultati drasticamente migliori. Anche la posa conta: l’accuratezza sui volti di profilo può diminuire del 10-20% rispetto ai volti frontali, persino nelle immagini ad alta risoluzione.
Quanto costa costruire un motore di ricerca facciale?
Per un sistema su scala web che effettua ricerche nell’Internet pubblico, bisogna prevedere costi da 1,4 a 3,7 milioni di dollari nel primo anno, comprendenti team di ingegneri, infrastruttura e aspetti legali, e successivamente da 500.000 a 1,2 milioni di dollari all’anno di costi continuativi. Per un sistema chiuso che effettua ricerche in un database privato con meno di 100.000 volti, i costi sono drasticamente inferiori: un solo server GPU e un ingegnere possono essere sufficienti. Il costo cresce in base alle dimensioni del database di ricerca e alla necessità o meno di sottoporre il web a crawling per popolarlo.
Quanto tempo serve per costruire un sistema di riconoscimento facciale pronto per la produzione?
Per un semplice sistema di verifica, con confronto 1:1 rispetto a un database noto, un ingegnere esperto può creare un prototipo funzionante in 1-2 settimane e renderlo pronto per la produzione in 1-3 mesi. Per un sistema di ricerca facciale su scala web, con confronto 1:N su Internet, sono necessari 12-24 mesi con un team di 3-5 ingegneri prima di ottenere qualcosa di abbastanza affidabile per la produzione. Le difficoltà di crawling, scalabilità e conformità aggiungono una quantità enorme di tempo rispetto al lavoro ML principale.
Costruisci qualcosa che conti. Per il tuo sistema chiuso, inizia con FaceNet512. Ma se ti serve una ricerca facciale su scala web, chiediti: vuoi davvero spendere da 1,4 a 3,7 milioni di dollari, assumere un team di ingegneri senior e attendere 12-24 mesi prima di ottenere il primo risultato utilizzabile? Puoi invece evitare completamente i cluster GPU, gli incubi del crawling, i problemi di conformità e anni di sviluppo, ottenendo i primi risultati di ricerca in meno di 5 minuti e partendo da appena 1 dollaro USA con l’API FaceCheck.id.
Leggi di più sulla ricerca inversa di immagini
C'è un sito di riconoscimento facciale GRATUITO?
Hai trovato una foto sospetta e vuoi sapere se quel volto compare da qualche altra parte online? Verificare se un profilo Instagram è autentico o scoprire dove finiscono le tue foto può sembrare un'impresa. Ma c'è un modo semplice per rintracciare qualsiasi volto sul web in pochi secondi.
Sull'argomento in altre lingue
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Argomenti popolari
Deepfake Identità Social Media Riconoscimento Facciale Facebook Instagram Ricerca Facciale Doppelgänger BiometricoPimEyes vs FaceCheck: Qual è il migliore per trovare volti online?