Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
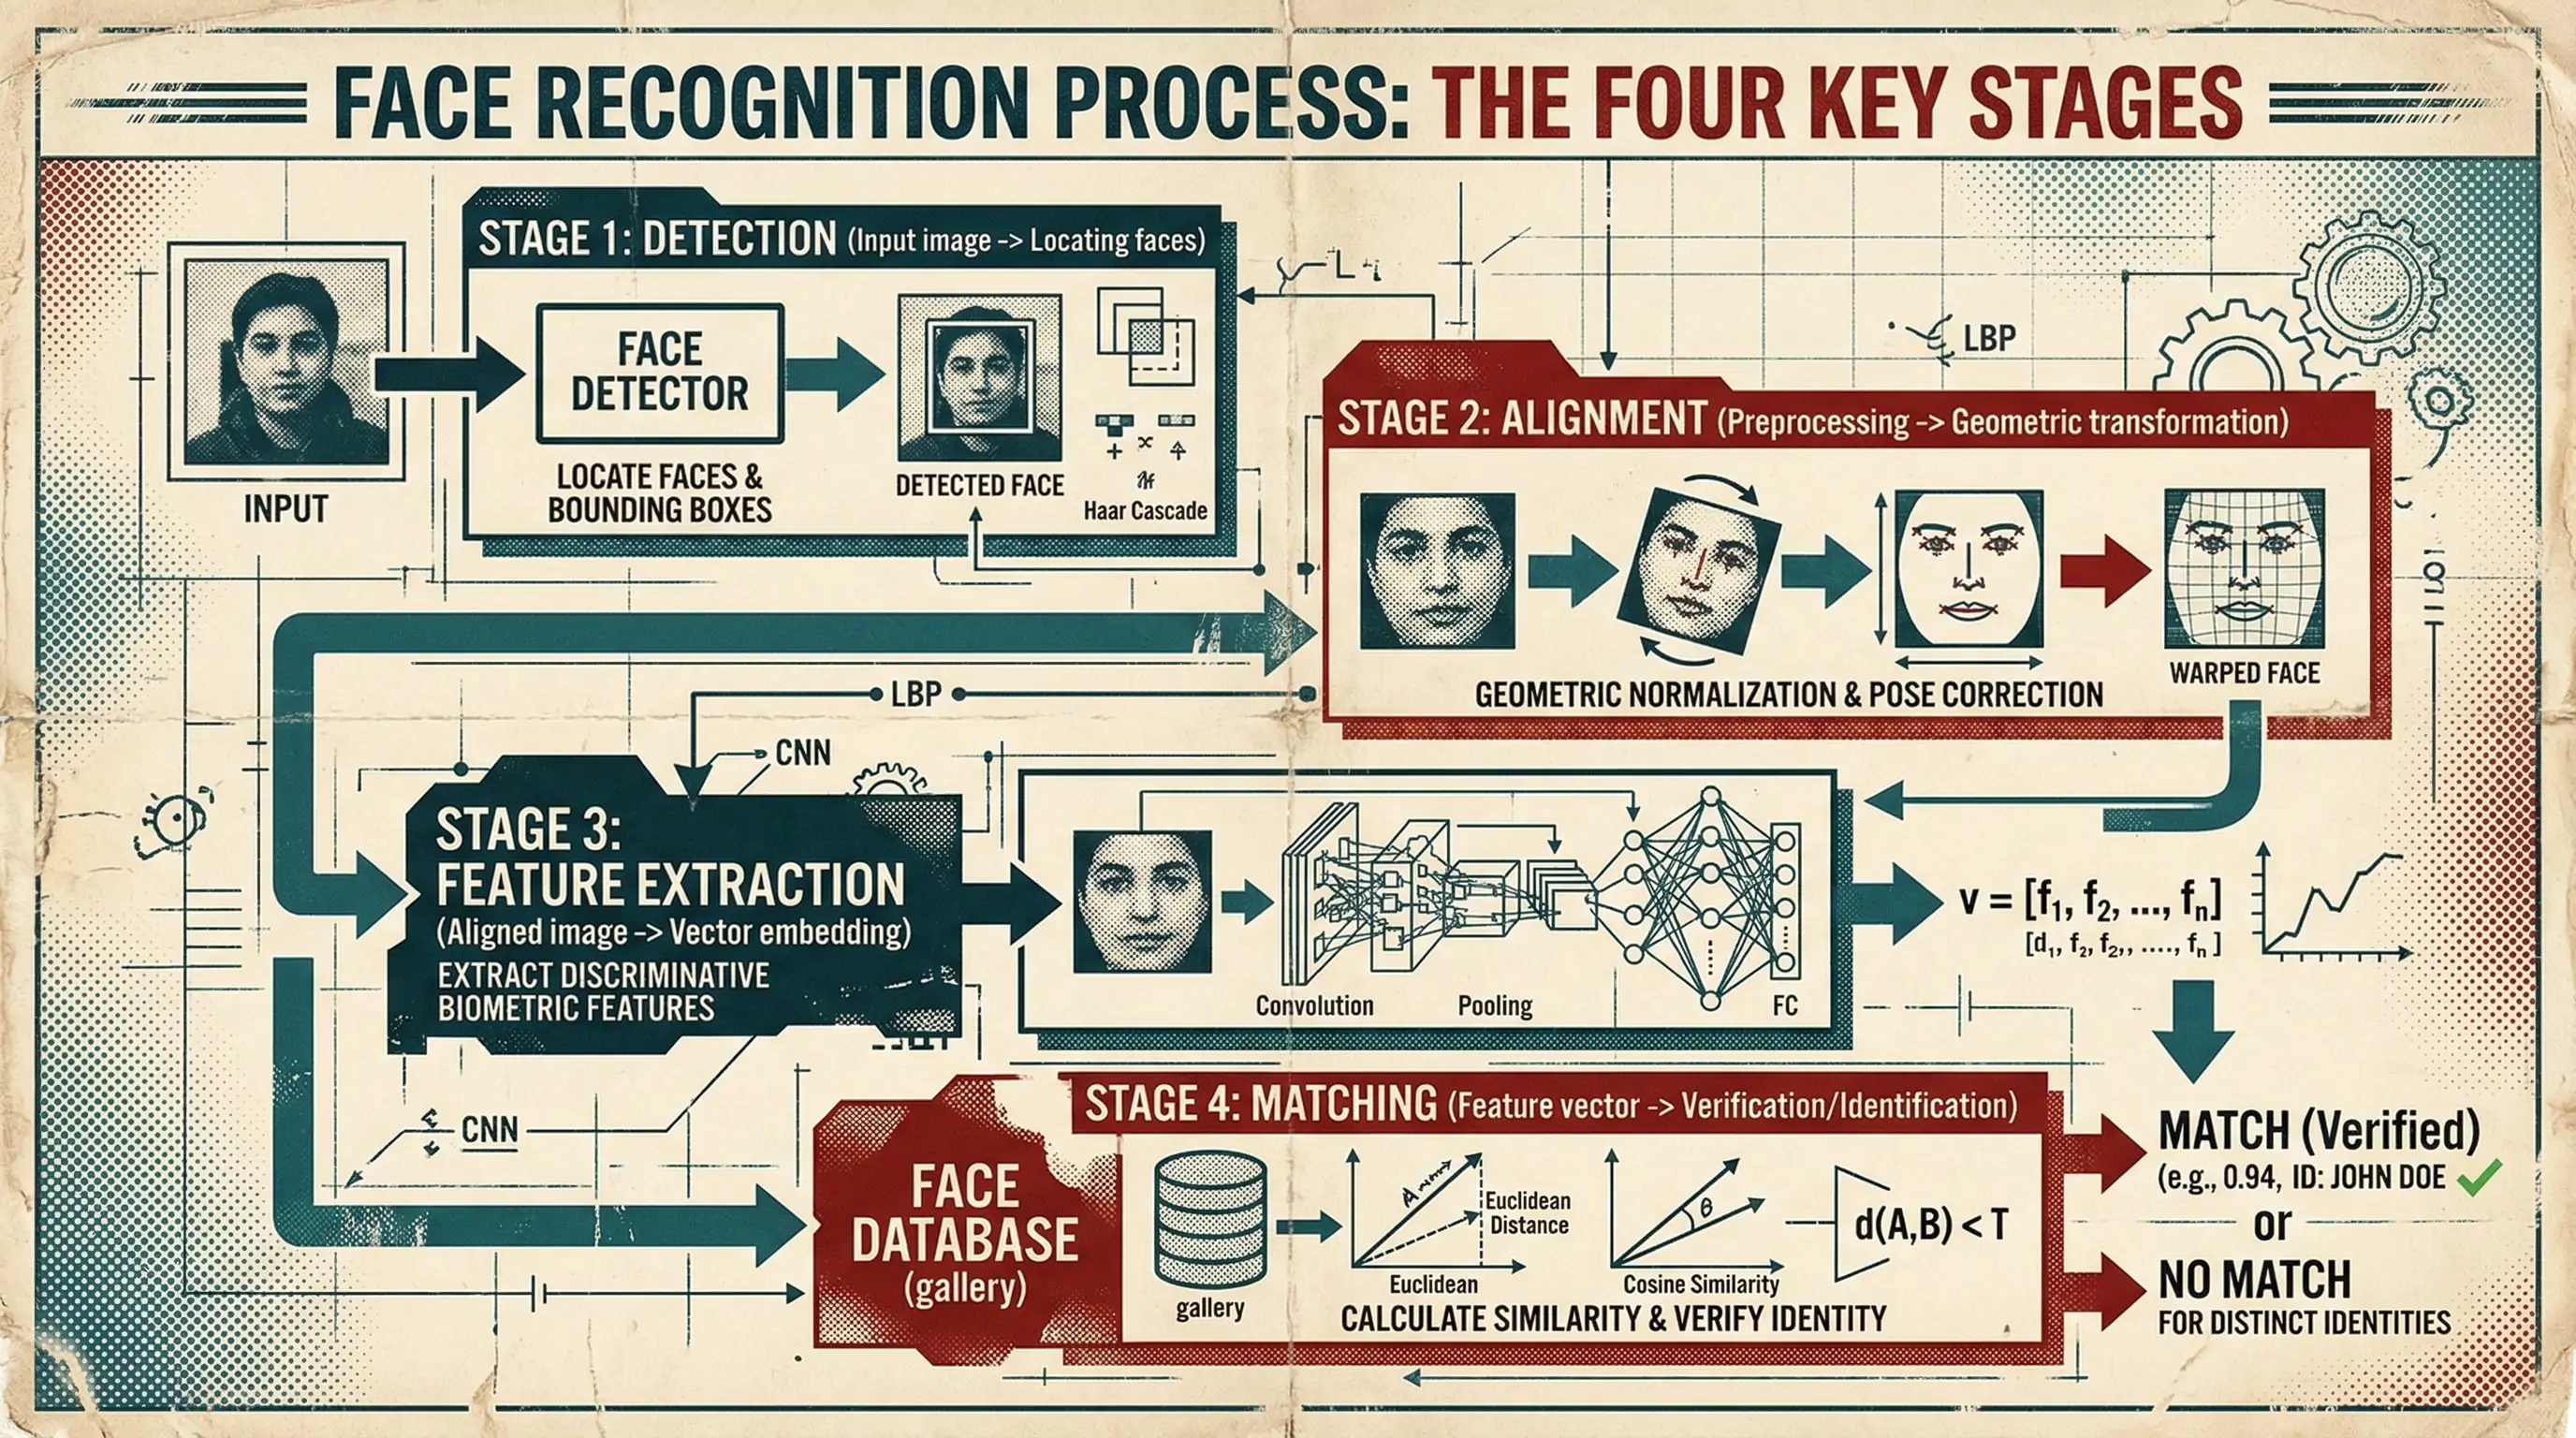
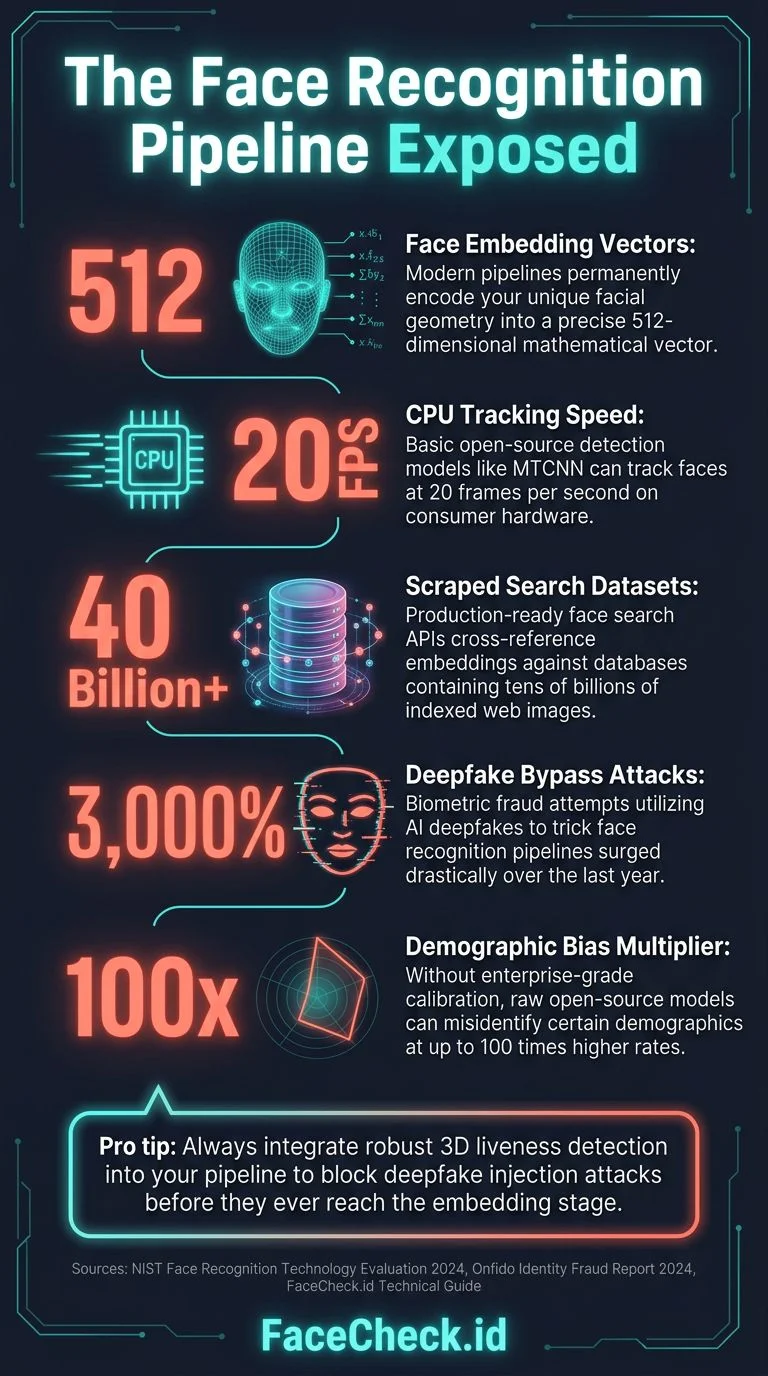
Yüzleri eşleştirmesi, fotoğrafla kimlik doğrulaması veya bir veri kümesinde yüz araması yapması gereken herhangi bir şey geliştiriyorsanız modern yüz tanımanın arka planda gerçekte nasıl çalıştığını anlamanız gerekir. Pazarlama anlatısını değil; ham piksellerden, kişinin benzersiz yüz geometrisini kodlayan 512 boyutlu bir gömme vektörüne kadar uzanan gerçek işlem hattını.
Bu makale yüz tanıma işlem hattının tamamını ele alıyor, 2026'da kullanılabilen en iyi açık kaynak modelleri karşılaştırıyor, gerçek performans rakamlarını gösteriyor ve hangi durumlarda kendi sisteminizi geliştirmenin, hangi durumlarda ise bir üretim API'si kullanmanın mantıklı olduğunu açıklıyor.
Bu makalede, tartışacağız
Yüz Tanıma İşlem Hattı: Dört Aşama
İster 35 dolarlık bir Raspberry Pi üzerinde ister bir devlet kurumundaki GPU kümesinde çalışsın, her modern yüz tanıma sistemi aynı temel işlem hattını izler. Bu dört aşamayı anlamak, herhangi bir modeli veya API'yi değerlendirmenize yardımcı olacaktır.
Aşama 1: Yüz Algılama
Bir yüzü tanıyabilmek için önce onu bulmanız gerekir. Yüz algılama, bir görüntüyü alır ve görüntüde bulunan her yüzün çevresindeki sınırlayıcı kutuları çıktı olarak verir. Bu kulağa basit gelse de birçok sistemin üretim ortamında başarısız olduğu nokta burasıdır.
Standart modeller:
- MTCNN (Çok Görevli Kademeli Evrişimli Ağlar): 2016'dan beri yüz algılamanın emektarıdır. Üç aşamalı bir kademeden oluşur: Öneri Ağı (P-Net) aday bölgeleri bulur, İyileştirme Ağı (R-Net) yanlış pozitifleri filtreler, Çıktı Ağı (O-Net) ise sınırlayıcı kutuları iyileştirip yüz işaret noktalarını üretir. Hâlâ yaygın olarak kullanılmaktadır. Önden görünen yüzlerde isabetlidir ancak aşırı açılar ve örtülmelerde zorlanır. Modern bir CPU'da yaklaşık 20 FPS hızında çalışır.
- RetinaFace: Algılama doğruluğunda en ileri düzeydedir. [Özellik Piramit Ağı](https://arxiv.org/abs/1612.03144) omurgası üzerine kurulu tek aşamalı bir algılayıcıdır. Sınırlayıcı kutularla birlikte beş yüz işaret noktası (gözler, burun, ağız köşeleri) döndürür. Farklı ölçekleri iyi işler. Doğruluk hızdan daha önemliyse başvurulacak seçenektir. GPU'da yaklaşık 15 FPS hızındadır, CPU'da ise daha yavaştır.
- SCRFD (Verimli Yüz Algılama için Örnek ve Hesaplama Yeniden Dağıtımı): Hız şampiyonudur. Mobil ve uç cihazlara dağıtım için tasarlanmıştır. RetinaFace düzeyinde doğruluğa 3-10 kat daha yüksek hızla ulaşır. 0,5 milyon ile 34 milyon arasında parametre içeren birden fazla model boyutu vardır. Mobil cihazlara dağıtım yapıyorsanız veya gerçek zamanlı işlemeye ihtiyacınız varsa aradığınız model budur.
- BlazeFace: Google'ın katkısıdır ve [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide) için tasarlanmıştır. Son derece hızlıdır (mobil GPU'larda 200 FPS'nin üzerinde çalışır) ancak zorlu açılarda doğruluktan bir miktar ödün verir. Her karenin işlenmesi gereken gerçek zamanlı video uygulamaları için uygundur.
Algılamada gerçekten önemli olan: Zor vakalar iyi aydınlatılmış özçekimler değildir. Gözetim görüntüleri, yüzlerin 50 piksel genişliğinde olduğu grup fotoğrafları, aşırı yan profiller ve güneş gözlüğü ya da maskeyle kısmen gizlenmiş yüzlerdir. Algılama modeliniz tüm sisteminizin ulaşabileceği üst sınırı belirler. Algılama bir yüzü kaçırırsa sonraki aşamalarda hiçbir şey bunu düzeltemez.
Çoklu yüz sorunu: Bir görüntü birden fazla yüz içerdiğinde hangi yüzün gömüleceğine karar vermeniz gerekir. Stratejiler arasında en büyük yüzü, merkeze en yakın yüzü veya kalite puanı en yüksek yüzü seçmek ya da tüm yüzleri gömüp sonraki mantığın bunları ayırmasını sağlamak bulunur. Her seçeneğin farklı başarısızlık biçimleri vardır. Grup fotoğraflarındaki tüm yüzleri gömmek dizinin şişmesine ve belirsiz arama sonuçlarına yol açar; yalnızca en büyük yüzü seçmek ise arka sırada duran kişiyi kaçırır. Çoğu üretim sistemi, asgari boyut eşiğinin üzerindeki tüm algılanmış yüzleri (genellikle gözler arasında 40-60 piksel) gömer ve bunları aynı kaynak görüntüye bağlı ayrı kayıtlar olarak ilişkilendirir.
Denetçi olarak yüz kalitesi puanlaması: Maliyetli gömmeleri hesaplamadan önce SER-FIQ gibi hafif bir kalite tahmincisi veya MagFace modelinin kalite dalını çalıştırmak, işe yaramaz verilerin dizininize girmesini baştan engeller. Bulanık kırpmalar, aşırı örtülmeler ve fazla pozlanmış yüzler, arama sonuçlarını kirleten düşük güvenilirlikli gömmeler üretir. Kalite eşiğinin altındaki yüzleri algılama aşamasında reddetmek, sonraki aşamaların kesinliğini büyük ölçüde artırır ve GPU çevrimlerinden tasarruf sağlar. Bu, tüm işlem hattındaki yatırım getirisi en yüksek optimizasyonlardan biridir.
Doğrulama için yüz sahteciliği önleme: Doğrulama senaryolarında sunum saldırısı algılama (PAD) kritik önemdedir. Kâğıt çıktılar, ekran tekrarları ve 3B maskelerin tümü gömme tabanlı sistemleri kandırabilir. CDCN veya PatchNet gibi modeller bu saldırıları algılar ancak yüz başına 5-15 ms gecikme ekler ve ek model bakımı gerektirir. Kullanıcının giriş görüntüsünü kontrol ettiği erişim kontrolü, KYC veya kimlik doğrulama gibi herhangi bir sistem geliştiriyorsanız sahtecilik önlemeyi mutlaka dâhil etmelisiniz; aksi hâlde sisteminiz istismar edilir.
Aşama 2: Yüz Hizalama
Bir yüzü algıladıktan sonra onu normalleştirmeniz gerekir. Farklı baş pozları, kamera açıları ve mesafeler, bir yüzün ham görüntüdeki görünümünü değiştirir. Hizalama, algılanan her yüzü standartlaştırılmış bir konuma dönüştürür: gözler aynı hizada, yüz merkezde ve ölçek tutarlıdır.
Standart yaklaşım, bir benzerlik dönüşümü hesaplamak için algılamadan gelen beş işaret noktasını (sol göz, sağ göz, burun ucu, sol ağız köşesi, sağ ağız köşesi) kullanır. Bu işlem, algılanan yüzü gözlerin sabit piksel koordinatlarında bulunduğu standart 160x160 piksellik bir kırpmaya eşler.
Bu adım eğitimlerde sıklıkla göz ardı edilir ancak kritik önemdedir. Hizalamadaki 2 derecelik bir döndürme hatası, tanıma doğruluğunu %1-3 düşürebilir. Çoğu açık kaynak işlem hattı bunu otomatik olarak yapar ancak özel bir sistem geliştiriyorsanız standart olarak FaceNet hizalama tanımını (160x160, belirli göz koordinatları) kullanın. Modern modellerin çoğu bu tanıma göre eğitilmiştir.
Hizalamanın işaret noktası doğruluğuna duyarlılığı: RetinaFace işaret noktalarında ortalama yaklaşık 2 piksellik hata vardır. Bu hata hizalama dönüşümüne yayılır ve özellikle 2 pikselin toplam yüz genişliğinin daha büyük bir bölümünü oluşturduğu küçük yüz kırpmalarında doğruluğun %1-5 azalmasına neden olabilir. Bazı üretim sistemleri, daha sıkı hizalama için ilk algılamadan sonra Adrian Bulat'ın face-alignment modeli gibi ikincil bir 68 veya 98 noktalı işaret noktası iyileştirmesi çalıştırır. Kullanım senaryonuz azami doğruluk gerektiriyorsa, özellikle de tek bir yanlış kararın sonuç doğurduğu 1:1 doğrulamada, yüz başına ek 3-5 ms buna değer.
Aşama 3: Özellik Çıkarma (Gömme)
Bu, yüz tanımanın özüdür. Derin bir sinir ağı, hizalanmış yüz görüntüsünü alır ve gömme ya da özellik vektörü adı verilen sabit uzunlukta (genellikle 512 boyutlu) bir vektör üretir. Bu vektör, yüzün benzersiz özelliklerinin kompakt sayısal temsilidir.
Aydınlatma, ifade, yaş (makul sınırlar içinde) veya kameradan bağımsız olarak aynı kişiye ait iki yüz, vektör uzayında birbirine yakın gömmeler üretmelidir. İki farklı kişi ise birbirinden uzak gömmeler üretmelidir.
Teknik olarak nasıl çalışır:
Ağ mimarisi genellikle milyonlarca yüz görüntüsü üzerinde eğitilmiş, değiştirilmiş bir Inception-ResNet veya ResNet modelidir. Temel yenilik mimarinin kendisinde değil, eğitim sırasında kullanılan kayıp fonksiyonundadır.
- Softmax kaybı (temel yaklaşım): Yüz tanımayı bir sınıflandırma problemi olarak ele alır. Çalışır ancak açısal uzayda iyi ayrıştırılmış gömmeler üretmez. Tanıma için büyük ölçüde kullanımdan kalkmıştır.
- Üçlü kayıp: FaceNet tarafından yaygınlaştırılan yaklaşımdır. Ağ; çapa/pozitif/negatif yüz üçlülerini karşılaştırarak öğrenir, aynı kimliğe ait gömmeleri birbirine yaklaştırır ve farklı kimliklere ait gömmeleri birbirinden uzaklaştırır. Eğitim sırasında zor üçlülerin dikkatli biçimde seçilmesini gerektirir. Son derece ayırt edici gömmeler üretir.
- ArcFace kaybı: 2026 itibarıyla üretim ortamındaki yüz tanıma sistemlerinde muhtemelen en yaygın kullanılan kayıp fonksiyonudur. Özellik vektörü ile karşılık gelen sınıf ağırlığı arasındaki açısal uzaya toplamsal bir açısal marj cezası ekleyerek, kosinüs marjlı yaklaşımlara kıyasla sınıf içi kümeleri daha sıkı ve sınıflar arası boşlukları daha geniş hâle getirir. [InsightFace](https://github.com/deepinsight/insightface) projesi referans uygulamayı sağlar ve en ileri modellerin çoğu ArcFace ya da onun türevlerinden biriyle eğitilir (örneğin AdaFace'in uyarlanabilir marjı, ArcFace formülünün üzerine kuruludur). Kendi yüz tanıma modelinizi eğitiyor veya ince ayar yapıyorsanız varsayılan başlangıç noktası ArcFace'tir.
- CosFace kaybı: Softmax kaybına kosinüs marjı ekleyerek ağı, her kimlik içinde daha sıkı kümelenen ve kimlikler arasında daha fazla ayrışan gömmeler üretmeye zorlar.
- SphereFace / A-Softmax: 2017'de geliştirilen özgün açısal marj yaklaşımıdır. Tarihsel açıdan önemlidir ancak yerini büyük ölçüde ArcFace ve daha modern kayıp fonksiyonlarına bırakmıştır.
Çıktı: Birim hiperküreye L2 ile normalleştirilmiş, 512 kayan noktalı sayıdan oluşan bir vektör. Bir yüz hakkındaki tüm bilgi 2 KB veriye sıkıştırılır. Depolanan, dizine eklenen ve karşılaştırılan şey budur.
Normalleştirme tuzağı: Birçok geliştirici, karşılaştırmadan önce gömmelerin L2 ile normalleştirilmesi gerektiğini unutur. Normalleştirilmemiş gömmeler son derece tutarsız benzerlik puanları üretir. Bu, teşhis edilmesi zor ve yaygın bir hatadır çünkü sistem “çoğunlukla çalışır”; eşleşmelerin göreli sıralaması testlerde doğru görünebilir ancak mutlak benzerlik puanları görüntüler arasında kayar ve eşik tabanlı kararları güvenilmez hâle getirir. FaceNet512 varsayılan olarak normalleştirilmiş gömmeler üretir ancak özel bir model kullanıyor veya ONNX aracılığıyla dışa aktarıyorsanız çıktı gömmelerinizin birim hiperküre üzerinde bulunduğunu (yani L2 normlarının 1,0'a eşit olduğunu) daima doğrulayın.
Üretime dağıtım: ONNX Runtime ve niceleme: Karşılaştırmalı testlerdeki hız değerleri, temiz bir GPU üzerinde FP32 çıkarımı varsayar. Üretimde çoğu sistem, çıkarım süresini çok az doğruluk kaybıyla (LFW'de genellikle <%0,1) 2-3 kat azaltan INT8 nicelemesiyle ONNX Runtime üzerinden dağıtılır. İş akışı şöyledir: PyTorch veya TensorFlow modelinizi ONNX'e aktarın, yaklaşık 1.000 yüz görüntüsünden oluşan bir kalibrasyon veri kümesiyle ONNX Runtime niceleme aracını çalıştırın ve nicelenmiş modeli dağıtın. Aynı donanımda “yüz başına 10 ms” değerinden “yüz başına 3-4 ms” değerine bu şekilde inersiniz; milyarlarca görüntü işlerken bunun önemi çok büyüktür.
Karma hassasiyetli çıkarım: Omurga için GPU'da FP16, son gömme katmanı içinse FP32 kullanmak, bu makalenin ilerleyen bölümlerinde açıklanan kayan nokta hassasiyeti sorunlarını önlerken yine de 1,5-2 kat hızlanma sağlar. Bu, tam FP32 (isabetli ama yavaş) ile tam FP16 (hızlı ancak farklı donanımlarda küçük farklılıklar içeren gömmeler üretebilir) arasında pratik bir orta yoldur.
Uç cihazlara dağıtım için gömme damıtma: Daha küçük bir öğrenci ağı (MobileFaceNet, yaklaşık 1 milyon parametre) bilgi damıtma yoluyla FaceNet512'nin gömmelerini taklit edecek şekilde eğitilebilir. Öğrenci model, 10 kat hızla doğruluğun %95'inden fazlasını elde eder; bu da GPU kullanamayacağınız mobil ve uç cihaz dağıtımlarını uygulanabilir kılar. Buradaki temel fikir, öğrenciyi yüz kimliği etiketleriyle sıfırdan eğitmek zorunda olmamanızdır. Onu etiketsiz yüz verilerinde öğretmenin gömmelerini yeniden üretmek üzere eğitirsiniz; bu da çok daha az hesaplama gücü gerektirir ve kimlik etiketli bir veri kümesine ihtiyaç duymaz.
Aşama 4: Eşleştirme
İki yüz gömmesinin aynı kişiye ait olup olmadığına nasıl karar verirsiniz? İki yaklaşım vardır:
Kosinüs benzerliği: İki gömme vektörü arasındaki açının kosinüsünü hesaplayın. Aralık -1 ile 1'dir ve 1 özdeş oldukları anlamına gelir. “Aynı kişi” için tipik eşik, modelinize ve kullanım senaryonuza bağlı olarak 0,4-0,6'dır. Basit ve hızlıdır; FaceNet512 gömmeleri L2 ile normalleştirildiği için iyi çalışır.
Öklid uzaklığı: Vektörler arasındaki L2 uzaklığını hesaplayın. Normalleştirilmiş gömmelerde bu, matematiksel olarak kosinüs benzerliğine eşdeğerdir (d = sqrt(2 - 2*cos_sim)). Bazı sistemler bu formülü tercih eder.
Arama için (1:N eşleştirme): Milyonlarca kayıttan oluşan bir veri tabanında yüz bulmanız gerektiğinde kaba kuvvet karşılaştırması çok yavaştır. Yaklaşık en yakın komşu (ANN) aramasını kullanın:
- FAISS (Facebook AI Benzerlik Araması): Standart kütüphanedir. GPU hızlandırmayı ve birden fazla dizin türünü (IVF, HNSW, PQ) destekler. 1 milyar vektörü milisaniyeler içinde arayabilir. Ücretsiz ve açık kaynaklıdır.
- Milvus: Arka planda FAISS'in yanı sıra kalıcılık, ölçekleme ve API katmanları sunan, amaca özel geliştirilmiş bir vektör veri tabanıdır.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Altyapıyı kendiniz çalıştırmak istemiyorsanız yönetilen vektör veri tabanı seçenekleridir.
10 milyon yüz içeren bir veri tabanında, tek bir GPU üzerindeki iyi ayarlanmış FAISS HNSW dizini en iyi 10 eşleşmeyi 5 milisaniyeden kısa sürede döndürebilir.
FAISS dizin türü seçimi son derece önemlidir. IVF-PQ mükemmel sıkıştırma sağlar (vektör başına 2 KB yerine 8-16 bayt) ancak niceleme hatasının gerçek bir eşleşmeyi eşiğin altına ittiği sınırdaki eşleşmelerde doğruluk kaybeder. HNSW doğruluğu korur ancak tam kayan noktalı vektörleri ve grafik yapısını depoladığı için 4-8 kat daha fazla bellek kullanır. IVF-HNSW hibrit dizinleri, 10 milyon-1 milyar ölçeğinde en iyi dengeyi sunar. Çoğu ekip başlangıçta eğitimlerdeki önerilere dayanarak yanlış dizin türünü seçer ve sınırlara ulaştığında, 6 ay sonra tüm dizin altyapısını yeniden kurmak zorunda kalır. Bir dizin türünü seçmeden önce kendi iş yükünüzü gerçekçi veri hacimleri ve sorgu örüntüleriyle test edin.
ANN dizinlerinin soğuk başlangıç sorunu: HNSW ve IVF dizinlerinin iyi çalışması için asgari sayıda vektöre ihtiyacı vardır. Yaklaşık 10 bin vektörden daha azında, dizin yükü (grafik geçişi, merkez karşılaştırması) hesaplamaya baskın geldiğinden kaba kuvvet araması aslında dizinli aramadan daha hızlıdır. İlk büyüme aşamanızda kaba kuvvetle (FAISS IndexFlatIP) başlayın ve veri tabanınız 50-100 bin vektörü geçtiğinde ANN dizinine geçin.
İkili kodlarla ön filtreleme: Her gömmenin ikili özetini (ikileştirme veya SimHash yoluyla) hesaplamak, maliyetli kayan nokta karşılaştırmalarından önce ucuz bir Hamming uzaklığı ön filtresi uygulamanızı sağlar. Bu, geri çağırma oranında çok az kayıpla aday kümesini %90'dan fazla azaltabilir. Fikir şudur: her tam gömmenin yanında 256 bitlik veya 512 bitlik ikili bir kod saklayın. Bir sorguda önce tüm ikili kodlara olan Hamming uzaklığını hesaplayın (CPU POPCNT komutlarıyla son derece hızlıdır), en iyi %1-5'lik adayları alın ve yalnızca bunlar için kesin kosinüs benzerliğini hesaplayın. Bu iki aşamalı yaklaşım, veri kümeniz kullanılabilir GPU belleğini aştığında özellikle etkilidir.
Yüz özellikleriyle yeniden sıralama: İlk gömme araması adayları döndürür; tahmin edilen özellikleri (yaş aralığı, cinsiyet, ten rengi, sakal/bıyık) kullanan ikinci bir geçiş bariz yanlış eşleşmeleri filtreleyebilir. Sorgu yüzünün 25 yaşında bir kadın olduğu, aday eşleşmenin ise 60 yaşında bir erkek olduğu tahmin ediliyorsa gömme benzerliği puanı ne olursa olsun bu neredeyse kesinlikle yanlış pozitiftir. Bu basit sezgisel yöntem, çok düşük hesaplama maliyetiyle yanlış pozitifleri %30-50 azaltabilir ve üretim ortamındaki yüz aramasında en az kullanılan tekniklerden biridir.
Videoda zamansal tutarlılık: Sabit görüntüler yerine videodaki yüzleri eşleştiriyorsanız aynı takip edilen yüzün birden fazla karesindeki gömmelerin ortalamasını almak doğruluğu büyük ölçüde artırır (zor karşılaştırmalı testlerde çoğu zaman %5-10). İz düzeyinde gömme birleştirme, kare düzeyinde eşleştirmeden kesinlikle daha iyidir. Yaklaşım şöyledir: kareler arasındaki algılamaları bağlamak için bir yüz takipçisi (SORT veya DeepSORT gibi) kullanın, her algılama için gömme hesaplayın ve algılama aşamasındaki yüz kalite puanının kalite ağırlığı olarak kullanıldığı kalite ağırlıklı ortalamayla bunları tek bir “iz gömmesinde” birleştirin.
En İyi Açık Kaynak Yüz Tanıma Modelleri (2026)
FaceNet512
Altın standart. FaceNet512, Google'ın FaceNet mimarisinin 512 boyutlu gömme türevidir ve özgün 128 boyutlu sürümden daha geniş ve daha ayırt edici bir gömme uzayı sunar.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Mimari: 512 boyutlu gömmeler üreten Inception-ResNet-v2 omurgası
- Lisans: MIT (izin verici, ticari kullanım uygundur)
- LFW doğruluğu: %99,65
- Gömme boyutu: 512 boyut
- İçerik: Uçtan uca tanıma için standart algılama işlem hatlarıyla (MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)) çalışır
- Python API'si:
deepfacekütüphanesi veya bağımsız uygulamalar aracılığıyla kullanılabilir
Sonuç: 2026'da bir yüz tanıma sistemi geliştiriyorsanız FaceNet512 güçlü bir başlangıç noktasıdır. Mükemmel doğruluk, yüksek ayırt etme gücü için 512 boyutlu gömmeler, izin verici MIT lisansı ve geniş ekosistem desteği sunar.
FaceNet (Google, Özgün 128 Boyutlu Sürüm)
2015'te gömme yaklaşımını yaygınlaştıran modeldir. Ağın çapa/pozitif/negatif yüz üçlülerini karşılaştırarak öğrendiği üçlü kayıp eğitimini tanıtmıştır.
- Özgün makale: "FaceNet: Yüz Tanıma ve Kümeleme için Birleşik Bir Gömme" (Schroff ve diğerleri, 2015)
- Depo: Birden fazla uygulama (davidsandberg/facenet klasik TensorFlow sürümüdür)
- Lisans: MIT
- LFW doğruluğu: %99,63 (özgün), modern eğitimle %99,75'e kadar
- Gömme boyutu: 128 boyut
- Mimari: Inception-ResNet-v1 veya Inception-ResNet-v2
Sonuç: Tarihsel açıdan önemlidir ve hâlâ iyi çalışır. 128 boyutlu gömme daha kompakttır ancak 512 boyutlu FaceNet512 türevinden biraz daha az ayırt edicidir. Daha küçük bir gömme alanına ihtiyacınız varsa veya bellek kısıtlamaları altında TensorFlow ile çalışıyorsanız kullanın.
DeepFace (Facebook/Meta)
Küçük harfle yazılan deepface Python kütüphanesiyle karıştırılmamalıdır. Meta'nın DeepFace modeli (2014), LFW'de insana yakın doğruluğa ulaşan ilk derin öğrenme tabanlı yüz tanıma yaklaşımlarından biriydi.
Günümüzde daha ilgili proje, Serengil tarafından geliştirilen deepface Python kütüphanesidir:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Depo: github.com/serengil/deepface
- Lisans: MIT
- Ne yapar: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib ve SFace gibi birden fazla arka uç modeli için birleşik API sağlayan sarmalayıcı kütüphane
- İçerik: Doğrulama, arama, yüz özellikleri analizi (yaş, cinsiyet, ırk, duygu)
- Kullanım kolaylığı: Son derece basit API
Sonuç: Prototip oluşturma ve denemeler için en iyi seçenektir. Birleşik API, tek bir parametre değişikliğiyle modeller arasında geçiş yapmanıza olanak tanır. Üretimde daha iyi performans ve kontrol için FaceNet512'yi doğrudan kullanmak isteyeceksiniz.
dlib
Davis King tarafından sürdürülen ve Python bağlarına sahip C++ kütüphanesidir. 3 milyon görüntülük veri kümesinde eğitilmiş bir yüz tanıma modeli içerir.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Depo: github.com/davisking/dlib
- Lisans: Boost Yazılım Lisansı (izin verici)
- LFW doğruluğu: %99,38
- Gömme boyutu: 128 boyut
- Algılama: HOG tabanlı (hızlı, CPU dostu) ve CNN tabanlı (daha isabetli)
Sonuç: İyi Python bağlarına sahip, son derece sağlam ve sahada kendini kanıtlamış bir C++ çözümüdür. FaceNet512'den daha düşük doğruluğa sahiptir ancak son derece güvenilirdir. C++ ile çalışıyorsanız veya PyTorch/ONNX bağımlılıkları olmadan hafif bir çözüme ihtiyacınız varsa iyi bir seçimdir.
AdaFace
Özellikle görüntü kalitesindeki değişimleri ele alan daha yeni bir modeldir (2022). Standart modeller yüksek kaliteli görüntüler üzerinde eğitilir ve düşük çözünürlüklü veya bulanık girdilerde performansları düşer. AdaFace, eğitim sırasında marj cezasını görüntü kalitesine göre uyarlar.
- Depo: github.com/mk-minchul/AdaFace
- Lisans: MIT
- Temel avantaj: Düşük kaliteli görüntülerde üstün performans (gözetim, uzun menzilli kameralar)
- LFW doğruluğu: %99,82
- IJB-C TAR@FAR=1e-4: %97,39 (zor karşılaştırmalı testlerde çoğu açık kaynak modelden daha iyi)
Sonuç: Girdi görüntüleriniz düşük kaliteliyse kullanın. Gözetim, CCTV analizi veya görüntü kalitesini kontrol edemediğiniz herhangi bir senaryoda AdaFace, standart modellerden ölçülebilir derecede daha iyi sonuçlar verir.
Performans Karşılaştırma Tablosu
| Model | LFW (%) | Gömme | Hız (ms/yüz) | Lisans |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 boyut | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 boyut | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 boyut | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 boyut | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2048 boyut | ~15 ms (GPU) | CC BY-SA |
LFW (Doğal Ortamdaki Etiketli Yüzler) standart karşılaştırmalı testtir ancak esasen çözülmüş durumdadır. Her modern model %99'un üzerinde puan alır. Asıl farklılık, IJB-C (değişken koşullar) ve TinyFace (düşük çözünürlük) gibi daha zor karşılaştırmalı testlerde ortaya çıkar.
Karşılaştırmalı testler ile gerçeklik üzerine bir not: Bu hız değerleri, ısınmış bir GPU üzerinde tek yüz için FP32 çıkarımına aittir. ONNX Runtime INT8 nicelemesi kullanılan üretim ortamında 2-3 kat daha yüksek hız bekleyebilirsiniz. Ancak tam işlem hattının, yani algılama + hizalama + kalite puanlama + gömme işlemlerinin, yalnızca gömme çıkarmadan 3-5 kat daha uzun sürdüğünü de unutmayın. Tek bir A100 GPU'da tam işlem hattı için gerçekçi uçtan uca aktarım hızı, yalnızca gömme testlerinin ima edebileceği binlerce yüz değil, saniyede 200-400 yüzdür.
Açık Kaynak Modeller ile Üretim Sistemleri Arasındaki Fark
Eğitimlerin size söylemediği şey şudur: Bir yüz tanıma modelini Jupyter notebook içinde çalıştırmak işin kolay kısmıdır. Ölçekte gerçekten çalışan bir üretim sistemi geliştirmek, hiçbir modelin sizin yerinize çözmediği uzun bir mühendislik sorunları listesini çözmeyi gerektirir. Çoğu ekip hem maliyeti hem de süreyi ciddi biçimde hafife alır. “Modeli bağlayıp çalıştırma” projesi gibi görünen şey, üretime hazır hâle gelmeden önce kolayca 500 bin-2 milyon ABD dolarından fazla harcayabilen, 12-24 aylık bir mühendislik çalışmasına dönüşür; üstelik buna devam eden işletme maliyetleri dâhil değildir.
Altyapı Faturası
Gömme çıkarma için GPU hesaplama gücü. Milyarlarca görüntüde yüz algılama ve gömme çıkarma işlemini bir dizüstü bilgisayarda yapamazsınız. Tek bir NVIDIA A100 GPU, tam bir algılama + hizalama + gömme işlem hattında saniyede yaklaşık 200-400 yüz işleyebilir. 1 milyar görüntüyü makul bir sürede, örneğin bir haftadan kısa sürede işlemek için kesintisiz çalışan 40-80 GPU'dan oluşan bir kümeye ihtiyacınız vardır. Bulut fiyatlarıyla bu, her işleme geçişi için 50.000-150.000 ABD doları demektir ve modeliniz geliştikçe veya işlem hattınız değiştikçe yeniden işleme yapmanız gerekir. Donanımı doğrudan satın almak ise GPU sunucuları için 300 bin-800 bin ABD doları; buna ek olarak raf alanı, elektrik, soğutma ve tümünü yönetecek bir personel gerektirir.
Ölçekli depolama. Her biri 512 kayan noktalı sayıdan (2 KB) oluşan 1 milyar yüz gömmesi, yalnızca vektör verisi olarak yaklaşık 2 TB yer kaplar. Özgün görüntüleri, küçük resimleri, meta verileri ve dizin yapılarını eklediğinizde yüzlerce terabayttan birkaç petabayta kadar depolama gerekir. Vektör dizinleriniz için yüksek performanslı NVMe depolamanın buluttaki maliyeti aylık GB başına 0,10-0,25 ABD dolarıdır. 50 TB sıcak depolama için yalnızca sistemi açık tutmanın maliyeti ayda 5.000-12.500 ABD dolarıdır.
Vektör arama altyapısı. Tek bir makinedeki FAISS, dizin türünüze ve kullanılabilir RAM'e bağlı olarak yaklaşık 100-500 milyon vektörde sınıra ulaşır. Bunun ötesinde yük dengeleme, hata toleransı için çoğaltma ve dizinleri tutmaya yetecek RAM ile birden fazla parça üzerinde dağıtılmış arama gerekir. 1 milyardan fazla vektör için üretim sınıfı dağıtılmış FAISS veya Milvus kurulumu genellikle her biri en az 256 GB RAM'e sahip 8-16 yüksek bellekli makine gerektirir ve bulut bilişim maliyeti ayda 15.000-40.000 ABD dolarıdır.
Ağ ve bant genişliği. Milyarlarca görüntüyü taramak petabaytlarca veri indirmek demektir. Büyük bulut sağlayıcılarında çıkış trafiğinin GB başına 0,05-0,09 ABD doları olduğu düşünüldüğünde yalnızca veri aktarımı on binlerce dolara mal olabilir. Tarayıcılarınız, GPU işleme düğümleriniz ve depolama arka uçlarınız arasında yüksek kapasiteli iç ağa da ihtiyacınız vardır.
Web ölçeğinde bir yüz arama motoru için toplam altyapı maliyeti tahmini: Devam eden bulut maliyetleri ayda 30.000-80.000 ABD doları veya başlangıçta donanım için 500 bin-1,5 milyon ABD doları ve ayrıca elektrik, bant genişliği ve bakım için ayda 10.000-20.000 ABD dolarıdır. Üstelik bu yalnızca altyapıdır; henüz tek bir mühendis bile uygulama kodu yazmamıştır.
Mühendislik Takvimi
Üretim ortamına uygun bir yüz arama sistemi geliştirmek bir hackathon projesi değildir. Deneyimli 3-5 mühendisten oluşan bir ekip için gerçekçi takvim şöyledir:
1-3. aylar: Temel işlem hattı. Algılama, hizalama ve gömme çıkarma işlemlerini güvenilir biçimde çalıştırın. Temel vektör dizinini oluşturun. Yerel dosyalardan görüntü alımını yönetin. Bu, her şeyin yolunda göründüğü ve demonun etkileyici olduğu “eğlenceli” kısımdır.
3-6. aylar: Web tarama altyapısı. Büyük platformlar için kazıyıcılar geliştirin. Hız sınırlamalarını, CAPTCHA'ları, giriş duvarlarını, dinamik işlemeyi (JavaScript ağırlıklı siteler), görüntü tekilleştirmeyi ve içerik filtrelemeyi yönetin. Her sosyal medya platformunun, tarayıcılarınızı her hafta bozan farklı kazıma önleme tedbirlerine sahip olduğunu keşfedin. Tarayıcıların sessizce başarısız olduğunu algılayacak izleme sistemleri kurun. Web karmaşık ve düşmanca olduğundan yalnızca bu aşama bile beklenenden uzun sürebilir.
6-9. aylar: Ölçek ve güvenilirlik. Prototipiniz 1 milyon yüzde çalıştı. Şimdi 100 milyonda çalışmasını sağlayın. FAISS dizininizin artık RAM'e sığmadığını keşfedin. Parçalamayı uygulayın. Veri alım işlem hattınızdaki yarış koşullarını düzeltin. İndirilemeyen görüntülerin %15'i için yeniden deneme mantığı geliştirin. Bozuk görüntüleri, JPEG olduğunu iddia ettiği hâlde olmayan görüntüleri, EXIF döndürme bayraklı görüntüleri ve yarım kalan indirmeleri yönetin. Sabah 03.00'te bir şeyler bozulduğunda haberiniz olması için izleme, uyarı ve günlük kaydı ekleyin.
9-12. aylar: Kalite ve doğruluk. Ölçekte yanlış pozitif oranınızın kabul edilemez olduğunu fark edin. İşe yaramaz gömmeleri filtrelemek için yüz kalitesi puanlaması uygulayın. Eşikleri kullanım senaryosuna göre ayarlayın. Kötü eşleşmelerin işaretlenip incelenebilmesi için geri bildirim mekanizması geliştirin. Kayan nokta hassasiyeti farklılıkları nedeniyle modelinizin farklı GPU mimarilerinde farklı sonuçlar ürettiğini keşfedin ve bunu izlemek için iki hafta harcayın.
12-18. aylar: Üretim için sağlamlaştırma. Kimlik doğrulama, hız sınırlama ve kullanım takibi içeren bir API katmanı geliştirin. GDPR/CCPA uyumluluk özellikleri ekleyin: kapsam dışında kalma mekanizmaları, veri silme talepleri, denetim günlükleri. Sonuç önbelleğe almayı uygulayın. Yönetim araçları geliştirin. Belgeleri yazın. Güvenlik denetimini yönetin. Her şeyi yük testine tabi tutun. Varlığını bilmediğiniz bellek sızıntılarını düzeltin.
18-24. aylar: Sürekli operasyon. Web siteleri düzenlerini değiştirdikçe tarayıcılar bozulur. Yeni görüntü türleri ortaya çıktıkça modeller sapar. Disk dolar. Dizinlerin yeniden oluşturulması gerekir. Kullanıcılar hiç öngörmediğiniz uç durumları bildirir. Biri sisteminizin çizgi film yüzlerinde yüksek güvenli eşleşmeler döndürdüğünü keşfeder ve “gerçek yüz” filtresi eklemeniz gerekir. Bu hiçbir zaman sona ermez.
Karşılaşacağınız Sorunların Tam Listesi
Altyapı ve takvimin ötesinde, yüz tanıma sistemlerini sıfırdan geliştirirken ekiplerin karşılaştığı başlıca sorunların tümü aşağıdadır. Bu liste teorik kaygılardan değil, gerçek üretim sistemlerinden gelmektedir.
Veri kalitesi kâbusları:
- Çöp girerse çöp çıkar. İnternet memlerle, yapay zekâ tarafından oluşturulmuş yüzlerle, çizimlerle, fotoğrafların fotoğraflarıyla, dergi kapaklarıyla ve heykellerle doludur. Algılayıcınız bunların hepsinde “yüzler” bulur ve dizininizi kirleten gömmeler üretir. Sentetik yüzleri, resmedilmiş yüzleri, son derece düşük çözünürlüklü kırpmaları ve fotoğraf olmayan içerikleri filtrelemek için sınıflandırıcılara ihtiyacınız vardır. Bu filtreleri geliştirmek ve sürdürmek başlı başına bir projedir.
- Yinelenen ve neredeyse yinelenen görüntüler. Aynı fotoğraf farklı kırpmalar, filigranlar, sıkıştırma düzeyleri ve renk ayarlarıyla onlarca sitede görünür. Tekilleştirme olmadan viral bir fotoğraf, hepsi aynı görüntü olan yüzlerce “eşleşme” üretir ve gerçek sonuçları gömer. Algısal özetleme (pHash, dHash) yardımcı olur ancak kusursuz değildir. Birden fazla düzeyde tekilleştirme gerekir: URL düzeyinde tekilleştirme (önemsiz), algısal özet tekilleştirmesi (yeniden boyutlandırılmış ve tekrar sıkıştırılmış kopyaları yakalar) ve gömme düzeyinde tekilleştirme (biraz farklı açılardan fotoğraflanmış aynı yüzü yakalar). Her düzey diğerlerinin kaçırdıklarını yakalar ve tekilleştirmeye beklediğinizden daha fazla zaman harcarsınız.
- Yaş ve görünüm değişiklikleri. Bir kişinin üniversite fotoğrafındaki yüz gömmesi, 15 yıl sonraki fotoğrafıyla eşleşmeyebilir. Kilo değişimleri, yaşlanma, estetik cerrahi, sakal/bıyık ve farklı saç stilleri tanıma doğruluğunu etkiler. Hiçbir model bunu kusursuz biçimde yönetemez. Sisteminiz bir kişiyi 20 yıllık aralıkta eşleştiremediğinde kullanıcılar sizi suçlar.
- Demografik yanlılık. Ağırlıklı olarak Batılı/Beyaz veri kümeleriyle eğitilen açık kaynak modeller, diğer demografik gruplarda daha kötü performans gösterir. Etnik gruplar arası doğruluk farkları LFW'nin ima ettiğinden daha büyüktür; LFW yaklaşık %77 oranında Beyaz kişilerden oluşur. Küresel dağıtımda demografik gruplar arasındaki doğruluk farkı zor karşılaştırmalı testlerde %5-15 olabilir. MS-Celeb-1M üzerinde eğitilen FaceNet512 gibi modeller bu veri kümesinin demografik dengesizliğini devralır. Dengeli veri kümelerinde (BUPT-Balancedface gibi) ince ayar yapmak veya demografiye duyarlı eğitim stratejileri kullanmak adil performans için önemlidir. Irksal gruplar arasındaki doğruluğu değerlendirmezseniz bazı kullanıcılarda iyi, diğerlerinde kötü çalışan bir sistem yayımlayabilirsiniz. Bu yalnızca etik bir mesele değil, ürün kalitesi ve hukuki sorumluluk meselesidir.
- EXIF yönlendirmesini işleme. Web'deki görüntülerin yaklaşık %15-20'sinde, göz ardı edildiğinde yüzlerin yana dönük veya baş aşağı görünmesine yol açan EXIF yönlendirme etiketleri bulunur. Çoğu yüz algılayıcı döndürülmüş yüzleri bulamaz. Bu, testlerde (doğru yönlendirilmiş görüntüler kullandığınızda) kolayca gözden kaçan ancak üretimde yıkıcı olan sessiz bir doğruluk katilidir. EXIF yönlendirme düzeltmesini daima görüntü işleme hattınızın ilk adımı olarak uygulayın.
- Aşamalı JPEG ve WebP kod çözme hataları. Bazı görüntü kütüphaneleri, kısmen indirilmiş aşamalı JPEG'lerden veya kesilmiş WebP dosyalarından sessizce bozuk piksel verileri üretir. Yüz algılayıcı, bozulma yapılarında yine de bir “yüz” bulup işe yaramaz bir gömme üretebilir. İşlemeden önce görüntü bütünlüğünü doğrulamanız; dosyanın hatasız kod çözüldüğünü ve ortaya çıkan piksel arabelleğinin makul boyutlarda olduğunu kontrol etmeniz gerekir. Aksi hâlde bozuk görüntüler dizininizi sessizce kirletir.
İlk bakışta belirgin olmayan mühendislik sorunları:
- Gömme sürümleme. Modelinizi yükselttiğinizde (ve doğruluk iyileştirmeleri önemli olduğu için yükselteceksiniz) veri tabanınızdaki her gömme yeni modelin çıktısıyla uyumsuz hâle gelir. Ya tüm veri tabanınızı yeniden gömersiniz (pahalı ve zaman alıcıdır, tüm özgün görüntüleri saklamayı gerektirir), geçiş sırasında paralel dizinler çalıştırırsınız (altyapı maliyetini ikiye katlar) ya da geriye dönük uyumluluğu korursunuz (karmaşıktır ve gelişme yeteneğinizi sınırlar). İyi bir çözüm yoktur, yalnızca daha az acı verenler vardır.
- Kayan nokta determinizmi. Farklı GPU modellerinde, farklı CUDA sürümlerinde veya farklı toplu iş boyutlarında işlenen aynı görüntü, kayan nokta aritmetiği nedeniyle biraz farklı gömmeler üretebilir. Bu farklılıklar küçüktür (1e-6 ile 1e-4) ancak birikir: bir makinede 0,401 puan alan eşleşme başka bir makinede 0,399 alarak ikili eşik kararını tersine çevirebilir. Hata ayıklama sırasında bu sizi çıldırtır. GPU sürücüsü güncellemeleri özellikle tehlikelidir; NVIDIA sürücü güncellemeleri CUDA düzeyindeki kayan nokta davranışını değiştirebilir. 535.x sürücüsünde hesaplanan bir gömme, aynı görüntünün 545.x sürücüsündeki gömmesinden farklı olabilir. Üretimde bu, tüm filonuzdaki sürücü sürümlerini sabitlemeniz ve her güncellemeden sonra gömme tutarlılığını doğrulamanız gerektiği anlamına gelir.
- Eşzamanlılık ve yarış koşulları. Birden fazla tarayıcının aynı anda yüz alması, dizin güncellenirken kullanıcıların sorgu yapması, arama sonuçları hazırlanırken silme taleplerinin gelmesi. Vektör veri tabanları SQL veri tabanları kadar olgun işlem desteğine sahip değildir. Bir yüzün kısmen dizine eklendiği, sorguların eski sonuçlar döndürdüğü veya silmenin tüm parçalara yayılmadığı senaryolarla karşılaşırsınız.
- Bellek yönetimi. FAISS dizinleri bellek eşlemelidir ancak sorgu performansı, dizinin ne kadarının RAM'e sığdığına büyük ölçüde bağlıdır. Dizininiz büyüdükçe işletim sistemi dizin sayfalarını bellekten çıkardığında sorgu gecikmesi öngörülemeyen biçimde yükselir. OOM sonlandırmaları en kötü zamanda gerçekleşir. Linux bellek yönetimi, takas ayarları ve [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access) topolojisine son derece aşina olursunuz. Soğuk başlangıçlardan sonraki ısınma başka bir baş ağrısıdır: FAISS HNSW dizinleri bellek eşlemeli olduğundan sunucu yeniden başlatıldıktan sonraki ilk birkaç yüz sorgu, dizin sayfaları henüz RAM'e yüklenmediği için 10-100 kat daha yavaştır. Üretim trafiğini kabul etmeden önce dizini önceden yükleyen bir ısınma aşamasına ihtiyacınız vardır; aksi hâlde dağıtımdan sonraki ilk kullanıcılar korkunç gecikmeler yaşar.
- Sessiz hatalar. Bir web sitesi HTML'sini değiştirdiği için tarayıcı çalışmayı durdurur. GPU işleme düğümünüz sürücü güncellemesi nedeniyle NaN gömmeleri üretmeye başlar. Bir disk dolar ve yeni yüzler sessizce dizine eklenmemeye başlar. Bu hatalar hata mesajı vermez; sisteminizi sessizce kötüleştirir. Kapsamlı izleme ve anomali algılama olmadan kullanıcılar şikâyet edene kadar haberiniz olmaz.
- FAISS yenileme sorunu. Bir IVF dizinine yeni gömmeler eklediğinizde Voronoi hücreleri dengesizleşir. Niceleyiciyi yeniden eğitene kadar arama kalitesi kademeli olarak düşer. Web ölçeğinde yeniden eğitim, tüm veri kümesi üzerinde saatlerce GPU zamanı gerektirir. Ekipler genellikle eklemeleri toplu hâle getirip haftalık veya aylık yeniden eğitim yapar; bu da yeni alınan yüzlerin tam doğrulukla hemen aranamadığı anlamına gelir. Güncellik ile arama kalitesi arasında sürekli ödünleşim yaparsınız ve bedelsiz bir çözüm yoktur.
- Dizin parçaları arasında puan kalibrasyonu. Dizininiz birden fazla makineye parçalandığında, her parçanın farklı bir gömme dağılımı olduğundan farklı parçalardan gelen ham benzerlik puanları doğrudan karşılaştırılamaz. Sonuçları anlamlı biçimde birleştirmek için parça başına puan normalleştirmesi (kohort normalleştirmesi, Z-norm, T-norm) gerekir. Kalibrasyon olmadan A Parçasından gelen 0,45 puanı güçlü bir eşleşmeyi, B Parçasındaki 0,45 ise vasat bir eşleşmeyi temsil edebilir. Birleştirilmiş sonuçlar güvenilmez hâle gelir.
- Dağıtılmış aramadaki dağıtma sorunu. N parçada arama yapmak sorgu başına N ağ gidiş dönüşü demektir. Herhangi bir parça yavaşsa (GC duraklaması, disk G/Ç artışı, ağ aksaması) tüm sorgu yavaşlar. P99 gecikmesi, en yavaş parçanın P99 değeri tarafından belirlenir ve daha fazla parça ekledikçe kötüleşir. Kabul edilebilir kuyruk gecikmesini korumak için korumalı istekler (yinelenen istekler gönderip ilk döneni almak) ve uyarlanabilir zaman aşımları gibi teknikler zorunludur.
Doğruluk ve eşleştirme sorunları:
- Eşik ayarlaması hiçbir zaman “tamamlanmaz.” Veri tabanınız büyüdükçe en uygun benzerlik eşiği değişir. 1 milyon yüzde 0,45'lik eşik size iyi bir kesinlik ve geri çağırma dengesi sağlar. 100 milyon yüzde aynı eşik, benzer görünümlü yakın eşleşmeler daha fazla olduğu için on kat fazla yanlış pozitif üretir. Uyarlanabilir eşiklere veya son işlem yeniden sıralamasına ihtiyacınız vardır. Temeldeki matematik acımasızdır: veri tabanınız 1 milyondan 100 milyona, ardından 1 milyara çıktıkça benzer görünümlü yakın eşleşmeler arttığından en yüksek k benzerlik puanlarının dağılımı yukarı kayar. 1 milyon yüzde %0,1 yanlış pozitif oranı sağlayan sabit bir eşik, 1 milyar yüzde %10 verebilir. Bu dağılımı modelleyip eşikleri dinamik olarak ayarlamanız veya ölçekle birlikte kesinliğinizin düşmesini kabul etmeniz gerekir.
- Açık küme ve kapalı küme tanıma. Karşılaştırmalı testlerin çoğu, sorgulanan kişinin veri tabanında bulunduğunun garanti edildiği kapalı küme performansını değerlendirir. Gerçek dünyadaki yüz araması açık kümedir: sorgu yüzü dizinde hiç bulunmayabilir. Açık küme değerlendirmesi tamamen farklı ölçütler gerektirir (1. sıra doğruluğu yerine sabit FPIR'de TPIR) ve başarısızlık biçimi yanlış sıralama değil, yanlış eşleşmedir. Kapalı küme testlerinde %99 puan alan bir sistem, gerçek eşleşme bulunmadığında bile güvenle “en yakın” yüzü döndürdüğü için açık küme dağıtımında %10 yanlış eşleşme oranına sahip olabilir. “Eşleşme bulunamadı” durumunu doğru yönetmek, doğru eşleşmeleri bulmak kadar önemlidir.
- Benzer kişiler ve çiftler. 100 milyondan fazla yüz içeren bir veri tabanında, gömmeleri şaşırtıcı derecede yakın olan çok sayıda ilgisiz insan çifti vardır. Veri tabanınız büyüdükçe daha fazla yanlış eşleşme görürsünüz. Kullanıcılar düzenli olarak “yanlış kişi” sonuçları bildirir. Bunu yönetmek için bir stratejiye ihtiyacınız vardır: çoklu fotoğraf doğrulaması, bağlamsal sinyaller (ad, konum), insan inceleme kuyrukları.
- Pozdan bağımsız tanıma hâlâ zordur. FaceNet512 bile artı veya eksi 60 derece sapmanın ötesinde önemli ölçüde kötüleşir. Profil ile önden görünüşü eşleştirme doğruluğu, önden görünüşleri eşleştirmeye kıyasla %10-20 düşebilir. Gözetim senaryolarındaki yüzlerin çoğu açılıdır; bu da gerçek dünya doğruluğunuzun karşılaştırmalı testlerin ima ettiğinden önemli ölçüde düşük olduğu anlamına gelir. 3B farkındalıklı veri artırma ile eğitilmiş modeller veya UV-GAN gibi mimariler yardımcı olur ancak karmaşıklık ekler. Girdi verileriniz büyük ölçüde açılıysa bunu bir uç durum değil, birincil doğruluk sorunu olarak değerlendirin.
- Çekişmeli girdiler. Kullanıcılar yapay zekâ tarafından üretilmiş yüzler, deepfake'ler, morflanmış görüntüler ve kasıtlı bozulmalar içeren fotoğraflar gönderir. Bazıları sisteminizi test ederken bazıları sonuçları manipüle etmeye çalışır. Sisteminizin bu girdilere karşı belirli bir dayanıklılığı olmalıdır; aksi hâlde sahte yüzler için yüksek güvenli eşleşmeler döndürürsünüz.
- Fotoğraf manipülasyonu. Filtreler, güzellik uygulamaları, yoğun makyaj, yüz düzenleme yazılımları. Instagram gerçekliği ile gerçek hayat arasındaki fark. Bu değişiklikler yüz geometrisini, gömme benzerliğini etkileyecek kadar değiştirir. Yoğun filtrelenmiş bir özçekim aynı kişinin filtresiz fotoğrafıyla eşleşmeyebilir.
- Tek yüz, çok sayıda gömme. Tek bir kişinin internette farklı platformlara, açılara ve yıllara yayılmış yüzlerce fotoğrafı olabilir. Bunların tümünü ayrı eşleşmeler olarak mı döndüreceksiniz, yoksa tek bir kimlik altında mı kümeleyeceksiniz? Ölçekte kümeleme (yüz milyonlarca yüz) hesaplama açısından pahalıdır ve kendine özgü hata biçimleri doğurur: aşırı birleştirme (iki farklı kişiyi birleştirme) ve eksik birleştirme (aynı kişinin fotoğraflarını ilişkilendirememe).
Operasyonel baş ağrıları:
- Kazıma önleme silahlanma yarışı. Tüm büyük sosyal medya platformları kazıyıcıları etkin biçimde engeller. Sayfa yapılarını değiştirir, CAPTCHA ekler, başsız tarayıcıları algılar, IP'ye göre hız sınırı uygular, istek örüntülerinin parmak izini çıkarır ve bazen yanıltıcı içerik sunarlar. Tarama altyapınız sürekli bir silahlanma yarışındadır. Bugün çalışan bir kazıyıcı gelecek hafta tamamen engellenebilir. Tarayıcıların bakımı tek seferlik bir geliştirme değil, sürekli bir mühendislik maliyetidir.
- Değişim hızını modelleme. Farklı kaynaklar farklı hızlarda güncellenir. Ünlü haber sitelerine her saat yeni fotoğraflar gelirken kişisel sosyal medya profilleri yıllarca değişmeyebilir. Geçmiş değişim hızlarına dayalı akıllı yeniden tarama planlaması, önemli yerlerde dizini daha güncel tutarken bant genişliği maliyetlerini %60-80 azaltabilir. Bu olmadan ya durağan kaynakları gereğinden fazla tararsınız (bant genişliği ve para israfı) ya da dinamik kaynakları yetersiz tararsınız (eski sonuçlar sunarsınız).
- CDN ve coğrafi içerik farklılıkları. Aynı URL, istekte bulunanın konumuna, cihaz kullanıcı aracısına veya çerezlere göre farklı görüntüler sunabilir. Tarayıcınız, kullanıcının gördüğünden farklı bir görüntüyü dizine ekleyebilir ve bu da kafa karıştırıcı “eşleşme sonuçtaki görüntüye benzemiyor” bildirimlerine yol açar. Bazı CDN'ler gerçek tarayıcı görüntüyü görünüm alanına kaydırana kadar düşük çözünürlüklü yer tutucular sunar. Bu uç durumları yönetmeniz veya belirli oranda hayalet sonucu kabul etmeniz gerekir.
- Depolama maliyetinin büyümesi. Görüntü depolama doğrusal biçimde büyür ve asla durmaz. Yeniden gömmeniz gerekebilecekse özgün görüntüleri silemezsiniz. Küçük resimler, meta veriler, gömme vektörleri, dizin dosyaları, yedek kopyalar. Sisteminiz olgunlaştıkça depolama faturası hızlanır. İlk yılın depolamasına göre bütçe yapan ekipler üçüncü yılın maliyetleri karşısında şaşkına döner.
- Ölçekli uyumluluk talepleri. GDPR bireylere verilerinin silinmesini talep etme hakkı verir. Bir kişi kapsam dışında kalma talebi gönderdiğinde şunları yapmanız gerekir: tüm veri tabanınızda kişinin yüzünden üretilen bütün gömmeleri bulmak, silmek, tarayıcılar özgün görüntüleri yeniden bulduğunda bunların tekrar eklenmemesini sağlamak ve silme işlemini denetim amacıyla belgelemek. Ölçekte bu, özel araçlar ve mühendislik çalışması gerektirir. [AB Yapay Zekâ Yasası](https://artificialintelligenceact.eu/), yüz tanıma dâhil yüksek riskli yapay zekâ sistemlerine ek gereklilikler getirir: zorunlu uygunluk değerlendirmeleri, yanlılık testleri, şeffaflık yükümlülükleri ve insan gözetimi mekanizmaları.
- Kapsam dışında kalmayı uygulamak göründüğünden zordur. Bir gömmeyi silmekle yetinemezsiniz; tarayıcı aynı yüzle yeniden karşılaştığında tekrar dizine eklenmesini önlemeniz gerekir. Bunun için kapsam dışında kalmış yüz gömmelerinden oluşan bir “engelleme listesi” dizini tutmalı ve her yeni gömmeyi dizine eklemeden önce bununla karşılaştırmalısınız. Bu engelleme listesinin hızlı olması gerekir (her eklemede sorgulanır) ve kendine özgü veri saklama soruları doğurur: kapsam dışında kalmış kişinin yüz gömmesini eşleştirme yapabilmek için kalıcı olarak saklamanız gerekir; yani silme talebine uymak amacıyla biyometrik veriyi saklarsınız. Buradaki hukuki gerilim gerçektir ve birçok yargı alanında çözümsüzdür.
- Herkese açık taranan verilerde rıza sorunu. GDPR kapsamında herkese açık sosyal medya profillerindeki biyometrik verilerin işlenmesi için hukuka uygun dayanak tartışmalıdır. Birçok AB veri koruma kurumu yüz tanıma şirketleri aleyhinde karar vermiştir (özellikle birden fazla AB üyesi ülkedeki Clearview AI kararları). Hukuki riskiniz yargı alanına, veri kaynağına ve kullanım senaryosuna bağlıdır. Bu, geleceğe ilişkin varsayımsal bir kaygı değil, aktif bir yaptırım alanıdır.
- Denetim izi depolama maliyetleri. Her arama sorgusunu ve döndürülen her eşleşmeyi günlüğe kaydederseniz (uyumluluk bunu gerektirebilir), denetim günlükleri gerçek yüz verisinden daha hızlı büyüyebilir. Günde 1 milyon aramayı ve her aramada 10 sonucu yöneten bir sistem, günlük yaklaşık 10 milyon denetim kaydı üretir. Saklama gereklilikleri (yargı alanına göre çoğu zaman 1-7 yıl), bu verinin durmaksızın birikmesi anlamına gelir. Denetim depolamasını sonradan düşünülecek bir ayrıntı değil, temel maliyet kalemi olarak planlayın.
- Olay müdahalesi. Sisteminiz bir yüzü yanlış eşleştirir ve biri bu yanlış eşleşmeye dayanarak harekete geçerse ne olur? Her sonucun nasıl üretildiğini gösteren denetim izlerine, eşleştirme kararlarını açıklama becerisine ve itirazları ele alacak bir sürece ihtiyacınız vardır. Biri eşleşmeye itiraz ettiğinde “kosinüs benzerliği 0,42 eşiğimizi aşarak 0,47 oldu” demek tatmin edici bir açıklama değildir. GradCAM gibi teknikler yüzün hangi bölgelerinin eşleşmeyi belirlediğini gösterebilir; bu da itirazların çözümüne yardımcı olur ve güven oluşturur. Bu yalnızca iyi mühendislik değildir; yargı alanınıza bağlı olarak hukuken zorunlu olabilir.
- Model ve bağımlılıkların eskimesi. CUDA sürümleri, Python sürümleri, [ONNX Runtime](https://onnxruntime.ai/) sürümleri ve işletim sistemi güncellemeleri zamanla değişir ve çıkarım işlem hattınızı fark edilmesi zor biçimlerde bozabilir. Sürümleri sabitlemek, bir güvenlik yamasına ihtiyaç duyana kadar yardımcı olur. Bağımlılık yönetimi ve ortamın yeniden üretilebilirliği için şaşırtıcı derecede fazla zaman harcarsınız.
- Ekip bilgisinin belirli kişilerde yoğunlaşması. FAISS dizinleme katmanını geliştiren mühendis parçalama mantığını bilir. Tarayıcıları ayarlayan mühendis hangi sitelerin özel işlem gerektirdiğini bilir. Bu kişiler ayrıldığında (ve 18-24 aylık projede personel değişimi yaşanır) kritik bilgi de onlarla gider. Belgeleme yardımcı olur ancak belirgin olmayan kararların arkasındaki “neden”i hiçbir zaman tam olarak yakalayamaz.
Gerçek Maliyet Özeti
Herkese açık internette arama yapan web ölçeğindeki bir yüz arama sistemi için:
- Mühendislik ekibi: 12-24 ay boyunca 3-5 kıdemli mühendis = maaş ve genel giderler dâhil 600 bin-2,5 milyon ABD doları
- Altyapı (1. Yıl): Bulut maliyetleri veya donanım için 400 bin-1 milyon ABD doları
- Altyapı (devam eden): Aylık 30 bin-80 bin ABD doları (yıllık 360 bin-960 bin ABD doları)
- Hukuk ve uyumluluk: İlk değerlendirme ve sürekli danışmanlık için 50 bin-200 bin ABD doları
- Toplam 1. Yıl: 1,4 milyon-3,7 milyon ABD doları
- Toplam 2. Yıl ve sonrası: Altyapı + mühendislik bakımı için yıllık 500 bin-1,2 milyon ABD doları
Üstelik bunlar çalışan bir sistem içindir. Birçok ekip, sorunun tahmin ettiklerinden daha zor olduğunu fark edip API çözümüne yönelmeden önce 6-12 ay ve 500 bin ABD dolarından fazla harcar.
Ne Zaman Geliştirmeli, Ne Zaman API Kullanmalı?
Şu durumlarda kendiniz geliştirin:
- 100 bin yüzün altında kapalı bir veri kümeniz (çalışan kartları, müşteri fotoğrafları) varsa
- Sistemin şirket içinde veya dış ağdan tamamen yalıtılmış çalışması gerekiyorsa
- Model optimizasyonunu, eşik ayarlamasını ve uç durumları yönetebilecek makine öğrenimi mühendisleriniz varsa
- Kullanım senaryonuz arama (web'e karşı 1: N) yerine doğrulamaysa (1:1)
- Çok yıllı bir mühendislik projesine ayıracak bütçeniz ve zamanınız varsa
Şu durumlarda API kullanın:
- Herkese açık internette (sosyal medya, haberler, web) yüz aramanız gerekiyorsa
- Web kazıma + dizinleme işlem hattı geliştirip sürdürmek istemiyorsanız
- 12-24 aylık mühendislik çalışmasından sonra değil, şimdi sonuçlara ihtiyacınız varsa
- Sistemin internette yayımlanan yeni içeriklerle güncel kalması gerekiyorsa
- GDPR uyumluluğunu, kapsam dışında kalma taleplerini ve AB Yapay Zekâ Yasası'nı başkasının yönetmesini istiyorsanız
- Başlangıçtaki 1 milyon ABD dolarını aşan altyapı ve mühendislik maliyetlerinden kaçınmak istiyorsanız
- Temel ürününüz yüz arama değilse ve mühendislik zamanını asıl ürününüze harcamak daha mantıklıysa
FaceCheck.id Yüz Arama API'si
Altyapıyı sıfırdan kurmadan herkese açık web'de yüz araması yapması gereken geliştiriciler için FaceCheck.id bir REST API sunar. Bu API tüm işlem hattını yönetir: algılama, gömme ve sosyal medya, haber siteleri ve daha geniş web genelindeki herkese açık yüz görüntülerinden oluşan, sürekli güncellenen bir dizinde arama.
FaceCheck.id, web ölçeğinde arama için optimize edilmiş tescilli bir yüz tanıma modeli kullanır. Kendiniz dağıtıp ayarlamanız gereken açık kaynak modellerin aksine, tescilli modeli internet üzerinde yüz aramanın zorlukları için özel olarak eğitilmiş ve ince ayarlanmıştır: büyük ölçüde değişen görüntü kalitesini, farklı aydınlatma koşullarını, demografik çeşitliliği ve sürekli taranan dizinin devasa ölçeğini yönetir. Bu tescilli yaklaşım, model performansını bağımsız biçimde geliştirmelerine ve genel amaçlı açık kaynak modellerin yapamayacağı şekillerde kendi arama işlem hatları için optimize etmelerine olanak tanır. Sistemin sıfırdan yeniden üretilmesi son derece zor ve pahalı olacak bir düzeyde çalışmasını sağlamak için yıllarca mühendislik, test ve iyileştirme yapılmıştır.
API ne yapar:
Bir yüz görüntüsü gönderirsiniz; API internette bulunan eşleşen yüzleri güven puanları ve kaynak URL'leriyle döndürür. Eşleştirme, dizinleme ve web ölçekli altyapı onların tarafında yönetilir. Yukarıda açıklanan tüm GPU kümeleri, tarama işlem hatları, vektör arama altyapısı, uyumluluk araçları ve sürekli bakım onların sorunudur, sizin değil.
API'nin temelleri:
- RESTful JSON API
- API anahtarıyla kimlik doğrulama
- Base64 ile kodlanmış görüntü veya görüntü URL'si gönderme
- Döndürülenler: benzerlik puanları, kaynak URL'leri ve küçük resim önizlemeleri içeren eşleşme dizisi
- Hız sınırları ve fiyatlandırma kullanıma göre ölçeklenir
Tipik entegrasyon:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
API kullanım senaryoları:
- Flört uygulaması doğrulaması: Kullanıcıların eşleştikleri kişinin fotoğraflarının gerçek sosyal medya profillerinde görünüp görünmediğini doğrulamasını sağlayın
- Marka koruması: Birinin ekibinizin fotoğraflarını sahte işletme profilleri için kullanıp kullanmadığını kontrol edin
- Durum tespiti platformları: Geçmiş kontrolü veya KYC iş akışlarına yüz arama ekleyin
- Dolandırıcılık önleme sistemleri: İnternetin başka yerlerinde farklı adlar altında görünen fotoğrafları kullanan hesapları işaretleyin
- OSINT araçları: Web ölçeğinde yüz eşleştirme içeren araştırma araçları geliştirin
Neden kendiniz geliştirmek yerine bunu kullanmalısınız:
Herkese açık web'de arama yapan bir yüz arama motoru geliştirmek şunları gerektirir: (1) milyarlarca görüntüyü keşfedip indiren web ölçekli bir tarama işlem hattı, (2) yüz algılama ve gömme çıkarma için çalıştırılması yüz binlerce dolara mal olan GPU altyapısı, (3) tam dizinde gerçek zamanlı sorgu yapmak için terabaytlarca RAM'e sahip dağıtılmış vektör arama sistemi, (4) dizini güncel tutmak için sürekli yeniden tarama, (5) kapsam dışında kalma, veri silme talepleri ve mevzuat gereklilikleri için uyumluluk altyapısı, (6) tam zamanlı bakım yapan 3-5 kişilik mühendis ekibi ve (7) ilk kullanılabilir sürüm yayımlanmadan önce 12-24 ay. Bu, önemli sürekli maliyetleri bulunan, milyonlarca dolarlık bir mühendislik projesidir. FaceCheck.id'ın tescilli modeli ve sahada kendini kanıtlamış altyapısıyla desteklenen API, bunların tümünü tek bir HTTP çağrısıyla sunar.
Yukarıda ele alınan açık kaynak modeller, kapalı sistem yüz tanıma uygulamaları (çalışan erişim kontrolü, fotoğraf kitaplığı düzenleme, özel doğrulama akışları) geliştirmek için mükemmeldir. Ancak kullanım senaryonuz “bu yüzün internette nerelerde göründüğünü ara” ise çalışan bir model ile çalışan bir ürün arasındaki mühendislik farkı muazzamdır. FaceCheck.id API'si bu farkı kapatarak çalışan bir ürünü yıllar yerine günler içinde yayımlamanızı sağlar.
Başlayın: Belgeler, fiyatlandırma ve API anahtarı kaydı için facecheck.id/en/Face-Search/API adresini ziyaret edin.
SSS
En doğru açık kaynak yüz tanıma modeli hangisidir?
Inception-ResNet-v2 omurgasına sahip FaceNet512, LFW üzerinde %99,65 ile çoğu karşılaştırmalı testte şu anda mükemmel sonuçlar elde etmektedir. Düşük kaliteli görüntü senaryolarında (gözetim, CCTV), AdaFace, %97,39 TAR@FAR=1e-4 değeriyle IJB-C gibi zor karşılaştırmalı testlerde daha iyi performans gösterir.
Açık kaynak yüz tanıma modellerini ticari olarak kullanabilir miyim?
Evet. FaceNet512, FaceNet, DeepFace, dlib ve AdaFace modellerinin tümü izin verici lisanslar (MIT veya Boost) altında yayımlanmıştır. Bunları ticari ürünlerde kullanabilirsiniz. Ancak yazılım lisansından bağımsız olarak geçerli olan, yargı alanınızdaki biyometrik veri işleme kısıtlamalarını (GDPR, BIPA, AB Yapay Zekâ Yasası) dikkate alın.
Kendi yüz tanıma modelimi eğitmek için ne kadar veriye ihtiyacım var?
Sıfırdan eğitmeniz gerekmez. Yukarıda listelenen önceden eğitilmiş modeller, 100 bin-500 bin kimliğe ait 5-12 milyon görüntüden oluşan veri kümeleriyle eğitilmiştir. Bu önceden eğitilmiş modelleri kullanın ve yalnızca belirli bir alan ihtiyacınız varsa ince ayar yapın. İnce ayar genellikle 10 bin-100 bin görüntü gerektirir. Sıfırdan eğitim, milyonlarca görüntü ve önemli miktarda GPU kaynağı gerektirir.
Yüz doğrulama ile yüz arama arasındaki fark nedir?
Yüz doğrulama (1:1), iki gömmeyi doğrudan karşılaştırarak “bu iki fotoğraf aynı kişiye mi ait?” sorusunu yanıtlar. Yüz arama (1:N), tek bir gömmeyi milyonlarca kayıttan oluşan veri tabanıyla karşılaştırarak “bu kişi nerelerde görünüyor?” sorusunu yanıtlar. Doğrulama hesaplama açısından basittir. Arama, verimli en yakın komşu dizinlemesi (FAISS, Milvus) ve web ölçeğindeki aramalarda geliştirilmesi ve işletilmesi milyonlarca dolara mal olabilen devasa tarama ve dizinleme altyapısı gerektirir.
Düşük kaliteli görüntülerde yüz tanıma ne kadar doğrudur?
Görüntü kalitesi düştükçe doğruluk önemli ölçüde azalır. Net, önden çekilmiş fotoğraflarda modern modeller %99'un üzerinde doğruluğa ulaşır. Bulanık gözetim görüntülerinde veya yüzün 50 pikselden dar olduğu fotoğraflarda doğruluk %80-90'a veya daha aşağıya düşebilir. AdaFace, kalite değişimlerini standart modellerden daha iyi yönetmek üzere özel olarak tasarlanmıştır. Her sistemde daha yüksek çözünürlüklü girdi görüntüleri çok daha iyi sonuçlar üretir. Poz da önemlidir: yüksek çözünürlüklü görüntülerde bile profil (yandan görünüş) yüzlerde doğruluk, önden görünen yüzlere kıyasla %10-20 düşebilir.
Bir yüz arama motoru geliştirmenin maliyeti nedir?
Herkese açık internette arama yapan web ölçekli bir sistem için ilk yıl 1,4 milyon-3,7 milyon ABD doları (mühendislik ekibi + altyapı + hukuk), sonrasında ise yıllık 500 bin-1,2 milyon ABD doları sürekli maliyet bekleyin. 100 bin yüzün altındaki özel bir veri tabanında arama yapan kapalı sistemin maliyetleri çok daha düşüktür; tek bir GPU sunucusu ve bir mühendis yeterlidir. Maliyet, arama veri tabanınızın boyutuna ve onu doldurmak için web'i taramanız gerekip gerekmediğine göre artar.
Üretime hazır bir yüz tanıma sistemi geliştirmek ne kadar sürer?
Basit bir doğrulama sistemi için (bilinen bir veri tabanına karşı 1:1 eşleştirme), deneyimli bir mühendis 1-2 haftada çalışan bir prototip geliştirebilir ve 1-3 ay içinde üretime hazır hâle getirebilir. Web ölçekli yüz arama sistemi için (internete karşı 1:N), üretimde kullanılabilecek kadar güvenilir bir sisteme ulaşmak 3-5 mühendisten oluşan bir ekiple 12-24 ay sürer. Tarama, ölçekleme ve uyumluluk zorlukları, temel makine öğrenimi çalışmasının üzerine muazzam miktarda süre ekler.
Önemli bir şey geliştirin. Kapalı sisteminiz için FaceNet512 ile başlayın. Ancak web ölçeğinde yüz aramaya ihtiyacınız varsa kendinize şunu sorun: İlk kullanılabilir sonucunuzu almadan önce gerçekten 1,4 milyon-3,7 milyon ABD doları harcamak, kıdemli mühendislerden oluşan bir ekip kurmak ve 12-24 ay beklemek istiyor musunuz? Bunun yerine GPU kümelerini, tarama kâbuslarını, uyumluluk sorunlarını ve yıllarca süren mühendislik çalışmasını tamamen atlayabilir; FaceCheck.id API'si ile yalnızca 1 ABD dolarından başlayan fiyatlarla ilk arama sonuçlarınızı 5 dakikadan kısa sürede alabilirsiniz.
Yüzle Arama hakkında daha fazla okuyun
Yüz Tanıma ile Online Arkadaşlıkta FaceCheck.ID'nin Sunduğu 4 Temel Fayda
Online tanışma dünyasında sahte profiller ve dolandırıcılar her yerde kol geziyor. Peki ekranın arkasındaki kişinin gerçekten fotoğraftaki kişi olup olmadığını nasıl anlarsınız? Yüz tanıma teknolojisi, duygusal ve maddi kayıplar yaşamadan karşınızdakinin kimliğini doğrulamanın en etkili yolu olabilir.
Diğer dillerde konu üzerine
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
Popüler Konular
Deepfake Kimlik Sosyal Medya Yüz Tanıma Facebook Instagram Sosyal Medya Profilleri Yüz Arama Motoru Dolandırıcılar Kimlik Doğrulama Yüz Arama Yüzle Arama Yapay Zeka Reddit BiyometrikNihai Yüz Arama Savaşı: PimEyes vs FaceCheck - Kim Üstün Gelir?