Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
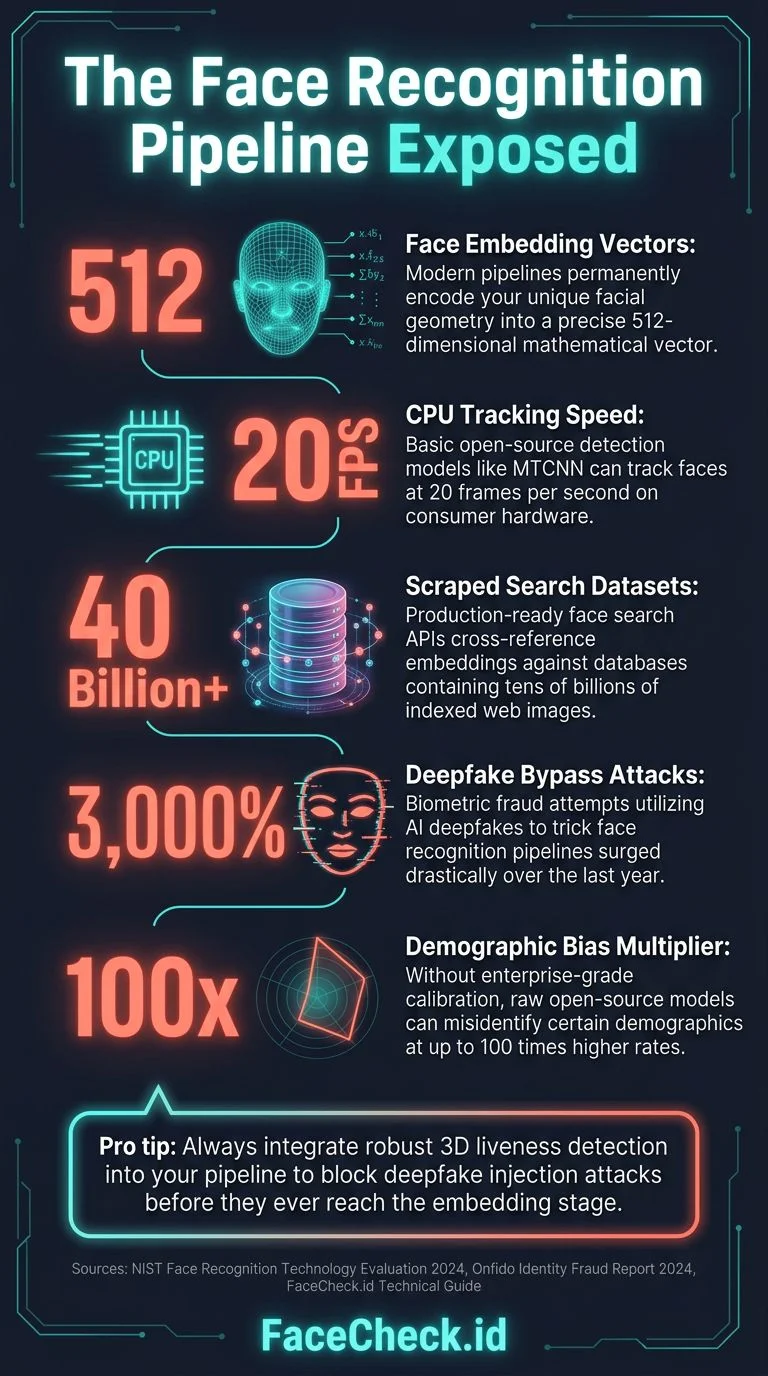
Si vous développez un produit qui doit comparer des visages, vérifier des identités à partir d’une photo ou rechercher un visage dans un ensemble de données, vous devez comprendre le fonctionnement réel de la reconnaissance faciale moderne. Pas la version marketing. Le véritable pipeline, des pixels bruts jusqu’à un vecteur d’embedding à 512 dimensions qui encode la géométrie faciale unique d’une personne.
Cet article détaille l’ensemble du pipeline de reconnaissance faciale, compare les meilleurs modèles open source disponibles en 2026, présente leurs performances réelles et explique quand il est pertinent de créer votre propre système plutôt que d’utiliser une API de production.
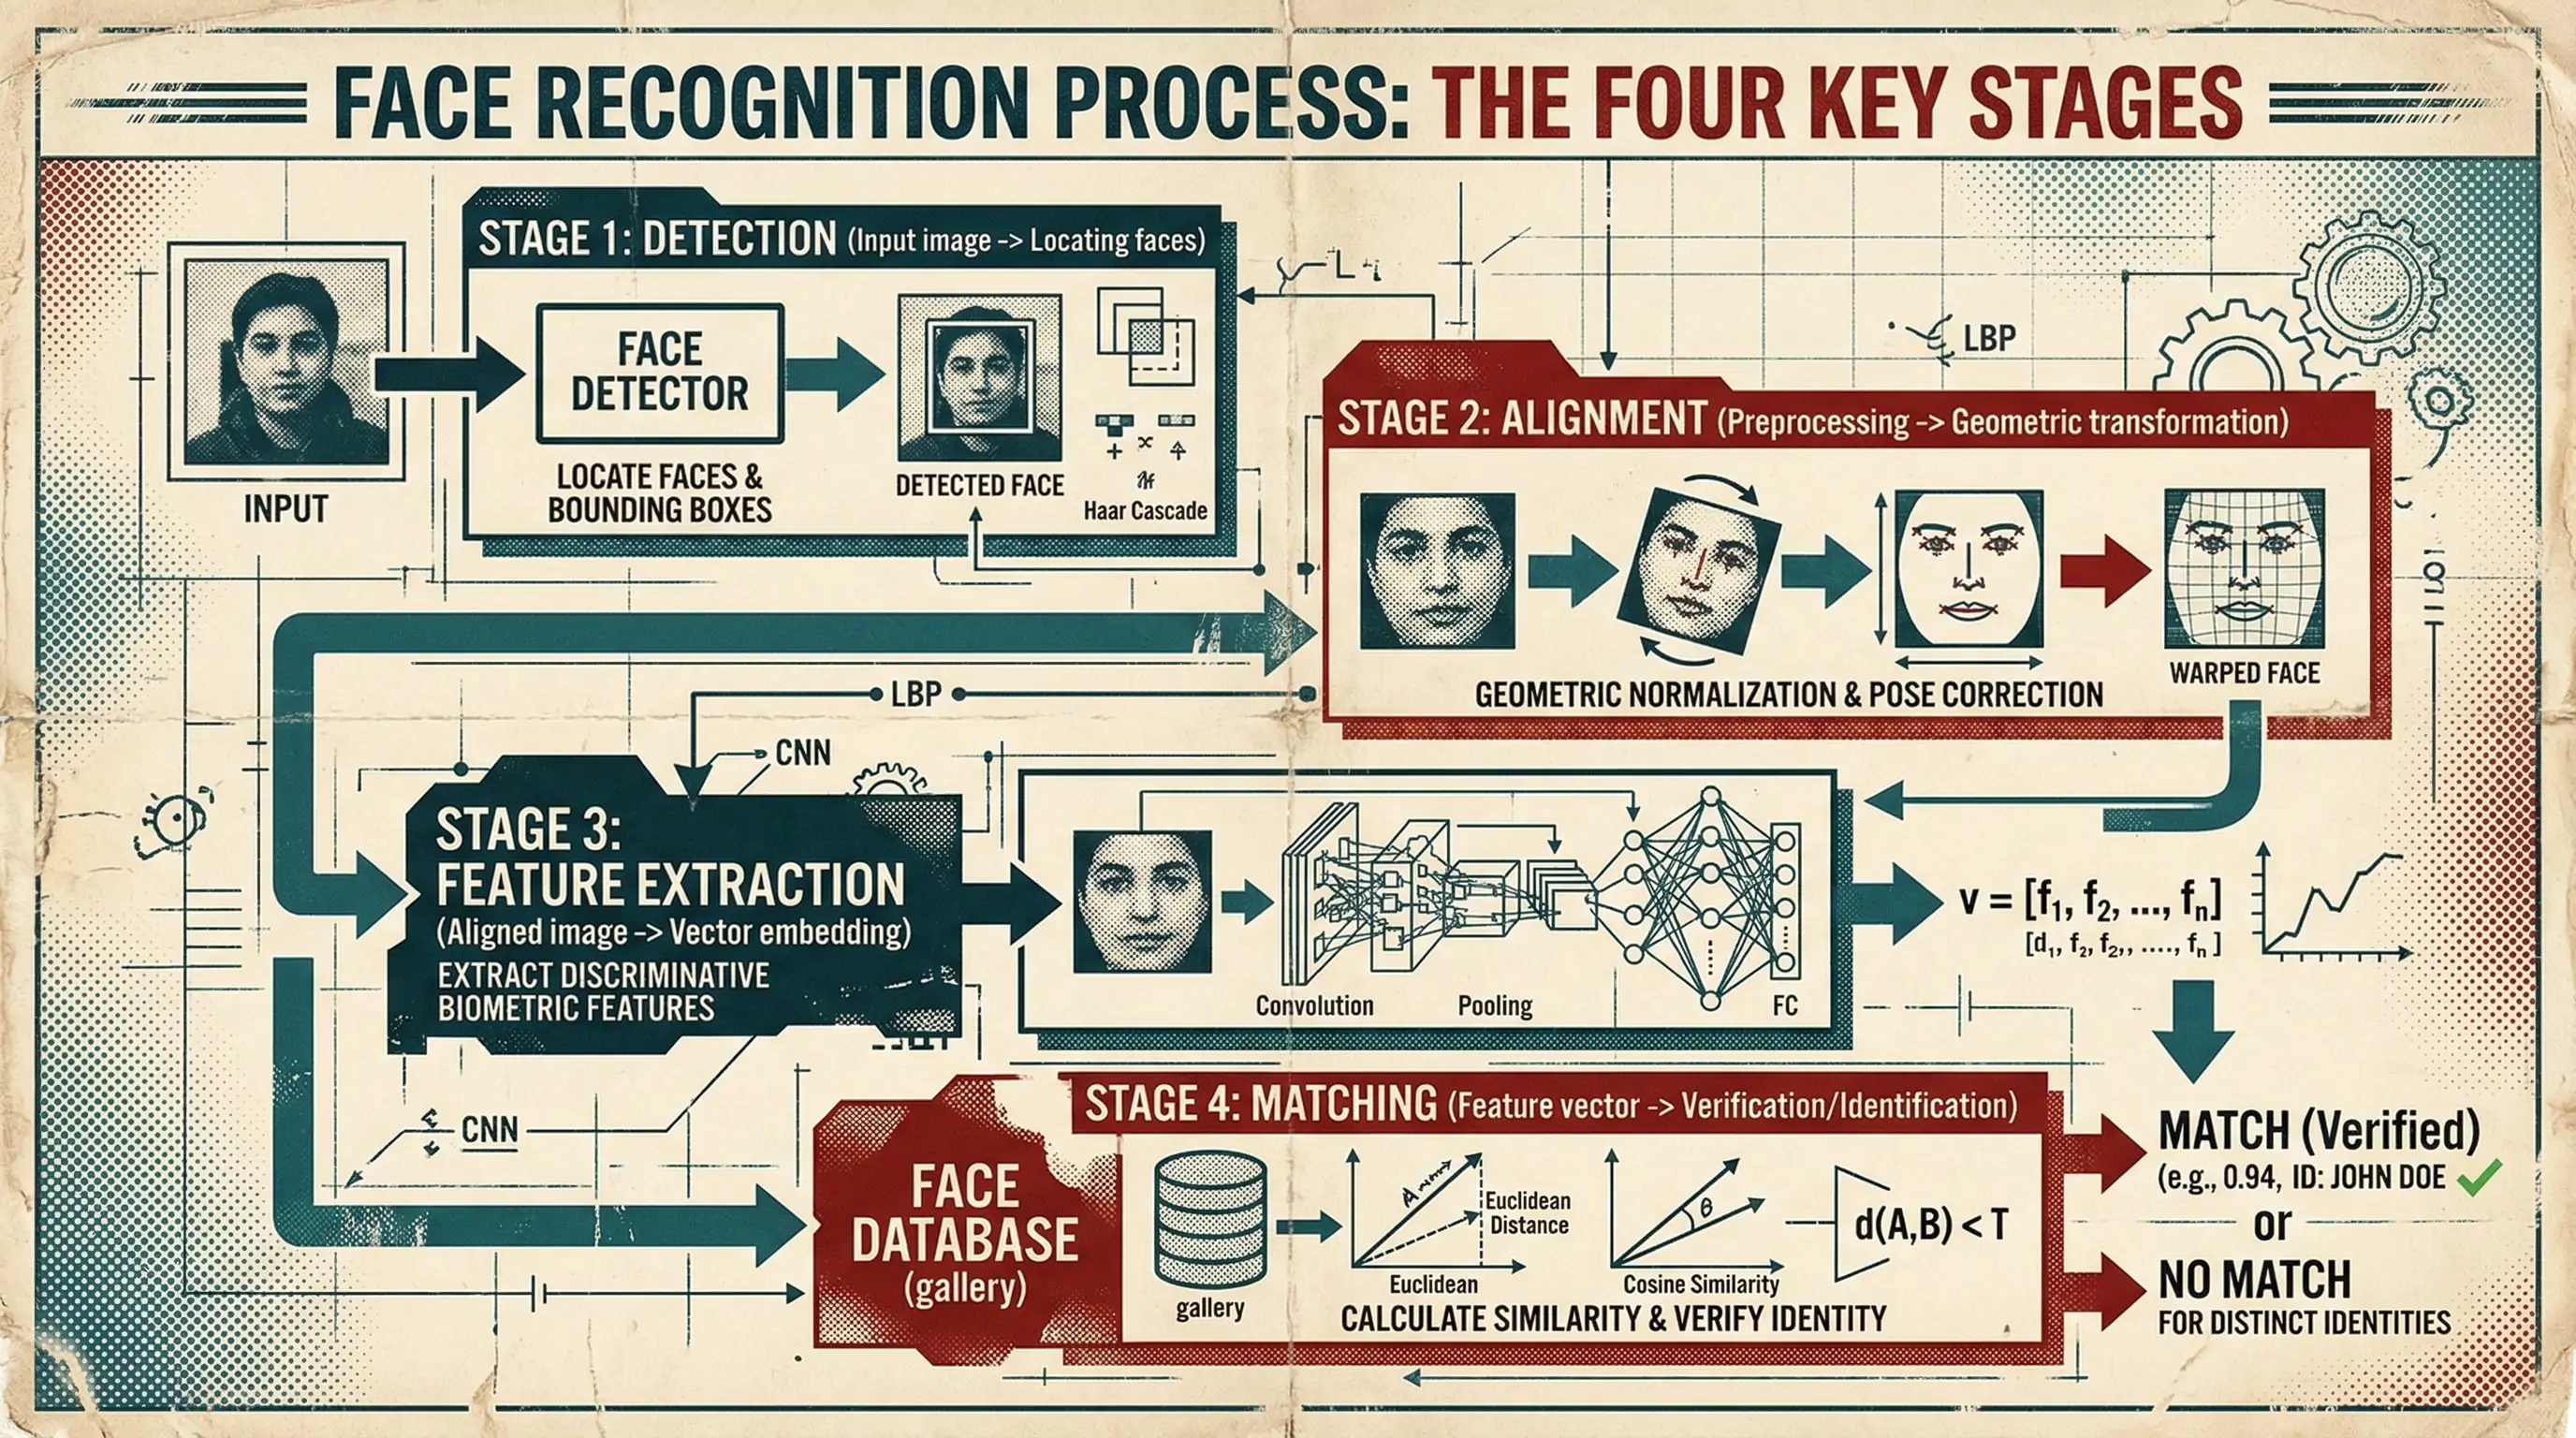
Dans cet article, nous allons discuter
- Le pipeline de reconnaissance faciale : quatre étapes
- Meilleurs modèles open source de reconnaissance faciale (2026)
- Tableau comparatif des performances
- L’écart entre les modèles open source et les systèmes de production
- Quand développer soi-même et quand utiliser une API
- API de recherche faciale FaceCheck.id
Le pipeline de reconnaissance faciale : quatre étapes
Tous les systèmes modernes de reconnaissance faciale suivent le même pipeline de base, qu’ils fonctionnent sur un Raspberry Pi à 35 $ ou sur un cluster de GPU au sein d’une agence gouvernementale. Comprendre ces quatre étapes vous aidera à évaluer n’importe quel modèle ou API.
Étape 1 : détection des visages
Avant de pouvoir reconnaître un visage, il faut le localiser. La détection des visages prend une image en entrée et génère des boîtes englobantes autour de chaque visage présent. Cela paraît simple, mais c’est à cette étape que de nombreux systèmes échouent en production.
Les modèles de référence :
- MTCNN (réseaux convolutifs en cascade multitâches) : Le modèle incontournable de la détection des visages depuis 2016. Cascade en trois étapes : le Proposal Network (P-Net) trouve les régions candidates, le Refine Network (R-Net) filtre les faux positifs et l’Output Network (O-Net) affine les boîtes englobantes et génère les points de repère du visage. Il reste largement utilisé. Précis sur les visages de face, il est moins performant avec les angles extrêmes et les occultations. Il fonctionne à environ 20 images par seconde sur un processeur moderne.
- RetinaFace : La référence en matière de précision de détection. Détecteur en une seule étape reposant sur une architecture dorsale de type [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Il renvoie les boîtes englobantes ainsi que cinq points de repère du visage (yeux, nez et commissures des lèvres). Il gère bien les différentes échelles. C’est le choix privilégié lorsque la précision compte davantage que la vitesse. Environ 15 images par seconde sur GPU, moins sur CPU.
- SCRFD (redistribution des échantillons et des calculs pour une détection efficace des visages) : Le champion de la vitesse. Conçu pour les déploiements mobiles et en périphérie. Il atteint une précision comparable à RetinaFace tout en étant 3 à 10 fois plus rapide. Plusieurs tailles de modèles sont proposées, de 0,5 à 34 millions de paramètres. Si vous déployez sur mobile ou avez besoin d’un traitement en temps réel, c’est le modèle qu’il vous faut.
- BlazeFace : La contribution de Google, conçue pour [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Extrêmement rapide — plus de 200 images par seconde sur les GPU mobiles — mais au prix d’une précision moindre sur les angles difficiles. Un bon choix pour les applications vidéo en temps réel où chaque image doit être traitée.
Ce qui compte vraiment dans la détection : Les cas difficiles ne sont pas les selfies bien éclairés. Ce sont les images de vidéosurveillance, les photos de groupe où les visages ne font que 50 pixels de large, les profils très prononcés et les visages partiellement masqués par des lunettes de soleil ou un masque. Votre modèle de détection détermine les performances maximales de l’ensemble du système. S’il ne détecte pas un visage, aucune étape ultérieure ne pourra corriger cette erreur.
Le problème des visages multiples : Lorsqu’une image contient plusieurs visages, vous devez décider lequel convertir en embedding. Vous pouvez choisir le plus grand visage, le plus centré, celui qui obtient le meilleur score de qualité, ou tous les convertir en embeddings et laisser la logique en aval faire le tri. Chaque choix présente des modes d’échec différents. Convertir tous les visages des photos de groupe en embeddings gonfle l’index et produit des résultats de recherche ambigus ; ne choisir que le plus grand visage fait manquer la personne au dernier rang. La plupart des systèmes de production convertissent en embeddings tous les visages détectés dépassant un seuil de taille minimale — généralement 40 à 60 pixels entre les yeux — et les associent à des entrées distinctes liées à la même image source.
L’évaluation de la qualité des visages comme filtre d’entrée : Exécuter un estimateur de qualité léger tel que SER-FIQ ou la branche de qualité de MagFace avant de calculer des embeddings coûteux empêche les données inutilisables d’entrer dans votre index. Les recadrages flous, les occultations importantes et les visages surexposés produisent tous des embeddings peu fiables qui polluent les résultats de recherche. Rejeter dès l’étape de détection les visages dont la qualité est inférieure à un certain seuil améliore considérablement la précision en aval et économise des cycles GPU. C’est l’une des optimisations offrant le meilleur retour sur investissement de tout le pipeline.
Protection contre l’usurpation faciale pour la vérification : Dans les scénarios de vérification, la détection des attaques par présentation (PAD) est essentielle. Les photos imprimées sur papier, les rediffusions sur écran et les masques 3D peuvent tous tromper les systèmes reposant sur des embeddings. Des modèles comme CDCN ou PatchNet détectent ces attaques, mais ajoutent 5 à 15 ms de latence par visage et nécessitent une maintenance supplémentaire. Si vous développez un système dans lequel l’utilisateur contrôle l’image d’entrée — contrôle d’accès, KYC ou authentification — vous devez intégrer une protection contre l’usurpation, faute de quoi votre système sera exploité.
Étape 2 : alignement des visages
Une fois le visage détecté, vous devez le normaliser. Les différentes poses de la tête, les angles de prise de vue et les distances modifient tous l’apparence du visage dans l’image brute. L’alignement transforme chaque visage détecté pour le placer dans une position standardisée : yeux à l’horizontale, visage centré et échelle uniforme.
L’approche standard utilise les cinq points de repère issus de la détection — œil gauche, œil droit, pointe du nez, commissure gauche et commissure droite des lèvres — afin de calculer une transformation de similitude. Celle-ci projette le visage détecté dans un recadrage canonique de 160 × 160 pixels, avec les yeux placés à des coordonnées fixes.
Cette étape est souvent négligée dans les tutoriels, mais elle est essentielle. Une erreur de rotation de 2 degrés lors de l’alignement peut réduire la précision de reconnaissance de 1 à 3 %. La plupart des pipelines open source s’en chargent automatiquement, mais si vous développez votre propre solution, utilisez la spécification d’alignement de FaceNet — 160 × 160 pixels, avec des coordonnées précises pour les yeux — comme norme. C’est celle sur laquelle la plupart des modèles modernes ont été entraînés.
Sensibilité de l’alignement à la précision des points de repère : Les points de repère de RetinaFace présentent une erreur moyenne d’environ 2 pixels. Cette erreur se propage dans la transformation d’alignement et peut entraîner une baisse de précision de 1 à 5 %, en particulier sur les petits recadrages où 2 pixels représentent une plus grande proportion de la largeur totale du visage. Certains systèmes de production exécutent, après la détection initiale, un second affinage à 68 ou 98 points — comme face-alignment d’Adrian Bulat — afin d’obtenir un alignement plus précis. Les 3 à 5 ms supplémentaires par visage en valent la peine lorsque votre cas d’usage exige une précision maximale, notamment pour la vérification 1:1 où une seule mauvaise décision peut avoir des conséquences.
Étape 3 : extraction des caractéristiques (embedding)
C’est le cœur de la reconnaissance faciale. Un réseau neuronal profond prend l’image du visage aligné et génère un vecteur de longueur fixe — généralement 512 dimensions — appelé embedding ou vecteur de caractéristiques. Ce vecteur constitue une représentation numérique compacte des caractéristiques uniques du visage.
Deux visages d’une même personne, indépendamment de l’éclairage, de l’expression, de l’âge — dans une certaine mesure — ou de l’appareil photo, doivent produire des embeddings proches dans l’espace vectoriel. Deux personnes différentes doivent produire des embeddings éloignés.
Fonctionnement technique :
L’architecture du réseau est généralement une version modifiée d’Inception-ResNet ou de ResNet, entraînée sur des millions d’images de visages. L’innovation majeure réside dans la fonction de perte utilisée pendant l’entraînement, et non dans l’architecture elle-même.
- Perte softmax (la référence de base) : Traite la reconnaissance faciale comme un problème de classification. Elle fonctionne, mais produit des embeddings qui ne sont pas bien séparés dans l’espace angulaire. Elle est aujourd’hui largement obsolète pour la reconnaissance.
- Perte triplet : L’approche popularisée par FaceNet. Le réseau apprend en comparant des triplets de visages ancre/positif/négatif, en rapprochant les embeddings d’une même identité et en éloignant ceux d’identités différentes. Elle nécessite une sélection minutieuse des triplets difficiles pendant l’entraînement. Elle produit des embeddings hautement discriminants.
- Perte ArcFace : Sans doute la fonction de perte la plus utilisée dans les systèmes de reconnaissance faciale en production en 2026. Elle ajoute une pénalité de marge angulaire additive dans l’espace angulaire entre le vecteur de caractéristiques et le poids de la classe correspondante, ce qui produit des regroupements intra-classes plus compacts et des écarts interclasses plus importants que les approches à marge cosinus. Le projet [InsightFace](https://github.com/deepinsight/insightface) fournit l’implémentation de référence, et la plupart des modèles de pointe sont entraînés avec ArcFace ou l’une de ses variantes — la marge adaptative d’AdaFace, par exemple, repose sur la formulation d’ArcFace. Si vous entraînez ou affinez votre propre modèle de reconnaissance faciale, ArcFace constitue le point de départ par défaut.
- Perte CosFace : Ajoute une marge cosinus à la perte softmax, obligeant le réseau à produire des embeddings plus étroitement regroupés pour chaque identité et mieux séparés entre les différentes identités.
- SphereFace / A-Softmax : L’approche originale à marge angulaire datant de 2017. Historiquement importante, mais largement remplacée par ArcFace et des fonctions de perte plus modernes.
La sortie : Un vecteur de 512 nombres flottants, normalisé en L2 sur l’hypersphère unité. Toutes les informations relatives à un visage sont compressées dans 2 Ko de données. C’est ce vecteur qui est stocké, indexé et comparé.
Le piège de la normalisation : De nombreux développeurs oublient que les embeddings doivent être normalisés en L2 avant d’être comparés. Les embeddings non normalisés produisent des scores de similarité extrêmement incohérents. C’est un bug courant et difficile à diagnostiquer, car le système « fonctionne plus ou moins » : l’ordre relatif des correspondances peut sembler correct pendant les tests, mais les scores de similarité absolus varient d’une image à l’autre, rendant les décisions fondées sur un seuil peu fiables. FaceNet512 produit par défaut des embeddings normalisés, mais si vous utilisez un modèle personnalisé ou effectuez une exportation via ONNX, vérifiez toujours que les embeddings de sortie se trouvent sur l’hypersphère unité — autrement dit, que leur norme L2 est égale à 1,0.
Déploiement en production : ONNX Runtime et quantification : Les vitesses annoncées dans les benchmarks supposent une inférence FP32 sur un GPU dédié. En production, la plupart des systèmes sont déployés via ONNX Runtime avec une quantification INT8, ce qui réduit le temps d’inférence d’un facteur 2 à 3 avec une perte de précision minimale — généralement inférieure à 0,1 % sur LFW. Le processus est le suivant : exportez votre modèle PyTorch ou TensorFlow vers ONNX, exécutez l’outil de quantification d’ONNX Runtime avec un jeu d’étalonnage d’environ 1 000 images de visages, puis déployez le modèle quantifié. C’est ainsi que vous passez de « 10 ms par visage » à « 3 à 4 ms par visage » sur le même matériel, ce qui est crucial lorsque vous traitez des milliards d’images.
Inférence en précision mixte : Utiliser FP16 sur GPU pour l’architecture dorsale, mais FP32 pour la dernière couche d’embedding, permet d’éviter les problèmes de précision en virgule flottante décrits plus loin dans cet article, tout en obtenant une accélération de 1,5 à 2 fois. Il s’agit d’un compromis pratique entre le FP32 intégral — précis, mais lent — et le FP16 intégral — rapide, mais susceptible de produire des embeddings légèrement différents selon le matériel.
Distillation des embeddings pour le déploiement en périphérie : Vous pouvez entraîner un réseau élève plus petit — MobileFaceNet, environ 1 million de paramètres — à reproduire les embeddings de FaceNet512 grâce à la distillation des connaissances. Le modèle élève atteint plus de 95 % de la précision à une vitesse dix fois supérieure, ce qui le rend viable pour les déploiements mobiles et en périphérie où un GPU n’est pas envisageable. L’idée essentielle est qu’il n’est pas nécessaire d’entraîner l’élève à partir de zéro avec des étiquettes d’identité : vous l’entraînez à reproduire les embeddings du modèle enseignant sur des données faciales non étiquetées, ce qui exige beaucoup moins de calculs et aucun jeu de données étiqueté par identité.
Étape 4 : mise en correspondance
À partir de deux embeddings faciaux, comment déterminer s’ils correspondent à la même personne ? Deux approches existent :
Similarité cosinus : Calculez le cosinus de l’angle entre deux vecteurs d’embedding. La plage va de -1 à 1, où 1 signifie qu’ils sont identiques. Un seuil typique pour conclure qu’il s’agit de la « même personne » se situe entre 0,4 et 0,6 selon le modèle et le cas d’usage. Cette méthode est simple, rapide et efficace, car les embeddings de FaceNet512 sont normalisés en L2.
Distance euclidienne : Calculez la distance L2 entre les vecteurs. Pour des embeddings normalisés, cette mesure est mathématiquement équivalente à la similarité cosinus (d = sqrt(2 - 2*cos_sim)). Certains systèmes préfèrent cette formulation.
Pour la recherche (mise en correspondance 1:N) : Lorsque vous devez trouver un visage dans une base de données de plusieurs millions d’entrées, une comparaison exhaustive est trop lente. Utilisez une recherche approximative des plus proches voisins (ANN) :
- FAISS (Facebook AI Similarity Search) : La bibliothèque de référence. Elle prend en charge l’accélération GPU et plusieurs types d’index — IVF, HNSW, PQ. Elle peut rechercher parmi 1 milliard de vecteurs en quelques millisecondes. Gratuite et open source.
- Milvus : Base de données vectorielle spécialement conçue à cet effet, utilisant FAISS en interne et ajoutant des couches de persistance, de mise à l’échelle et d’API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/) : Bases de données vectorielles gérées si vous ne souhaitez pas exploiter vous-même l’infrastructure.
Pour une base de données de 10 millions de visages, un index HNSW FAISS correctement réglé sur un seul GPU peut renvoyer les 10 meilleures correspondances en moins de 5 millisecondes.
Le choix du type d’index FAISS est extrêmement important. IVF-PQ offre une excellente compression — 8 à 16 octets par vecteur au lieu de 2 Ko — mais réduit la précision sur les correspondances limites, lorsque l’erreur de quantification fait passer une véritable correspondance sous le seuil. HNSW préserve la précision, mais utilise 4 à 8 fois plus de mémoire, car il stocke les vecteurs flottants complets ainsi que la structure du graphe. Les index hybrides IVF-HNSW offrent le meilleur compromis pour des volumes allant de 10 millions à 1 milliard d’entrées. La plupart des équipes choisissent initialement le mauvais type d’index en suivant les recommandations de tutoriels, puis doivent reconstruire toute leur infrastructure d’indexation six mois plus tard lorsqu’elles en atteignent les limites. Testez votre charge de travail spécifique avec des volumes de données et des schémas de requêtes réalistes avant de choisir un type d’index.
Le problème du démarrage à froid des index ANN : Les index HNSW et IVF ont besoin d’un nombre minimal de vecteurs pour être efficaces. Avec moins d’environ 10 000 vecteurs, la recherche exhaustive est en réalité plus rapide que la recherche indexée, car la surcharge de l’index — parcours du graphe et comparaison avec les centroïdes — domine le calcul. Commencez par une recherche exhaustive — FAISS IndexFlatIP — pendant votre phase initiale de croissance, puis migrez vers un index ANN lorsque votre base de données dépasse 50 000 à 100 000 vecteurs.
Préfiltrage à l’aide de codes binaires : Le calcul d’un hachage binaire pour chaque embedding — par binarisation ou avec SimHash — permet d’effectuer un préfiltrage peu coûteux par distance de Hamming avant les comparaisons plus coûteuses de nombres flottants. Cela peut réduire l’ensemble des candidats de plus de 90 % avec une perte de rappel minimale. Le principe consiste à stocker un code binaire de 256 ou 512 bits avec chaque embedding complet. Pour une requête, calculez d’abord la distance de Hamming avec tous les codes binaires — une opération extrêmement rapide grâce aux instructions CPU POPCNT —, retenez les 1 à 5 % de meilleurs candidats, puis calculez la similarité cosinus exacte uniquement pour ceux-ci. Cette approche en deux étapes est particulièrement efficace lorsque votre jeu de données dépasse la mémoire GPU disponible.
Reclassement à l’aide des attributs du visage : La recherche initiale d’embeddings renvoie des candidats ; un second passage utilisant des attributs estimés — tranche d’âge, genre, couleur de peau, pilosité faciale — permet d’éliminer les fausses correspondances évidentes. Si le visage recherché est estimé comme celui d’une femme de 25 ans et qu’un candidat est estimé comme celui d’un homme de 60 ans, il s’agit presque certainement d’un faux positif, quel que soit le score de similarité des embeddings. Cette heuristique simple peut réduire les faux positifs de 30 à 50 % pour un coût de calcul minimal. C’est l’une des techniques les moins exploitées dans les systèmes de recherche faciale en production.
Cohérence temporelle dans les vidéos : Si vous comparez des visages provenant de vidéos plutôt que de photos, calculer la moyenne des embeddings sur plusieurs images du même visage suivi améliore considérablement la précision — souvent de 5 à 10 % sur les benchmarks difficiles. L’agrégation des embeddings au niveau d’une piste est toujours préférable à la mise en correspondance image par image. L’approche consiste à utiliser un outil de suivi des visages — comme SORT ou DeepSORT — pour relier les détections entre les images, calculer les embeddings de chaque détection et les agréger en un seul « embedding de piste » à l’aide d’une moyenne pondérée par la qualité, où le poids correspond au score de qualité du visage obtenu à l’étape de détection.
Meilleurs modèles open source de reconnaissance faciale (2026)
FaceNet512
La référence absolue. FaceNet512 est la variante d’embedding à 512 dimensions de l’architecture FaceNet de Google. Elle offre un espace d’embedding plus vaste et plus discriminant que la version originale à 128 dimensions.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Architecture : Architecture dorsale Inception-ResNet-v2 produisant des embeddings à 512 dimensions
- Licence : MIT (permissive, utilisation commerciale autorisée)
- Précision sur LFW : 99,65 %
- Taille de l’embedding : 512 dimensions
- Compatibilité : Fonctionne avec les pipelines de détection standard — MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface) — pour une reconnaissance de bout en bout
- API Python : Disponible via la bibliothèque
deepfaceou des implémentations autonomes
Verdict : Si vous développez un système de reconnaissance faciale en 2026, FaceNet512 constitue un excellent point de départ. Il offre une excellente précision, des embeddings à 512 dimensions au fort pouvoir discriminant, une licence MIT permissive et une large prise en charge par l’écosystème.
FaceNet (Google, version originale à 128 dimensions)
Le modèle qui a popularisé l’approche par embeddings en 2015. Il a introduit l’entraînement par perte triplet, dans lequel le réseau apprend en comparant des triplets de visages ancre/positif/négatif.
- Article original : « FaceNet: A Unified Embedding for Face Recognition and Clustering » (Schroff et al., 2015)
- Dépôt : Plusieurs implémentations — davidsandberg/facenet est la version TensorFlow classique
- Licence : MIT
- Précision sur LFW : 99,63 % pour la version originale, jusqu’à 99,75 % avec un entraînement moderne
- Taille de l’embedding : 128 dimensions
- Architecture : Inception-ResNet-v1 ou Inception-ResNet-v2
Verdict : Historiquement important et toujours performant. L’embedding à 128 dimensions est plus compact, mais légèrement moins discriminant que celui à 512 dimensions de FaceNet512. Utilisez-le si vous avez besoin d’une empreinte mémoire réduite pour les embeddings ou si vous travaillez avec TensorFlow sous de fortes contraintes de mémoire.
DeepFace (Facebook/Meta)
À ne pas confondre avec la bibliothèque Python deepface — en minuscules. DeepFace de Meta, publié en 2014, a été l’une des premières approches de reconnaissance faciale fondées sur l’apprentissage profond à atteindre une précision proche de celle des humains sur LFW.
Le projet le plus pertinent aujourd’hui est la bibliothèque Python deepface de Serengil :
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Dépôt : github.com/serengil/deepface
- Licence : MIT
- Fonction : Bibliothèque d’abstraction fournissant une API unifiée pour plusieurs modèles sous-jacents : FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib et SFace
- Fonctionnalités incluses : Vérification, recherche et analyse des attributs du visage — âge, genre, origine ethnique et émotion
- Facilité d’utilisation : API extrêmement simple
Verdict : Le meilleur choix pour le prototypage et l’expérimentation. L’API unifiée permet de passer d’un modèle à l’autre en modifiant un seul paramètre. En production, il est préférable d’utiliser directement FaceNet512 afin de bénéficier de meilleures performances et d’un contrôle accru.
dlib
Bibliothèque C++ dotée de liaisons Python, maintenue par Davis King. Elle comprend un modèle de reconnaissance faciale entraîné sur un jeu de données de 3 millions d’images.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Dépôt : github.com/davisking/dlib
- Licence : Boost Software License (permissive)
- Précision sur LFW : 99,38 %
- Taille de l’embedding : 128 dimensions
- Détection : Fondée sur HOG — rapide et adaptée au CPU — ou sur un CNN — plus précis
Verdict : Une solution C++ extrêmement robuste et éprouvée, avec de bonnes liaisons Python. Sa précision est inférieure à celle de FaceNet512, mais sa fiabilité est remarquable. C’est un bon choix si vous travaillez en C++ ou avez besoin d’une solution légère sans dépendances PyTorch/ONNX.
AdaFace
Un modèle plus récent, publié en 2022, qui traite spécifiquement les variations de qualité des images. Les modèles standard sont entraînés sur des images de haute qualité et se dégradent lorsque les entrées sont de faible résolution ou floues. AdaFace adapte sa pénalité de marge à la qualité de l’image pendant l’entraînement.
- Dépôt : github.com/mk-minchul/AdaFace
- Licence : MIT
- Avantage principal : Performances supérieures sur les images de faible qualité — vidéosurveillance et caméras longue portée
- Précision sur LFW : 99,82 %
- TAR@FAR=1e-4 sur IJB-C : 97,39 % — surpasse la plupart des modèles open source sur les benchmarks difficiles
Verdict : À utiliser lorsque vos images d’entrée sont de faible qualité. Pour la surveillance, l’analyse de vidéosurveillance ou tout scénario dans lequel vous ne maîtrisez pas la qualité des images, AdaFace offre des résultats sensiblement meilleurs que les modèles standard.
Tableau comparatif des performances
| Modèle | LFW (%) | Embedding | Vitesse (ms/visage) | Licence |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 dimensions | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 dimensions | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 dimensions | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 dimensions | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2 048 dimensions | ~15 ms (GPU) | CC BY-SA |
LFW (Labeled Faces in the Wild) est le benchmark de référence, mais il est aujourd’hui pratiquement résolu. Tous les modèles modernes dépassent 99 %. Les véritables différences apparaissent sur des benchmarks plus difficiles comme IJB-C — conditions variées — et TinyFace — faible résolution.
Remarque sur les benchmarks par rapport à la réalité : Ces vitesses correspondent à une inférence FP32 sur un seul visage avec un GPU déjà initialisé. En production, avec une quantification INT8 via ONNX Runtime, attendez-vous à des performances 2 à 3 fois supérieures. Mais n’oubliez pas que le pipeline complet — détection, alignement, évaluation de la qualité et embedding — prend 3 à 5 fois plus de temps que la seule extraction des embeddings. Sur un seul GPU A100, un débit réaliste de bout en bout pour l’ensemble du pipeline est de 200 à 400 visages par seconde, et non les milliers que pourraient laisser penser les benchmarks limités aux embeddings.
L’écart entre les modèles open source et les systèmes de production
Voici ce que les tutoriels ne vous disent pas : faire fonctionner un modèle de reconnaissance faciale dans un notebook Jupyter est la partie facile. Construire un système de production qui fonctionne réellement à grande échelle exige de résoudre une longue liste de problèmes d’ingénierie qu’aucun modèle ne résoudra pour vous. La plupart des équipes sous-estiment considérablement le coût et les délais. Ce qui ressemble au départ à un projet consistant à « simplement brancher le modèle » se transforme en 12 à 24 mois de travail d’ingénierie pouvant facilement engloutir entre 500 000 $ et plus de 2 millions de dollars avant même d’être prêt pour la production, sans compter les coûts d’exploitation récurrents.
La facture d’infrastructure
Calcul GPU pour l’extraction des embeddings. Exécuter la détection des visages et l’extraction des embeddings sur des milliards d’images ne se fait pas sur un ordinateur portable. Un seul GPU NVIDIA A100 peut traiter environ 200 à 400 visages par seconde avec un pipeline complet de détection, d’alignement et d’embedding. Pour traiter 1 milliard d’images dans un délai raisonnable — moins d’une semaine, par exemple —, vous avez besoin d’un cluster de 40 à 80 GPU fonctionnant en continu. Aux tarifs du cloud, cela représente entre 50 000 et 150 000 $ par cycle de traitement, et vous devrez tout retraiter à mesure que votre modèle s’améliorera ou que votre pipeline évoluera. Acheter directement le matériel signifie investir entre 300 000 et 800 000 $ dans des serveurs GPU, auxquels s’ajoutent l’espace en baie, l’électricité, le refroidissement et le personnel chargé de la maintenance.
Stockage à grande échelle. Un milliard d’embeddings faciaux composés de 512 nombres flottants — 2 Ko chacun — représentent à eux seuls environ 2 To de données vectorielles. Ajoutez les images originales, les miniatures, les métadonnées et les structures d’index, et vous atteignez des centaines de téraoctets, voire quelques pétaoctets de stockage. Dans le cloud, le stockage NVMe hautes performances destiné aux index vectoriels coûte entre 0,10 et 0,25 $ par Go et par mois. Avec 50 To de stockage actif, cela représente entre 5 000 et 12 500 $ par mois rien que pour maintenir le système en fonctionnement.
Infrastructure de recherche vectorielle. Sur une seule machine, FAISS atteint ses limites autour de 100 à 500 millions de vecteurs, selon le type d’index et la mémoire vive disponible. Au-delà, vous avez besoin d’une recherche distribuée sur plusieurs fragments, avec équilibrage de charge, réplication pour la tolérance aux pannes et suffisamment de RAM pour contenir les index. Un déploiement distribué de FAISS ou de Milvus adapté à la production pour plus d’un milliard de vecteurs nécessite généralement 8 à 16 machines dotées de beaucoup de mémoire — au moins 256 Go de RAM chacune —, pour un coût de calcul dans le cloud compris entre 15 000 et 40 000 $ par mois.
Réseau et bande passante. Explorer des milliards d’images implique de télécharger des pétaoctets de données. Avec des frais de sortie de 0,05 à 0,09 $ par Go chez les principaux fournisseurs de cloud, le seul transfert de données peut coûter des dizaines de milliers de dollars. Vous avez également besoin d’un réseau interne à haut débit entre les robots d’exploration, les nœuds de traitement GPU et les systèmes de stockage.
Estimation du coût total de l’infrastructure d’un moteur de recherche faciale à l’échelle du Web : entre 30 000 et 80 000 $ par mois de coûts cloud récurrents, ou entre 500 000 et 1,5 million de dollars d’investissement matériel initial, auxquels s’ajoutent entre 10 000 et 20 000 $ par mois pour l’électricité, la bande passante et la maintenance. Et il ne s’agit que de l’infrastructure, avant même qu’un seul ingénieur n’écrive une ligne de code applicatif.
Le calendrier d’ingénierie
Construire un système de recherche faciale destiné à la production n’est pas un projet de hackathon. Voici un calendrier réaliste pour une équipe de 3 à 5 ingénieurs expérimentés :
Mois 1 à 3 : pipeline principal. Faire fonctionner de manière fiable la détection, l’alignement et l’extraction des embeddings. Construire l’index vectoriel de base. Gérer l’ingestion d’images à partir de fichiers locaux. C’est la partie « amusante », où tout semble bien se passer et où la démonstration est impressionnante.
Mois 3 à 6 : infrastructure d’exploration du Web. Créer des robots d’extraction pour les principales plateformes. Gérer les limitations de débit, les CAPTCHA, les écrans de connexion, le rendu dynamique — sites fortement dépendants de JavaScript —, la déduplication des images et le filtrage du contenu. Découvrir que chaque plateforme de réseau social utilise des mesures anti-extraction différentes qui cassent vos robots toutes les semaines. Mettre en place une surveillance permettant de détecter les pannes silencieuses. Cette phase peut à elle seule prendre plus de temps que prévu, car le Web est désordonné et hostile.
Mois 6 à 9 : montée en charge et fiabilité. Votre prototype fonctionnait avec 1 million de visages. Faites-le maintenant fonctionner avec 100 millions. Découvrez que votre index FAISS ne tient plus en RAM. Mettez en œuvre le partitionnement. Corrigez les conditions de concurrence de votre pipeline d’ingestion. Ajoutez une logique de nouvelle tentative pour les 15 % d’images dont le téléchargement échoue. Gérez les images corrompues, celles qui prétendent être des JPEG sans l’être, celles dotées de marqueurs de rotation EXIF et les téléchargements tronqués. Ajoutez une surveillance, des alertes et une journalisation afin de savoir quand le système tombe en panne à 3 heures du matin.
Mois 9 à 12 : qualité et précision. Constatez que votre taux de faux positifs à grande échelle est inacceptable. Mettez en œuvre une évaluation de la qualité des visages pour filtrer les embeddings inutilisables. Réglez les seuils pour chaque cas d’usage. Créez un mécanisme de retour permettant de signaler et d’examiner les mauvaises correspondances. Découvrez que votre modèle produit des résultats différents selon l’architecture GPU en raison de variations de précision en virgule flottante, puis passez deux semaines à en trouver la cause.
Mois 12 à 18 : préparation à la production. Construisez une couche d’API avec authentification, limitation du débit et suivi de l’utilisation. Ajoutez des fonctionnalités de conformité au RGPD et au CCPA : mécanismes d’opposition, demandes de suppression des données et journaux d’audit. Mettez en œuvre la mise en cache des résultats. Créez des outils d’administration. Rédigez la documentation. Gérez l’audit de sécurité. Effectuez des tests de charge complets. Corrigez les fuites de mémoire dont vous ignoriez l’existence.
Mois 18 à 24 : exploitation continue. Les robots d’exploration tombent en panne lorsque les sites Web modifient leur mise en page. Les modèles dérivent à mesure que de nouveaux types d’images apparaissent. Les disques se remplissent. Les index doivent être reconstruits. Les utilisateurs signalent des cas limites que vous n’aviez jamais anticipés. Quelqu’un découvre que votre système renvoie des correspondances avec un niveau de confiance élevé pour des visages de dessins animés, et vous devez ajouter un filtre distinguant les « vrais visages ». Cela ne s’arrête jamais.
La liste complète des problèmes que vous rencontrerez
Au-delà de l’infrastructure et des délais, voici tous les grands problèmes auxquels les équipes sont confrontées lorsqu’elles construisent des systèmes de reconnaissance faciale à partir de zéro. Cette liste provient de véritables systèmes de production, et non de préoccupations théoriques.
Cauchemars liés à la qualité des données :
- Des données médiocres produisent des résultats médiocres. Internet regorge de mèmes, de visages générés par IA, de dessins, de photos de photos, de couvertures de magazines et de statues. Votre détecteur trouvera des « visages » dans tous ces contenus et produira des embeddings qui pollueront votre index. Vous avez besoin de classificateurs capables de filtrer les visages synthétiques, les visages illustrés, les recadrages à très faible résolution et les contenus non photographiques. Construire et maintenir ces filtres constitue un projet à part entière.
- Images dupliquées et quasi dupliquées. La même photo apparaît sur des dizaines de sites avec des recadrages, des filigranes, des niveaux de compression et des ajustements de couleur différents. Sans déduplication, une seule photo virale génère des centaines de « correspondances » qui sont toutes la même image et masquent les véritables résultats. Le hachage perceptuel — pHash, dHash — est utile, mais imparfait. Vous avez besoin d’une déduplication à plusieurs niveaux : au niveau des URL — trivial —, du hachage perceptuel — qui détecte les copies redimensionnées et recompressées — et des embeddings — qui détectent le même visage photographié sous des angles légèrement différents. Chaque niveau détecte des éléments manqués par les autres, et vous consacrerez probablement plus de temps à la déduplication que prévu.
- Évolution de l’âge et de l’apparence. L’embedding d’une photo universitaire peut ne pas correspondre à celui d’une photo prise 15 ans plus tard. Les variations de poids, le vieillissement, la chirurgie esthétique, la pilosité faciale et les différentes coiffures influent tous sur la précision de la reconnaissance. Aucun modèle ne gère parfaitement ces changements. Les utilisateurs reprocheront à votre système de ne pas reconnaître une personne sur une période de 20 ans.
- Biais démographiques. Les modèles open source entraînés principalement sur des jeux de données occidentaux ou caucasiens sont moins performants avec les autres groupes démographiques. Les écarts de précision entre groupes ethniques sont plus importants que ne le suggère LFW, dont environ 77 % des sujets sont caucasiens. Lors d’un déploiement mondial, les écarts de précision entre groupes démographiques peuvent atteindre 5 à 15 % sur les benchmarks difficiles. Les modèles comme FaceNet512, entraînés sur MS-Celeb-1M, héritent de ses déséquilibres démographiques. Pour obtenir des performances équitables, il est important d’effectuer un affinage sur des jeux de données équilibrés — comme BUPT-Balancedface — ou d’utiliser des stratégies d’entraînement tenant compte des caractéristiques démographiques. Si vous n’évaluez pas la précision pour chaque groupe ethnique, vous risquez de commercialiser un système qui fonctionne bien pour certains utilisateurs et mal pour d’autres. Ce n’est pas seulement une question éthique, mais aussi un problème de qualité produit et de responsabilité juridique.
- Gestion de l’orientation EXIF. Environ 15 à 20 % des images du Web comportent des balises d’orientation EXIF qui, si elles sont ignorées, produisent des visages tournés sur le côté ou à l’envers. La plupart des détecteurs faciaux ne trouvent pas les visages pivotés. Ce problème réduit silencieusement la précision et passe facilement inaperçu pendant les tests — où les images sont correctement orientées —, mais il est dévastateur en production. Appliquez toujours la correction de l’orientation EXIF dès la toute première étape de votre pipeline de traitement des images.
- Échecs de décodage des JPEG progressifs et des fichiers WebP. Certaines bibliothèques d’images produisent silencieusement des données de pixels corrompues à partir de JPEG progressifs partiellement téléchargés ou de fichiers WebP tronqués. Le détecteur peut malgré tout trouver un « visage » dans les artefacts de corruption et produire un embedding inutilisable. Avant le traitement, vous devez valider l’intégrité de l’image en vérifiant que le fichier se décode sans erreur et que le tampon de pixels obtenu possède des dimensions plausibles. Sans cela, les images corrompues polluent silencieusement votre index.
Problèmes d’ingénierie qui ne sont pas évidents au départ :
- Gestion des versions des embeddings. Lorsque vous mettrez à niveau votre modèle — et vous le ferez, car les gains de précision comptent —, tous les embeddings de votre base de données deviendront incompatibles avec les sorties du nouveau modèle. Vous devrez soit recalculer les embeddings de toute la base — opération coûteuse et longue qui exige de conserver toutes les images originales —, soit exploiter des index parallèles pendant la migration — ce qui double le coût d’infrastructure —, soit maintenir une rétrocompatibilité — solution complexe qui limite vos possibilités d’amélioration. Il n’existe pas de bonne solution, seulement des solutions moins pénibles que les autres.
- Déterminisme des calculs en virgule flottante. La même image traitée sur différents modèles de GPU, avec différentes versions de CUDA, voire avec des tailles de lots différentes, peut produire des embeddings légèrement différents en raison de l’arithmétique en virgule flottante. Ces différences sont faibles — de 1e-6 à 1e-4 —, mais elles s’accumulent : une correspondance obtenant un score de 0,401 sur une machine peut obtenir 0,399 sur une autre, inversant une décision binaire fondée sur un seuil. Ce problème est particulièrement exaspérant lors du débogage. Les mises à jour des pilotes GPU constituent un piège majeur : les mises à jour des pilotes NVIDIA peuvent modifier le comportement des calculs en virgule flottante au niveau de CUDA. Un embedding calculé avec un pilote 535.x peut différer de celui de la même image calculé avec un pilote 545.x. En production, vous devez donc figer les versions des pilotes sur l’ensemble de votre parc et valider la cohérence des embeddings après chaque mise à jour.
- Concurrence et conditions de course. Plusieurs robots ingèrent simultanément des visages, les utilisateurs effectuent des recherches pendant la mise à jour de l’index et les demandes de suppression arrivent pendant l’assemblage des résultats. Les bases de données vectorielles ne disposent pas d’une gestion des transactions aussi mature que les bases SQL. Vous rencontrerez des scénarios où un visage n’est que partiellement indexé, où les requêtes renvoient des résultats obsolètes ou où une suppression ne se propage pas à tous les fragments.
- Gestion de la mémoire. Les index FAISS sont mappés en mémoire, mais les performances des requêtes dépendent fortement de la proportion de l’index qui tient dans la RAM. À mesure que l’index grandit, la latence des requêtes augmente de façon imprévisible lorsque le système d’exploitation évince des pages de l’index hors de la mémoire. Les arrêts provoqués par un manque de mémoire surviennent toujours au pire moment. Vous finirez par connaître intimement la gestion de la mémoire sous Linux, les paramètres de swap et la topologie [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). Le préchauffage après un démarrage à froid constitue un autre problème : les index FAISS HNSW sont mappés en mémoire et, après le redémarrage d’un serveur, les premières centaines de requêtes sont 10 à 100 fois plus lentes, car les pages de l’index n’ont pas encore été chargées en RAM. Vous devez prévoir une phase de préchauffage qui charge l’index avant d’accepter le trafic de production, faute de quoi les premiers utilisateurs après un déploiement subiront une latence désastreuse.
- Pannes silencieuses. Un robot d’exploration cesse de fonctionner parce qu’un site Web a modifié son HTML. Votre nœud de traitement GPU commence à produire des embeddings NaN après une mise à jour de pilote. Un disque se remplit et les nouveaux visages cessent silencieusement d’être indexés. Ces défaillances ne génèrent aucune erreur ; elles dégradent simplement votre système en silence. Sans une surveillance complète et une détection des anomalies, vous ne vous en apercevrez que lorsque les utilisateurs se plaindront.
- Le problème de l’actualisation de FAISS. Lorsque vous ajoutez de nouveaux embeddings à un index IVF, les cellules de Voronoï deviennent déséquilibrées. La qualité de la recherche se dégrade progressivement jusqu’à ce que vous réentraîniez le quantificateur. À l’échelle du Web, ce réentraînement nécessite plusieurs heures de GPU sur l’ensemble complet des données. Les équipes regroupent généralement les ajouts et effectuent un réentraînement chaque semaine ou chaque mois, ce qui signifie que les visages récemment ingérés ne peuvent pas être immédiatement recherchés avec une précision optimale. Vous devez constamment arbitrer entre fraîcheur et qualité de recherche ; il n’existe pas de solution sans compromis.
- Étalonnage des scores entre les fragments de l’index. Lorsque votre index est réparti entre plusieurs machines, les scores de similarité bruts des différents fragments ne sont pas directement comparables, car chaque fragment possède une distribution d’embeddings différente. Vous avez besoin d’une normalisation des scores par fragment — normalisation par cohorte, Z-norm ou T-norm — afin de fusionner les résultats de manière pertinente. Sans étalonnage, un score de 0,45 provenant du fragment A peut représenter une forte correspondance, tandis que le même score du fragment B peut n’être que médiocre. Les résultats fusionnés deviennent alors peu fiables.
- Le problème de la dispersion dans la recherche distribuée. Rechercher dans N fragments signifie effectuer N allers-retours réseau par requête. Si un seul fragment est lent — pause du ramasse-miettes, pic d’entrées-sorties disque ou problème réseau —, toute la requête ralentit. La latence P99 est déterminée par le P99 du fragment le plus lent, et elle se dégrade à mesure que vous ajoutez des fragments. Des techniques telles que les requêtes spéculatives — envoyer des requêtes en double et conserver la première réponse — et les délais d’expiration adaptatifs sont indispensables pour maintenir une latence extrême acceptable.
Problèmes de précision et de mise en correspondance :
- Le réglage des seuils n’est jamais « terminé ». Le seuil de similarité optimal évolue à mesure que votre base de données grandit. Avec 1 million de visages, un seuil de 0,45 offre un bon équilibre entre précision et rappel. Avec 100 millions de visages, ce même seuil génère dix fois plus de faux positifs, simplement parce que le nombre de sosies presque correspondants est supérieur. Vous avez besoin de seuils adaptatifs ou d’un reclassement après traitement. Les mathématiques sous-jacentes sont implacables : lorsque votre base passe de 1 million à 100 millions, puis à 1 milliard de visages, la distribution des scores de similarité des k meilleurs résultats se déplace vers le haut, car les sosies proches sont plus nombreux. Un seuil fixe donnant un taux de faux positifs de 0,1 % avec 1 million de visages peut en produire 10 % avec 1 milliard. Vous devez modéliser cette distribution et ajuster dynamiquement les seuils, faute de quoi votre précision diminuera avec l’échelle.
- Reconnaissance en ensemble ouvert ou fermé. La plupart des benchmarks évaluent les performances en ensemble fermé, où la présence de la personne recherchée dans la base de données est garantie. La recherche faciale réelle fonctionne en ensemble ouvert : le visage recherché peut ne pas exister du tout dans l’index. L’évaluation en ensemble ouvert nécessite des métriques totalement différentes — TPIR pour un FPIR fixe, plutôt que précision au rang 1 — et le mode d’échec correspond aux fausses correspondances plutôt qu’aux mauvais classements. Un système obtenant 99 % sur des benchmarks en ensemble fermé peut présenter un taux de fausses correspondances de 10 % lors d’un déploiement en ensemble ouvert, parce qu’il renvoie avec assurance le visage « le plus proche » même lorsque la véritable personne est absente. Savoir répondre correctement « aucune correspondance trouvée » est aussi important que de trouver les bonnes correspondances.
- Sosies et doubles. Dans une base de plus de 100 millions de visages, de nombreuses personnes sans lien entre elles présentent des embeddings étonnamment proches. Plus votre base est grande, plus vous observerez de fausses correspondances. Les utilisateurs signaleront régulièrement des résultats correspondant à la « mauvaise personne ». Vous devez prévoir une stratégie : vérification à partir de plusieurs photos, signaux contextuels — nom, lieu — et files d’examen humain.
- La reconnaissance indépendante de la pose reste difficile. Même FaceNet512 se dégrade sensiblement au-delà d’un angle de lacet de plus ou moins 60 degrés. La précision d’une mise en correspondance entre un profil et un visage de face peut diminuer de 10 à 20 % par rapport à une comparaison entre deux visages de face. Dans les scénarios de surveillance, la plupart des visages sont vus sous un angle oblique, ce qui signifie que votre précision réelle est nettement inférieure à celle suggérée par les benchmarks. Les modèles entraînés avec une augmentation tenant compte de la 3D ou des architectures comme UV-GAN sont utiles, mais ajoutent de la complexité. Si vos données d’entrée comportent de nombreux visages de biais, considérez ce point comme un problème majeur de précision, et non comme un simple cas limite.
- Entrées adversariales. Les utilisateurs soumettront des visages générés par IA, des deepfakes, des images composites et des photos délibérément perturbées. Certains testeront votre système ; d’autres chercheront à manipuler les résultats. Votre système doit offrir une certaine robustesse face à ces entrées, faute de quoi il renverra des correspondances très confiantes pour de faux visages.
- Manipulation des photos. Filtres, applications d’embellissement, maquillage prononcé et logiciels de retouche des visages : la réalité d’Instagram diffère de la réalité véritable. Ces modifications changent suffisamment la géométrie faciale pour influer sur la similarité des embeddings. Un selfie fortement filtré peut ne pas correspondre à une photo non filtrée de la même personne.
- Un visage, de nombreux embeddings. Une seule personne peut avoir des centaines de photos en ligne, réparties entre différentes plateformes, différents angles et différentes années. Devez-vous les renvoyer comme des correspondances distinctes ou les regrouper sous une même identité ? Le regroupement à grande échelle — des centaines de millions de visages — est coûteux en calcul et présente ses propres modes d’échec : fusion excessive — regroupement de deux personnes différentes — et fusion insuffisante — incapacité à relier les photos de la même personne.
Difficultés opérationnelles :
- Course aux armements contre l’extraction automatisée. Toutes les grandes plateformes de réseaux sociaux bloquent activement les robots d’extraction. Elles modifient la structure de leurs pages, ajoutent des CAPTCHA, détectent les navigateurs sans interface graphique, limitent le débit par adresse IP, identifient les schémas de requêtes et servent parfois des contenus leurres. Votre infrastructure d’exploration participe à une course aux armements permanente. Un robot fonctionnant aujourd’hui peut être totalement bloqué la semaine prochaine. La maintenance des robots constitue un coût d’ingénierie récurrent, et non un développement ponctuel.
- Modélisation du rythme des changements. Les différentes sources évoluent à des rythmes différents. Les sites d’actualité consacrés aux célébrités reçoivent de nouvelles photos toutes les heures ; les profils personnels sur les réseaux sociaux peuvent rester inchangés pendant des années. Une planification intelligente des nouvelles explorations fondée sur les fréquences historiques de changement peut réduire les coûts de bande passante de 60 à 80 %, tout en conservant un index plus récent là où cela compte. Sans cette optimisation, vous explorez trop souvent les sources statiques — gaspillant bande passante et argent — ou trop peu les sources dynamiques — servant des résultats obsolètes.
- CDN et variations géographiques du contenu. La même URL peut fournir des images différentes selon la localisation, l’agent utilisateur de l’appareil ou les cookies du demandeur. Votre robot peut indexer une image différente de celle que voit l’utilisateur, ce qui entraîne des signalements déroutants du type « la correspondance ne ressemble pas au résultat ». Certains CDN servent des espaces réservés en basse résolution jusqu’à ce qu’un vrai navigateur fasse défiler la page et place l’image dans la zone visible. Vous devez gérer ces cas limites ou accepter un certain pourcentage de résultats fantômes.
- Croissance des coûts de stockage. Le stockage des images augmente linéairement et ne s’arrête jamais. Vous ne pouvez pas supprimer les originaux si vous risquez de devoir recalculer leurs embeddings. Miniatures, métadonnées, vecteurs d’embedding, fichiers d’index et copies de sauvegarde : la facture de stockage s’accélère à mesure que votre système mûrit. Les équipes qui avaient budgétisé le stockage de la première année sont stupéfaites par les coûts de la troisième.
- Demandes de conformité à grande échelle. Le RGPD accorde aux personnes le droit de demander la suppression de leurs données. Lorsqu’une personne exerce son droit d’opposition, vous devez trouver tous les embeddings générés à partir de son visage dans l’ensemble de votre base, les supprimer, vous assurer qu’ils ne seront pas réintroduits lorsque vos robots retrouveront les images originales, et documenter la suppression à des fins d’audit. À grande échelle, cela nécessite des outils dédiés et un travail d’ingénierie important. Le [règlement européen sur l’IA](https://artificialintelligenceact.eu/) impose des exigences supplémentaires aux systèmes d’IA à haut risque, notamment ceux de reconnaissance faciale : évaluations obligatoires de conformité, tests des biais, obligations de transparence et mécanismes de supervision humaine.
- La mise en œuvre du droit d’opposition est plus difficile qu’il n’y paraît. Vous ne pouvez pas simplement supprimer un embedding ; vous devez empêcher sa réindexation lorsque le robot rencontre à nouveau le même visage. Cela nécessite de conserver un index de « blocage » contenant les embeddings des personnes ayant exercé leur droit d’opposition et de comparer chaque nouvel embedding à cet index avant de l’ajouter. Cette liste doit elle-même être rapide — elle est interrogée à chaque insertion — et soulève ses propres questions de conservation des données : vous devez stocker de manière permanente l’embedding facial de la personne afin de pouvoir le reconnaître, ce qui revient à conserver des données biométriques pour respecter une demande de suppression. Cette tension juridique est réelle et demeure non résolue dans de nombreuses juridictions.
- Le problème du consentement pour les données publiques explorées. La base légale prévue par le RGPD pour le traitement de données biométriques provenant de profils publics sur les réseaux sociaux fait l’objet de contestations juridiques. Plusieurs autorités européennes de protection des données se sont prononcées contre des entreprises de reconnaissance faciale — notamment dans les décisions Clearview AI de plusieurs États membres de l’UE. Votre risque juridique dépend de la juridiction, de la source des données et du cas d’usage. Il ne s’agit pas d’une préoccupation hypothétique pour l’avenir, mais d’un domaine où des mesures d’application sont déjà prises.
- Coût de stockage des pistes d’audit. Si vous journalisez chaque requête de recherche et chaque correspondance renvoyée — ce que la conformité peut exiger —, les journaux d’audit peuvent croître plus rapidement que les données faciales elles-mêmes. Un système traitant 1 million de recherches par jour avec 10 résultats chacune génère environ 10 millions d’enregistrements d’audit quotidiens. Les obligations de conservation — souvent de 1 à 7 ans selon la juridiction — font s’accumuler ces données sans relâche. Considérez le stockage des audits comme un poste de coût majeur, et non comme un détail secondaire.
- Réponse aux incidents. Que se passe-t-il lorsque votre système associe incorrectement un visage et qu’une personne agit sur la base de cette fausse correspondance ? Vous avez besoin de pistes d’audit montrant comment chaque résultat a été généré, de la capacité à expliquer les décisions de mise en correspondance et d’un processus de gestion des contestations. Lorsqu’une personne conteste une correspondance, répondre que « la similarité cosinus était de 0,47, soit davantage que notre seuil de 0,42 » n’est pas une explication satisfaisante. Des techniques comme GradCAM peuvent montrer quelles régions du visage ont déterminé la correspondance, ce qui facilite le règlement des litiges et renforce la confiance. Il ne s’agit pas seulement d’une bonne pratique d’ingénierie : cela peut être une obligation légale selon votre juridiction.
- Obsolescence des modèles et des dépendances. Les versions de CUDA, de Python, d’[ONNX Runtime](https://onnxruntime.ai/) et les mises à jour du système d’exploitation évoluent toutes avec le temps et peuvent casser subtilement votre pipeline d’inférence. Figer les versions est utile jusqu’à ce qu’un correctif de sécurité devienne nécessaire. Vous consacrerez un temps étonnamment important à la gestion des dépendances et à la reproductibilité des environnements.
- Concentration des connaissances au sein de l’équipe. L’ingénieur qui a construit la couche d’indexation FAISS comprend la logique de partitionnement. Celui qui a réglé les robots sait quels sites nécessitent un traitement particulier. Lorsque ces personnes partent — et sur un projet de 18 à 24 mois, il y aura du renouvellement —, des connaissances essentielles disparaissent avec elles. La documentation aide, mais ne restitue jamais entièrement les raisons qui sous-tendent les décisions non évidentes.
Récapitulatif du coût réel
Pour un système de recherche faciale à l’échelle du Web interrogeant l’Internet public :
- Équipe d’ingénierie : 3 à 5 ingénieurs seniors pendant 12 à 24 mois = entre 600 000 et 2,5 millions de dollars en salaires et frais généraux
- Infrastructure (1re année) : entre 400 000 et 1 million de dollars de coûts cloud ou de matériel
- Infrastructure (récurrente) : entre 30 000 et 80 000 $ par mois — soit entre 360 000 et 960 000 $ par an
- Juridique et conformité : entre 50 000 et 200 000 $ pour l’évaluation initiale, auxquels s’ajoutent les conseils récurrents
- Total pour la 1re année : entre 1,4 et 3,7 millions de dollars
- Total à partir de la 2e année : entre 500 000 et 1,2 million de dollars par an pour l’infrastructure et la maintenance technique
Et cela concerne un système qui fonctionne. De nombreuses équipes dépensent plus de 500 000 $ et consacrent 6 à 12 mois au projet avant de comprendre que le problème est plus difficile qu’elles ne l’avaient estimé et de se tourner vers une solution par API.
Quand développer soi-même et quand utiliser une API
Développez votre propre système si :
- Vous disposez d’un jeu de données fermé — badges d’employés, photos de clients — de moins de 100 000 visages
- Le système doit fonctionner sur site ou dans un environnement isolé
- Vous disposez d’ingénieurs en apprentissage automatique capables de gérer l’optimisation des modèles, le réglage des seuils et les cas limites
- Votre cas d’usage concerne la vérification (1: 1) plutôt que la recherche (1:N sur le Web)
- Vous disposez du budget et du temps nécessaires pour vous engager dans un projet d’ingénierie sur plusieurs années
Utilisez une API si :
- Vous devez rechercher des visages sur l’Internet public — réseaux sociaux, actualités et Web
- Vous ne souhaitez pas construire et maintenir un pipeline d’extraction et d’indexation du Web
- Vous avez besoin de résultats maintenant, et non après 12 à 24 mois d’ingénierie
- Le système doit rester à jour avec les nouveaux contenus publiés en ligne
- Vous souhaitez déléguer la conformité au RGPD, les demandes d’opposition et le règlement européen sur l’IA
- Vous voulez éviter plus de 1 million de dollars de coûts initiaux d’infrastructure et d’ingénierie
- Votre produit principal n’est pas la recherche faciale elle-même et le temps d’ingénierie serait mieux consacré à votre véritable produit
API de recherche faciale FaceCheck.id
Pour les développeurs qui ont besoin d’effectuer des recherches faciales sur le Web public sans construire toute l’infrastructure à partir de zéro, FaceCheck.id propose une API REST qui prend en charge l’ensemble du pipeline : détection, embedding et recherche dans un index continuellement mis à jour d’images faciales accessibles au public provenant des réseaux sociaux, des sites d’actualité et du Web au sens large.
FaceCheck.id utilise un modèle propriétaire de reconnaissance faciale optimisé pour la recherche à l’échelle du Web. Contrairement aux modèles open source que vous devriez déployer et régler vous-même, son modèle propriétaire est spécialement entraîné et affiné pour répondre aux difficultés de la recherche faciale sur Internet : qualité d’image extrêmement variable, conditions d’éclairage diverses, diversité démographique et échelle considérable de son index continuellement alimenté. Cette approche propriétaire lui permet d’améliorer les performances du modèle de manière indépendante et d’optimiser son pipeline de recherche d’une façon inaccessible aux modèles open source généralistes. Des années d’ingénierie, de tests et d’améliorations ont été consacrées à faire fonctionner le système à un niveau qu’il serait extrêmement difficile et coûteux de reproduire à partir de zéro.
Fonctionnement de l’API :
Vous envoyez une image de visage, et l’API renvoie les visages correspondants trouvés sur Internet, accompagnés de scores de confiance et des URL sources. La mise en correspondance, l’indexation et l’infrastructure à l’échelle du Web sont gérées de leur côté. Tous les clusters de GPU, pipelines d’exploration, systèmes de recherche vectorielle, outils de conformité et opérations de maintenance décrits ci-dessus sont leur problème, pas le vôtre.
Principes de base de l’API :
- API JSON RESTful
- Authentification par clé API
- Envoi d’une image encodée en base64 ou d’une URL d’image
- Renvoie : un tableau de correspondances comprenant les scores de similarité, les URL sources et des aperçus miniatures
- Les limites de débit et les tarifs évoluent selon l’utilisation
Intégration typique :
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Cas d’usage de l’API :
- Vérification sur les applications de rencontre : Permettre aux utilisateurs de vérifier que les photos d’un contact apparaissent sur de véritables profils de réseaux sociaux
- Protection des marques : Vérifier si quelqu’un utilise les photos de votre équipe pour créer de faux profils professionnels
- Plateformes de vérification préalable : Ajouter la recherche faciale à des processus de vérification des antécédents ou de KYC
- Systèmes antifraude : Signaler les comptes utilisant des photos qui apparaissent ailleurs sur Internet sous des noms différents
- Outils OSINT : Créer des outils d’enquête intégrant la mise en correspondance faciale à l’échelle du Web
Pourquoi utiliser cette solution plutôt que de tout développer vous-même :
Construire un moteur de recherche faciale interrogeant le Web public exige : (1) un pipeline d’exploration à l’échelle du Web capable de découvrir et de télécharger des milliards d’images, (2) une infrastructure GPU coûtant des centaines de milliers de dollars pour exécuter la détection et l’extraction des embeddings, (3) un système distribué de recherche vectorielle doté de plusieurs téraoctets de RAM pour interroger l’ensemble de l’index en temps réel, (4) une nouvelle exploration continue afin de maintenir l’index à jour, (5) une infrastructure de conformité pour les droits d’opposition, les demandes de suppression et les obligations réglementaires, (6) une équipe de 3 à 5 ingénieurs chargée de sa maintenance à temps plein et (7) un délai de 12 à 24 mois avant la livraison de la première version utilisable. Il s’agit d’un projet d’ingénierie de plusieurs millions de dollars assorti de coûts récurrents importants. L’API, alimentée par le modèle propriétaire de FaceCheck.id et son infrastructure éprouvée, vous fournit tout cela en un seul appel HTTP.
Les modèles open source présentés ci-dessus sont excellents pour construire des systèmes fermés de reconnaissance faciale — contrôle d’accès des employés, organisation de photothèques et processus de vérification personnalisés. Mais si votre cas d’usage consiste à « rechercher sur Internet où apparaît ce visage », l’écart d’ingénierie entre un modèle fonctionnel et un produit fonctionnel est immense. L’API FaceCheck.id comble cet écart et vous permet de livrer un produit opérationnel en quelques jours plutôt qu’en plusieurs années.
Pour commencer : Consultez facecheck.id/en/Face-Search/API pour accéder à la documentation, aux tarifs et à l’inscription permettant d’obtenir une clé API.
FAQ
Quel est le modèle open source de reconnaissance faciale le plus précis ?
FaceNet512, avec une architecture dorsale Inception-ResNet-v2, obtient actuellement d’excellents résultats sur la plupart des benchmarks, notamment 99,65 % sur LFW. Pour les scénarios utilisant des images de faible qualité — surveillance, vidéosurveillance —, AdaFace affiche de meilleures performances sur des benchmarks difficiles comme IJB-C, avec un TAR@FAR=1e-4 de 97,39 %.
Puis-je utiliser commercialement les modèles open source de reconnaissance faciale ?
Oui. FaceNet512, FaceNet, DeepFace, dlib et AdaFace sont tous publiés sous des licences permissives — MIT ou Boost. Vous pouvez les utiliser dans des produits commerciaux. Tenez toutefois compte des restrictions juridiques relatives au traitement des données biométriques dans votre juridiction — RGPD, BIPA, règlement européen sur l’IA — qui s’appliquent indépendamment de la licence du logiciel.
De combien de données ai-je besoin pour entraîner mon propre modèle de reconnaissance faciale ?
Vous n’avez pas besoin de partir de zéro. Les modèles préentraînés énumérés ci-dessus ont été entraînés sur des jeux de données comprenant de 5 à 12 millions d’images et de 100 000 à 500 000 identités. Utilisez ces modèles préentraînés et ne procédez à un affinage que si votre domaine présente un besoin particulier. L’affinage nécessite généralement de 10 000 à 100 000 images. Un entraînement à partir de zéro exige des millions d’images et d’importantes ressources GPU.
Quelle est la différence entre la vérification faciale et la recherche faciale ?
La vérification faciale (1:1) répond à la question « ces deux photos représentent-elles la même personne ? » en comparant directement deux embeddings. La recherche faciale (1:N) répond à la question « où cette personne apparaît-elle ? » en comparant un embedding à une base de données de plusieurs millions d’entrées. La vérification est simple sur le plan informatique. La recherche exige une indexation efficace des plus proches voisins — FAISS, Milvus — et, pour une recherche à l’échelle du Web, une immense infrastructure d’exploration et d’indexation dont la construction et l’exploitation peuvent coûter plusieurs millions de dollars.
Quelle est la précision de la reconnaissance faciale sur des images de faible qualité ?
La précision diminue considérablement avec la qualité de l’image. Sur des photos nettes et prises de face, les modèles modernes atteignent plus de 99 % de précision. Sur des images de vidéosurveillance floues ou des photos où le visage fait moins de 50 pixels de large, la précision peut tomber entre 80 et 90 %, voire moins. AdaFace est spécialement conçu pour mieux gérer les variations de qualité que les modèles standard. Quel que soit le système, des images d’entrée de plus haute résolution produisent des résultats nettement meilleurs. La pose compte également : la précision sur des visages de profil peut diminuer de 10 à 20 % par rapport aux visages de face, même sur des images en haute résolution.
Combien coûte la création d’un moteur de recherche faciale ?
Pour un système à l’échelle du Web effectuant des recherches sur l’Internet public, prévoyez entre 1,4 et 3,7 millions de dollars la première année — équipe d’ingénierie, infrastructure et frais juridiques —, puis entre 500 000 et 1,2 million de dollars par an de coûts récurrents. Pour un système fermé interrogeant une base privée de moins de 100 000 visages, les coûts sont considérablement inférieurs : un seul serveur GPU et un ingénieur peuvent suffire. Le coût dépend de la taille de la base de recherche et de la nécessité ou non d’explorer le Web pour l’alimenter.
Combien de temps faut-il pour créer un système de reconnaissance faciale destiné à la production ?
Pour un système de vérification simple — comparaison 1:1 avec une base connue —, un ingénieur expérimenté peut réaliser un prototype fonctionnel en 1 à 2 semaines et le préparer pour la production en 1 à 3 mois. Pour un système de recherche faciale à l’échelle du Web — recherche 1:N sur Internet —, comptez 12 à 24 mois avec une équipe de 3 à 5 ingénieurs avant d’obtenir une solution suffisamment fiable pour la production. Les difficultés liées à l’exploration, à la montée en charge et à la conformité ajoutent énormément de temps au-delà du travail principal d’apprentissage automatique.
Construisez quelque chose qui compte. Commencez par FaceNet512 pour votre système fermé. Mais si vous avez besoin d’une recherche faciale à l’échelle du Web, posez-vous la question : souhaitez-vous vraiment dépenser entre 1,4 et 3,7 millions de dollars, recruter une équipe d’ingénieurs seniors et attendre 12 à 24 mois avant d’obtenir votre premier résultat exploitable ? Vous pouvez au contraire éviter entièrement les clusters de GPU, les cauchemars de l’exploration, les difficultés de conformité et des années d’ingénierie, puis obtenir vos premiers résultats de recherche en moins de 5 minutes, à partir de seulement 1 $ US, grâce à l’API FaceCheck.id.
Lire la suite sur la recherche par photo
Arnaques sentimentales : comment les repérer et les arrêter en 2026
Les arnaques sentimentales deviennent plus sophistiquées, mais les outils permettant de les détecter aussi. Ce guide présente les véritables mécanismes de ces escroqueries, les astuces photographiques utilisées par les escrocs et les moyens de vérifier l’identité de toute personne rencontrée en ligne avant d’y perdre votre argent ou d’avoir le cœur brisé.
Sur le sujet dans d'autres langues
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Sujets populaires
Deepfake Identité Reconnaissance Faciale Facebook Instagram Faux Profils Recherche Faciale BiométriqueAnalyse d'expert : PimEyes vs FaceCheck pour la reconnaissance faciale