أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
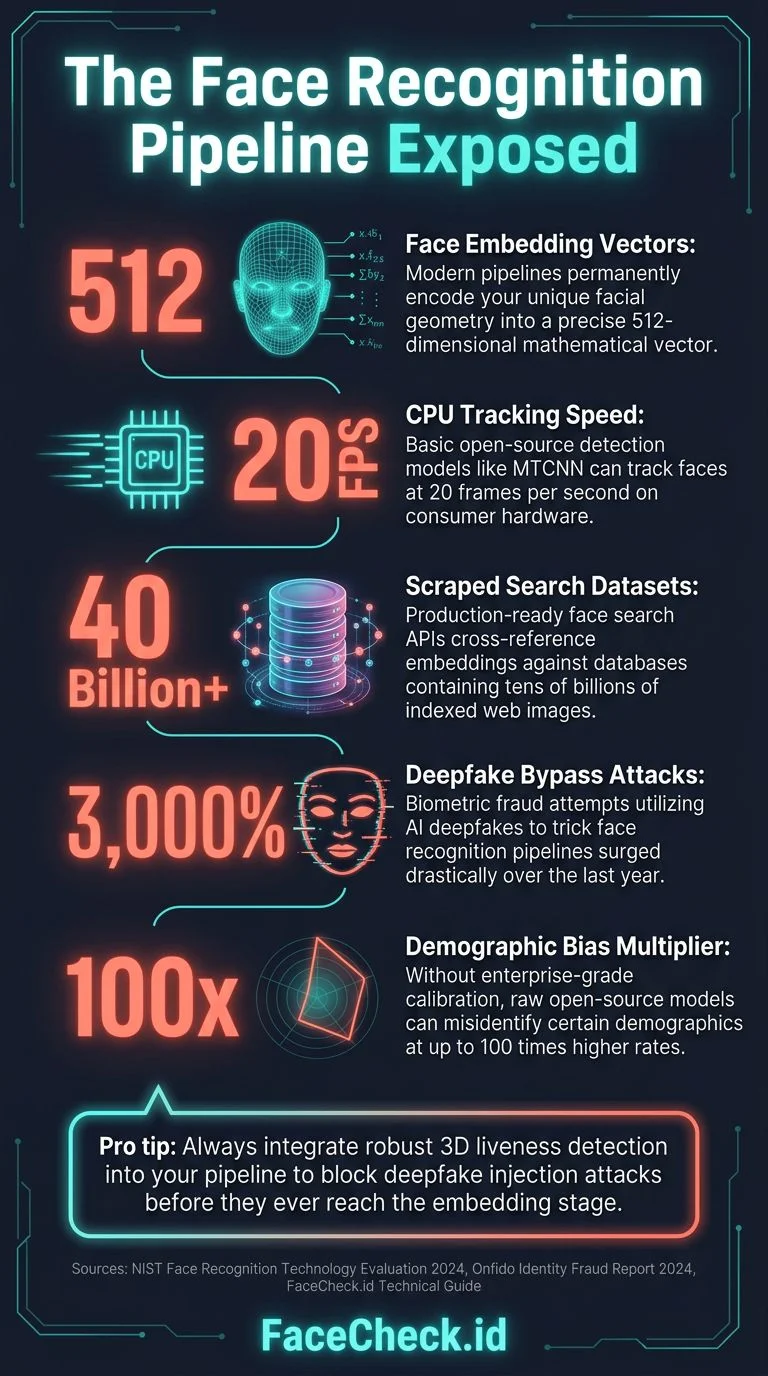
إذا كنت تطوّر أي شيء يحتاج إلى مطابقة الوجوه، أو التحقق من الهويات باستخدام الصور، أو البحث عن وجه ضمن مجموعة بيانات، فعليك فهم كيفية عمل تقنيات التعرّف الحديثة على الوجوه فعليًا من الداخل. لا النسخة التسويقية، بل المسار الحقيقي، بدءًا من وحدات البكسل الخام وصولًا إلى متجه تضمين ذي 512 بُعدًا يرمّز الهندسة الوجهية الفريدة للشخص.
تفصّل هذه المقالة مسار التعرّف على الوجوه كاملًا، وتقارن أفضل النماذج مفتوحة المصدر المتاحة في عام 2026، وتعرض أرقام الأداء الفعلية، وتشرح متى يكون من المنطقي بناء نظامك الخاص بدلًا من استخدام واجهة API جاهزة للإنتاج.
في هذا المقال، سنناقش
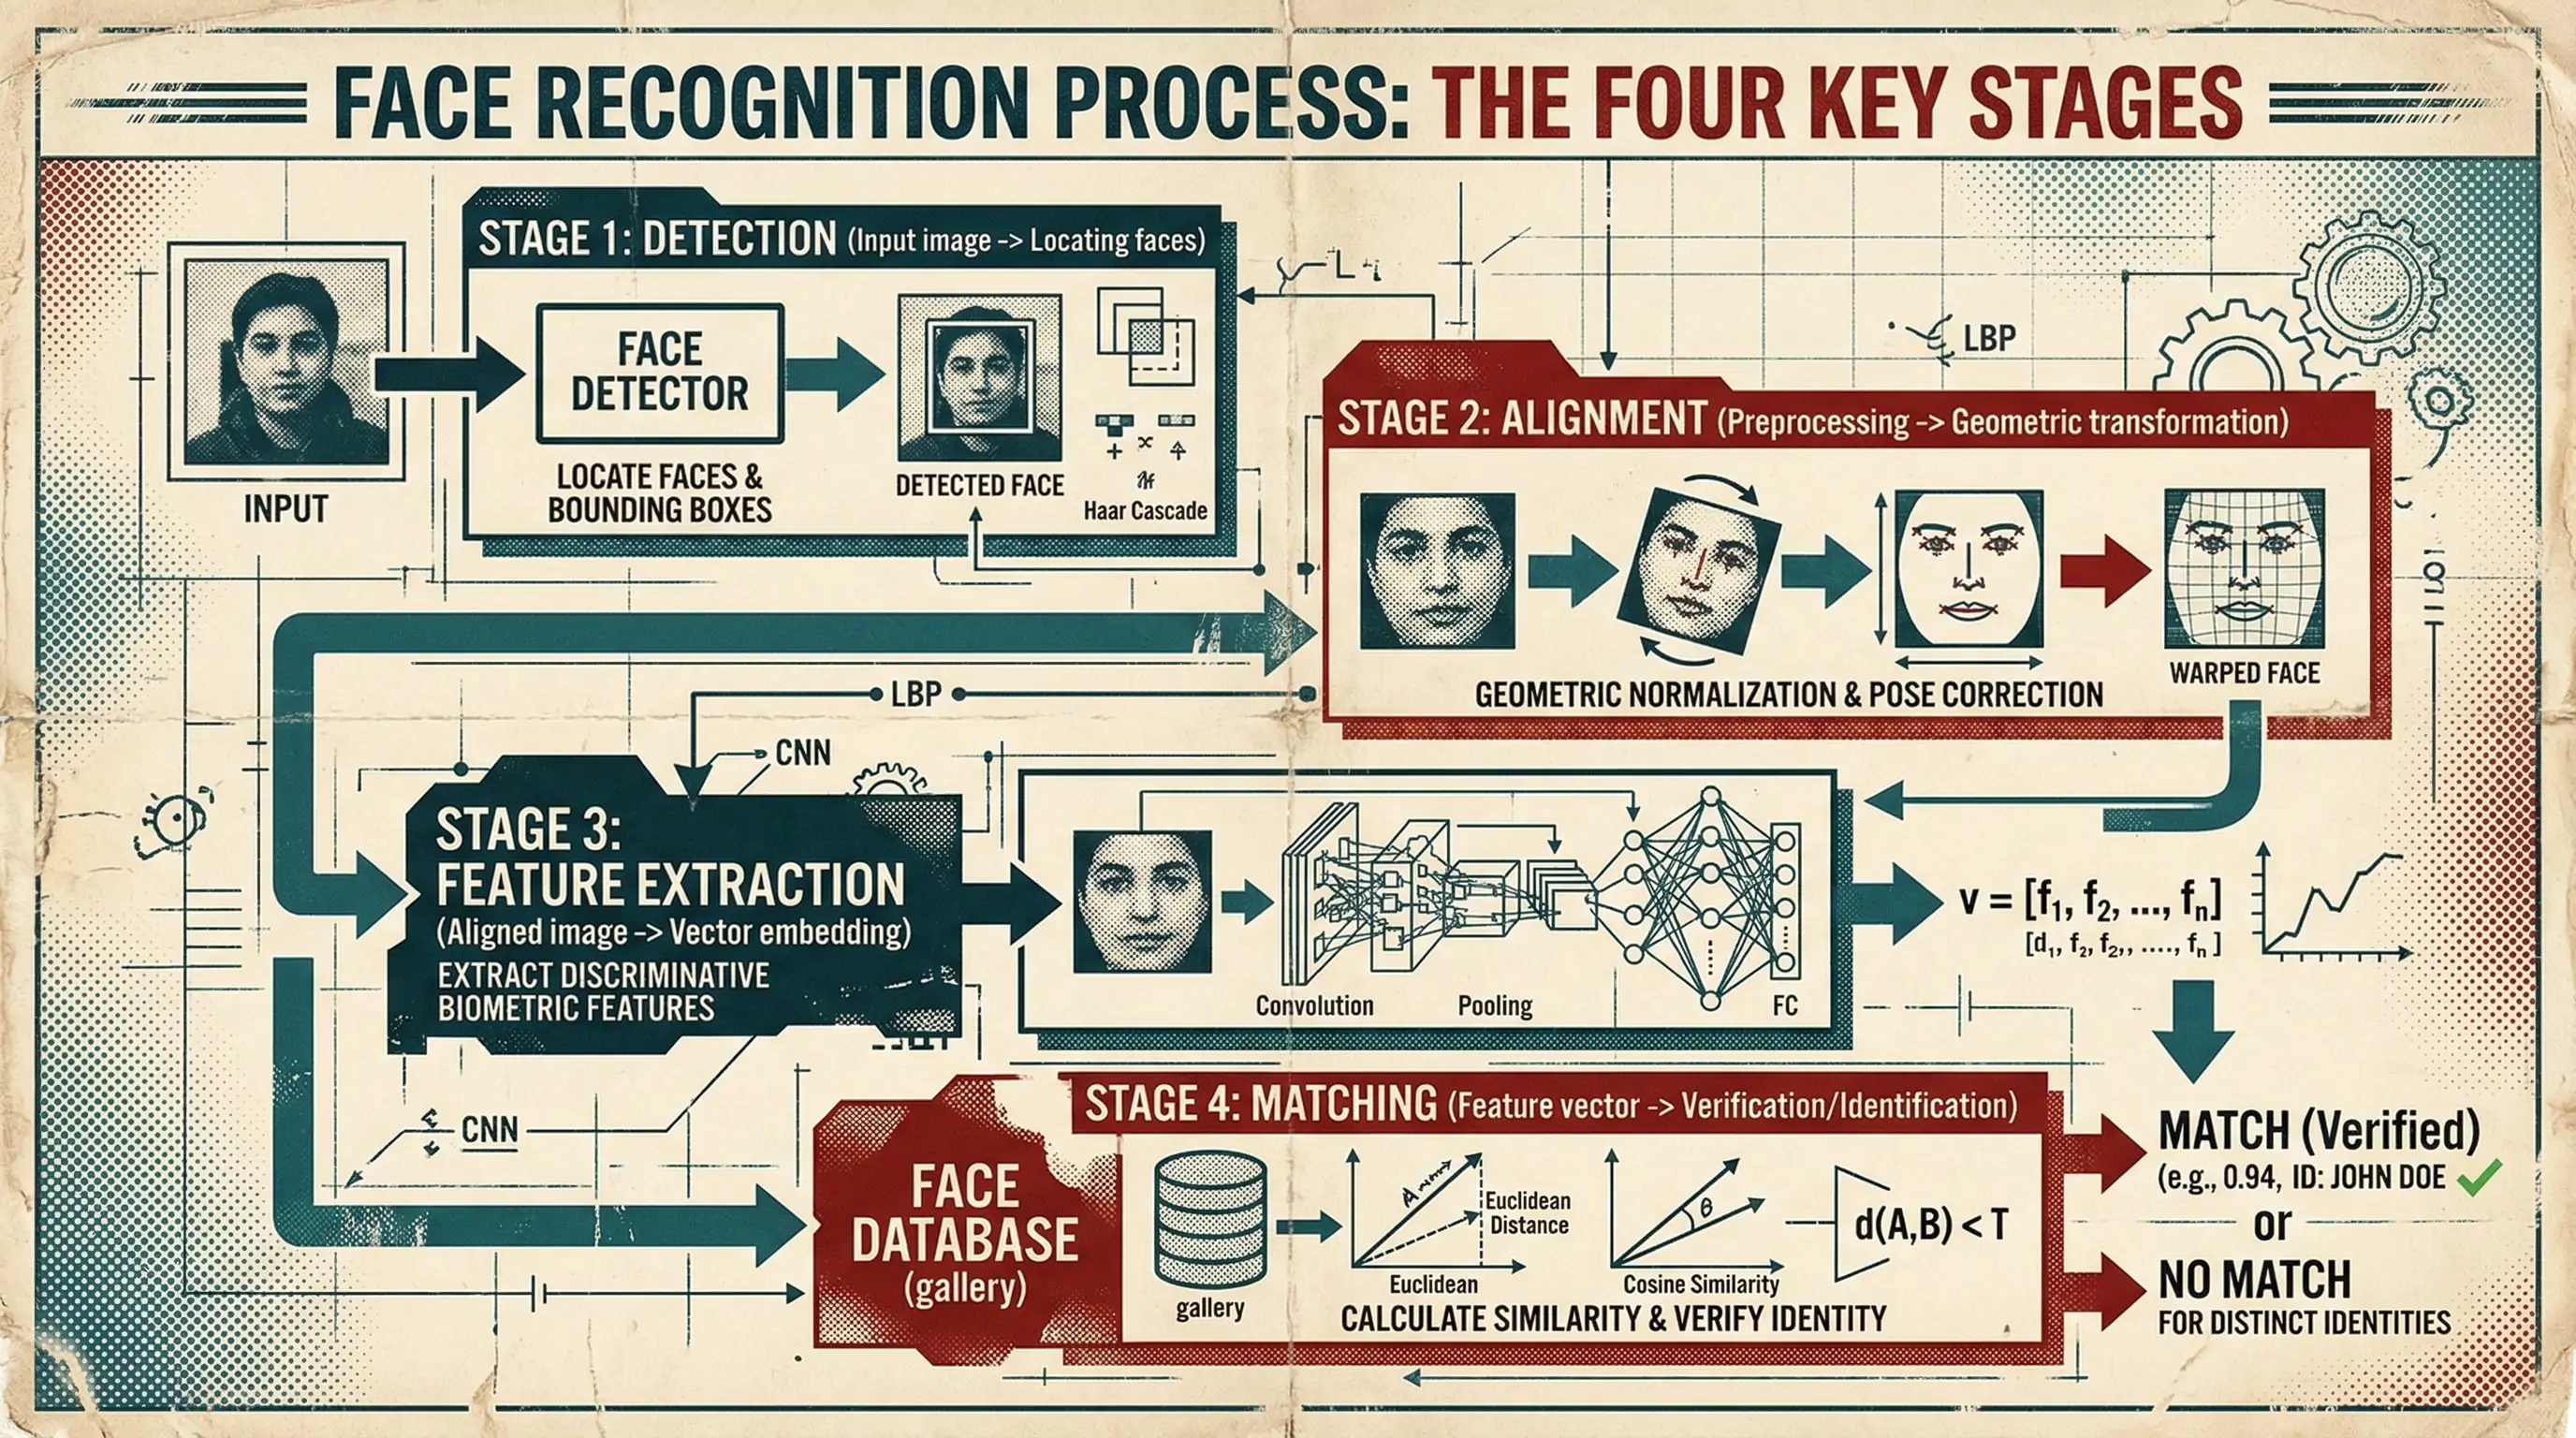
مسار التعرّف على الوجوه: أربع مراحل
يتبع كل نظام حديث للتعرّف على الوجوه المسار الأساسي نفسه، سواء أكان يعمل على جهاز Raspberry Pi بسعر 35 دولارًا أم على عنقود من وحدات معالجة الرسومات لدى جهة حكومية. سيساعدك فهم هذه المراحل الأربع على تقييم أي نموذج أو واجهة API.
المرحلة 1: كشف الوجوه
قبل أن تتمكن من التعرّف على وجه، عليك العثور عليه. يأخذ كشف الوجوه صورةً ويُخرج مربعات إحاطة حول كل وجه موجود فيها. يبدو ذلك بسيطًا، لكنه المرحلة التي تفشل عندها أنظمة كثيرة في بيئات الإنتاج.
النماذج القياسية:
- MTCNN (الشبكات الالتفافية المتتالية متعددة المهام): النموذج العملي الأساسي لكشف الوجوه منذ عام 2016. يتألف من سلسلة ثلاثية المراحل: تعثر شبكة الاقتراح (P-Net) على المناطق المرشحة، وترشّح شبكة التنقيح (R-Net) النتائج الإيجابية الكاذبة، ثم تنقّح شبكة الإخراج (O-Net) مربعات الإحاطة وتُخرج معالم الوجه. ولا يزال واسع الاستخدام. إنه دقيق مع الوجوه الأمامية، لكنه يواجه صعوبة مع الزوايا الحادة وحالات الحجب. يعمل بسرعة تقارب 20 إطارًا في الثانية على وحدة معالجة مركزية حديثة.
- RetinaFace: أحدث ما توصلت إليه التقنية من حيث دقة الكشف. كاشف أحادي المرحلة مبني على بنية أساسية من نوع [شبكة هرم الميزات](https://arxiv.org/abs/1612.03144). يعيد مربعات الإحاطة إلى جانب خمسة معالم وجهية، وهي العينان والأنف وزاويتا الفم. ويتعامل جيدًا مع المقاييس المتعددة. إنه الخيار المفضل إذا كانت الدقة أهم من السرعة. يعمل بسرعة تقارب 15 إطارًا في الثانية على وحدة معالجة الرسومات، ويكون أبطأ على وحدة المعالجة المركزية.
- SCRFD (إعادة توزيع العينات والعمليات الحسابية لكشف الوجوه بكفاءة): بطل السرعة. صُمم للنشر على الأجهزة المحمولة وأجهزة الحافة. ويحقق دقة بمستوى RetinaFace بسرعة أكبر من 3 إلى 10 مرات. تتوافر منه أحجام نماذج متعددة تتراوح بين 0.5 مليون و34 مليون معلَمة. إذا كنت تنشر على الأجهزة المحمولة أو تحتاج إلى معالجة فورية، فهذا هو الخيار الذي تريده.
- BlazeFace: مساهمة Google المصممة من أجل [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). سريع للغاية، إذ يعمل بأكثر من 200 إطار في الثانية على وحدات معالجة الرسومات المحمولة، لكنه يضحي ببعض الدقة عند الزوايا الصعبة. وهو مناسب لتطبيقات الفيديو الفورية التي تحتاج فيها إلى معالجة كل إطار.
ما يهم فعلًا في الكشف: الحالات الصعبة ليست صور السيلفي ذات الإضاءة الجيدة، بل لقطات المراقبة، والصور الجماعية التي لا يتجاوز عرض الوجوه فيها 50 بكسل، والملامح الجانبية الحادة، والوجوه المحجوبة جزئيًا بالنظارات الشمسية أو الأقنعة. يحدد نموذج الكشف الحد الأقصى لأداء نظامك بأكمله. فإذا أخفق الكشف في العثور على وجه، فلن تتمكن أي مرحلة لاحقة من إصلاح ذلك.
مشكلة تعدد الوجوه: عندما تحتوي صورة على عدة وجوه، عليك تحديد الوجه الذي ستنشئ له تضمينًا. تشمل الاستراتيجيات اختيار أكبر وجه، أو الوجه الأقرب إلى المركز، أو الوجه الحاصل على أعلى درجة جودة، أو تضمينها جميعًا وترك المنطق اللاحق يفرزها. ولكل خيار أنماط فشل مختلفة. يؤدي تضمين جميع الوجوه في الصور الجماعية إلى تضخم الفهرس وظهور نتائج بحث ملتبسة، بينما يؤدي اختيار أكبر وجه فقط إلى تفويت الشخص الواقف في الصف الخلفي. تُضمّن معظم أنظمة الإنتاج جميع الوجوه المكتشفة التي تتجاوز حدًا أدنى للحجم، يتراوح عادةً بين 40 و60 بكسل بين العينين، وتربطها كسجلات منفصلة مرتبطة بالصورة المصدر نفسها.
تقييم جودة الوجه بوصفه حارس بوابة: يؤدي تشغيل مقدّر جودة خفيف مثل SER-FIQ أو فرع الجودة من MagFace قبل حساب التضمينات المكلفة إلى منع البيانات الرديئة من دخول فهرسك أصلًا. فالقصاصات الضبابية، وحالات الحجب الشديد، والوجوه مفرطة التعريض تنتج جميعها تضمينات منخفضة الثقة تفسد نتائج البحث. ويؤدي رفض الوجوه الواقعة دون حد جودة معيّن في مرحلة الكشف إلى تحسين الدقة اللاحقة بصورة كبيرة وتوفير دورات وحدات معالجة الرسومات. وهذا أحد التحسينات الأعلى عائدًا على الاستثمار في المسار بأكمله.
مكافحة انتحال الوجه لأغراض التحقق: في سيناريوهات التحقق، يُعد كشف هجمات العرض التقديمي (PAD) أمرًا بالغ الأهمية. فقد تخدع المطبوعات الورقية، وإعادات العرض على الشاشات، والأقنعة ثلاثية الأبعاد الأنظمة المعتمدة على التضمينات. تكتشف نماذج مثل CDCN أو PatchNet هذه الهجمات، لكنها تضيف زمن استجابة يتراوح بين 5 و15 مللي ثانية لكل وجه وتتطلب صيانة إضافية للنموذج. إذا كنت تبني أي نظام يتحكم المستخدم في صورة إدخاله، مثل التحكم في الوصول أو إجراءات «اعرف عميلك» أو المصادقة، فعليك تضمين مكافحة الانتحال وإلا فسيجري استغلال نظامك.
المرحلة 2: محاذاة الوجه
بعد اكتشاف الوجه، عليك تطبيعه. فتغيّر وضعيات الرأس وزوايا الكاميرا والمسافات جميعها مظهر الوجه في الصورة الخام. وتحول المحاذاة كل وجه مكتشف إلى وضع قياسي: عينان على مستوى واحد، ووجه في المنتصف، ومقياس ثابت.
يستخدم النهج القياسي المعالم الخمسة الناتجة عن الكشف، وهي العين اليسرى والعين اليمنى وطرف الأنف وزاوية الفم اليسرى وزاوية الفم اليمنى، لحساب تحويل تشابه. ويعيّن هذا التحويل الوجه المكتشف إلى قصاصة معيارية بحجم 160×160 بكسل، مع وضع العينين عند إحداثيات بكسل ثابتة.
غالبًا ما تُهمَل هذه الخطوة في الشروحات، لكنها بالغة الأهمية. فقد يؤدي خطأ دوران بمقدار درجتين في المحاذاة إلى خفض دقة التعرّف بنسبة تتراوح بين 1% و3%. تتعامل معظم المسارات مفتوحة المصدر مع ذلك تلقائيًا، لكن إذا كنت تبني نظامًا مخصصًا، فاستخدم مواصفات محاذاة FaceNet، أي 160×160 وإحداثيات محددة للعينين، معيارًا لك. فهذا هو المعيار الذي دُرّبت عليه معظم النماذج الحديثة.
حساسية المحاذاة لدقة المعالم: يبلغ متوسط خطأ معالم RetinaFace نحو بكسلين. وينتقل هذا الخطأ عبر تحويل المحاذاة وقد يتسبب في تراجع الدقة بنسبة تتراوح بين 1% و5%، ولا سيما في قصاصات الوجوه الأصغر التي يمثل فيها بكسلان نسبة أكبر من العرض الكلي للوجه. تُشغّل بعض أنظمة الإنتاج مرحلة تنقيح ثانوية للمعالم تتضمن 68 أو 98 نقطة، مثل face-alignment من Adrian Bulat، بعد الكشف الأولي للحصول على محاذاة أدق. وتستحق الزيادة البالغة من 3 إلى 5 مللي ثوانٍ لكل وجه كلفتها عندما تتطلب حالة استخدامك أقصى قدر من الدقة، وخصوصًا في التحقق بنسبة 1:1 حيث تترتب عواقب على قرار خاطئ واحد.
المرحلة 3: استخراج الميزات (التضمين)
هذه هي نواة التعرّف على الوجوه. تأخذ شبكة عصبية عميقة صورة الوجه المحاذاة وتُخرج متجهًا ثابت الطول، يتكون عادةً من 512 بُعدًا، يُسمى التضمين أو متجه الميزات. وهذا المتجه تمثيل عددي مضغوط للخصائص الفريدة لذلك الوجه.
ينبغي لوجهين يعودان إلى الشخص نفسه، بصرف النظر عن الإضاءة أو التعبير أو العمر ضمن الحدود المعقولة أو الكاميرا، أن ينتجا تضمينين متقاربين في فضاء المتجهات. أما وجهان لشخصين مختلفين فينبغي أن ينتجا تضمينين متباعدين.
كيف يعمل ذلك تقنيًا:
تكون بنية الشبكة عادةً نسخة معدّلة من Inception-ResNet أو ResNet، مدرّبة على ملايين صور الوجوه. ويكمن الابتكار الأساسي في دالة الخسارة المستخدمة أثناء التدريب، لا في البنية نفسها.
- خسارة Softmax (خط الأساس): تتعامل مع التعرّف على الوجوه بوصفه تصنيفًا. تعمل، لكنها تنتج تضمينات غير مفصولة جيدًا في الفضاء الزاوي. وقد أصبحت متقادمة إلى حد كبير في مجال التعرّف.
- خسارة الثلاثيات: النهج الذي أشاعه FaceNet. تتعلم الشبكة من خلال مقارنة ثلاثيات وجه مرجعي/إيجابي/سلبي، فتدفع تضمينات الهوية نفسها إلى التقارب وتضمينات الهويات المختلفة إلى التباعد. وتتطلب تنقيبًا دقيقًا عن الثلاثيات الصعبة أثناء التدريب. وتنتج تضمينات عالية القدرة على التمييز.
- خسارة ArcFace: يمكن القول إنها دالة الخسارة الأوسع استخدامًا في أنظمة التعرّف على الوجوه الإنتاجية حتى عام 2026. فهي تضيف عقوبة هامش زاوي جمعي في الفضاء الزاوي بين متجه الميزات ووزن الفئة المقابل له، ما ينتج تجميعًا أكثر إحكامًا داخل الفئة وفجوات أوسع بين الفئات مقارنةً بنهج هامش جيب التمام. يوفر مشروع [InsightFace](https://github.com/deepinsight/insightface) التنفيذ المرجعي، وتُدرّب معظم النماذج الأحدث باستخدام ArcFace أو أحد متغيراته، فهامش AdaFace التكيفي مثلًا مبني فوق صياغة ArcFace. إذا كنت تدرّب نموذجك الخاص للتعرّف على الوجوه أو تضبطه ضبطًا دقيقًا، فإن ArcFace هي نقطة البداية الافتراضية.
- خسارة CosFace: تضيف هامش جيب تمام إلى خسارة softmax، ما يجبر الشبكة على إنتاج تضمينات أكثر إحكامًا داخل كل هوية وأكثر انفصالًا بين الهويات.
- SphereFace / A-Softmax: نهج الهامش الزاوي الأصلي من عام 2017. وهو مهم تاريخيًا، لكن ArcFace ودوال الخسارة الأحدث حلت محله إلى حد كبير.
المخرَج: متجه من 512 عددًا عشريًا، مطبّع وفق L2 إلى كرة الوحدة فائقة الأبعاد. تُضغط جميع المعلومات المتعلقة بالوجه في 2 كيلوبايت من البيانات. وهذا ما يجري تخزينه وفهرسته ومقارنته.
فخ التطبيع: ينسى كثير من المطورين وجوب تطبيع التضمينات وفق L2 قبل المقارنة. وتنتج التضمينات غير المطبّعة درجات تشابه شديدة التباين. وهذا خطأ شائع يصعب تشخيصه لأنه «يعمل في أغلب الأحيان»؛ فقد يبدو الترتيب النسبي للمطابقات صحيحًا في الاختبارات، لكن درجات التشابه المطلقة تنحرف بين الصور، ما يجعل القرارات القائمة على الحدود غير موثوقة. ينتج FaceNet512 تضمينات مطبّعة افتراضيًا، لكن إذا كنت تستخدم نموذجًا مخصصًا أو تصدّر عبر ONNX، فتحقق دائمًا من أن تضمينات المخرجات تقع على كرة الوحدة فائقة الأبعاد، أي إن معيار L2 لها يساوي 1.0.
النشر الإنتاجي: ONNX Runtime والتكميم: تفترض أرقام السرعة في الاختبارات المرجعية استدلال FP32 على وحدة معالجة رسومات خالية من الأحمال. وفي الإنتاج، تُنشر معظم الأنظمة عبر ONNX Runtime باستخدام تكميم INT8، ما يقلص زمن الاستدلال بمقدار مرتين إلى 3 مرات مع خسارة طفيفة جدًا في الدقة، عادةً أقل من 0.1% على LFW. سير العمل هو: تصدير نموذج PyTorch أو TensorFlow إلى ONNX، ثم تشغيل أداة التكميم في ONNX Runtime باستخدام مجموعة معايرة تضم نحو 1000 صورة وجه، ونشر النموذج المكمّم. وبهذا تنتقل من «10 مللي ثوانٍ لكل وجه» إلى «3-4 مللي ثوانٍ لكل وجه» على العتاد نفسه، وهو أمر بالغ الأهمية عند معالجة مليارات الصور.
الاستدلال مختلط الدقة: يؤدي استخدام FP16 على وحدة معالجة الرسومات للبنية الأساسية مع إبقاء FP32 لطبقة التضمين النهائية إلى تجنب مشكلات دقة الفاصلة العائمة المذكورة لاحقًا في هذه المقالة، مع تحقيق تسريع يتراوح بين 1.5 ومرتين. وهذا حل وسط عملي بين FP32 الكامل، الدقيق لكنه بطيء، وFP16 الكامل، السريع لكنه قد ينتج تضمينات مختلفة قليلًا على عتاد مختلف.
تقطير التضمينات للنشر على الحافة: يمكنك تدريب شبكة طالبة أصغر، مثل MobileFaceNet ذات نحو مليون معلَمة، لتقليد تضمينات FaceNet512 عبر تقطير المعرفة. يحقق النموذج الطالب أكثر من 95% من الدقة بسرعة تفوقه 10 مرات، ما يجعله مناسبًا للنشر المحمول وعلى الحافة حيث لا يمكنك تحمّل تكلفة وحدة معالجة رسومات. وتتمثل الفكرة الأساسية في أنك لا تحتاج إلى تدريب الطالب من الصفر باستخدام تسميات هويات الوجوه، بل تدربه على إعادة إنتاج تضمينات المعلّم باستخدام بيانات وجوه غير موسومة، ما يتطلب قدرة حوسبة أقل بكثير ولا يحتاج إلى مجموعة بيانات موسومة بالهويات.
المرحلة 4: المطابقة
إذا كان لديك تضمينان لوجهين، فكيف تقرر إن كانا يعودان إلى الشخص نفسه؟ هناك نهجان:
تشابه جيب التمام: احسب جيب تمام الزاوية بين متجهي التضمين. يتراوح الناتج بين -1 و1، حيث يعني 1 التطابق التام. ويتراوح الحد المعتاد لاعتبار الوجهين «للشخص نفسه» بين 0.4 و0.6 حسب نموذجك وحالة الاستخدام. وهو نهج بسيط وسريع ويعمل جيدًا لأن تضمينات FaceNet512 مطبّعة وفق L2.
المسافة الإقليدية: احسب مسافة L2 بين المتجهات. وبالنسبة إلى التضمينات المطبّعة، يعادل ذلك رياضيًا تشابه جيب التمام (d = sqrt(2 - 2*cos_sim)). وتفضّل بعض الأنظمة هذه الصياغة.
للبحث، أي المطابقة 1:N: عندما تحتاج إلى العثور على وجه في قاعدة بيانات تضم الملايين، تكون المقارنة بالقوة الغاشمة بطيئة جدًا. استخدم بحث أقرب الجيران التقريبي (ANN):
- FAISS (بحث التشابه من Facebook AI): المكتبة القياسية. تدعم تسريع وحدة معالجة الرسومات وأنواعًا متعددة من الفهارس، مثل IVF وHNSW وPQ. ويمكنها البحث في مليار متجه خلال مللي ثوانٍ. وهي مجانية ومفتوحة المصدر.
- Milvus: قاعدة بيانات متجهية مصممة لهذا الغرض، تستخدم FAISS داخليًا وتضيف الاستمرارية والتوسع وطبقات API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): خيارات مُدارة لقواعد البيانات المتجهية إذا كنت لا تريد تشغيل البنية التحتية بنفسك.
بالنسبة إلى قاعدة بيانات تضم 10 ملايين وجه، يمكن لفهرس HNSW مضبوط جيدًا في FAISS على وحدة معالجة رسومات واحدة إعادة أفضل 10 مطابقات في أقل من 5 مللي ثوانٍ.
اختيار نوع فهرس FAISS مهم للغاية. يوفر IVF-PQ ضغطًا ممتازًا، إذ يحتاج إلى 8-16 بايت لكل متجه بدلًا من 2 كيلوبايت، لكنه يفقد الدقة في المطابقات الحدّية التي يدفع فيها خطأ التكميم المطابقة الصحيحة إلى ما دون الحد. يحافظ HNSW على الدقة، لكنه يستخدم ذاكرة أكبر من 4 إلى 8 مرات لأنه يخزن متجهات الفاصلة العائمة كاملةً إلى جانب بنية الرسم البياني. وتوفر فهارس IVF-HNSW الهجينة أفضل توازن للأحجام من 10 ملايين إلى مليار. تختار معظم الفرق في البداية نوع الفهرس الخطأ اعتمادًا على توصيات الشروحات، ثم تضطر إلى إعادة بناء بنية الفهرسة بأكملها بعد 6 أشهر عندما تصطدم بالقيود. اختبر عبء عملك المحدد بأحجام بيانات وأنماط استعلام واقعية قبل الالتزام بنوع فهرس.
مشكلة البداية الباردة لفهارس ANN: تحتاج فهارس HNSW وIVF إلى حد أدنى من المتجهات كي تعمل جيدًا. وعند وجود أقل من نحو 10 آلاف متجه، يكون البحث بالقوة الغاشمة أسرع فعليًا من البحث المفهرس، لأن أعباء الفهرس الإضافية، مثل اجتياز الرسم البياني ومقارنة المراكز، تهيمن على العمليات الحسابية. ابدأ بالقوة الغاشمة، أي FAISS IndexFlatIP، خلال مرحلة النمو المبكرة، وانتقل إلى فهرس ANN عندما تتجاوز قاعدة بياناتك 50-100 ألف متجه.
الترشيح المسبق بالرموز الثنائية: يتيح حساب تجزئة ثنائية لكل تضمين، عبر الثنائية أو SimHash، إجراء ترشيح مسبق رخيص باستخدام مسافة Hamming قبل مقارنات الفاصلة العائمة المكلفة. ويمكن أن يقلص ذلك مجموعة المرشحين بأكثر من 90% مع خسارة ضئيلة في الاستدعاء. والفكرة هي تخزين رمز ثنائي من 256 أو 512 بتًا إلى جانب كل تضمين كامل. بالنسبة إلى استعلام ما، احسب أولًا مسافة Hamming إلى جميع الرموز الثنائية، وهي عملية شديدة السرعة باستخدام تعليمات POPCNT في وحدة المعالجة المركزية، ثم خذ أعلى 1-5% من المرشحين واحسب تشابه جيب التمام الدقيق لهؤلاء فقط. يكون هذا النهج ثنائي المراحل فعالًا خصوصًا عندما تتجاوز مجموعة بياناتك ذاكرة وحدة معالجة الرسومات المتاحة.
إعادة الترتيب باستخدام سمات الوجه: يعيد بحث التضمينات الأولي مرشحين، ويمكن لمرحلة ثانية تستخدم السمات المقدّرة، مثل الفئة العمرية والجنس ولون البشرة وشعر الوجه، ترشيح المطابقات الكاذبة الواضحة. فإذا قُدّر وجه الاستعلام لامرأة تبلغ 25 عامًا وقُدّر المرشح لرجل يبلغ 60 عامًا، فهذه على الأرجح نتيجة إيجابية كاذبة بغض النظر عن درجة تشابه التضمين. ويمكن لهذا الاستدلال البسيط خفض النتائج الإيجابية الكاذبة بنسبة تتراوح بين 30% و50% بتكلفة حسابية ضئيلة، وهو من أكثر التقنيات إهمالًا في أنظمة البحث الإنتاجية عن الوجوه.
الاتساق الزمني في الفيديو: إذا كنت تطابق وجوهًا من فيديو بدلًا من صور ثابتة، فإن حساب متوسط التضمينات عبر عدة إطارات للوجه المتتبَّع نفسه يحسن الدقة بصورة كبيرة، وغالبًا بنسبة تتراوح بين 5% و10% في الاختبارات الصعبة. وتجميع التضمينات على مستوى المسار أفضل دون شك من المطابقة على مستوى الإطار. يتمثل النهج في استخدام متعقب وجوه، مثل SORT أو DeepSORT، لربط الاكتشافات عبر الإطارات، وحساب التضمينات لكل اكتشاف، وتجميعها في «تضمين مسار» واحد باستخدام متوسط مرجّح بالجودة، حيث يكون وزن الجودة هو درجة جودة الوجه الناتجة من مرحلة الكشف.
أفضل نماذج التعرّف على الوجوه مفتوحة المصدر (2026)
FaceNet512
المعيار الذهبي. FaceNet512 هو متغير التضمين ذي 512 بُعدًا من بنية FaceNet التابعة لـGoogle، ويوفر فضاء تضمين أكبر وأكثر قدرة على التمييز من الإصدار الأصلي ذي 128 بُعدًا.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- البنية: بنية أساسية من Inception-ResNet-v2 تنتج تضمينات ذات 512 بُعدًا
- الترخيص: MIT (متساهل ويسمح بالاستخدام التجاري)
- دقة LFW: 99.65%
- حجم التضمين: 512 بُعدًا
- يتضمن: يعمل مع مسارات الكشف القياسية، مثل MTCNN و[RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)، للتعرّف المتكامل من البداية إلى النهاية
- واجهة Python API: متاحة عبر مكتبة
deepfaceأو تطبيقات مستقلة
الحكم: إذا كنت تبني نظامًا للتعرّف على الوجوه في عام 2026، فإن FaceNet512 نقطة انطلاق قوية. فهو يقدم دقة ممتازة، وتضمينات ذات 512 بُعدًا لقدرة تمييز عالية، وترخيص MIT متساهلًا، ودعمًا واسعًا في المنظومة.
FaceNet (Google، الإصدار الأصلي ذو 128 بُعدًا)
النموذج الذي أشاع نهج التضمين في عام 2015. وقد قدّم التدريب بخسارة الثلاثيات، حيث تتعلم الشبكة من خلال مقارنة ثلاثيات الوجه المرجعي والإيجابي والسلبي.
- البحث الأصلي: "FaceNet: تضمين موحّد للتعرّف على الوجوه وتجميعها" (Schroff وآخرون، 2015)
- المستودع: تطبيقات متعددة، ويُعد davidsandberg/facenet إصدار TensorFlow الكلاسيكي
- الترخيص: MIT
- دقة LFW: 99.63% في الإصدار الأصلي، وحتى 99.75% مع التدريب الحديث
- حجم التضمين: 128 بُعدًا
- البنية: Inception-ResNet-v1 أو Inception-ResNet-v2
الحكم: مهم تاريخيًا ولا يزال يعمل جيدًا. تضمين 128 بُعدًا أكثر إحكامًا، لكنه أقل قدرة على التمييز قليلًا من متغير FaceNet512 ذي 512 بُعدًا. استخدمه إذا كنت تحتاج إلى مساحة أصغر للتضمينات أو تعمل في TensorFlow ضمن قيود الذاكرة.
DeepFace (Facebook/Meta)
يجب عدم الخلط بينه وبين مكتبة Python المسماة deepface بالأحرف الصغيرة. كان DeepFace من Meta، الصادر عام 2014، أحد أوائل مناهج التعلم العميق للتعرّف على الوجوه، وحقق دقة قريبة من البشر على LFW.
أما المشروع الأكثر صلة اليوم فهو مكتبة Python المسماة deepface من Serengil:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- المستودع: github.com/serengil/deepface
- الترخيص: MIT
- ما تفعله: مكتبة تغليف توفر واجهة API موحدة لعدة نماذج خلفية: FaceNet512 وFaceNet وVGG-Face وOpenFace وDeepID وDlib وSFace
- تتضمن: التحقق والبحث وتحليل سمات الوجه، مثل العمر والجنس والعرق والمشاعر
- سهولة الاستخدام: واجهة API شديدة البساطة
الحكم: أفضل خيار للنماذج الأولية والتجارب. تتيح لك واجهة API الموحدة التبديل بين النماذج بتغيير معلَمة واحدة. وفي الإنتاج، سترغب في استخدام FaceNet512 مباشرةً للحصول على أداء وتحكم أفضل.
dlib
مكتبة C++ ذات روابط Python، يتولى صيانتها Davis King. وتتضمن نموذجًا للتعرّف على الوجوه مدرّبًا على مجموعة بيانات من 3 ملايين صورة.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- المستودع: github.com/davisking/dlib
- الترخيص: Boost Software License (متساهل)
- دقة LFW: 99.38%
- حجم التضمين: 128 بُعدًا
- الكشف: قائم على HOG، وهو سريع وملائم لوحدة المعالجة المركزية، وقائم على CNN، وهو أكثر دقة
الحكم: تطبيق C++ بالغ المتانة ومختبر ميدانيًا، مع روابط Python جيدة. دقته أقل من FaceNet512، لكنه موثوق للغاية. وهو خيار جيد إذا كنت تعمل بلغة C++ أو تحتاج إلى حل خفيف من دون اعتماديات PyTorch/ONNX.
AdaFace
نموذج أحدث، صدر عام 2022، يعالج تحديدًا تفاوت جودة الصور. تُدرّب النماذج القياسية على صور عالية الجودة ويتراجع أداؤها مع المدخلات منخفضة الدقة أو الضبابية. يكيّف AdaFace عقوبة الهامش وفق جودة الصورة أثناء التدريب.
- المستودع: github.com/mk-minchul/AdaFace
- الترخيص: MIT
- الميزة الرئيسية: أداء متفوق مع الصور منخفضة الجودة، مثل صور المراقبة والكاميرات بعيدة المدى
- دقة LFW: 99.82%
- IJB-C TAR@FAR=1e-4: 97.39%، متفوقًا على معظم النماذج مفتوحة المصدر في الاختبارات الصعبة
الحكم: استخدمه عندما تكون صور الإدخال منخفضة الجودة. ففي المراقبة، وتحليل كاميرات الدوائر التلفزيونية المغلقة، وأي سيناريو لا يمكنك فيه التحكم في جودة الصورة، يقدم AdaFace نتائج أفضل بصورة قابلة للقياس من النماذج القياسية.
جدول مقارنة الأداء
| النموذج | LFW (%) | التضمين | السرعة (مللي ثانية/وجه) | الترخيص |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99.65 | 512 بُعدًا | نحو 10 مللي ثوانٍ (GPU) | MIT |
| FaceNet (IR-v1) | 99.63 | 128 بُعدًا | نحو 12 مللي ثانية (GPU) | MIT |
| AdaFace (R100) | 99.82 | 512 بُعدًا | نحو 9 مللي ثوانٍ (GPU) | MIT |
| dlib ResNet | 99.38 | 128 بُعدًا | نحو 25 مللي ثانية (CPU) | Boost |
| VGG-Face2 | 99.43 | 2048 بُعدًا | نحو 15 مللي ثانية (GPU) | CC BY-SA |
يُعد LFW، أي الوجوه الموسومة في البرية، الاختبار المرجعي القياسي، لكنه حُلّ فعليًا. فكل نموذج حديث يحقق أكثر من 99%. ويظهر التمايز الحقيقي في اختبارات أصعب مثل IJB-C، الذي يتضمن ظروفًا متنوعة، وTinyFace للصور منخفضة الدقة.
ملاحظة حول الاختبارات المرجعية مقارنةً بالواقع: تمثل أرقام السرعة هذه استدلال FP32 على وجه واحد مع وحدة معالجة رسومات جاهزة. وفي الإنتاج باستخدام تكميم INT8 في ONNX Runtime، توقّع سرعة أكبر من مرتين إلى 3 مرات. لكن تذكّر أيضًا أن المسار الكامل، أي الكشف والمحاذاة وتقييم الجودة والتضمين، يستغرق وقتًا أطول من استخراج التضمين وحده بمقدار 3 إلى 5 مرات. ويبلغ معدل المعالجة الواقعي من البداية إلى النهاية للمسار الكامل على وحدة معالجة رسومات A100 واحدة بين 200 و400 وجه في الثانية، لا الآلاف التي قد توحي بها اختبارات التضمين وحده.
الفجوة بين النماذج مفتوحة المصدر وأنظمة الإنتاج
إليك ما لا تخبرك به الشروحات: تشغيل نموذج للتعرّف على الوجوه في دفتر Jupyter هو الجزء السهل. أما بناء نظام إنتاج يعمل فعلًا على نطاق واسع، فيتطلب حل قائمة طويلة من المشكلات الهندسية التي لا يحلها أي نموذج نيابةً عنك. تقلل معظم الفرق بصورة كبيرة من تقدير التكلفة والجدول الزمني معًا. فما يبدو مشروعًا «لتوصيل النموذج فحسب» يتحول إلى جهد هندسي يمتد من 12 إلى 24 شهرًا، وقد يستهلك بسهولة ما بين 500 ألف وأكثر من مليوني دولار قبل أن يصبح جاهزًا للإنتاج، وذلك قبل التكاليف التشغيلية المستمرة.
فاتورة البنية التحتية
قدرة وحدات معالجة الرسومات لاستخراج التضمينات. تشغيل كشف الوجوه واستخراج التضمينات على مليارات الصور ليس أمرًا تنجزه على حاسوب محمول. تستطيع وحدة معالجة رسومات NVIDIA A100 واحدة معالجة نحو 200-400 وجه في الثانية عبر مسار كامل يتضمن الكشف والمحاذاة والتضمين. ولمعالجة مليار صورة ضمن إطار زمني معقول، لنقل أقل من أسبوع، تحتاج إلى عنقود من 40 إلى 80 وحدة معالجة رسومات تعمل باستمرار. وفق أسعار الحوسبة السحابية، تبلغ التكلفة بين 50 ألفًا و150 ألف دولار لكل دورة معالجة، وستحتاج إلى إعادة المعالجة كلما تحسن نموذجك أو تغير مسارك. أما شراء العتاد مباشرةً، فيعني إنفاق 300-800 ألف دولار على خوادم وحدات معالجة الرسومات، إضافةً إلى مساحة الرفوف والطاقة والتبريد وشخص يتولى صيانة كل ذلك.
التخزين واسع النطاق. يتطلب مليار تضمين وجه يتكون كل منها من 512 عددًا عشريًا، أي 2 كيلوبايت، نحو 2 تيرابايت من بيانات المتجهات وحدها. أضف الصور الأصلية والصور المصغرة والبيانات الوصفية وبنى الفهارس، وستصل إلى مئات التيرابايت أو بضعة بيتابايت من التخزين. تتراوح تكلفة تخزين NVMe عالي الأداء لِفهارسك المتجهية في السحابة بين 0.10 و0.25 دولار لكل غيغابايت شهريًا. ومع 50 تيرابايت من التخزين الساخن، تبلغ التكلفة بين 5 آلاف و12,500 دولار شهريًا لمجرد إبقاء النظام قيد التشغيل.
البنية التحتية للبحث المتجهي. يصل FAISS على جهاز واحد إلى حد أقصى يتراوح بين 100 و500 مليون متجه، حسب نوع الفهرس وذاكرة RAM المتاحة. بعد ذلك تحتاج إلى بحث موزع عبر عدة شظايا، مع موازنة للأحمال وتكرار لتحمل الأعطال وذاكرة RAM كافية لحفظ الفهارس. يتطلب نشر إنتاجي موزع باستخدام FAISS أو Milvus لأكثر من مليار متجه عادةً من 8 إلى 16 جهازًا عالي الذاكرة، بذاكرة RAM تبلغ 256 غيغابايت أو أكثر لكل جهاز، وبتكلفة تتراوح بين 15 ألفًا و40 ألف دولار شهريًا في الحوسبة السحابية.
الشبكة والنطاق الترددي. يعني زحف مليارات الصور تنزيل بيتابايتات من البيانات. ومع تكلفة نقل خارجي تتراوح بين 0.05 و0.09 دولار لكل غيغابايت لدى كبار مزودي الخدمات السحابية، قد يكلف نقل البيانات وحده عشرات الآلاف من الدولارات. وتحتاج أيضًا إلى شبكة داخلية عالية الإنتاجية بين برامج الزحف وعقد معالجة وحدات الرسومات وأنظمة التخزين الخلفية.
تقدير التكلفة الإجمالية للبنية التحتية لمحرك بحث وجوه على نطاق الويب: من 30 ألفًا إلى 80 ألف دولار شهريًا في تكاليف سحابية مستمرة، أو من 500 ألف إلى 1.5 مليون دولار للعتاد مقدمًا، إضافةً إلى 10-20 ألف دولار شهريًا للطاقة والنطاق الترددي والصيانة. وهذه تكلفة البنية التحتية فقط، قبل أن يكتب مهندس واحد سطرًا من شيفرة التطبيق.
الجدول الزمني الهندسي
بناء نظام إنتاجي للبحث عن الوجوه ليس مشروع هاكاثون. وفيما يلي جدول زمني واقعي لفريق من 3 إلى 5 مهندسين ذوي خبرة:
الأشهر 1-3: المسار الأساسي. تشغيل الكشف والمحاذاة واستخراج التضمينات بصورة موثوقة. وبناء الفهرس المتجهي الأساسي. والتعامل مع إدخال الصور من الملفات المحلية. هذا هو الجزء «الممتع» الذي يبدو فيه أن كل شيء يسير جيدًا ويظهر العرض التجريبي بصورة مبهرة.
الأشهر 3-6: البنية التحتية لزحف الويب. بناء أدوات استخراج للمنصات الكبرى. والتعامل مع تحديد المعدلات واختبارات CAPTCHA وجدران تسجيل الدخول والعرض الديناميكي للمواقع كثيفة JavaScript وإزالة تكرار الصور وترشيح المحتوى. ثم اكتشاف أن كل منصة تواصل اجتماعي تستخدم تدابير مختلفة لمكافحة الاستخراج تكسر برامج الزحف أسبوعيًا. وبناء مراقبة لاكتشاف فشل برامج الزحف بصمت. قد تستغرق هذه المرحلة وحدها وقتًا أطول من المتوقع، لأن الويب فوضوي وعدائي.
الأشهر 6-9: التوسع والموثوقية. نجح نموذجك الأولي على مليون وجه. اجعله الآن يعمل على 100 مليون. ستكتشف أن فهرس FAISS لم يعد يتسع في ذاكرة RAM. طبّق التجزئة. أصلح حالات التسابق في مسار الإدخال. ابنِ منطق إعادة المحاولة لنسبة 15% من الصور التي يفشل تنزيلها. تعامل مع الصور التالفة، والصور التي تزعم أنها JPEG وليست كذلك، والصور ذات علامات تدوير EXIF، والتنزيلات المبتورة. أضف المراقبة والتنبيهات والسجلات حتى تعرف متى تتعطل الأمور عند الساعة الثالثة صباحًا.
الأشهر 9-12: الجودة والدقة. ستدرك أن معدل النتائج الإيجابية الكاذبة لديك على نطاق واسع غير مقبول. طبّق تقييم جودة الوجه لترشيح التضمينات الرديئة. اضبط الحدود لكل حالة استخدام. ابنِ آلية ملاحظات حتى يمكن الإبلاغ عن المطابقات السيئة والتحقيق فيها. ستكتشف أن نموذجك ينتج نتائج مختلفة على بُنى مختلفة لوحدات معالجة الرسومات بسبب اختلافات دقة الفاصلة العائمة، وستقضي أسبوعين في تعقب السبب.
الأشهر 12-18: تعزيز الجاهزية للإنتاج. ابنِ طبقة API مزودة بالمصادقة وتحديد المعدلات وتتبع الاستخدام. أضف ميزات الامتثال لـGDPR/CCPA، مثل آليات الانسحاب وطلبات حذف البيانات وسجلات التدقيق. طبّق التخزين المؤقت للنتائج. ابنِ أدوات الإدارة. اكتب الوثائق. تعامل مع التدقيق الأمني. اختبر كل شيء تحت الأحمال. وأصلح تسريبات الذاكرة التي لم تكن تعلم بوجودها.
الأشهر 18-24: العمليات المستمرة. تتعطل برامج الزحف عندما تغير المواقع تخطيطاتها. وتنحرف النماذج مع ظهور أنواع جديدة من الصور. وتمتلئ الأقراص. وتحتاج الفهارس إلى إعادة البناء. ويبلغ المستخدمون عن حالات طرفية لم تتوقعها قط. ويكتشف أحدهم أن نظامك يعيد مطابقات واثقة لوجوه كرتونية، فتحتاج إلى إضافة مرشح «وجه حقيقي». وهذا لا ينتهي أبدًا.
القائمة الكاملة للمشكلات التي ستواجهها
إضافةً إلى البنية التحتية والجدول الزمني، إليك كل مشكلة رئيسية تواجهها الفرق عند بناء أنظمة التعرّف على الوجوه من الصفر. تأتي هذه القائمة من أنظمة إنتاج حقيقية، لا من مخاوف نظرية.
كابوس جودة البيانات:
- مدخلات رديئة، مخرجات رديئة. الإنترنت مليء بالصور الساخرة، والوجوه المولدة بالذكاء الاصطناعي، والرسومات، وصور الصور، وأغلفة المجلات، والتماثيل. سيعثر الكاشف على «وجوه» في جميعها وينتج تضمينات تفسد فهرسك. تحتاج إلى مصنفات لترشيح الوجوه الاصطناعية والمرسومة والقصاصات شديدة الانخفاض في الدقة والمحتوى غير الفوتوغرافي. ويُعد بناء هذه المرشحات وصيانتها مشروعًا قائمًا بذاته.
- الصور المكررة وشبه المكررة. تظهر الصورة نفسها على عشرات المواقع بقصّات وعلامات مائية ومستويات ضغط وتعديلات لونية مختلفة. ومن دون إزالة التكرار، تنتج صورة رائجة واحدة مئات «المطابقات» التي تمثل جميعها الصورة نفسها، فتطمر النتائج الحقيقية. يساعد التجزئة الإدراكية، مثل pHash وdHash، لكنها ليست مثالية. تحتاج إلى إزالة التكرار على عدة مستويات: مستوى URL، وهو بسيط؛ والتجزئة الإدراكية، التي تلتقط النسخ المعاد تحجيمها وضغطها؛ ومستوى التضمين، الذي يلتقط الوجه نفسه المصوّر من زوايا مختلفة قليلًا. يلتقط كل مستوى أشياء تفوت المستويات الأخرى، وستقضي على إزالة التكرار وقتًا أطول مما تتوقع.
- تغيرات العمر والمظهر. قد لا يطابق تضمين وجه من صورة شخص في الجامعة صورته بعد 15 عامًا. فتغيرات الوزن والتقدم في العمر والجراحة التجميلية وشعر الوجه وتسريحات الشعر المختلفة تؤثر جميعها في دقة التعرّف. ولا يتعامل أي نموذج مع ذلك بصورة مثالية. وسيلوم المستخدمون نظامك عندما لا يطابق شخصًا عبر فجوة زمنية قدرها 20 عامًا.
- التحيز الديموغرافي. تؤدي النماذج مفتوحة المصدر المدرّبة أساسًا على مجموعات بيانات غربية أو قوقازية أداءً أسوأ مع الفئات السكانية الأخرى. وفجوات الدقة بين الأعراق أكبر مما يوحي به LFW، إذ إن نحو 77% من LFW قوقازيون. وعند النشر عالميًا، قد تتراوح فجوات الدقة بين المجموعات الديموغرافية من 5% إلى 15% في الاختبارات الصعبة. ترث نماذج مثل FaceNet512 المدرّبة على MS-Celeb-1M انحرافه الديموغرافي. ويُعد الضبط الدقيق باستخدام مجموعات بيانات متوازنة، مثل BUPT-Balancedface، أو استخدام استراتيجيات تدريب تراعي التركيبة السكانية أمرًا مهمًا لتحقيق أداء منصف. إذا لم تقيّم الدقة عبر المجموعات العرقية، فقد تطلق نظامًا يعمل جيدًا لبعض المستخدمين وسيئًا لآخرين. وهذه ليست مسألة أخلاقية فحسب، بل مسألة جودة منتج ومسؤولية قانونية أيضًا.
- التعامل مع اتجاه EXIF. تحتوي نحو 15-20% من الصور على الويب على علامات اتجاه EXIF، وإذا جرى تجاهلها ظهرت الوجوه جانبية أو مقلوبة. ولا تستطيع معظم كواشف الوجوه العثور على الوجوه المدورة. وهذا قاتل صامت للدقة يسهل تفويته في الاختبار، حيث تستخدم صورًا موجهة بصورة صحيحة، لكنه مدمر في الإنتاج. طبّق دائمًا تصحيح اتجاه EXIF بوصفه أول خطوة في مسار معالجة الصور.
- فشل فك ترميز JPEG التدريجي وWebP. تنتج بعض مكتبات الصور بصمت بيانات بكسل تالفة من ملفات JPEG التدريجية المنزلة جزئيًا أو ملفات WebP المبتورة. وقد يظل كاشف الوجوه قادرًا على العثور على «وجه» في آثار التلف وينتج تضمينًا رديئًا. تحتاج إلى التحقق من سلامة الصورة، عبر التأكد من أن الملف يُفك ترميزه بلا أخطاء وأن مخزن البكسل الناتج ذو أبعاد معقولة، قبل المعالجة. ومن دون ذلك، تفسد الصور التالفة فهرسك بصمت.
مشكلات هندسية لا تكون واضحة في البداية:
- إصدارات التضمينات. عندما ترقي نموذجك، وستفعل لأن تحسينات الدقة مهمة، تصبح كل تضمينات قاعدة بياناتك غير متوافقة مع مخرجات النموذج الجديد. وعليك إما إعادة تضمين قاعدة البيانات كلها، وهو أمر مكلف وبطيء ويتطلب الاحتفاظ بجميع الصور الأصلية؛ أو تشغيل فهارس متوازية أثناء الترحيل، ما يضاعف تكلفة البنية التحتية؛ أو الحفاظ على التوافق السابق، وهو معقد ويحد قدرتك على التحسين. لا يوجد حل جيد، بل حلول أقل إيلامًا فقط.
- حتمية الفاصلة العائمة. قد تنتج الصورة نفسها عند معالجتها على طرز مختلفة من وحدات معالجة الرسومات أو إصدارات مختلفة من CUDA أو حتى بأحجام دفعات مختلفة تضمينات مختلفة قليلًا بسبب حسابات الفاصلة العائمة. هذه الفروق صغيرة، من 1e-6 إلى 1e-4، لكنها تتراكم: فقد تحصل مطابقة على 0.401 في جهاز و0.399 في آخر، ما يقلب قرار حد ثنائي. وهذا سيدفعك إلى الجنون أثناء التصحيح. تمثل تحديثات برامج تشغيل وحدات معالجة الرسومات لغمًا خاصًا؛ إذ قد تغير تحديثات NVIDIA سلوك الفاصلة العائمة على مستوى CUDA. وقد يختلف تضمين محسوب على برنامج تشغيل 535.x عن الصورة نفسها على 545.x. وفي الإنتاج، يعني ذلك أنك تحتاج إلى تثبيت إصدارات برامج التشغيل عبر أسطولك كله والتحقق من اتساق التضمينات بعد أي تحديث.
- التزامن وحالات التسابق. برامج زحف متعددة تُدخل الوجوه في الوقت نفسه، ومستخدمون يستعلمون أثناء تحديث الفهرس، وطلبات حذف تصل أثناء تجميع نتائج البحث. لا تتمتع قواعد البيانات المتجهية بدعم معاملات ناضج مماثل لقواعد بيانات SQL. وستواجه سيناريوهات يجري فيها فهرسة وجه جزئيًا، أو تعيد الاستعلامات نتائج قديمة، أو لا ينتشر الحذف إلى جميع الشظايا.
- إدارة الذاكرة. تُعيَّن فهارس FAISS إلى الذاكرة، لكن أداء الاستعلام يعتمد بشدة على مقدار الفهرس الذي يتسع في ذاكرة RAM. ومع نمو الفهرس، يقفز زمن الاستعلام بصورة غير متوقعة عندما يطرد نظام التشغيل صفحات الفهرس من الذاكرة. وتحدث عمليات الإنهاء بسبب نفاد الذاكرة في أسوأ وقت ممكن. وستصبح شديد الإلمام بإدارة ذاكرة Linux وإعدادات مساحة التبديل وطوبولوجيا [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). كما يمثل الإحماء بعد البدء البارد صداعًا آخر: ففهارس FAISS HNSW معيّنة إلى الذاكرة، لذلك تكون أول بضع مئات من الاستعلامات بعد إعادة تشغيل الخادم أبطأ من 10 إلى 100 مرة، لأن صفحات الفهرس لم تُحمّل بعد في ذاكرة RAM. وتحتاج إلى مرحلة إحماء تحمّل الفهرس مسبقًا قبل قبول حركة الإنتاج، وإلا فسيواجه أول المستخدمين بعد النشر زمن استجابة سيئًا للغاية.
- الإخفاقات الصامتة. يتوقف برنامج زحف عن العمل لأن موقعًا غيّر HTML الخاص به. وتبدأ عقدة معالجة وحدة الرسومات بإنتاج تضمينات NaN بسبب تحديث برنامج تشغيل. ويمتلئ قرص فتتوقف فهرسة الوجوه الجديدة بصمت. لا تطلق هذه الإخفاقات أخطاء، بل تضعف نظامك بهدوء. ومن دون مراقبة شاملة واكتشاف للشذوذ، لن تعرف حتى يشتكي المستخدمون.
- مشكلة تحديث FAISS. عند إضافة تضمينات جديدة إلى فهرس IVF، تصبح خلايا Voronoi غير متوازنة. وتتراجع جودة البحث تدريجيًا حتى تعيد تدريب أداة التكميم. وعلى نطاق الويب، تعني إعادة التدريب ساعات من وقت وحدة معالجة الرسومات على مجموعة البيانات الكاملة. تجمع الفرق عادةً الإضافات في دفعات وتعيد التدريب أسبوعيًا أو شهريًا، ما يعني أن الوجوه المدخلة حديثًا لا تصبح قابلة للبحث فورًا بأقصى دقة. فأنت توازن دائمًا بين حداثة البيانات وجودة البحث، ولا يوجد حل مجاني.
- معايرة الدرجات عبر شظايا الفهرس. عندما يكون فهرسك مقسمًا إلى شظايا عبر عدة أجهزة، لا تكون درجات التشابه الخام من الشظايا المختلفة قابلة للمقارنة مباشرةً، لأن لكل شظية توزيع تضمينات مختلفًا. تحتاج إلى تطبيع الدرجات لكل شظية، مثل تطبيع المجموعة وZ-norm وT-norm، لدمج النتائج بصورة ذات معنى. ومن دون المعايرة، قد تمثل درجة 0.45 من الشظية A مطابقة قوية، بينما تمثل 0.45 من الشظية B مطابقة متوسطة. وعندها تصبح النتائج المدمجة غير موثوقة.
- مشكلة التوزيع الواسع في البحث الموزع. يعني البحث في N من الشظايا إجراء N رحلة ذهاب وإياب عبر الشبكة لكل استعلام. وإذا كانت أي شظية بطيئة، بسبب توقف جامع القمامة أو قفزة إدخال/إخراج القرص أو اضطراب الشبكة، يصبح الاستعلام كله بطيئًا. يحدد P99 لأبطأ شظية زمن استجابة P99، ويزداد سوءًا كلما أضفت مزيدًا من الشظايا. وتُعد تقنيات مثل الطلبات التحوطية، أي إرسال طلبات مكررة واستخدام أول نتيجة تصل، والمهل التكيفية ضرورية للحفاظ على زمن استجابة مقبول في الحالات الطرفية.
مشكلات الدقة والمطابقة:
- ضبط الحدود لا «ينتهي» أبدًا. يتغير حد التشابه الأمثل مع نمو قاعدة بياناتك. عند مليون وجه، يمنحك حد 0.45 توازنًا جيدًا بين الدقة والاستدعاء. وعند 100 مليون وجه، ينتج الحد نفسه نتائج إيجابية كاذبة أكثر بعشر مرات، لمجرد وجود عدد أكبر من الأشخاص المتشابهين شبه المطابقين. تحتاج إلى حدود تكيفية أو إعادة ترتيب بعد المعالجة. الرياضيات الأساسية لا ترحم: عندما تنمو قاعدة بياناتك من مليون إلى 100 مليون ثم إلى مليار وجه، يتحرك توزيع أعلى درجات التشابه نحو الأعلى بسبب زيادة عدد المتشابهين شبه المطابقين. وقد يعطي حد ثابت معدل نتائج إيجابية كاذبة يبلغ 0.1% عند مليون وجه، لكنه قد يعطي 10% عند مليار وجه. تحتاج إلى نمذجة هذا التوزيع وضبط الحدود ديناميكيًا، أو قبول تدهور دقتك مع التوسع.
- التعرّف ضمن مجموعة مفتوحة مقابل مجموعة مغلقة. تقيّم معظم الاختبارات أداء المجموعة المغلقة، حيث يكون وجود الشخص صاحب الاستعلام في قاعدة البيانات مضمونًا. أما البحث الواقعي عن الوجوه فهو مفتوح المجموعة: فقد لا يكون وجه الاستعلام موجودًا أصلًا في الفهرس. ويتطلب تقييم المجموعة المفتوحة مقاييس مختلفة تمامًا، مثل TPIR عند FPIR ثابت بدلًا من دقة المرتبة الأولى، ويكون نمط الفشل هو المطابقات الكاذبة بدلًا من الترتيبات الخاطئة. وقد يحقق نظام 99% في اختبارات المجموعة المغلقة، لكنه يسجل معدل مطابقة كاذبة يبلغ 10% عند النشر ضمن مجموعة مفتوحة، لأنه يعيد بثقة الوجه «الأقرب» حتى عندما لا توجد المطابقة الحقيقية. والتعامل الصحيح مع «لم يُعثر على مطابقة» مهم بقدر أهمية العثور على المطابقات الصحيحة.
- الأشباه والنسخ المتطابقة شكليًا. في قاعدة بيانات تضم أكثر من 100 مليون وجه، توجد أزواج كثيرة لأشخاص لا تربطهم صلة لكن تضميناتهم متقاربة بصورة مفاجئة. وكلما كبرت قاعدة بياناتك، زادت المطابقات الكاذبة. وسيبلغ المستخدمون بانتظام عن نتائج «الشخص الخطأ». تحتاج إلى استراتيجية للتعامل مع ذلك: التحقق بعدة صور، وإشارات سياقية مثل الاسم والموقع، وقوائم انتظار للمراجعة البشرية.
- لا يزال التعرّف المستقل عن وضعية الوجه صعبًا. حتى FaceNet512 يتراجع أداؤه بصورة كبيرة بعد زاوية انحراف تزيد أو تنقص عن 60 درجة. وقد تنخفض دقة مطابقة الوجه الجانبي بالوجه الأمامي بنسبة 10-20% مقارنةً بمطابقة وجهين أماميين. وفي سيناريوهات المراقبة، تكون معظم الوجوه مائلة، ما يعني أن دقتك الواقعية أقل كثيرًا مما توحي به الاختبارات. تساعد النماذج المدرّبة باستخدام تعزيز مدرك للأبعاد الثلاثية أو بُنى مثل UV-GAN، لكنها تضيف تعقيدًا. إذا كانت بيانات إدخالك مائلة الزوايا بكثرة، فاعتبر ذلك مصدر قلق رئيسيًا للدقة لا حالة طرفية.
- المدخلات العدائية. سيرسل المستخدمون وجوهًا مولدة بالذكاء الاصطناعي وتزييفات عميقة وصورًا ممزوجة وصورًا ذات تشويشات متعمدة. بعضهم يختبر نظامك، وبعضهم يحاول التلاعب بالنتائج. يحتاج نظامك إلى قدر من المتانة في مواجهة هذه المدخلات، وإلا فستعيد مطابقات واثقة لوجوه مزيفة.
- التلاعب بالصور. المرشحات وتطبيقات التجميل والمكياج الكثيف وبرامج تعديل الوجوه؛ واقع Instagram مقابل الواقع الفعلي. تغير هذه التعديلات هندسة الوجه بما يكفي للتأثير في تشابه التضمينات. وقد لا تتطابق صورة سيلفي شديدة الترشيح مع صورة الشخص نفسه غير المرشحة.
- وجه واحد، تضمينات كثيرة. قد يمتلك شخص واحد مئات الصور على الإنترنت عبر منصات وزوايا وسنوات مختلفة. هل تعيدها جميعًا كمطابقات منفصلة، أم تجمعها في هوية واحدة؟ التجميع على نطاق واسع، لمئات الملايين من الوجوه، مكلف حسابيًا ويقدم أنماط فشل خاصة به: الدمج الزائد، أي جمع شخصين مختلفين، والدمج الناقص، أي الإخفاق في ربط صور الشخص نفسه.
متاعب التشغيل:
- سباق التسلح ضد الاستخراج. تحظر كل منصات التواصل الاجتماعي الكبرى أدوات الاستخراج بنشاط. فهي تغير بنى الصفحات، وتضيف اختبارات CAPTCHA، وتكتشف المتصفحات عديمة الواجهة، وتحدد المعدلات وفق عنوان IP، وتبصم أنماط الطلبات، وأحيانًا تقدم محتوى طُعمًا. وتعيش بنية الزحف لديك في سباق تسلح مستمر. فقد تُحظر تمامًا أداة استخراج تعمل اليوم في الأسبوع المقبل. وصيانة برامج الزحف تكلفة هندسية مستمرة، لا عملية بناء لمرة واحدة.
- نمذجة معدل التغير. تتحدث المصادر المختلفة بمعدلات مختلفة. تحصل مواقع أخبار المشاهير على صور جديدة كل ساعة، بينما قد لا تتغير الملفات الشخصية على وسائل التواصل لسنوات. ويمكن لجدولة إعادة الزحف بذكاء وفق معدلات التغير التاريخية تقليل تكاليف النطاق الترددي بنسبة 60-80% مع إبقاء الفهرس أحدث في المواضع المهمة. ومن دون ذلك، إما أن تفرط في زحف المصادر الثابتة، فتهدر النطاق الترددي والمال، أو تقلل زحف المصادر الديناميكية، فتقدم نتائج قديمة.
- شبكات CDN وتفاوت المحتوى الجغرافي. قد يقدم عنوان URL نفسه صورًا مختلفة وفق موقع مقدم الطلب أو وكيل مستخدم الجهاز أو ملفات تعريف الارتباط. وقد يفهرس برنامج الزحف صورة مختلفة عما يراه المستخدم، ما يؤدي إلى تقارير مربكة من نوع «المطابقة لا تشبه النتيجة». وتقدم بعض شبكات CDN صورًا مؤقتة منخفضة الدقة حتى يمرر متصفح حقيقي الصورة إلى منطقة العرض. تحتاج إلى التعامل مع هذه الحالات الطرفية أو قبول نسبة من النتائج الوهمية.
- نمو تكاليف التخزين. ينمو تخزين الصور خطيًا ولا يتوقف. ولا يمكنك حذف النسخ الأصلية إذا كنت قد تحتاج إلى إعادة تضمينها. صور مصغرة وبيانات وصفية ومتجهات تضمين وملفات فهرس ونسخ احتياطية. تتسارع فاتورة التخزين مع نضج نظامك. وتُصدم الفرق التي وضعت ميزانية لتخزين السنة الأولى بتكاليف السنة الثالثة.
- طلبات الامتثال على نطاق واسع. يمنح GDPR الأفراد الحق في طلب حذف بياناتهم. وعندما يقدم شخص طلب انسحاب، عليك العثور على جميع التضمينات المولدة من وجهه عبر قاعدة بياناتك كلها، وحذفها، وضمان عدم إعادة إضافتها عندما تعثر برامج الزحف على الصور الأصلية مجددًا، وتوثيق الحذف لأغراض التدقيق. وعلى نطاق واسع، يتطلب ذلك أدوات وجهدًا هندسيًا مخصصين. ويضيف [قانون الذكاء الاصطناعي للاتحاد الأوروبي](https://artificialintelligenceact.eu/) متطلبات إضافية لأنظمة الذكاء الاصطناعي عالية المخاطر، ومنها التعرّف على الوجوه: تقييمات مطابقة إلزامية، واختبار التحيز، والتزامات الشفافية، وآليات الإشراف البشري.
- تنفيذ الانسحاب أصعب مما يبدو. لا يمكنك حذف تضمين فحسب؛ بل عليك منع إعادة الفهرسة عندما يصادف برنامج الزحف الوجه نفسه مجددًا. ويتطلب ذلك الاحتفاظ بفهرس «قائمة حظر» لتضمينات وجوه المنسحبين وفحص كل تضمين جديد مقابله قبل الفهرسة. ويجب أن تكون قائمة الحظر نفسها سريعة، لأنها تُستعلم عند كل إدخال، كما تثير أسئلة خاصة بها حول الاحتفاظ بالبيانات: يجب أن تخزن تضمين وجه الشخص المنسحب بصورة دائمة حتى تتمكن من المطابقة مقابله، ما يعني أنك تحتفظ ببيانات حيوية للامتثال لطلب حذف. وهذا التوتر القانوني حقيقي ولم يُحسم في كثير من الولايات القضائية.
- مشكلة الموافقة في البيانات التي جُمعت من الويب علنًا. يشكل الأساس القانوني لـGDPR لمعالجة البيانات الحيوية من ملفات التواصل الاجتماعي العامة موضع نزاع قانوني. وقد حكمت عدة سلطات لحماية البيانات في الاتحاد الأوروبي ضد شركات التعرّف على الوجوه، ولا سيما قرارات Clearview AI في عدة دول أعضاء في الاتحاد الأوروبي. تعتمد مخاطرك القانونية على الولاية القضائية ومصدر البيانات وحالة الاستخدام. وهذا ليس قلقًا مستقبليًا افتراضيًا، بل مجال إنفاذ نشط.
- تكاليف تخزين مسار التدقيق. إذا سجّلت كل استعلام بحث وكل مطابقة مُعادة، وهو ما قد يتطلبه الامتثال، فقد تنمو سجلات التدقيق أسرع من بيانات الوجوه الفعلية. يولد نظام يتعامل مع مليون عملية بحث يوميًا، لكل منها 10 نتائج، نحو 10 ملايين سجل تدقيق يوميًا. وتعني متطلبات الاحتفاظ، التي تتراوح غالبًا بين سنة و7 سنوات حسب الولاية القضائية، أن هذه البيانات تتراكم بلا هوادة. خطط لتخزين التدقيق بوصفه مركز تكلفة رئيسيًا، لا فكرة لاحقة.
- الاستجابة للحوادث. ماذا يحدث عندما يطابق نظامك وجهًا بصورة خاطئة ويتخذ شخص إجراءً بناءً على تلك المطابقة الكاذبة؟ تحتاج إلى مسارات تدقيق توضح كيفية توليد كل نتيجة، والقدرة على شرح قرارات المطابقة، وعملية للتعامل مع النزاعات. عندما يعترض شخص على مطابقة، فإن قول «بلغ تشابه جيب التمام 0.47، وهو أعلى من حدنا البالغ 0.42» ليس تفسيرًا مُرضيًا. يمكن لتقنيات مثل GradCAM إظهار مناطق الوجه التي دفعت المطابقة، ما يساعد في حل النزاعات وبناء الثقة. وهذا ليس مجرد ممارسة هندسية جيدة، بل قد يكون مطلوبًا قانونيًا حسب ولايتك القضائية.
- تقادم النموذج والاعتماديات. تتغير إصدارات CUDA وPython و[ONNX Runtime](https://onnxruntime.ai/) وتحديثات نظام التشغيل بمرور الوقت، وقد تكسر مسار الاستدلال بطرق خفية. يساعد تثبيت الإصدارات إلى أن تحتاج إلى تصحيح أمني. وستقضي وقتًا مفاجئًا في إدارة الاعتماديات وإعادة إنتاج البيئات.
- تركّز معرفة الفريق. يفهم المهندس الذي بنى طبقة فهرسة FAISS منطق التجزئة. ويعرف المهندس الذي ضبط برامج الزحف المواقع التي تحتاج إلى معالجة خاصة. وعندما يغادر هؤلاء الأشخاص، وهو أمر يحدث في مشروع يمتد من 18 إلى 24 شهرًا، تغادر معهم معرفة حاسمة. تساعد الوثائق، لكنها لا تلتقط بالكامل «سبب» القرارات غير الواضحة.
ملخص التكلفة الحقيقية
بالنسبة إلى نظام بحث وجوه على نطاق الويب يبحث في الإنترنت العام:
- الفريق الهندسي: من 3 إلى 5 مهندسين كبار لمدة 12-24 شهرًا = من 600 ألف إلى 2.5 مليون دولار للرواتب والنفقات العامة
- البنية التحتية (السنة الأولى): من 400 ألف إلى مليون دولار في تكاليف السحابة أو العتاد
- البنية التحتية (المستمرة): من 30 ألفًا إلى 80 ألف دولار شهريًا، أي من 360 ألفًا إلى 960 ألف دولار سنويًا
- الشؤون القانونية والامتثال: من 50 ألفًا إلى 200 ألف دولار للتقييم الأولي، إضافةً إلى الاستشارات المستمرة
- إجمالي السنة الأولى: من 1.4 مليون إلى 3.7 ملايين دولار
- إجمالي السنة الثانية وما بعدها: من 500 ألف إلى 1.2 مليون دولار سنويًا للبنية التحتية والصيانة الهندسية
وهذا لنظام يعمل. تنفق فرق كثيرة من 6 إلى 12 شهرًا وأكثر من 500 ألف دولار قبل أن تدرك أن المشكلة أصعب مما قدرت، فتتحول إلى حل قائم على واجهة API.
متى تبني نظامك ومتى تستخدم واجهة API
ابنِ نظامك عندما:
- تكون لديك مجموعة بيانات مغلقة، مثل شارات الموظفين أو صور العملاء، تضم أقل من 100 ألف وجه
- تحتاج إلى تشغيل النظام محليًا أو في بيئة معزولة عن الشبكة
- يكون لديك مهندسو تعلم آلي قادرون على التعامل مع تحسين النموذج وضبط الحدود والحالات الطرفية
- تكون حالة استخدامك هي التحقق 1: 1 بدلًا من البحث 1:N عبر الويب
- تكون لديك الميزانية والجدول الزمني للالتزام بمشروع هندسي متعدد السنوات
استخدم واجهة API عندما:
- تحتاج إلى البحث عن الوجوه عبر الإنترنت العام، بما في ذلك وسائل التواصل الاجتماعي والأخبار والويب
- لا تريد بناء مسار لاستخراج الويب وفهرسته وصيانته
- تحتاج إلى النتائج الآن، لا بعد 12-24 شهرًا من العمل الهندسي
- تحتاج إلى أن يظل النظام مواكبًا للمحتوى الجديد المنشور على الإنترنت
- تريد من جهة أخرى التعامل مع امتثال GDPR وطلبات الانسحاب وقانون الذكاء الاصطناعي للاتحاد الأوروبي
- تريد تجنب أكثر من مليون دولار في تكاليف البنية التحتية والهندسة مقدمًا
- لا يكون منتجك الأساسي هو البحث عن الوجوه نفسه، ويُفضّل إنفاق الوقت الهندسي على منتجك الفعلي
واجهة API للبحث عن الوجوه من FaceCheck.id
بالنسبة إلى المطورين الذين يحتاجون إلى البحث عن الوجوه عبر الويب العام من دون بناء البنية التحتية من الصفر، تقدم FaceCheck.id واجهة REST API تتولى المسار كاملًا: الكشف والتضمين والبحث في فهرس محدّث باستمرار لصور الوجوه المتاحة علنًا عبر وسائل التواصل الاجتماعي والمواقع الإخبارية والويب الأوسع.
تستخدم FaceCheck.id نموذجًا خاصًا للتعرّف على الوجوه محسّنًا للبحث على نطاق الويب. وبخلاف النماذج مفتوحة المصدر التي ستحتاج إلى نشرها وضبطها بنفسك، دُرّب نموذجها الخاص وضُبط بدقة خصيصًا لمواجهة تحديات البحث عن الوجوه على الإنترنت: التعامل مع تفاوت جودة الصور تفاوتًا شديدًا، وظروف الإضاءة المتنوعة، والتنوع الديموغرافي، والحجم الهائل لفهرسها الذي يجري زحفه باستمرار. يتيح لها هذا النهج الخاص تطوير أداء النموذج بصورة مستقلة وتحسينه لمسار البحث المحدد لديها بطرق لا تستطيعها النماذج مفتوحة المصدر العامة. وقد استُثمرت سنوات من الهندسة والاختبار والتحسين لجعل النظام يعمل بمستوى سيكون من الصعب والمكلف للغاية تكراره من الصفر.
ما تفعله واجهة API:
ترسل صورة وجه، فتعيد واجهة API الوجوه المطابقة التي عُثر عليها عبر الإنترنت، مع درجات الثقة وعناوين URL للمصادر. ويجري التعامل مع المطابقة والفهرسة والبنية التحتية واسعة النطاق من جانبهم. كل عناقيد وحدات معالجة الرسومات ومسارات الزحف والبنية التحتية للبحث المتجهي وأدوات الامتثال والصيانة المستمرة الموضحة أعلاه هي مشكلتهم، لا مشكلتك.
أساسيات واجهة API:
- واجهة RESTful تستخدم JSON
- المصادقة عبر مفتاح API
- إرسال صورة مرمّزة بصيغة base64 أو عنوان URL لصورة
- تعيد: مصفوفة من المطابقات مع درجات التشابه وعناوين URL للمصادر ومعاينات الصور المصغرة
- تتوسع حدود المعدل والأسعار حسب الاستخدام
تكامل نموذجي:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
حالات استخدام واجهة API:
- التحقق في تطبيقات المواعدة: اسمح للمستخدمين بالتحقق من ظهور صور الطرف المطابق في ملفات حقيقية على وسائل التواصل الاجتماعي
- حماية العلامة التجارية: تحقق مما إذا كان شخص ما يستخدم صور فريقك لإنشاء ملفات أعمال مزيفة
- منصات العناية الواجبة: أضف البحث بالوجه إلى إجراءات التحقق من الخلفية أو «اعرف عميلك»
- أنظمة مكافحة الاحتيال: ضع علامة على الحسابات التي تستخدم صورًا تظهر في مواضع أخرى على الإنترنت بأسماء مختلفة
- أدوات استخبارات المصادر المفتوحة: ابنِ أدوات تحقيق تتضمن مطابقة الوجوه على نطاق الويب
لماذا تستخدمها بدلًا من بناء نظامك بنفسك:
يتطلب بناء محرك بحث عن الوجوه يبحث في الويب العام: (1) مسار زحف على نطاق الويب يكتشف مليارات الصور وينزلها، و(2) بنية تحتية لوحدات معالجة الرسومات تكلف مئات الآلاف من الدولارات لتشغيل كشف الوجوه واستخراج التضمينات، و(3) نظام بحث متجهي موزع بذاكرة RAM تبلغ عدة تيرابايتات للاستعلام في الفهرس الكامل لحظيًا، و(4) إعادة زحف مستمرة لإبقاء الفهرس حديثًا، و(5) بنية امتثال لطلبات الانسحاب وحذف البيانات والمتطلبات التنظيمية، و(6) فريقًا من 3 إلى 5 مهندسين يصونونه بدوام كامل، و(7) مدة من 12 إلى 24 شهرًا قبل إصدار أول نسخة قابلة للاستخدام. وهذا مشروع هندسي بملايين الدولارات وتكاليف مستمرة كبيرة. وتمنحك واجهة API، المدعومة بنموذج FaceCheck.id الخاص وبنيتها التحتية المختبرة ميدانيًا، كل ذلك عبر استدعاء HTTP واحد.
تُعد النماذج مفتوحة المصدر المذكورة أعلاه ممتازة لبناء أنظمة مغلقة للتعرّف على الوجوه، مثل التحكم في وصول الموظفين وتنظيم مكتبات الصور ومسارات التحقق المخصصة. لكن إذا كانت حالة استخدامك هي «البحث على الإنترنت عن مواضع ظهور هذا الوجه»، فإن الفجوة الهندسية بين نموذج يعمل ومنتج يعمل هائلة. تسد واجهة FaceCheck.id API هذه الفجوة، ما يتيح لك إطلاق منتج عامل خلال أيام بدلًا من سنوات.
ابدأ الآن: زُر facecheck.id/en/Face-Search/API للاطلاع على الوثائق والأسعار وتسجيل مفتاح API.
الأسئلة الشائعة
ما أدق نموذج مفتوح المصدر للتعرّف على الوجوه؟
يحقق FaceNet512 المزود ببنية أساسية من Inception-ResNet-v2 حاليًا نتائج ممتازة في معظم الاختبارات، إذ يسجل 99.65% على LFW. أما في سيناريوهات الصور منخفضة الجودة، مثل المراقبة وكاميرات الدوائر التلفزيونية المغلقة، فيُظهر AdaFace أداءً أفضل في الاختبارات الصعبة مثل IJB-C، مع TAR@FAR=1e-4 يبلغ 97.39%.
هل يمكنني استخدام نماذج التعرّف على الوجوه مفتوحة المصدر تجاريًا؟
نعم. تُطرح FaceNet512 وFaceNet وDeepFace وdlib وAdaFace جميعها بموجب تراخيص متساهلة، مثل MIT أو Boost. ويمكنك استخدامها في المنتجات التجارية. لكن انتبه إلى القيود القانونية المفروضة على معالجة البيانات الحيوية في ولايتك القضائية، مثل GDPR وBIPA وقانون الذكاء الاصطناعي للاتحاد الأوروبي، وهي تنطبق بصرف النظر عن ترخيص البرنامج.
ما مقدار البيانات التي أحتاج إليها لتدريب نموذج خاص بي للتعرّف على الوجوه؟
لا تحتاج إلى التدريب من الصفر. دُرّبت النماذج المدربة مسبقًا المذكورة أعلاه على مجموعات بيانات تضم من 5 إلى 12 مليون صورة عبر 100 ألف إلى 500 ألف هوية. استخدم هذه النماذج المدربة مسبقًا، ولا تلجأ إلى الضبط الدقيق إلا إذا كانت لديك حاجة خاصة بمجال معين. يتطلب الضبط الدقيق عادةً من 10 آلاف إلى 100 ألف صورة. أما التدريب من الصفر، فيتطلب ملايين الصور وموارد كبيرة من وحدات معالجة الرسومات.
ما الفرق بين التحقق من الوجه والبحث بالوجه؟
يجيب التحقق من الوجه 1:1 عن سؤال «هل تمثل هاتان الصورتان الشخص نفسه؟» من خلال مقارنة تضمينين مباشرةً. أما البحث بالوجه 1:N، فيجيب عن سؤال «أين يظهر هذا الشخص؟» من خلال مقارنة تضمين واحد بقاعدة بيانات تضم الملايين. التحقق بسيط حسابيًا. أما البحث فيتطلب فهرسة فعالة لأقرب الجيران، باستخدام FAISS أو Milvus، ويتطلب البحث على نطاق الويب بنية ضخمة للزحف والفهرسة قد يكلف بناؤها وتشغيلها ملايين الدولارات.
ما مدى دقة التعرّف على الوجوه في الصور منخفضة الجودة؟
تنخفض الدقة بصورة كبيرة مع انخفاض جودة الصورة. ففي الصور الواضحة المواجهة للكاميرا، تحقق النماذج الحديثة دقة تتجاوز 99%. أما في لقطات المراقبة الضبابية أو الصور التي يقل عرض الوجه فيها عن 50 بكسل، فقد تنخفض الدقة إلى 80-90% أو أقل. صُمم AdaFace خصيصًا للتعامل مع تفاوت الجودة بصورة أفضل من النماذج القياسية. وفي أي نظام، تنتج صور الإدخال الأعلى دقة نتائج أفضل بكثير. كما تهم وضعية الوجه أيضًا: فقد تنخفض الدقة في الوجوه الجانبية بنسبة 10-20% مقارنةً بالوجوه الأمامية، حتى مع الصور عالية الدقة.
ما تكلفة بناء محرك بحث عن الوجوه؟
بالنسبة إلى نظام على نطاق الويب يبحث في الإنترنت العام، توقّع تكاليف تتراوح بين 1.4 مليون و3.7 ملايين دولار في السنة الأولى، شاملة الفريق الهندسي والبنية التحتية والشؤون القانونية، وبين 500 ألف و1.2 مليون دولار سنويًا في التكاليف المستمرة بعد ذلك. أما بالنسبة إلى نظام مغلق يبحث في قاعدة بيانات خاصة تضم أقل من 100 ألف وجه، فالتكاليف أقل بكثير؛ إذ يستطيع خادم واحد مزود بوحدة معالجة رسومات ومهندس واحد التعامل معه. وتتوسع التكلفة حسب حجم قاعدة بيانات البحث وما إذا كنت تحتاج إلى زحف الويب لتعبئتها.
كم يستغرق بناء نظام إنتاجي للتعرّف على الوجوه؟
بالنسبة إلى نظام تحقق بسيط، أي مطابقة 1:1 مقابل قاعدة بيانات معروفة، يستطيع مهندس ذو خبرة بناء نموذج أولي عامل خلال أسبوع إلى أسبوعين، وجعله جاهزًا للإنتاج خلال شهر إلى 3 أشهر. أما بالنسبة إلى نظام بحث عن الوجوه على نطاق الويب، أي 1:N عبر الإنترنت، فتوقّع من 12 إلى 24 شهرًا مع فريق من 3 إلى 5 مهندسين قبل امتلاك نظام موثوق بما يكفي للإنتاج. تضيف تحديات الزحف والتوسع والامتثال وقتًا هائلًا يتجاوز عمل التعلم الآلي الأساسي.
ابنِ شيئًا مهمًا. ابدأ باستخدام FaceNet512 لنظامك المغلق. لكن إذا كنت تحتاج إلى البحث عن الوجوه على نطاق الويب، فاسأل نفسك: هل تريد حقًا إنفاق ما بين 1.4 مليون و3.7 ملايين دولار، وتوظيف فريق من كبار المهندسين، والانتظار من 12 إلى 24 شهرًا قبل الحصول على أول نتيجة قابلة للاستخدام؟ بدلًا من ذلك، يمكنك تجاوز عناقيد وحدات معالجة الرسومات وكوابيس الزحف ومتاعب الامتثال وسنوات العمل الهندسي بالكامل، والحصول على أول نتائج بحث خلال أقل من 5 دقائق، بتكلفة تبدأ من دولار أمريكي واحد فقط، باستخدام واجهة FaceCheck.id API.
تعلم المزيد عن البحث بواسطة الصورة
البحث بالصور في Yandex: الدليل الكامل للعثور على الوجوه (2026)
كان البحث بالصور في Yandex السلاح السري للعثور على الأشخاص بواسطة الصور. لكن في 2026، تراجعت قدراته على مطابقة الوجوه. إليك ما لا يزال يعمل، وما لم يعد يعمل، وأفضل بديل لعمليات البحث المخصصة للوجوه.
حول الموضوع بلغات أخرى
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
المواضيع الشائعة
الهوية وسائل التواصل الاجتماعي التعرف على الوجه كيفية التعريف البحث عن الوجه رديت الشبيه العثور على الوجهأفضل محركات البحث العكسي للصور: مراجعة PimEyes vs FaceCheck