Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
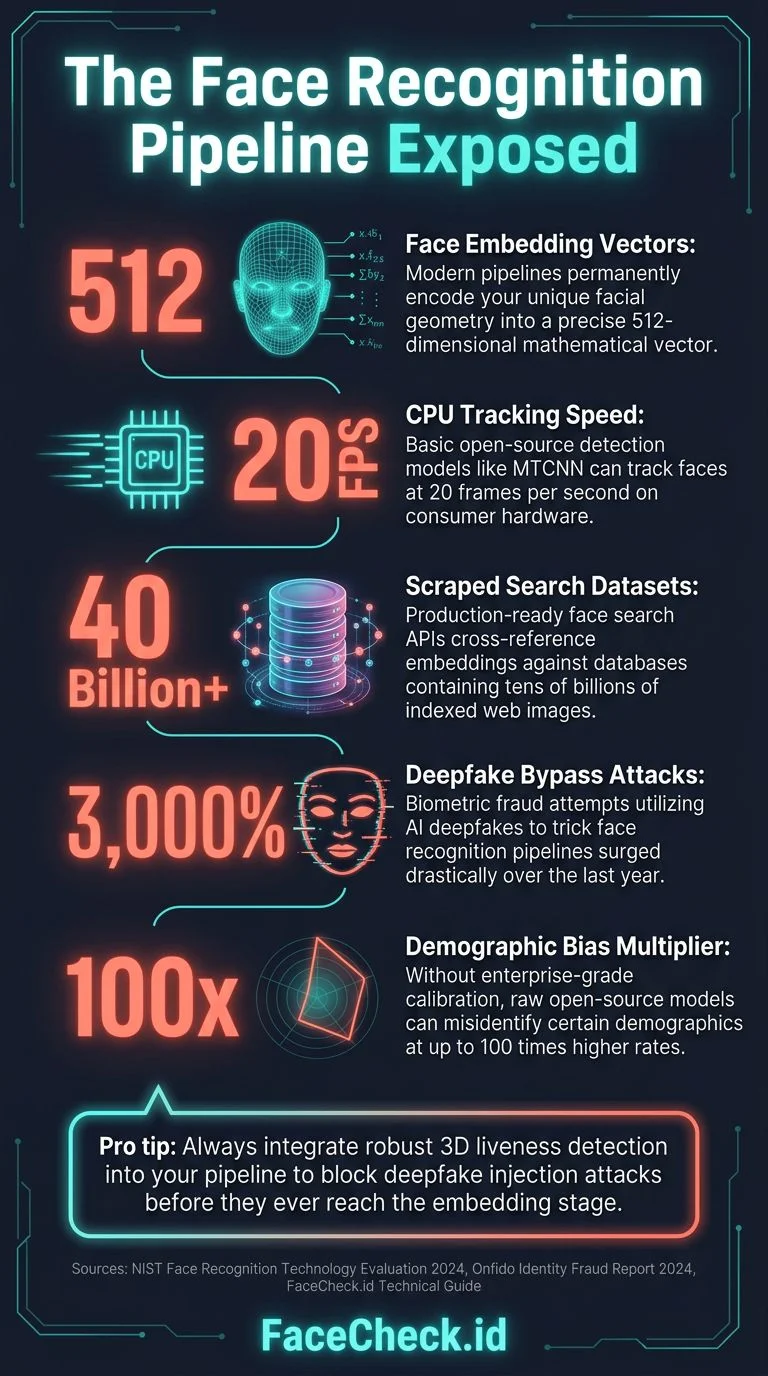
Pokud vytváříte cokoli, co potřebuje porovnávat obličeje, ověřovat totožnost podle fotografie nebo vyhledávat obličej v datové sadě, musíte rozumět tomu, jak moderní rozpoznávání obličejů skutečně funguje. Ne marketingové verzi. Skutečnému procesu od nezpracovaných pixelů až po 512rozměrný vektor embeddingu, který zachycuje jedinečnou geometrii obličeje člověka.
Tento článek podrobně rozebírá celý proces rozpoznávání obličejů, porovnává nejlepší open source modely dostupné v roce 2026, uvádí skutečné údaje o výkonu a vysvětluje, kdy má smysl vytvořit vlastní systém a kdy použít produkční API.
V tomto článku se budeme zabývat
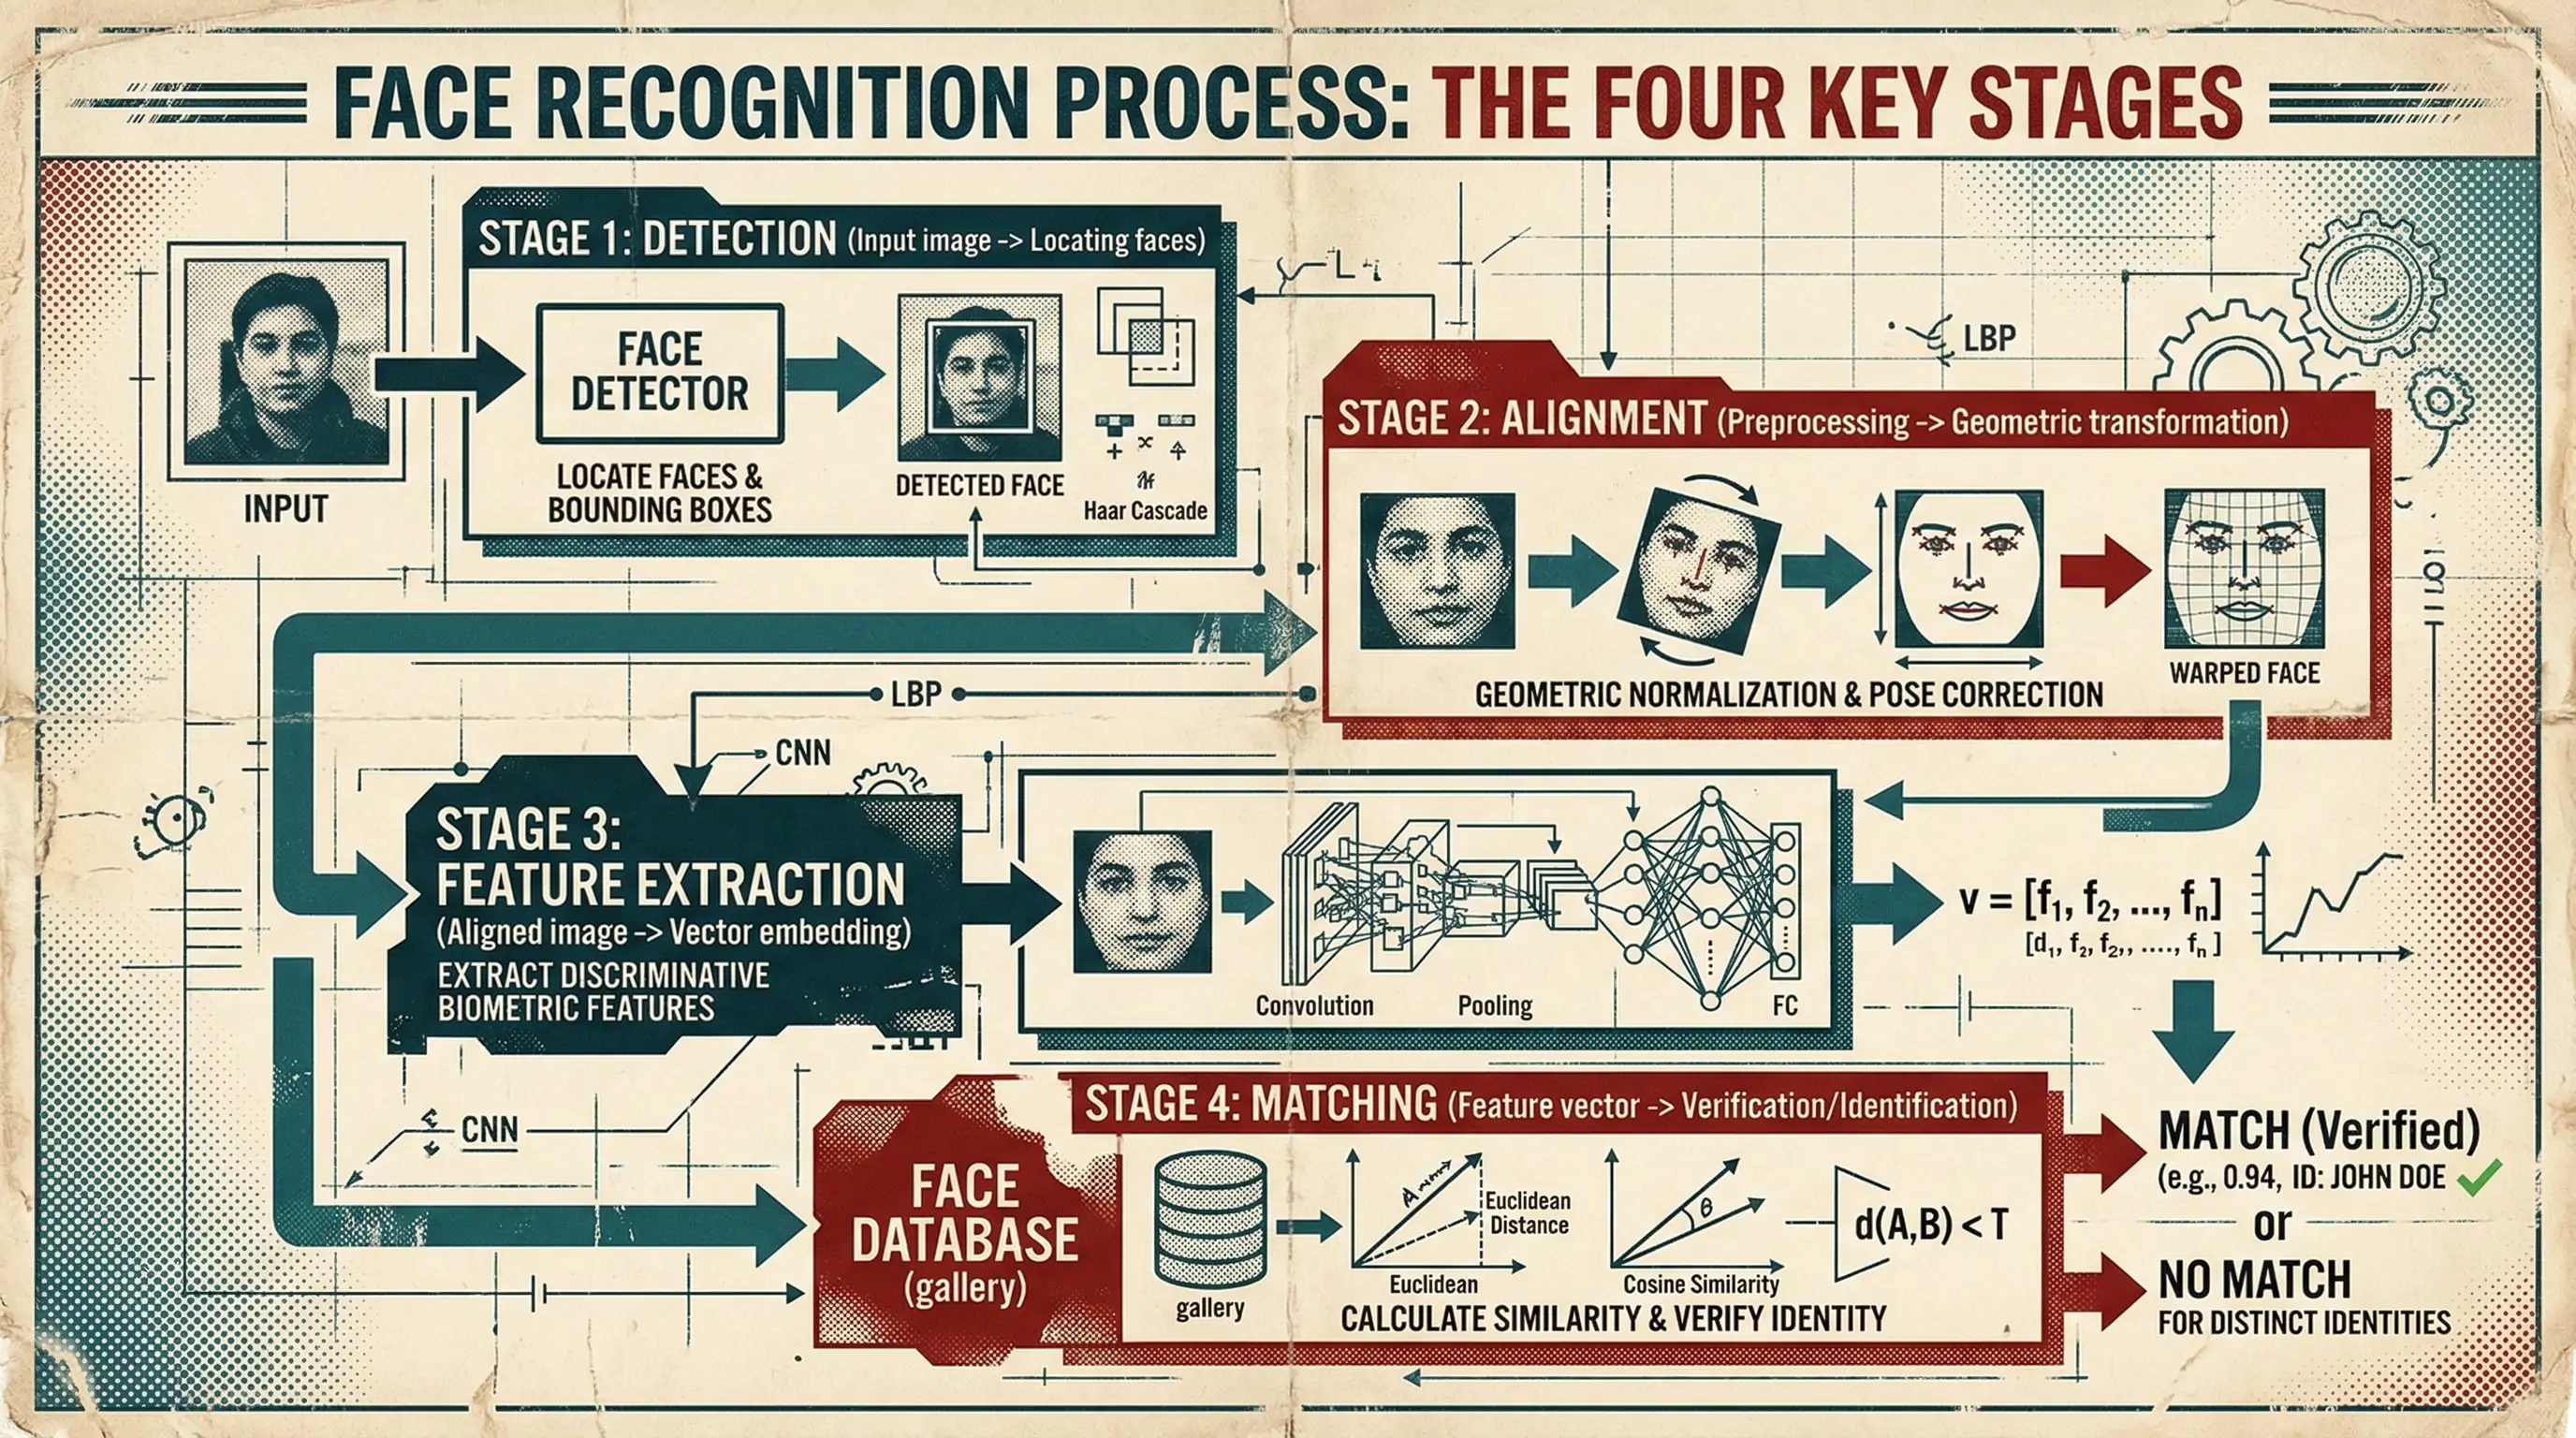
Proces rozpoznávání obličejů: Čtyři fáze
Každý moderní systém rozpoznávání obličejů používá stejný základní proces bez ohledu na to, zda běží na Raspberry Pi za 35 dolarů, nebo na clusteru GPU ve státní instituci. Pochopení těchto čtyř fází vám pomůže vyhodnotit jakýkoli model nebo API.
Fáze 1: Detekce obličeje
Než můžete obličej rozpoznat, musíte ho najít. Detekce obličeje přijme obrázek a vrátí ohraničující rámečky kolem všech přítomných obličejů. Zní to jednoduše, ale právě zde mnoho systémů v produkčním prostředí selhává.
Standardní modely:
- MTCNN (Multi-task Cascaded Convolutional Networks): Osvědčený tahoun detekce obličejů od roku 2016. Třístupňová kaskáda: Proposal Network (P-Net) vyhledává kandidátní oblasti, Refine Network (R-Net) filtruje falešně pozitivní výsledky a Output Network (O-Net) zpřesňuje ohraničující rámečky a vrací obličejové orientační body. Stále se široce používá. Je přesný u čelních pohledů, ale má potíže s extrémními úhly a zakrytím. Na moderním CPU zvládá přibližně 20 FPS.
- RetinaFace: Špička v přesnosti detekce. Jednostupňový detektor založený na architektuře [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Vrací ohraničující rámečky a pět obličejových orientačních bodů (oči, nos a koutky úst). Dobře zvládá různá měřítka. Jde o nejčastější volbu, pokud je přesnost důležitější než rychlost. Přibližně 15 FPS na GPU, na CPU je pomalejší.
- SCRFD (Sample and Computation Redistribution for Efficient Face Detection): Rychlostní šampion. Byl navržen pro nasazení na mobilních a edge zařízeních. Dosahuje přesnosti na úrovni RetinaFace při 3–10násobné rychlosti. Existuje v několika velikostech od 0,5 milionu do 34 milionů parametrů. Pokud nasazujete na mobilní zařízení nebo potřebujete zpracování v reálném čase, je to správná volba.
- BlazeFace: Příspěvek společnosti Google navržený pro [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Je mimořádně rychlý (na mobilních GPU běží rychlostí přes 200 FPS), ale u obtížných úhlů obětuje část přesnosti. Hodí se pro video aplikace v reálném čase, kde potřebujete zpracovat každý snímek.
Na čem při detekci skutečně záleží: Obtížnými případy nejsou selfie s dobrým osvětlením. Jsou to záběry z bezpečnostních kamer, skupinové fotografie, na nichž mají obličeje šířku 50 pixelů, extrémní profily a obličeje částečně zakryté slunečními brýlemi nebo rouškami. Detekční model určuje maximální možnosti celého systému. Pokud detekce obličej přehlédne, žádná navazující fáze už to nenapraví.
Problém více obličejů: Pokud obrázek obsahuje více obličejů, musíte rozhodnout, pro který z nich vytvoříte embedding. Mezi možné strategie patří výběr největšího obličeje, obličeje nejblíže středu, obličeje s nejvyšším skóre kvality nebo vytvoření embeddingů pro všechny obličeje a ponechání rozhodnutí na navazující logice. Každá volba má jiné způsoby selhání. Vytvoření embeddingů všech obličejů na skupinových fotografiích zvětšuje index a vede k nejednoznačným výsledkům vyhledávání; výběr pouze největšího obličeje zase přehlédne člověka stojícího v zadní řadě. Většina produkčních systémů vytváří embeddingy všech detekovaných obličejů nad minimálním velikostním prahem (obvykle 40–60 pixelů mezi očima) a ukládá je jako samostatné položky propojené se stejným zdrojovým obrázkem.
Hodnocení kvality obličeje jako vstupní kontrola: Spuštění nenáročného odhadu kvality, například SER-FIQ nebo větve pro kvalitu z modelu MagFace, ještě před výpočtem náročných embeddingů zabrání tomu, aby se nekvalitní data vůbec dostala do indexu. Rozmazané výřezy, výrazná zakrytí a přeexponované obličeje vytvářejí embeddingy s nízkou mírou jistoty, které znečišťují výsledky vyhledávání. Odmítnutí obličejů pod prahem kvality už ve fázi detekce výrazně zvyšuje přesnost navazujících kroků a šetří výpočetní kapacitu GPU. Jde o jednu z optimalizací s nejvyšší návratností investic v celém procesu.
Ochrana proti podvržení obličeje při ověřování: Ve scénářích ověřování je zásadní detekce prezentačních útoků (PAD). Papírové výtisky, přehrávání obrazu na displeji i 3D masky mohou systémy založené na embeddingu oklamat. Modely jako CDCN nebo PatchNet tyto útoky odhalují, ale přidávají 5–15 ms latence na obličej a vyžadují údržbu dalšího modelu. Pokud vytváříte cokoli, kde vstupní obrázek ovládá uživatel – řízení přístupu, KYC nebo autentizaci –, musíte ochranu proti podvržení zahrnout, jinak bude systém zneužit.
Fáze 2: Zarovnání obličeje
Jakmile obličej detekujete, musíte ho normalizovat. Různé polohy hlavy, úhly kamery a vzdálenosti mění vzhled obličeje v nezpracovaném obrázku. Zarovnání převede každý detekovaný obličej do standardizované polohy: oči jsou ve stejné výšce, obličej je vystředěný a měřítko je jednotné.
Standardní přístup využívá pět orientačních bodů z detekce (levé oko, pravé oko, špička nosu, levý koutek úst a pravý koutek úst) k výpočtu transformace podobnosti. Ta mapuje detekovaný obličej na standardizovaný výřez o rozměrech 160 × 160 pixelů s očima na pevně daných souřadnicích.
Tento krok se v návodech často přehlíží, ale je zásadní. Chyba zarovnání o 2 stupně může snížit přesnost rozpoznávání o 1–3 %. Většina open source řešení jej zajišťuje automaticky, ale pokud vytváříte vlastní systém, použijte jako standard specifikaci zarovnání FaceNet (160 × 160, konkrétní souřadnice očí). Právě podle ní byla natrénována většina moderních modelů.
Citlivost zarovnání na přesnost orientačních bodů: Orientační body modelu RetinaFace mají v průměru chybu přibližně 2 pixely. Tato chyba se přenáší do transformačního výpočtu zarovnání a může způsobit snížení přesnosti o 1–5 %, zejména u menších výřezů obličejů, kde 2 pixely představují větší podíl celkové šířky obličeje. Některé produkční systémy po úvodní detekci spouštějí sekundární zpřesnění pomocí 68 nebo 98 orientačních bodů, například face-alignment od Adriana Bulata. Dodatečné 3–5 ms na obličej se vyplatí, pokud váš případ použití vyžaduje maximální přesnost – zejména při ověřování 1:1, kdy má jediné nesprávné rozhodnutí závažné následky.
Fáze 3: Extrakce příznaků (embedding)
Toto je jádro rozpoznávání obličejů. Hluboká neuronová síť přijme zarovnaný obrázek obličeje a vytvoří vektor pevné délky (obvykle o 512 rozměrech), kterému se říká embedding neboli vektor příznaků. Tento vektor je kompaktním číselným vyjádřením jedinečných vlastností daného obličeje.
Dva obličeje stejné osoby by bez ohledu na osvětlení, výraz, věk (v rozumné míře) nebo fotoaparát měly vytvářet embeddingy, které jsou si ve vektorovém prostoru blízké. Dva různí lidé by měli vytvářet embeddingy, které jsou od sebe vzdálené.
Jak to technicky funguje:
Architektura sítě je obvykle upravený Inception-ResNet nebo ResNet natrénovaný na milionech obrázků obličejů. Klíčová inovace nespočívá v samotné architektuře, ale ve ztrátové funkci použité při trénování.
- Ztráta softmax (základní varianta): Přistupuje k rozpoznávání obličejů jako ke klasifikaci. Funguje, ale vytváří embeddingy, které nejsou v úhlovém prostoru dobře oddělené. Pro rozpoznávání je už z velké části zastaralá.
- Triplet loss: Přístup zpopularizovaný modelem FaceNet. Síť se učí porovnáváním trojic obličejů anchor/positive/negative, přičemž embeddingy stejné identity přibližuje a embeddingy různých identit od sebe vzdaluje. Během trénování vyžaduje pečlivý výběr obtížných trojic. Vytváří vysoce diskriminativní embeddingy.
- Ztráta ArcFace: V roce 2026 jde pravděpodobně o nejpoužívanější ztrátovou funkci v produkčních systémech rozpoznávání obličejů. Přidává aditivní penalizaci úhlového odstupu v úhlovém prostoru mezi vektorem příznaků a odpovídající váhou třídy. Ve srovnání s přístupy založenými na kosinovém odstupu tak vytváří těsnější shluky uvnitř tříd a větší mezery mezi třídami. Projekt [InsightFace](https://github.com/deepinsight/insightface) poskytuje referenční implementaci a většina nejmodernějších modelů se trénuje pomocí ArcFace nebo některé z jeho variant (například adaptivní odstup AdaFace vychází z formulace ArcFace). Pokud trénujete nebo dolaďujete vlastní model rozpoznávání obličejů, ArcFace je výchozím bodem.
- Ztráta CosFace: Přidává ke ztrátě softmax kosinový odstup a nutí síť vytvářet embeddingy, které jsou v rámci jednotlivých identit těsněji seskupené a mezi identitami více oddělené.
- SphereFace / A-Softmax: Původní přístup založený na úhlovém odstupu z roku 2017. Je historicky významný, ale z velké části jej nahradily ArcFace a modernější ztrátové funkce.
Výstup: Vektor 512 čísel s plovoucí desetinnou čárkou, normalizovaný pomocí L2 na jednotkovou hypersféru. Veškeré informace o obličeji jsou komprimovány do 2 kB dat. Právě tento vektor se ukládá, indexuje a porovnává.
Past normalizace: Mnoho vývojářů zapomíná, že embeddingy je nutné před porovnáním normalizovat pomocí L2. Nenormalizované embeddingy vytvářejí velmi nekonzistentní skóre podobnosti. Jde o běžnou chybu, kterou je těžké diagnostikovat, protože systém „většinou funguje“ – relativní pořadí shod může při testování vypadat správně, ale absolutní skóre podobnosti se mezi obrázky posouvá, takže rozhodování založené na prahu je nespolehlivé. FaceNet512 ve výchozím nastavení vytváří normalizované embeddingy, ale pokud používáte vlastní model nebo export přes ONNX, vždy ověřte, že výstupní embeddingy leží na jednotkové hypersféře (tedy že jejich L2 norma je rovna 1,0).
Produkční nasazení: ONNX Runtime a kvantizace: Údaje o rychlosti v benchmarcích předpokládají inferenci FP32 na nezatíženém GPU. V produkci se většina systémů nasazuje pomocí ONNX Runtime s kvantizací INT8, která zkracuje dobu inference 2–3krát při minimální ztrátě přesnosti (na LFW obvykle méně než 0,1 %). Postup je následující: exportujte model PyTorch nebo TensorFlow do ONNX, spusťte kvantizační nástroj ONNX Runtime s kalibrační datovou sadou přibližně 1 000 obrázků obličejů a nasaďte kvantizovaný model. Takto se na stejném hardwaru dostanete z „10 ms na obličej“ na „3–4 ms na obličej“, což je při zpracování miliard obrázků nesmírně důležité.
Inference se smíšenou přesností: Použití FP16 na GPU pro páteřní síť a FP32 pro poslední vrstvu embeddingu zabraňuje problémům s přesností výpočtů s plovoucí desetinnou čárkou popsaným dále v článku, a přitom stále přináší 1,5–2násobné zrychlení. Jde o praktický kompromis mezi plným FP32 (přesné, ale pomalé) a plným FP16 (rychlé, ale na různém hardwaru může vytvářet mírně odlišné embeddingy).
Destilace embeddingů pro nasazení na edge zařízeních: Menší studentskou síť (MobileFaceNet, přibližně 1 milion parametrů) můžete pomocí destilace znalostí natrénovat tak, aby napodobovala embeddingy FaceNet512. Studentský model dosahuje více než 95 % přesnosti při desetinásobné rychlosti, takže je vhodný pro mobilní a edge nasazení, kde si nemůžete dovolit GPU. Klíčovým poznatkem je, že studentský model nemusíte trénovat od začátku na štítcích identit obličejů – trénujete ho tak, aby reprodukoval embeddingy učitelského modelu na neoznačených datech obličejů, což vyžaduje výrazně méně výpočetního výkonu a žádnou datovou sadu s označenými identitami.
Fáze 4: Porovnávání
Jak se na základě dvou embeddingů obličejů rozhodnete, zda jde o stejnou osobu? Existují dva přístupy:
Kosinová podobnost: Vypočítá kosinus úhlu mezi dvěma vektory embeddingů. Rozsah je od −1 do 1, přičemž 1 znamená totožnost. Typický práh pro „stejnou osobu“ je 0,4–0,6 v závislosti na modelu a případu použití. Metoda je jednoduchá, rychlá a funguje dobře, protože embeddingy FaceNet512 jsou normalizované pomocí L2.
Eukleidovská vzdálenost: Vypočítá L2 vzdálenost mezi vektory. U normalizovaných embeddingů je matematicky ekvivalentní kosinové podobnosti (d = sqrt(2 - 2*cos_sim)). Některé systémy dávají přednost této formulaci.
Pro vyhledávání (porovnávání 1:N): Pokud potřebujete najít obličej v databázi obsahující miliony záznamů, porovnávání hrubou silou je příliš pomalé. Použijte vyhledávání přibližných nejbližších sousedů (ANN):
- FAISS (Facebook AI Similarity Search): Standardní knihovna. Podporuje akceleraci pomocí GPU a několik typů indexů (IVF, HNSW, PQ). Dokáže prohledat 1 miliardu vektorů během milisekund. Je zdarma a open source.
- Milvus: Specializovaná vektorová databáze, která interně používá FAISS a doplňuje jej o perzistenci, škálování a vrstvy API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Spravované vektorové databáze pro případ, že nechcete provozovat vlastní infrastrukturu.
U databáze s 10 miliony obličejů dokáže dobře vyladěný index FAISS HNSW na jediném GPU vrátit 10 nejlepších shod za méně než 5 milisekund.
Na výběru typu indexu FAISS nesmírně záleží. IVF-PQ poskytuje skvělou kompresi (8–16 bajtů na vektor namísto 2 kB), ale snižuje přesnost u hraničních shod, kdy chyba kvantizace posune skutečnou shodu pod práh. HNSW přesnost zachovává, ale využívá 4–8krát více paměti, protože ukládá celé vektory s plovoucí desetinnou čárkou i grafovou strukturu. Hybridní indexy IVF-HNSW nabízejí nejlepší kompromis pro rozsah od 10 milionů do 1 miliardy záznamů. Většina týmů si zpočátku podle doporučení z návodů zvolí nesprávný typ indexu a o 6 měsíců později musí po dosažení jeho omezení přestavět celou indexovací infrastrukturu. Než se pro určitý typ indexu rozhodnete, otestujte konkrétní pracovní zátěž s realistickým objemem dat a vzorci dotazování.
Problém studeného startu indexů ANN: Indexy HNSW a IVF potřebují k dobrému fungování minimální počet vektorů. Při méně než přibližně 10 000 vektorech je vyhledávání hrubou silou ve skutečnosti rychlejší než indexované vyhledávání, protože režie indexu (průchod grafem, porovnávání centroidů) převáží nad samotným výpočtem. V počáteční fázi růstu začněte hrubou silou (FAISS IndexFlatIP) a na index ANN přejděte, jakmile databáze překročí 50 000–100 000 vektorů.
Předběžné filtrování pomocí binárních kódů: Výpočet binárního hashe každého embeddingu (pomocí binarizace nebo SimHash) umožňuje před náročným porovnáváním čísel s plovoucí desetinnou čárkou provést levné předběžné filtrování podle Hammingovy vzdálenosti. To může zmenšit množinu kandidátů o více než 90 % při minimální ztrátě úplnosti výsledků. Princip spočívá v uložení 256bitového nebo 512bitového binárního kódu vedle každého úplného embeddingu. U dotazu nejprve vypočítáte Hammingovu vzdálenost ke všem binárním kódům (pomocí instrukcí CPU POPCNT je to mimořádně rychlé), vyberete 1–5 % nejlepších kandidátů a přesnou kosinovou podobnost vypočítáte pouze pro ně. Tento dvoustupňový přístup je zvlášť účinný, když datová sada překračuje dostupnou paměť GPU.
Přeřazení pomocí atributů obličeje: Prvotní vyhledávání embeddingů vrátí kandidáty; druhý průchod s využitím odhadovaných atributů (věkové rozmezí, pohlaví, odstín pleti, vousy) může odfiltrovat zjevné falešné shody. Pokud je obličej v dotazu odhadnut jako 25letá žena a kandidát jako 60letý muž, téměř jistě jde o falešně pozitivní výsledek bez ohledu na skóre podobnosti embeddingů. Tato jednoduchá heuristika může s minimálními výpočetními náklady snížit počet falešně pozitivních výsledků o 30–50 % a patří k nejméně využívaným technikám v produkčním vyhledávání obličejů.
Časová konzistence ve videu: Pokud porovnáváte obličeje z videa namísto statických snímků, zprůměrování embeddingů z více snímků stejného sledovaného obličeje výrazně zvyšuje přesnost (na obtížných benchmarcích často o 5–10 %). Agregace embeddingů na úrovni sledované stopy je vždy lepší než porovnávání jednotlivých snímků. Postup je následující: pomocí nástroje pro sledování obličejů (například SORT nebo DeepSORT) propojte detekce napříč snímky, vypočítejte embedding každé detekce a agregujte je do jediného „embeddingu stopy“ pomocí váženého průměru, kde vahou je skóre kvality obličeje z fáze detekce.
Nejlepší open source modely rozpoznávání obličejů (2026)
FaceNet512
Zlatý standard. FaceNet512 je varianta architektury FaceNet od Googlu s 512rozměrným embeddingem, která nabízí větší a diskriminativnější prostor embeddingů než původní 128rozměrná verze.
from deepface import DeepFace

# Získání embeddingů obličeje pomocí FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # Seznam o 512 rozměrech- Architektura: Páteřní síť Inception-ResNet-v2 vytvářející 512rozměrné embeddingy
- Licence: MIT (permisivní, komerční použití je povoleno)
- Přesnost na LFW: 99,65 %
- Velikost embeddingu: 512 rozměrů
- Součásti: Funguje se standardními detekčními procesy (MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)) pro kompletní rozpoznávání
- Python API: Dostupné prostřednictvím knihovny
deepfacenebo samostatných implementací
Verdikt: Pokud v roce 2026 vytváříte systém rozpoznávání obličejů, FaceNet512 je dobrým výchozím bodem. Nabízí vynikající přesnost, 512rozměrné embeddingy s vysokou diskriminační schopností, permisivní licenci MIT a širokou podporu ekosystému.
FaceNet (Google, původní 128rozměrná verze)
Model, který v roce 2015 zpopularizoval přístup založený na embeddingu. Zavedl trénování pomocí triplet loss, při němž se síť učí porovnáváním trojic obličejů anchor/positive/negative.
- Původní článek: "FaceNet: Jednotný embedding pro rozpoznávání a shlukování obličejů" (Schroff a kol., 2015)
- Repozitář: Několik implementací (davidsandberg/facenet je klasická verze pro TensorFlow)
- Licence: MIT
- Přesnost na LFW: 99,63 % (původní), s moderním trénováním až 99,75 %
- Velikost embeddingu: 128 rozměrů
- Architektura: Inception-ResNet-v1 nebo Inception-ResNet-v2
Verdikt: Historicky významný model, který stále funguje dobře. 128rozměrný embedding je kompaktnější, ale o něco méně diskriminativní než 512rozměrná varianta FaceNet512. Použijte jej, pokud potřebujete menší embedding nebo pracujete v prostředí TensorFlow s omezenou pamětí.
DeepFace (Facebook/Meta)
Nezaměňovat s pythonovou knihovnou deepface (s malým počátečním písmenem). DeepFace společnosti Meta (2014) byl jedním z prvních přístupů k rozpoznávání obličejů založených na hlubokém učení a na LFW dosahoval přesnosti blízké člověku.
V současnosti je relevantnějším projektem pythonová knihovna deepface od Serengila:
from deepface import DeepFace

# Ověření dvou obličejů
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Vyhledání obličeje v databázi
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repozitář: github.com/serengil/deepface
- Licence: MIT
- Co dělá: Obalová knihovna poskytující jednotné API pro několik backendových modelů FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib a SFace
- Součásti: Ověřování, vyhledávání a analýza atributů obličeje (věk, pohlaví, rasa, emoce)
- Snadnost použití: Mimořádně jednoduché API
Verdikt: Nejlepší volba pro prototypování a experimentování. Jednotné API umožňuje přepínat mezi modely změnou jediného parametru. V produkci budete chtít kvůli vyššímu výkonu a lepší kontrole používat přímo FaceNet512.
dlib
Knihovna v C++ s rozhraním pro Python, kterou spravuje Davis King. Obsahuje model rozpoznávání obličejů natrénovaný na datové sadě se 3 miliony obrázků.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Získání embeddingu
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repozitář: github.com/davisking/dlib
- Licence: Boost Software License (permisivní)
- Přesnost na LFW: 99,38 %
- Velikost embeddingu: 128 rozměrů
- Detekce: Založená na HOG (rychlá a vhodná pro CPU) a CNN (přesnější)
Verdikt: Mimořádně stabilní a praxí prověřené řešení v C++ s kvalitním rozhraním pro Python. Má nižší přesnost než FaceNet512, ale je velmi spolehlivé. Je dobrou volbou, pokud pracujete v C++ nebo potřebujete nenáročné řešení bez závislostí na PyTorch/ONNX.
AdaFace
Novější model (2022), který se cíleně zabývá rozdíly v kvalitě obrazu. Standardní modely jsou trénované na vysoce kvalitních obrázcích a u vstupů s nízkým rozlišením nebo rozmazáním se jejich výkon zhoršuje. AdaFace během trénování přizpůsobuje penalizaci odstupu kvalitě obrázku.
- Repozitář: github.com/mk-minchul/AdaFace
- Licence: MIT
- Hlavní výhoda: Vyšší výkon u nekvalitních obrázků (dohledové systémy, kamery snímající na velkou vzdálenost)
- Přesnost na LFW: 99,82 %
- IJB-C TAR@FAR=1e-4: 97,39 % (na obtížných benchmarcích překonává většinu open source modelů)
Verdikt: Použijte jej, pokud mají vstupní obrázky nízkou kvalitu. Při analýze dohledových systémů, kamerových systémů CCTV nebo v jakémkoli scénáři, kde kvalitu obrazu nemůžete ovlivnit, poskytuje AdaFace měřitelně lepší výsledky než standardní modely.
Tabulka porovnání výkonu
| Model | LFW (%) | Embedding | Rychlost (ms/obličej) | Licence |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 rozměrů | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 rozměrů | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 rozměrů | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 rozměrů | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2 048 rozměrů | ~15 ms (GPU) | CC BY-SA |
LFW (Labeled Faces in the Wild) je standardní benchmark, ale v zásadě už je vyřešený. Každý moderní model dosahuje více než 99 %. Skutečné rozdíly se projeví na obtížnějších benchmarcích, jako jsou IJB-C (různorodé podmínky) a TinyFace (nízké rozlišení).
Poznámka k benchmarkům oproti realitě: Tyto údaje o rychlosti představují inferenci FP32 na jediném obličeji se zahřátým GPU. V produkci s kvantizací INT8 v ONNX Runtime očekávejte 2–3násobnou rychlost. Pamatujte však také na to, že celý proces – detekce + zarovnání + hodnocení kvality + embedding – trvá 3–5krát déle než samotná extrakce embeddingu. Realistická celková propustnost kompletního procesu na jediném GPU A100 je 200–400 obličejů za sekundu, nikoli tisíce, které mohou naznačovat benchmarky měřící pouze embedding.
Rozdíl mezi open source modely a produkčními systémy
Návody vám neřeknou toto: zprovoznit model rozpoznávání obličejů v Jupyter notebooku je ta snadná část. Vytvořit produkční systém, který skutečně funguje ve velkém měřítku, vyžaduje vyřešit dlouhý seznam technických problémů, s nimiž vám žádný model nepomůže. Většina týmů výrazně podceňuje náklady i časový plán. Projekt, který vypadá jako „jen připojíme model“, se promění v 12–24měsíční technické úsilí, které může před připraveností do produkce snadno spotřebovat 500 000 až více než 2 miliony dolarů, a to ještě bez průběžných provozních nákladů.
Účet za infrastrukturu
Výpočty na GPU pro extrakci embeddingů. Detekci obličejů a extrakci embeddingů z miliard obrázků nelze provádět na notebooku. Jediné GPU NVIDIA A100 dokáže kompletním procesem detekce + zarovnání + embedding zpracovat přibližně 200–400 obličejů za sekundu. Chcete-li zpracovat 1 miliardu obrázků v rozumném čase, řekněme za méně než týden, potřebujete cluster se 40–80 nepřetržitě běžícími GPU. Při cloudových sazbách stojí každý průchod zpracováním 50 000–150 000 dolarů a s vylepšováním modelu nebo změnami procesu budete muset data zpracovávat znovu. Nákup vlastního hardwaru znamená 300 000–800 000 dolarů za servery s GPU, k tomu prostor v racku, elektřinu, chlazení a člověka, který se o vše bude starat.
Úložiště ve velkém měřítku. 1 miliarda embeddingů obličejů po 512 číslech s plovoucí desetinnou čárkou (každý 2 kB) představuje přibližně 2 TB samotných vektorových dat. Přidejte původní obrázky, náhledy, metadata a struktury indexů a dostanete se na stovky terabajtů až jednotky petabajtů úložiště. Vysoce výkonné úložiště NVMe pro vektorové indexy stojí v cloudu 0,10–0,25 dolaru za GB měsíčně. Při 50 TB aktivního úložiště je to 5 000–12 500 dolarů měsíčně jen za udržení provozu.
Infrastruktura vektorového vyhledávání. FAISS na jediném počítači zvládne přibližně 100–500 milionů vektorů v závislosti na typu indexu a dostupné paměti RAM. Nad tuto hranici potřebujete distribuované vyhledávání ve více oddílech s vyvažováním zátěže, replikací pro odolnost proti chybám a dostatkem paměti RAM pro uložení indexů. Produkční distribuované nasazení FAISS nebo Milvus pro více než 1 miliardu vektorů obvykle vyžaduje 8–16 strojů s velkou pamětí (každý s nejméně 256 GB RAM), což v cloudu stojí 15 000–40 000 dolarů měsíčně.
Síť a přenosová kapacita. Procházení miliard obrázků znamená stahování petabajtů dat. Při ceně 0,05–0,09 dolaru za GB odchozích dat u hlavních cloudových poskytovatelů mohou samotné přenosy stát desítky tisíc dolarů. Potřebujete také vysoce propustnou interní síť mezi crawlery, uzly zpracování na GPU a úložnými backendy.
Odhad celkových nákladů na infrastrukturu webového vyhledávače obličejů: 30 000–80 000 dolarů měsíčně v průběžných cloudových nákladech nebo 500 000–1,5 milionu dolarů za hardware předem a k tomu 10 000–20 000 dolarů měsíčně za elektřinu, přenosovou kapacitu a údržbu. A to je pouze infrastruktura, ještě než jediný vývojář napíše řádek aplikačního kódu.
Časový plán vývoje
Vytvoření produkčního systému vyhledávání obličejů není projekt na hackathon. Zde je realistický časový plán pro tým 3–5 zkušených vývojářů:
1.–3. měsíc: Základní proces. Spolehlivě zprovozněte detekci, zarovnání a extrakci embeddingů. Vytvořte základní vektorový index. Zajistěte načítání obrázků z místních souborů. Toto je „zábavná“ část, kdy se zdá, že všechno jde dobře, a ukázka vypadá působivě.
3.–6. měsíc: Infrastruktura procházení webu. Vytvořte scrapery pro hlavní platformy. Vyřešte omezení rychlosti, CAPTCHA, přihlašovací bariéry, dynamické vykreslování (webové stránky intenzivně využívající JavaScript), deduplikaci obrázků a filtrování obsahu. Zjistíte, že každá sociální síť používá jiná opatření proti scrapingu, která vaše crawlery každý týden rozbíjejí. Vytvořte monitoring, který odhalí, když crawlery potichu selžou. Tato fáze sama o sobě může trvat déle, než očekáváte, protože web je neuspořádaný a nepřátelský.
6.–9. měsíc: Škálování a spolehlivost. Váš prototyp fungoval na 1 milionu obličejů. Teď ho zprovozněte na 100 milionech. Zjistíte, že se váš index FAISS už nevejde do paměti RAM. Implementujete dělení do oddílů. Opravíte souběhové chyby v procesu načítání dat. Vytvoříte logiku opakovaných pokusů pro 15 % obrázků, které se nepodaří stáhnout. Vyřešíte poškozené obrázky, soubory, které se vydávají za JPEG, ale nejsou jím, obrázky s příznaky otočení EXIF a neúplná stahování. Přidáte monitoring, výstrahy a protokolování, abyste věděli, když se něco ve 3 hodiny ráno porouchá.
9.–12. měsíc: Kvalita a přesnost. Zjistíte, že míra falešně pozitivních výsledků je ve velkém měřítku nepřijatelná. Implementujete hodnocení kvality obličeje, které odfiltruje nekvalitní embeddingy. Vyladíte prahy pro jednotlivé případy použití. Vytvoříte mechanismus zpětné vazby, aby bylo možné označit a prošetřit špatné shody. Zjistíte, že váš model kvůli rozdílům v přesnosti výpočtů s plovoucí desetinnou čárkou vytváří na různých architekturách GPU odlišné výsledky, a strávíte dva týdny hledáním příčiny.
12.–18. měsíc: Příprava na produkci. Vytvoříte vrstvu API s autentizací, omezováním rychlosti a sledováním využití. Přidáte funkce pro soulad s GDPR/CCPA: mechanismy odhlášení, žádosti o vymazání dat a auditní protokolování. Implementujete ukládání výsledků do mezipaměti. Vytvoříte administrační nástroje. Napíšete dokumentaci. Absolvujete bezpečnostní audit. Provedete zátěžové testy všeho. Opravíte úniky paměti, o nichž jste nevěděli.
18.–24. měsíc: Průběžný provoz. Crawlery se rozbíjejí, protože webové stránky mění rozvržení. Modely se odchylují, protože se objevují nové typy obrázků. Disk se zaplní. Indexy je nutné znovu sestavit. Uživatelé hlásí okrajové případy, které jste nikdy nepředpokládali. Někdo zjistí, že váš systém vrací přesvědčivé shody u kreslených obličejů, a vy musíte přidat filtr „skutečného obličeje“. Tohle nikdy nekončí.
Úplný seznam problémů, na které narazíte
Kromě infrastruktury a časového plánu jsou zde všechny hlavní problémy, s nimiž se týmy při vytváření systémů rozpoznávání obličejů od základu setkávají. Tento seznam vychází ze skutečných produkčních systémů, nikoli z teoretických obav.
Noční můry s kvalitou dat:
- Nekvalitní vstup, nekvalitní výstup. Internet je plný memů, obličejů vytvořených umělou inteligencí, kreseb, fotografií fotografií, obálek časopisů a soch. Váš detektor ve všech těchto případech najde „obličeje“ a vytvoří embeddingy, které znečistí index. Potřebujete klasifikátory pro odfiltrování syntetických obličejů, ilustrovaných obličejů, výřezů s mimořádně nízkým rozlišením a nefotografického obsahu. Vytvoření a údržba těchto filtrů je samostatným projektem.
- Duplicitní a téměř duplicitní obrázky. Stejná fotografie se objevuje na desítkách webů s různými výřezy, vodoznaky, úrovněmi komprese a úpravami barev. Bez deduplikace vytvoří jedna virální fotografie stovky „shod“, které jsou všechny stejným obrázkem, a pohřbí skutečné výsledky. Percepční hashování (pHash, dHash) pomáhá, ale není dokonalé. Potřebujete deduplikaci na několika úrovních: podle URL (triviální), podle percepčního hashe (zachytí kopie se změněnou velikostí a kompresí) a podle embeddingu (zachytí stejný obličej vyfotografovaný z mírně odlišných úhlů). Každá úroveň zachytí něco, co ostatní přehlédnou, a deduplikací strávíte více času, než očekáváte.
- Změny věku a vzhledu. Embedding obličeje z něčí vysokoškolské fotografie nemusí odpovídat fotografii o 15 let později. Změny hmotnosti, stárnutí, plastické operace, vousy a různé účesy ovlivňují přesnost rozpoznávání. Žádný model to neřeší dokonale. Uživatelé budou vinit váš systém, když nedokáže najít shodu s odstupem 20 let.
- Demografické zkreslení. Open source modely natrénované převážně na západních/bělošských datových sadách dosahují u jiných demografických skupin horších výsledků. Rozdíly v přesnosti mezi etnickými skupinami jsou větší, než naznačuje LFW – přibližně 77 % této datové sady tvoří běloši. Při globálním nasazení mohou rozdíly v přesnosti mezi demografickými skupinami na obtížných benchmarcích dosahovat 5–15 %. Modely jako FaceNet512 natrénované na MS-Celeb-1M přebírají její demografické zkreslení. Pro spravedlivý výkon je důležité dolaďování na vyvážených datových sadách (například BUPT-Balancedface) nebo použití trénovacích strategií zohledňujících demografické charakteristiky. Pokud přesnost nevyhodnocujete napříč rasovými skupinami, můžete vydat systém, který některým uživatelům funguje dobře a jiným špatně. Nejde jen o etický problém, ale také o kvalitu produktu a právní odpovědnost.
- Zpracování orientace EXIF. Přibližně 15–20 % obrázků na webu obsahuje značky orientace EXIF, jejichž ignorování vede k obličejům otočeným na bok nebo vzhůru nohama. Většina detektorů otočené obličeje nenajde. Jde o tichého zabijáka přesnosti, kterého lze při testování snadno přehlédnout (protože používáte správně orientované obrázky), ale v produkci má ničivé důsledky. Opravu orientace podle EXIF vždy provádějte jako úplně první krok zpracování obrázku.
- Selhání dekódování progresivních JPEG a WebP. Některé knihovny pro práci s obrázky tiše vytvářejí poškozená pixelová data z částečně stažených progresivních souborů JPEG nebo neúplných souborů WebP. Detektor obličejů může v artefaktech poškození přesto najít „obličej“ a vytvořit nesmyslný embedding. Před zpracováním potřebujete ověřit integritu obrázku – zkontrolovat, že lze soubor bez chyb dekódovat a že výsledná vyrovnávací paměť pixelů má rozumné rozměry. Bez toho poškozené obrázky tiše znečišťují index.
Technické problémy, které nejsou zpočátku zřejmé:
- Verzování embeddingů. Když aktualizujete model (a uděláte to, protože na zlepšení přesnosti záleží), každý embedding v databázi přestane být kompatibilní s výstupem nového modelu. Buď znovu vytvoříte embeddingy celé databáze (drahé, časově náročné a vyžadující zachování všech původních obrázků), během migrace budete provozovat paralelní indexy (dvojnásobné náklady na infrastrukturu), nebo zachováte zpětnou kompatibilitu (složité a omezující možnosti zlepšování). Neexistuje dobré řešení, pouze méně bolestivé možnosti.
- Determinismus výpočtů s plovoucí desetinnou čárkou. Stejný obrázek zpracovaný na různých modelech GPU, s různými verzemi CUDA nebo dokonce v různě velkých dávkách může kvůli aritmetice s plovoucí desetinnou čárkou vytvořit mírně odlišné embeddingy. Rozdíly jsou malé (1e-6 až 1e-4), ale sčítají se: shoda se skóre 0,401 na jednom stroji může mít na jiném skóre 0,399, což změní binární rozhodnutí podle prahu. Při ladění vás to přivede k šílenství. Zvláštní nástrahou jsou aktualizace ovladačů GPU – aktualizace ovladačů NVIDIA mohou změnit chování výpočtů s plovoucí desetinnou čárkou na úrovni CUDA. Embedding vypočítaný s ovladačem řady 535.x se může lišit od stejného obrázku zpracovaného s ovladačem 545.x. V produkci to znamená, že musíte verze ovladačů zafixovat v celé infrastruktuře a po každé aktualizaci ověřit konzistenci embeddingů.
- Souběh a souběhové chyby. Několik crawlerů současně načítá obličeje, uživatelé zadávají dotazy během aktualizace indexu a žádosti o vymazání přicházejí při sestavování výsledků vyhledávání. Vektorové databáze nemají tak vyspělou podporu transakcí jako databáze SQL. Narazíte na situace, kdy je obličej indexován jen částečně, dotazy vracejí zastaralé výsledky nebo se vymazání nepropaguje do všech oddílů.
- Správa paměti. Indexy FAISS jsou mapované do paměti, ale výkon dotazů výrazně závisí na tom, jak velká část indexu se vejde do RAM. S růstem indexu nepředvídatelně roste latence dotazů, když operační systém začne stránky indexu vytěsňovat z paměti. Ukončení procesů kvůli nedostatku paměti přichází v nejhorší možnou chvíli. Důvěrně se seznámíte se správou paměti v Linuxu, nastavením odkládacího prostoru a topologií [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). Další komplikací je zahřívání po studeném startu: indexy FAISS HNSW jsou mapované do paměti, takže po restartu serveru je prvních několik stovek dotazů 10–100krát pomalejších, protože stránky indexu ještě nejsou načtené v RAM. Než začnete přijímat produkční provoz, potřebujete zahřívací fázi, která index předem načte, jinak se první uživatelé po nasazení setkají s hroznou latencí.
- Tichá selhání. Crawler přestane fungovat, protože web změnil HTML. Uzel zpracování na GPU začne kvůli aktualizaci ovladače vytvářet embeddingy NaN. Disk se zaplní a nové obličeje se potichu přestanou indexovat. Tato selhání nevyvolávají chyby, pouze nenápadně zhoršují systém. Bez komplexního monitoringu a detekce anomálií se o nich nedozvíte, dokud si nezačnou stěžovat uživatelé.
- Problém obnovování FAISS. Když do indexu IVF přidáváte nové embeddingy, Voroného buňky ztrácejí vyváženost. Kvalita vyhledávání se postupně zhoršuje, dokud kvantizátor znovu nenatrénujete. Ve webovém měřítku znamená opětovné trénování hodiny výpočtů na GPU s celou datovou sadou. Týmy obvykle přidávání sdružují do dávek a index přetrénovávají týdně nebo měsíčně, takže nově načtené obličeje nelze okamžitě vyhledávat s plnou přesností. Neustále volíte mezi aktuálností a kvalitou vyhledávání a bezplatné řešení neexistuje.
- Kalibrace skóre mezi oddíly indexu. Pokud je index rozdělen mezi několik strojů, hrubá skóre podobnosti z různých oddílů nelze přímo porovnávat, protože každý oddíl má jiné rozložení embeddingů. Abyste mohli výsledky smysluplně sloučit, potřebujete normalizaci skóre pro jednotlivé oddíly (normalizaci kohort, Z-norm, T-norm). Bez kalibrace může skóre 0,45 z oddílu A představovat silnou shodu, zatímco 0,45 z oddílu B pouze průměrnou. Sloučené výsledky se stávají nespolehlivými.
- Problém rozesílání v distribuovaném vyhledávání. Vyhledávání v N oddílech znamená N síťových přenosů tam a zpět na každý dotaz. Pokud je některý oddíl pomalý (pozastavení kvůli GC, špička diskových operací, výpadek sítě), zpomalí se celý dotaz. Latenci P99 určuje P99 nejpomalejšího oddílu a s přidáváním dalších oddílů se situace zhoršuje. Techniky jako zajištěné požadavky (odeslání duplicitních požadavků a použití prvního výsledku) a adaptivní časové limity jsou pro zachování přijatelné koncové latence nezbytné.
Problémy s přesností a porovnáváním:
- Ladění prahů není nikdy „hotové“. Optimální práh podobnosti se s růstem databáze posouvá. U 1 milionu obličejů poskytuje práh 0,45 dobrou rovnováhu mezi přesností a úplností. U 100 milionů obličejů vytváří stejný práh desetkrát více falešně pozitivních výsledků jednoduše proto, že existuje více podobných lidí, kteří téměř odpovídají. Potřebujete adaptivní prahy nebo následné přeřazování výsledků. Základní matematika je neúprosná: když databáze vyroste z 1 milionu na 100 milionů a poté na 1 miliardu obličejů, rozložení skóre podobnosti top-k se posune vzhůru, protože přibývá podobných lidí, kteří téměř odpovídají. Pevný práh, který u 1 milionu obličejů poskytuje 0,1% míru falešně pozitivních výsledků, může u 1 miliardy vést k 10 %. Musíte toto rozložení modelovat a prahy dynamicky upravovat, nebo přijmout, že se přesnost s rostoucím měřítkem zhorší.
- Rozpoznávání v otevřené a uzavřené množině. Většina benchmarků vyhodnocuje výkon v uzavřené množině, kde je zaručeno, že se hledaná osoba v databázi nachází. Skutečné vyhledávání obličejů pracuje s otevřenou množinou: hledaný obličej v indexu vůbec být nemusí. Vyhodnocování otevřené množiny vyžaduje zcela jiné metriky (TPIR při pevné FPIR namísto přesnosti na první pozici) a způsobem selhání jsou falešné shody, nikoli nesprávné pořadí. Systém, který v benchmarcích uzavřené množiny dosahuje 99 %, může mít při nasazení s otevřenou množinou 10% míru falešných shod, protože sebejistě vrací „nejbližší“ obličej, i když skutečná shoda neexistuje. Správné zpracování výsledku „žádná shoda nenalezena“ je stejně důležité jako nalezení správných shod.
- Podobní lidé a dvojníci. V databázi s více než 100 miliony obličejů existuje mnoho dvojic nepříbuzných lidí, jejichž embeddingy jsou si překvapivě blízké. Čím větší databáze je, tím více falešných shod uvidíte. Uživatelé budou pravidelně hlásit výsledky s „nesprávnou osobou“. Potřebujete strategii, jak s tím zacházet: ověřování pomocí více fotografií, kontextové signály (jméno, lokalita) a fronty pro lidskou kontrolu.
- Rozpoznávání nezávislé na poloze zůstává obtížné. Dokonce i výkon FaceNet512 se výrazně zhoršuje při natočení hlavy o více než plus nebo minus 60 stupňů. Přesnost porovnávání profilu s čelním pohledem může být o 10–20 % nižší než při porovnávání dvou čelních pohledů. V dohledových scénářích je většina obličejů natočená, takže přesnost v reálném světě je podstatně nižší, než naznačují benchmarky. Modely trénované pomocí augmentace zohledňující 3D nebo architektury jako UV-GAN pomáhají, ale zvyšují složitost. Pokud jsou vstupní data převážně pořízená pod úhlem, považujte to za zásadní problém přesnosti, nikoli za okrajový případ.
- Útočné vstupy. Uživatelé budou odesílat obličeje vytvořené umělou inteligencí, deepfaky, morfované obrázky a fotografie se záměrnými perturbacemi. Někteří váš systém testují, jiní se snaží manipulovat s výsledky. Systém musí být proti těmto vstupům do určité míry odolný, jinak bude vracet přesvědčivé shody pro falešné obličeje.
- Úpravy fotografií. Filtry, zkrášlovací aplikace, výrazné líčení a software pro úpravu obličeje. Realita Instagramu oproti skutečné realitě. Tyto úpravy mění geometrii obličeje natolik, že ovlivňují podobnost embeddingů. Výrazně filtrované selfie nemusí odpovídat neupravené fotografii stejné osoby.
- Jeden obličej, mnoho embeddingů. Jedna osoba může mít na internetu stovky fotografií z různých platforem, úhlů a období. Vrátíte je všechny jako samostatné shody, nebo je seskupíte do jediné identity? Shlukování ve velkém měřítku (stovky milionů obličejů) je výpočetně náročné a přináší vlastní způsoby selhání: nadměrné slučování (spojení dvou různých lidí) a nedostatečné slučování (nespojení fotografií stejné osoby).
Provozní komplikace:
- Závody ve zbrojení proti scrapingu. Každá velká sociální síť aktivně blokuje scrapery. Platformy mění strukturu stránek, přidávají CAPTCHA, odhalují bezhlavé prohlížeče, omezují rychlost podle IP adresy, identifikují vzorce požadavků a někdy zobrazují klamný obsah. Vaše infrastruktura pro procházení webu je v neustálém závodu ve zbrojení. Scraper, který funguje dnes, může být příští týden úplně zablokovaný. Údržba crawlerů představuje průběžný technický náklad, nikoli jednorázový vývoj.
- Modelování rychlosti změn. Různé zdroje se aktualizují různou rychlostí. Weby se zprávami o celebritách získávají nové fotografie každou hodinu; osobní profily na sociálních sítích se nemusí změnit celé roky. Inteligentní plánování opakovaného procházení podle historické rychlosti změn může snížit náklady na přenosovou kapacitu o 60–80 % a současně udržet index aktuálnější tam, kde na tom záleží. Bez toho buď zbytečně často procházíte statické zdroje (plýtváte přenosovou kapacitou a penězi), nebo nedostatečně často procházíte dynamické zdroje (zobrazujete zastaralé výsledky).
- CDN a geografické rozdíly v obsahu. Stejná URL může zobrazovat různé obrázky podle polohy žadatele, identifikace zařízení v user-agentu nebo souborů cookie. Crawler může indexovat jiný obrázek, než vidí uživatel, což vede k matoucím hlášením typu „shoda nevypadá jako výsledek“. Některé CDN zobrazují zástupné obrázky s nízkým rozlišením, dokud skutečný prohlížeč neposune obrázek do viditelné části stránky. Tyto okrajové případy musíte řešit, nebo přijmout určité procento přízračných výsledků.
- Růst nákladů na úložiště. Úložiště obrázků roste lineárně a nikdy se nezastaví. Originály nemůžete odstranit, pokud můžete potřebovat znovu vytvořit jejich embeddingy. Náhledy, metadata, vektory embeddingů, soubory indexů a záložní kopie. S vyzráváním systému účet za úložiště roste stále rychleji. Týmy, které rozpočtovaly úložiště na první rok, jsou šokovány náklady ve třetím roce.
- Žádosti o zajištění souladu ve velkém měřítku. GDPR dává jednotlivcům právo požadovat vymazání svých údajů. Když někdo podá žádost o vyřazení, musíte: najít všechny embeddingy vytvořené z jeho obličeje v celé databázi, odstranit je, zajistit, aby se znovu nepřidaly, až crawlery najdou původní obrázky, a zdokumentovat vymazání pro účely auditu. Ve velkém měřítku to vyžaduje specializované nástroje a technické úsilí. [Akt EU o umělé inteligenci](https://artificialintelligenceact.eu/) přidává další požadavky na vysoce rizikové systémy AI včetně rozpoznávání obličejů: povinné posuzování shody, testování zkreslení, povinnosti v oblasti transparentnosti a mechanismy lidského dohledu.
- Implementace vyřazení je těžší, než se zdá. Embedding nemůžete jednoduše odstranit; musíte zabránit jeho opětovnému indexování, až crawler narazí na stejný obličej. To vyžaduje udržovat index „seznamu blokovaných“ embeddingů obličejů osob, které požádaly o vyřazení, a před indexováním proti němu kontrolovat každý nový embedding. Samotný seznam blokovaných musí být rychlý (dotazuje se při každém vložení) a vyvolává vlastní otázky ohledně uchovávání dat: embedding obličeje vyřazené osoby musíte uchovávat trvale, abyste proti němu mohli porovnávat – což znamená, že biometrické údaje uchováváte právě proto, abyste splnili žádost o jejich vymazání. Toto právní napětí je reálné a v mnoha jurisdikcích nevyřešené.
- Problém souhlasu u veřejně procházených dat. Zákonný důvod podle GDPR pro zpracování biometrických údajů z veřejných profilů na sociálních sítích je právně sporný. Několik úřadů pro ochranu osobních údajů v EU rozhodlo proti společnostem zabývajícím se rozpoznáváním obličejů (zejména rozhodnutí ve věci Clearview AI v několika členských státech EU). Vaše právní riziko závisí na jurisdikci, zdroji dat a případu použití. Nejde o hypotetickou budoucí obavu – v této oblasti už aktivně probíhá vymáhání práva.
- Náklady na ukládání auditních stop. Pokud zaznamenáváte každý vyhledávací dotaz a každou vrácenou shodu (což mohou vyžadovat předpisy), auditní protokoly mohou růst rychleji než samotná data obličejů. Systém zpracovávající 1 milion vyhledávání denně s 10 výsledky u každého z nich vytváří přibližně 10 milionů auditních záznamů za den. Požadavky na dobu uchování (často 1–7 let podle jurisdikce) znamenají, že tato data neúprosně narůstají. Auditní úložiště plánujte jako hlavní nákladovou položku, nikoli jako dodatečnou myšlenku.
- Reakce na incidenty. Co se stane, když systém nesprávně spáruje obličej a někdo na základě této falešné shody začne jednat? Potřebujete auditní stopy ukazující, jak byl každý výsledek vytvořen, schopnost vysvětlit rozhodnutí o shodě a proces řešení sporů. Když někdo shodu zpochybní, vysvětlení „kosinová podobnost byla 0,47, což překročilo náš práh 0,42“ není uspokojivé. Techniky jako GradCAM mohou ukázat, které části obličeje rozhodly o shodě, což pomáhá při řešení sporů a buduje důvěru. Nejde jen o správnou technickou praxi, ale v závislosti na jurisdikci to může být právní požadavek.
- Zastarávání modelů a závislostí. Verze CUDA, verze Pythonu, verze [ONNX Runtime](https://onnxruntime.ai/) a aktualizace operačního systému se v průběhu času mění a mohou jemnými způsoby narušit váš inferenční proces. Fixace verzí pomáhá, dokud nepotřebujete bezpečnostní opravu. Správou závislostí a reprodukovatelností prostředí strávíte překvapivě mnoho času.
- Koncentrace znalostí v týmu. Vývojář, který vytvořil indexovací vrstvu FAISS, rozumí logice dělení do oddílů. Vývojář, který vyladil crawlery, ví, které weby vyžadují zvláštní zacházení. Když tito lidé odejdou (a u projektu trvajícího 18–24 měsíců k fluktuaci dochází), kritické znalosti odejdou s nimi. Dokumentace pomáhá, ale nikdy plně nezachytí důvody, které stojí za méně zřejmými rozhodnutími.
Shrnutí skutečných nákladů
Pro webový systém vyhledávání obličejů ve veřejném internetu:
- Vývojový tým: 3–5 zkušených vývojářů po dobu 12–24 měsíců = 600 000–2,5 milionu dolarů za mzdy a režii
- Infrastruktura (1. rok): 400 000–1 milion dolarů za cloudové služby nebo hardware
- Infrastruktura (průběžně): 30 000–80 000 dolarů měsíčně (360 000–960 000 dolarů ročně)
- Právní záležitosti a soulad s předpisy: 50 000–200 000 dolarů za počáteční posouzení, dále průběžné právní poradenství
- Celkem za 1. rok: 1,4–3,7 milionu dolarů
- Celkem od 2. roku: 500 000–1,2 milionu dolarů ročně za infrastrukturu + technickou údržbu
A to platí pro systém, který funguje. Mnoho týmů utratí za 6–12 měsíců více než 500 000 dolarů, než zjistí, že je problém obtížnější, než odhadovaly, a přejde na řešení založené na API.
Kdy vytvářet vlastní řešení a kdy použít API
Vlastní řešení vytvořte, když:
- Máte uzavřenou datovou sadu (zaměstnanecké průkazy, fotografie zákazníků) s méně než 100 000 obličeji
- Potřebujete, aby systém běžel lokálně nebo v izolované síti
- Máte ML vývojáře, kteří zvládnou optimalizaci modelu, ladění prahů a okrajové případy
- Vaším případem použití je ověřování (1: 1), nikoli vyhledávání (1:N na webu)
- Máte rozpočet a čas na několikaletý vývojový projekt
API použijte, když:
- Potřebujete vyhledávat obličeje ve veřejném internetu (sociální sítě, zpravodajství, web)
- Nechcete vytvářet a udržovat proces scrapingu webu a indexování
- Potřebujete výsledky nyní, nikoli po 12–24 měsících vývoje
- Potřebujete, aby systém zůstával aktuální s novým obsahem zveřejňovaným online
- Chcete, aby někdo jiný řešil soulad s GDPR, žádosti o vyřazení a Akt EU o umělé inteligenci
- Chcete se vyhnout počátečním nákladům na infrastrukturu a vývoj přesahujícím 1 milion dolarů
- Vyhledávání obličejů není podstatou vašeho produktu a čas vývojářů je lepší věnovat skutečnému produktu
API FaceCheck.id pro vyhledávání obličejů
Vývojářům, kteří potřebují vyhledávat obličeje na veřejném webu, aniž by vytvářeli infrastrukturu od začátku, nabízí FaceCheck.id REST API, které zajišťuje celý proces: detekci, vytvoření embeddingu a vyhledávání v průběžně aktualizovaném indexu veřejně dostupných obrázků obličejů ze sociálních sítí, zpravodajských webů a širšího internetu.
FaceCheck.id používá proprietární model rozpoznávání obličejů optimalizovaný pro vyhledávání ve webovém měřítku. Na rozdíl od open source modelů, které byste museli sami nasadit a vyladit, je jejich proprietární model speciálně natrénovaný a doladěný pro problémy internetového vyhledávání obličejů: zvládání velmi proměnlivé kvality obrázků, různorodých světelných podmínek, demografické rozmanitosti a obrovského rozsahu průběžně procházeného indexu. Tento proprietární přístup jim umožňuje nezávisle vylepšovat výkon modelu a optimalizovat jej pro konkrétní proces vyhledávání způsoby, které u univerzálních open source modelů nejsou možné. Do fungování systému na úrovni, jejíž napodobení od začátku by bylo mimořádně obtížné a nákladné, byly investovány roky vývoje, testování a zdokonalování.
Co API dělá:
Odešlete obrázek obličeje a API vrátí odpovídající obličeje nalezené na internetu spolu se skóre jistoty a URL zdrojů. Porovnávání, indexování a infrastrukturu ve webovém měřítku zajišťuje poskytovatel. Všechny clustery GPU, procesy procházení webu, infrastruktura vektorového vyhledávání, nástroje pro zajištění souladu a průběžná údržba popsané výše – to je jejich problém, nikoli váš.
Základní informace o API:
- RESTful JSON API
- Autentizace pomocí klíče API
- Odeslání obrázku zakódovaného v base64 nebo URL obrázku
- Vrací: pole shod se skóre podobnosti, URL zdrojů a náhledy
- Omezení rychlosti a ceny se škálují podle využití
Typická integrace:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Krok 1: nahrání obrázku
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Krok 2: průběžná kontrola, dokud nejsou výsledky připravené
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Případy použití API:
- Ověřování v seznamovacích aplikacích: Umožněte uživatelům ověřit, zda se fotografie protějšku objevují na skutečných profilech na sociálních sítích
- Ochrana značky: Zkontrolujte, zda někdo nepoužívá fotografie vašeho týmu pro falešné firemní profily
- Platformy pro hloubkovou kontrolu: Přidejte vyhledávání obličejů do procesů prověřování minulosti nebo KYC
- Systémy proti podvodům: Označujte účty používající fotografie, které se jinde na internetu objevují pod jinými jmény
- Nástroje OSINT: Vytvářejte vyšetřovací nástroje, které zahrnují porovnávání obličejů ve webovém měřítku
Proč použít toto řešení namísto vlastního:
Vytvoření vyhledávače obličejů, který prohledává veřejný web, vyžaduje: (1) proces procházení webu ve velkém měřítku, který objeví a stáhne miliardy obrázků, (2) infrastrukturu GPU za stovky tisíc dolarů pro detekci obličejů a extrakci embeddingů, (3) distribuovaný systém vektorového vyhledávání s terabajty paměti RAM pro dotazování nad celým indexem v reálném čase, (4) nepřetržité opakované procházení, které udržuje index aktuální, (5) infrastrukturu pro vyřazení, žádosti o vymazání dat a plnění regulačních požadavků, (6) tým 3–5 vývojářů, kteří systém udržují na plný úvazek, a (7) 12–24 měsíců, než vydáte první použitelnou verzi. Jde o vývojový projekt za několik milionů dolarů s významnými průběžnými náklady. API poháněné proprietárním modelem a praxí prověřenou infrastrukturou FaceCheck.id vám toto vše zpřístupní jediným voláním HTTP.
Výše uvedené open source modely jsou vynikající pro vytváření uzavřených systémů rozpoznávání obličejů (řízení přístupu zaměstnanců, organizace knihoven fotografií, vlastní procesy ověřování). Pokud ale váš případ použití zní „vyhledejte na internetu, kde se tento obličej objevuje“, je technický rozdíl mezi fungujícím modelem a fungujícím produktem obrovský. API FaceCheck.id tuto mezeru překonává a umožní vám vydat funkční produkt během několika dnů namísto let.
Začněte: Dokumentaci, ceny a registraci klíče API najdete na stránce facecheck.id/en/Face-Search/API.
Časté dotazy
Který open source model rozpoznávání obličejů je nejpřesnější?
FaceNet512 s páteřní sítí Inception-ResNet-v2 v současnosti dosahuje vynikajících výsledků ve většině benchmarků, včetně 99,65 % na LFW. Ve scénářích s nekvalitními obrázky (dohledové systémy, CCTV) vykazuje AdaFace lepší výkon v obtížných benchmarcích, jako je IJB-C, kde dosahuje TAR@FAR=1e-4 ve výši 97,39 %.
Mohu open source modely rozpoznávání obličejů používat komerčně?
Ano. FaceNet512, FaceNet, DeepFace, dlib a AdaFace jsou vydány pod permisivními licencemi (MIT nebo Boost). Můžete je používat v komerčních produktech. Dávejte však pozor na právní omezení zpracování biometrických údajů ve své jurisdikci (GDPR, BIPA, Akt EU o umělé inteligenci), která platí bez ohledu na softwarovou licenci.
Kolik dat potřebuji k natrénování vlastního modelu rozpoznávání obličejů?
Nemusíte trénovat od začátku. Výše uvedené předtrénované modely byly natrénovány na datových sadách s 5–12 miliony obrázků a 100 000–500 000 identitami. Použijte tyto předtrénované modely a dolaďujte je pouze tehdy, pokud máte konkrétní potřebu v určité doméně. Doladění obvykle vyžaduje 10 000–100 000 obrázků. Trénování od začátku vyžaduje miliony obrázků a značné prostředky GPU.
Jaký je rozdíl mezi ověřováním obličeje a vyhledáváním obličeje?
Ověřování obličeje (1:1) odpovídá na otázku „je na těchto dvou fotografiích stejná osoba?“ přímým porovnáním dvou embeddingů. Vyhledávání obličeje (1:N) odpovídá na otázku „kde se tato osoba objevuje?“ porovnáním jednoho embeddingu s databází milionů záznamů. Ověřování je výpočetně jednoduché. Vyhledávání vyžaduje efektivní indexování nejbližších sousedů (FAISS, Milvus) a u vyhledávání ve webovém měřítku také rozsáhlou infrastrukturu pro procházení a indexování, jejíž vytvoření a provoz mohou stát miliony dolarů.
Jak přesné je rozpoznávání obličejů na nekvalitních obrázcích?
S kvalitou obrazu přesnost výrazně klesá. U ostrých fotografií zepředu dosahují moderní modely přesnosti přes 99 %. U rozmazaných záběrů z dohledových kamer nebo fotografií, na nichž je obličej široký méně než 50 pixelů, může přesnost klesnout na 80–90 % nebo níže. AdaFace je speciálně navržen tak, aby změny kvality zvládal lépe než standardní modely. U každého systému poskytují vstupní obrázky s vyšším rozlišením výrazně lepší výsledky. Záleží také na poloze: přesnost u obličejů z profilu může být o 10–20 % nižší než u čelních pohledů, a to i u obrázků s vysokým rozlišením.
Kolik stojí vytvoření vyhledávače obličejů?
U systému ve webovém měřítku, který prohledává veřejný internet, počítejte v prvním roce s náklady 1,4–3,7 milionu dolarů (vývojový tým + infrastruktura + právní záležitosti) a poté s průběžnými náklady 500 000–1,2 milionu dolarů ročně. U uzavřeného systému prohledávajícího soukromou databázi s méně než 100 000 obličeji jsou náklady výrazně nižší – zvládne jej jediný server s GPU a jeden vývojář. Náklady se odvíjejí od velikosti prohledávané databáze a od toho, zda k jejímu naplnění potřebujete procházet web.
Jak dlouho trvá vytvoření produkčního systému rozpoznávání obličejů?
U jednoduchého ověřovacího systému (porovnávání 1:1 se známou databází) může zkušený vývojář vytvořit funkční prototyp za 1–2 týdny a připravit jej do produkce za 1–3 měsíce. U systému vyhledávání obličejů ve webovém měřítku (1:N v internetu) počítejte s 12–24 měsíci práce týmu 3–5 vývojářů, než bude řešení dostatečně spolehlivé pro produkci. Procházení webu, škálování a plnění regulačních požadavků přidávají k základní práci na strojovém učení obrovské množství času.
Vytvořte něco, na čem záleží. Pro uzavřený systém začněte s FaceNet512. Pokud ale potřebujete vyhledávání obličejů ve webovém měřítku, zeptejte se sami sebe: opravdu chcete utratit 1,4–3,7 milionu dolarů, najmout tým zkušených vývojářů a čekat 12–24 měsíců na první použitelný výsledek? Místo toho můžete úplně přeskočit clustery GPU, noční můry s procházením webu, komplikace s dodržováním předpisů i roky vývoje, získat první výsledky vyhledávání za méně než 5 minut a začít už za 1 americký dolar s API FaceCheck.id.
Dozvědět se více...
Bezplatné nástroje pro reverzní vyhledávání obrázků, které skutečně fungují (2026)
Většina bezplatných nástrojů pro reverzní vyhledávání obrázků slibuje všechno, ale nepřinese nic. Otestovali jsme je všechny, abyste nemuseli. Tady jsou ty, které stojí za váš čas, včetně nejlepší možnosti pro vyhledávání zaměřené konkrétně na obličeje.
Na toto téma v jiných jazycích
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Populární témata
Deepfake Rozpoznávání Obličeje Facebook Identita Instagram Vyhledávač Obličejů Identifikace Vymáhání Práva Vyhledávání Obličeje Umělá Inteligence Dvojník BiometrickýNejlepší nástroje pro reverzní vyhledávání obrázků: PimEyes vs FaceCheck