Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
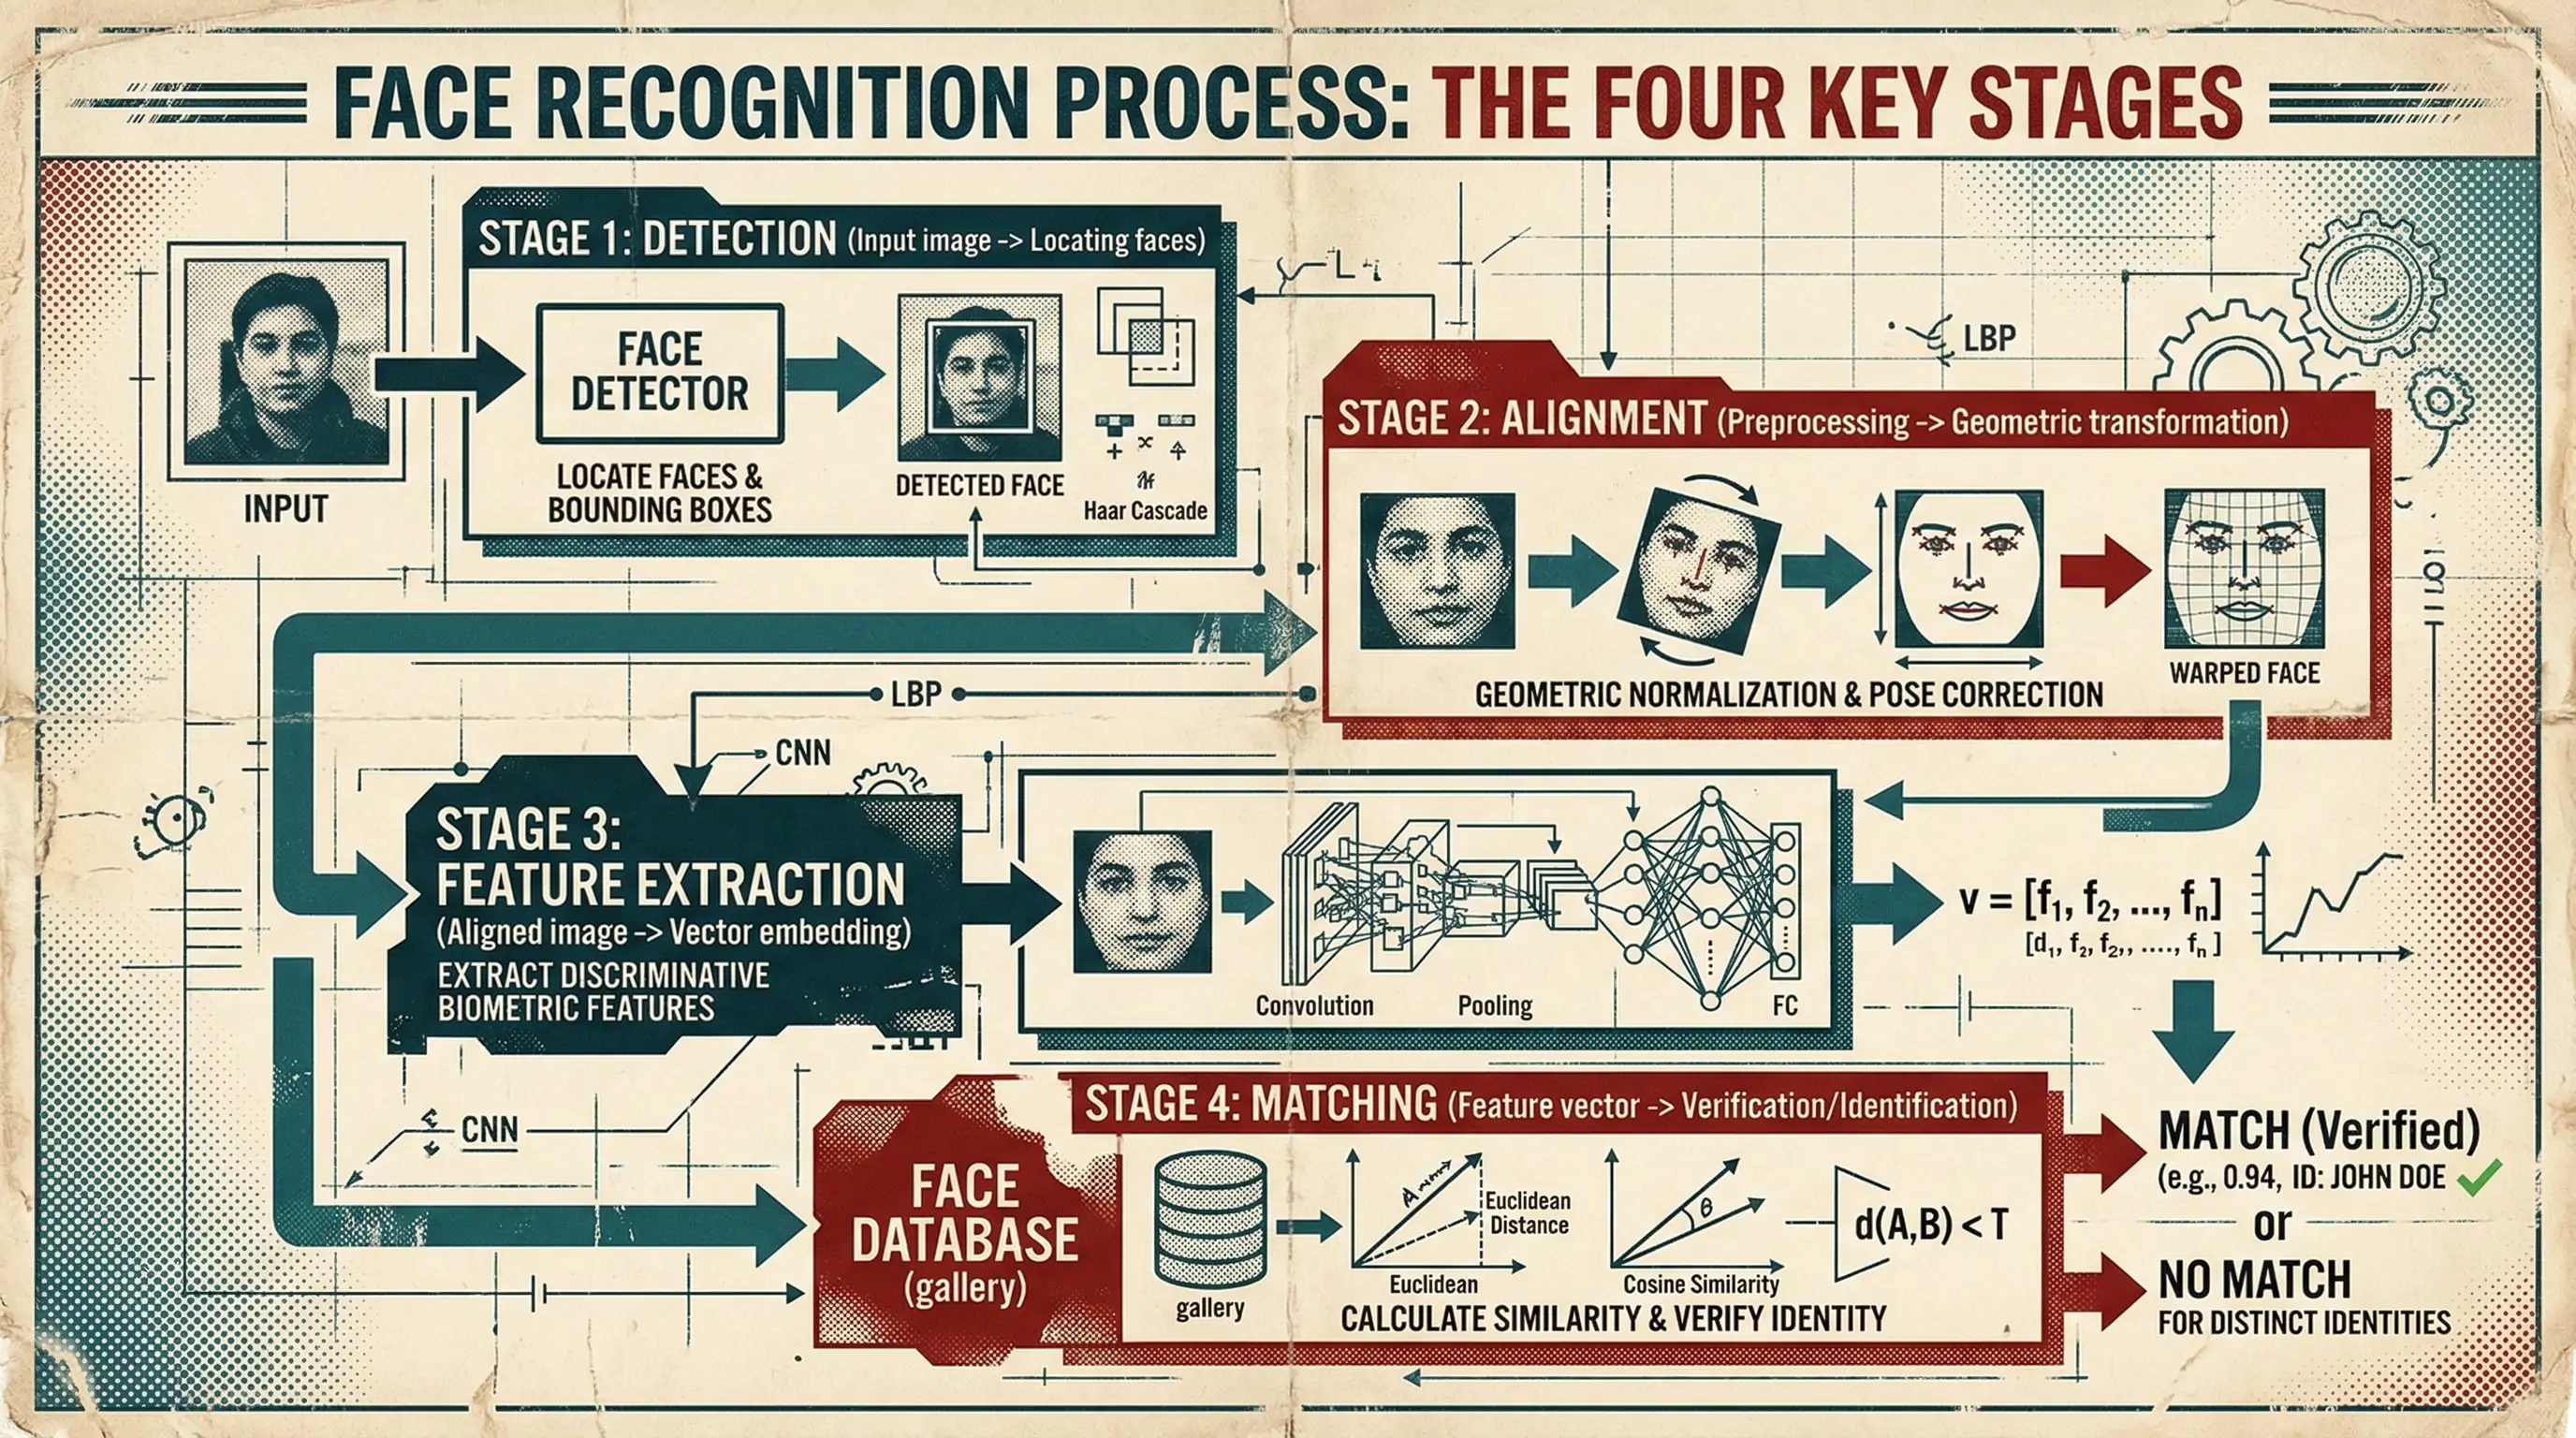
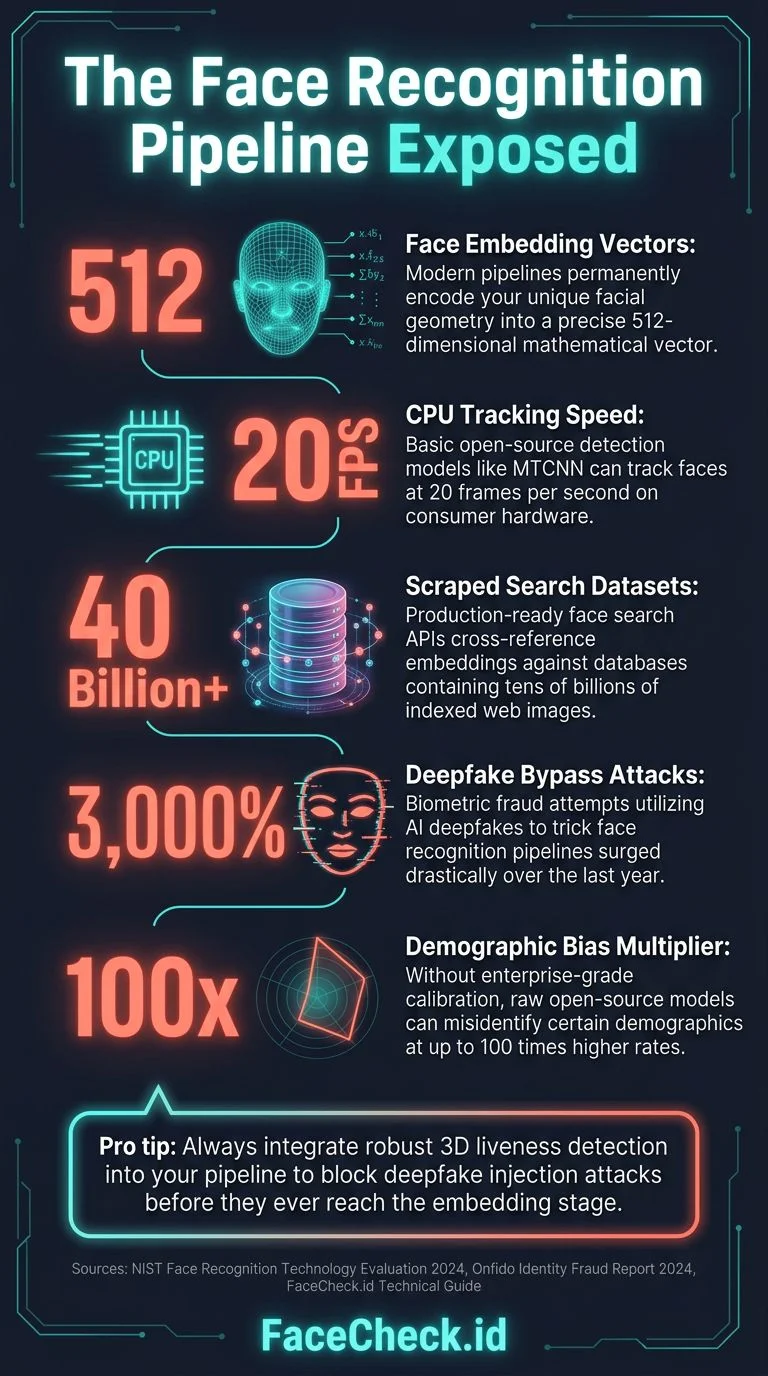
Se você está criando algo que precisa comparar rostos, verificar identidades por foto ou procurar um rosto em um conjunto de dados, precisa entender como o reconhecimento facial moderno realmente funciona nos bastidores. Não a versão de marketing. O pipeline real, desde os pixels brutos até um vetor de embedding de 512 dimensões que codifica a geometria facial única de uma pessoa.
Este artigo detalha todo o pipeline de reconhecimento facial, compara os melhores modelos de código aberto disponíveis em 2026, apresenta os números reais de desempenho e explica quando faz sentido criar seu próprio sistema em vez de usar uma API de produção.
Neste artigo, vamos discutir
- O pipeline de reconhecimento facial: quatro etapas
- Melhores modelos de reconhecimento facial de código aberto (2026)
- Tabela comparativa de desempenho
- A diferença entre modelos de código aberto e sistemas de produção
- Quando criar e quando usar uma API
- API de pesquisa facial FaceCheck.id
- Perguntas frequentes
O pipeline de reconhecimento facial: quatro etapas
Todo sistema moderno de reconhecimento facial segue o mesmo pipeline básico, independentemente de estar sendo executado em um Raspberry Pi de US$ 35 ou em um cluster de GPUs de uma agência governamental. Entender essas quatro etapas ajudará você a avaliar qualquer modelo ou API.
Etapa 1: detecção facial
Antes de reconhecer um rosto, você precisa encontrá-lo. A detecção facial recebe uma imagem e gera caixas delimitadoras ao redor de todos os rostos presentes. Parece simples, mas é aqui que muitos sistemas falham em produção.
Os modelos padrão:
- MTCNN (redes convolucionais em cascata multitarefa): O modelo mais confiável da detecção facial desde 2016. Cascata de três estágios: a Proposal Network (P-Net) encontra regiões candidatas, a Refine Network (R-Net) filtra falsos positivos e a Output Network (O-Net) refina as caixas delimitadoras e gera pontos de referência faciais. Continua sendo amplamente utilizado. É preciso em rostos de frente, mas tem dificuldades com ângulos extremos e oclusões. Executa a aproximadamente 20 FPS em uma CPU moderna.
- RetinaFace: Estado da arte em precisão de detecção. Detector de estágio único construído sobre uma arquitetura [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Retorna caixas delimitadoras e cinco pontos de referência faciais (olhos, nariz e cantos da boca). Lida bem com múltiplas escalas. É a escolha preferida quando a precisão importa mais do que a velocidade. Aproximadamente 15 FPS em GPU, mais lento em CPU.
- SCRFD (redistribuição de amostras e computação para detecção facial eficiente): O campeão de velocidade. Projetado para implantação em dispositivos móveis e de borda. Alcança precisão comparável à do RetinaFace com velocidade de 3 a 10 vezes maior. Vários tamanhos de modelo, de 0,5 milhão a 34 milhões de parâmetros. Se você está implantando em dispositivos móveis ou precisa de processamento em tempo real, é isso que procura.
- BlazeFace: A contribuição do Google, projetada para o [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Extremamente rápido (executa a mais de 200 FPS em GPUs móveis), mas sacrifica parte da precisão em ângulos difíceis. Bom para aplicações de vídeo em tempo real nas quais é necessário processar todos os quadros.
O que realmente importa na detecção: Os casos difíceis não são selfies com boa iluminação. São imagens de vigilância, fotos de grupo nas quais os rostos têm 50 pixels de largura, perfis laterais extremos e rostos parcialmente ocultos por óculos escuros ou máscaras. Seu modelo de detecção determina o limite máximo de todo o sistema. Se a detecção não encontrar um rosto, nada nas etapas seguintes poderá corrigir isso.
O problema de múltiplos rostos: Quando uma imagem contém vários rostos, você precisa decidir qual deles transformar em embedding. As estratégias incluem escolher o maior rosto, o rosto mais centralizado, aquele com a maior pontuação de qualidade ou transformar todos em embeddings e deixar a lógica posterior resolver. Cada escolha tem diferentes modos de falha. Gerar embeddings de todos os rostos em fotos de grupo incha o índice e cria resultados de pesquisa ambíguos; escolher apenas o maior rosto ignora a pessoa que está na última fileira. A maioria dos sistemas de produção gera embeddings de todos os rostos detectados acima de um limite mínimo de tamanho (normalmente entre 40 e 60 pixels entre os olhos) e os associa como entradas separadas vinculadas à mesma imagem de origem.
A pontuação de qualidade facial como mecanismo de controle: Executar um estimador de qualidade leve, como o SER-FIQ, ou o ramo de qualidade do MagFace antes de calcular embeddings dispendiosos impede que dados inúteis entrem no índice. Recortes desfocados, oclusões extremas e rostos superexpostos produzem embeddings de baixa confiança que contaminam os resultados da pesquisa. Rejeitar rostos abaixo de um limite de qualidade na etapa de detecção melhora drasticamente a precisão das etapas posteriores e economiza ciclos de GPU. Essa é uma das otimizações com maior retorno sobre o investimento em todo o pipeline.
Antispoofing facial para verificação: Em cenários de verificação, a detecção de ataques de apresentação (PAD) é fundamental. Impressões em papel, reproduções em telas e máscaras 3D podem enganar sistemas baseados em embeddings. Modelos como o CDCN ou o PatchNet detectam esses ataques, mas adicionam de 5 a 15 ms de latência por rosto e exigem manutenção adicional do modelo. Se você está criando algo em que o usuário controla a imagem de entrada — controle de acesso, KYC ou autenticação —, precisa incluir antispoofing, ou seu sistema será explorado.
Etapa 2: alinhamento facial
Depois de detectar um rosto, você precisa normalizá-lo. Diferentes poses da cabeça, ângulos de câmera e distâncias alteram a aparência de um rosto na imagem bruta. O alinhamento transforma cada rosto detectado em uma posição padronizada: olhos nivelados, rosto centralizado e escala consistente.
A abordagem padrão usa os cinco pontos de referência da detecção (olho esquerdo, olho direito, ponta do nariz, canto esquerdo da boca e canto direito da boca) para calcular uma transformação de similaridade. Isso mapeia o rosto detectado para um recorte canônico de 160x160 pixels, com os olhos em coordenadas fixas de pixels.
Essa etapa costuma ser ignorada em tutoriais, mas é fundamental. Um erro de rotação de 2 graus no alinhamento pode reduzir a precisão do reconhecimento entre 1% e 3%. A maioria dos pipelines de código aberto cuida disso automaticamente, mas, se você estiver criando uma solução personalizada, use a especificação de alinhamento do FaceNet (160x160, com coordenadas específicas para os olhos) como padrão. Foi com ela que a maioria dos modelos modernos foi treinada.
Sensibilidade do alinhamento à precisão dos pontos de referência: Os pontos de referência do RetinaFace apresentam, em média, um erro de aproximadamente 2 pixels. Esse erro se propaga pela transformação de alinhamento e pode causar uma degradação de precisão de 1% a 5%, especialmente em recortes faciais menores, nos quais 2 pixels representam uma proporção maior da largura total do rosto. Alguns sistemas de produção executam um refinamento secundário de 68 ou 98 pontos de referência, como o face-alignment, de Adrian Bulat, após a detecção inicial para obter um alinhamento mais preciso. Os 3 a 5 ms adicionais por rosto valem a pena quando seu caso de uso exige precisão máxima — especialmente na verificação 1:1, em que uma única decisão errada tem consequências.
Etapa 3: extração de características (embedding)
Este é o núcleo do reconhecimento facial. Uma rede neural profunda recebe a imagem facial alinhada e gera um vetor de comprimento fixo, normalmente com 512 dimensões, chamado embedding ou vetor de características. Esse vetor é uma representação numérica compacta das características únicas daquele rosto.
Dois rostos da mesma pessoa, independentemente da iluminação, expressão, idade — dentro do razoável — ou câmera, devem produzir embeddings próximos no espaço vetorial. Duas pessoas diferentes devem produzir embeddings distantes.
Como funciona tecnicamente:
A arquitetura da rede normalmente é uma Inception-ResNet ou ResNet modificada, treinada com milhões de imagens faciais. A principal inovação está na função de perda usada durante o treinamento, não na arquitetura em si.
- Perda softmax (a referência básica): Trata o reconhecimento facial como classificação. Funciona, mas produz embeddings que não ficam bem separados no espaço angular. Está praticamente obsoleta para reconhecimento.
- Perda triplet: A abordagem popularizada pelo FaceNet. A rede aprende comparando trios de rostos de referência/positivo/negativo, aproximando embeddings da mesma identidade e afastando embeddings de identidades diferentes. Exige uma seleção cuidadosa de trios difíceis durante o treinamento. Produz embeddings altamente discriminativos.
- Perda ArcFace: É, provavelmente, a função de perda mais utilizada em sistemas de reconhecimento facial em produção em 2026. Adiciona uma penalidade de margem angular aditiva no espaço angular entre o vetor de características e o peso da classe correspondente, produzindo agrupamentos intraclasse mais compactos e distâncias interclasses maiores do que abordagens de margem de cosseno. O projeto [InsightFace](https://github.com/deepinsight/insightface) fornece a implementação de referência, e a maioria dos modelos de última geração é treinada com ArcFace ou alguma de suas variantes — a margem adaptativa do AdaFace, por exemplo, é construída sobre a formulação do ArcFace. Se você está treinando ou fazendo o ajuste fino de seu próprio modelo de reconhecimento facial, o ArcFace é o ponto de partida padrão.
- Perda CosFace: Adiciona uma margem de cosseno à perda softmax, forçando a rede a produzir embeddings agrupados de forma mais compacta dentro de cada identidade e mais separados entre identidades.
- SphereFace / A-Softmax: A abordagem original de margem angular, de 2017. Historicamente importante, mas em grande parte substituída pelo ArcFace e por funções de perda mais modernas.
A saída: Um vetor de 512 números de ponto flutuante, normalizado por L2 para a hiperesfera unitária. Toda a informação sobre um rosto, compactada em 2 KB de dados. É isso que é armazenado, indexado e comparado.
A armadilha da normalização: Muitos desenvolvedores esquecem que os embeddings precisam ser normalizados por L2 antes da comparação. Embeddings não normalizados produzem pontuações de similaridade extremamente inconsistentes. Esse é um bug comum e difícil de diagnosticar porque “funciona na maior parte do tempo”: a ordem relativa das correspondências pode parecer correta nos testes, mas as pontuações absolutas de similaridade variam entre as imagens, tornando pouco confiáveis as decisões baseadas em limites. O FaceNet512 produz embeddings normalizados por padrão, mas, se você estiver usando um modelo personalizado ou exportando por meio do ONNX, sempre verifique se os embeddings de saída estão na hiperesfera unitária, isto é, se a norma L2 é igual a 1,0.
Implantação em produção: ONNX Runtime e quantização: Os números de velocidade dos benchmarks pressupõem inferência FP32 em uma GPU sem outras cargas. Em produção, a maioria dos sistemas é implantada por meio do ONNX Runtime com quantização INT8, o que reduz o tempo de inferência de duas a três vezes, com perda mínima de precisão — normalmente inferior a 0,1% no LFW. O fluxo de trabalho: exporte seu modelo PyTorch ou TensorFlow para ONNX, execute a ferramenta de quantização do ONNX Runtime com um conjunto de calibração de aproximadamente 1.000 imagens faciais e implante o modelo quantizado. É assim que você passa de “10 ms por rosto” para “3 a 4 ms por rosto” no mesmo hardware, algo extremamente importante quando se processam bilhões de imagens.
Inferência com precisão mista: Usar FP16 na GPU para a arquitetura principal, mas FP32 para a camada final de embedding, evita os problemas de precisão de ponto flutuante descritos posteriormente neste artigo, mantendo uma aceleração de 1,5 a 2 vezes. Esse é um meio-termo prático entre FP32 completo, que é preciso, mas lento, e FP16 completo, que é rápido, mas pode produzir embeddings sutilmente diferentes em hardwares distintos.
Destilação de embeddings para implantação na borda: Você pode treinar uma rede-aluna menor, como a MobileFaceNet, com aproximadamente 1 milhão de parâmetros, para imitar os embeddings do FaceNet512 por meio de destilação de conhecimento. O modelo-aluno obtém mais de 95% da precisão com velocidade 10 vezes maior, tornando-se viável para implantação em dispositivos móveis e de borda, nos quais não é possível usar uma GPU. O principal insight é que você não precisa treinar o modelo-aluno do zero com rótulos de identidade facial: basta treiná-lo para reproduzir os embeddings do modelo-professor em dados faciais não rotulados, o que exige muito menos processamento e dispensa um conjunto de dados rotulado por identidade.
Etapa 4: correspondência
Com dois embeddings faciais, como decidir se eles pertencem à mesma pessoa? Há duas abordagens:
Similaridade de cosseno: Calcula o cosseno do ângulo entre dois vetores de embedding. Intervalo: de -1 a 1, sendo que 1 significa idênticos. Um limite típico para “mesma pessoa” fica entre 0,4 e 0,6, dependendo do modelo e do caso de uso. É simples, rápido e funciona bem porque os embeddings do FaceNet512 são normalizados por L2.
Distância euclidiana: Calcula a distância L2 entre os vetores. Para embeddings normalizados, isso é matematicamente equivalente à similaridade de cosseno (d = sqrt(2 - 2*cos_sim)). Alguns sistemas preferem essa formulação.
Para pesquisa (correspondência 1:N): Quando você precisa encontrar um rosto em um banco de dados com milhões de registros, a comparação por força bruta é lenta demais. Use pesquisa aproximada de vizinhos mais próximos (ANN):
- FAISS (Facebook AI Similarity Search): A biblioteca padrão. Oferece aceleração por GPU e vários tipos de índice (IVF, HNSW, PQ). Pode pesquisar 1 bilhão de vetores em milissegundos. Gratuita e de código aberto.
- Milvus: Banco de dados vetorial criado especificamente para essa finalidade, com FAISS nos bastidores, além de persistência, escalabilidade e camadas de API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Opções gerenciadas de bancos de dados vetoriais para quem não quer operar a infraestrutura.
Para um banco de dados com 10 milhões de rostos, um índice HNSW do FAISS bem ajustado em uma única GPU pode retornar as 10 melhores correspondências em menos de 5 milissegundos.
A escolha do tipo de índice do FAISS faz uma diferença enorme. O IVF-PQ oferece excelente compactação — de 8 a 16 bytes por vetor, em vez de 2 KB —, mas perde precisão em correspondências limítrofes, nas quais o erro de quantização empurra uma correspondência verdadeira para abaixo do limite. O HNSW preserva a precisão, mas usa de quatro a oito vezes mais memória porque armazena os vetores completos de ponto flutuante e a estrutura do grafo. Índices híbridos IVF-HNSW oferecem o melhor equilíbrio para escalas de 10 milhões a 1 bilhão. A maioria das equipes escolhe inicialmente o tipo de índice errado, com base em recomendações de tutoriais, e precisa reconstruir toda a infraestrutura de indexação seis meses depois, quando encontra as limitações. Teste sua carga de trabalho específica com volumes de dados e padrões de consulta realistas antes de se comprometer com um tipo de índice.
O problema de inicialização dos índices ANN: Os índices HNSW e IVF precisam de um número mínimo de vetores para funcionar bem. Com menos de aproximadamente 10 mil vetores, a pesquisa por força bruta é, na verdade, mais rápida do que a pesquisa indexada, pois a sobrecarga do índice — percurso do grafo e comparação de centroides — domina o processamento. Comece com força bruta (FAISS IndexFlatIP) durante a fase inicial de crescimento e migre para um índice ANN quando seu banco de dados ultrapassar entre 50 mil e 100 mil vetores.
Pré-filtragem com códigos binários: Calcular um hash binário de cada embedding, por meio de binarização ou SimHash, permite executar uma pré-filtragem barata por distância de Hamming antes das dispendiosas comparações de ponto flutuante. Isso pode reduzir o conjunto de candidatos em mais de 90%, com perda mínima de recall. A ideia: armazene um código binário de 256 ou 512 bits junto a cada embedding completo. Para uma consulta, calcule primeiro a distância de Hamming em relação a todos os códigos binários — algo extremamente rápido com instruções POPCNT da CPU —, selecione os melhores 1% a 5% dos candidatos e só então calcule a similaridade exata de cosseno para eles. Essa abordagem em duas etapas é especialmente eficaz quando seu conjunto de dados excede a memória disponível na GPU.
Reordenação com atributos faciais: A pesquisa inicial de embeddings retorna candidatos; uma segunda passagem usando atributos estimados — faixa etária, gênero, tom de pele e pelos faciais — pode filtrar falsos positivos óbvios. Se o rosto da consulta for estimado como o de uma mulher de 25 anos e uma correspondência candidata for estimada como um homem de 60 anos, é quase certamente um falso positivo, independentemente da pontuação de similaridade do embedding. Essa heurística simples pode reduzir os falsos positivos entre 30% e 50%, com custo computacional mínimo, e é uma das técnicas menos utilizadas em pesquisas faciais em produção.
Consistência temporal em vídeo: Se você está comparando rostos de vídeos em vez de imagens estáticas, calcular a média dos embeddings de vários quadros do mesmo rosto rastreado melhora drasticamente a precisão — muitas vezes entre 5% e 10% em benchmarks difíceis. A agregação de embeddings por trajetória é estritamente superior à correspondência quadro a quadro. A abordagem: use um rastreador facial, como SORT ou DeepSORT, para vincular detecções entre quadros, calcule embeddings para cada detecção e agregue-os em um único “embedding de trajetória” usando uma média ponderada pela qualidade, em que o peso é a pontuação de qualidade facial da etapa de detecção.
Melhores modelos de reconhecimento facial de código aberto (2026)
FaceNet512
O padrão-ouro. O FaceNet512 é a variante de embeddings de 512 dimensões da arquitetura FaceNet, do Google, oferecendo um espaço de embeddings maior e mais discriminativo do que a versão original de 128 dimensões.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Arquitetura: Arquitetura principal Inception-ResNet-v2, que produz embeddings de 512 dimensões
- Licença: MIT (permissiva, permite uso comercial)
- Precisão no LFW: 99,65%
- Tamanho do embedding: 512 dimensões
- Inclui: Funciona com pipelines de detecção padrão (MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)) para reconhecimento completo de ponta a ponta
- API Python: Disponível por meio da biblioteca
deepfaceou de implementações independentes
Veredito: Se você está criando um sistema de reconhecimento facial em 2026, o FaceNet512 é um excelente ponto de partida. Ótima precisão, embeddings de 512 dimensões com elevado poder discriminativo, licença MIT permissiva e amplo suporte do ecossistema.
FaceNet (Google, versão original de 128 dimensões)
O modelo que popularizou a abordagem de embeddings em 2015. Introduziu o treinamento com perda triplet, no qual a rede aprende comparando trios de rostos de referência/positivo/negativo.
- Artigo original: “FaceNet: um embedding unificado para reconhecimento e agrupamento facial” (Schroff et al., 2015)
- Repositório: Várias implementações (davidsandberg/facenet é a versão clássica em TensorFlow)
- Licença: MIT
- Precisão no LFW: 99,63% (original), chegando a 99,75% com treinamento moderno
- Tamanho do embedding: 128 dimensões
- Arquitetura: Inception-ResNet-v1 ou Inception-ResNet-v2
Veredito: Historicamente importante e ainda funciona bem. O embedding de 128 dimensões é mais compacto, mas ligeiramente menos discriminativo do que a variante FaceNet512 de 512 dimensões. Use-o se precisar ocupar menos espaço com embeddings ou estiver trabalhando com TensorFlow sob restrições de memória.
DeepFace (Facebook/Meta)
Não confunda com a biblioteca Python deepface, escrita em minúsculas. O DeepFace da Meta, de 2014, foi uma das primeiras abordagens de aprendizagem profunda para reconhecimento facial, alcançando precisão próxima à humana no LFW.
O projeto mais relevante atualmente é a biblioteca Python deepface, de Serengil:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repositório: github.com/serengil/deepface
- Licença: MIT
- O que faz: Biblioteca de abstração que oferece uma API unificada para vários modelos de back-end: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib e SFace
- Inclui: Verificação, pesquisa e análise de atributos faciais (idade, gênero, raça e emoção)
- Facilidade de uso: API extremamente simples
Veredito: A melhor escolha para prototipagem e experimentação. A API unificada permite alternar entre modelos mudando um único parâmetro. Em produção, convém usar o FaceNet512 diretamente para obter melhor desempenho e controle.
dlib
A biblioteca C++ com bindings para Python, mantida por Davis King. Inclui um modelo de reconhecimento facial treinado com um conjunto de dados de 3 milhões de imagens.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repositório: github.com/davisking/dlib
- Licença: Boost Software License (permissiva)
- Precisão no LFW: 99,38%
- Tamanho do embedding: 128 dimensões
- Detecção: Baseada em HOG (rápida e adequada para CPU) e em CNN (mais precisa)
Veredito: C++ extremamente sólido e testado em produção, com bons bindings para Python. Tem precisão inferior à do FaceNet512, mas é extremamente confiável. Uma boa escolha se você trabalha em C++ ou precisa de uma solução leve sem dependências do PyTorch/ONNX.
AdaFace
Um modelo mais recente, de 2022, que aborda especificamente a variação da qualidade das imagens. Modelos padrão são treinados com imagens de alta qualidade e perdem desempenho em entradas de baixa resolução ou desfocadas. O AdaFace adapta sua penalidade de margem com base na qualidade da imagem durante o treinamento.
- Repositório: github.com/mk-minchul/AdaFace
- Licença: MIT
- Principal vantagem: Desempenho superior em imagens de baixa qualidade (vigilância e câmeras de longa distância)
- Precisão no LFW: 99,82%
- TAR@FAR=1e-4 no IJB-C: 97,39% (supera a maioria dos modelos de código aberto em benchmarks difíceis)
Veredito: Use-o quando as imagens de entrada tiverem baixa qualidade. Para vigilância, análise de CFTV ou qualquer cenário em que você não controle a qualidade da imagem, o AdaFace apresenta resultados mensuravelmente melhores do que modelos padrão.
Tabela comparativa de desempenho
| Modelo | LFW (%) | Embedding | Velocidade (ms/rosto) | Licença |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 dimensões | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 dimensões | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 dimensões | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 dimensões | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2.048 dimensões | ~15 ms (GPU) | CC BY-SA |
O LFW (Labeled Faces in the Wild) é o benchmark padrão, mas está essencialmente resolvido. Todos os modelos modernos obtêm mais de 99%. A verdadeira diferenciação aparece em benchmarks mais difíceis, como o IJB-C, com condições variadas, e o TinyFace, de baixa resolução.
Uma observação sobre benchmarks e realidade: Esses números de velocidade representam inferência FP32 em um único rosto, com a GPU já aquecida. Em produção, com quantização INT8 do ONNX Runtime, espere uma velocidade de duas a três vezes maior. Mas lembre-se também de que o pipeline completo — detecção + alinhamento + pontuação de qualidade + embedding — demora de três a cinco vezes mais do que apenas a extração do embedding. Uma taxa de processamento realista de ponta a ponta para o pipeline completo em uma única GPU A100 é de 200 a 400 rostos por segundo, e não os milhares que benchmarks exclusivos de embeddings podem sugerir.
A diferença entre modelos de código aberto e sistemas de produção
Aqui está o que os tutoriais não contam: executar um modelo de reconhecimento facial em um notebook Jupyter é a parte fácil. Criar um sistema de produção que realmente funcione em escala exige resolver uma longa lista de problemas de engenharia que nenhum modelo resolve por você. A maioria das equipes subestima drasticamente tanto o custo quanto o prazo. O que parece ser um projeto de “apenas conectar o modelo” transforma-se em um esforço de engenharia de 12 a 24 meses, que pode facilmente consumir entre US$ 500 mil e mais de US$ 2 milhões antes de estar pronto para produção — e isso antes dos custos operacionais contínuos.
A conta da infraestrutura
Processamento em GPU para extração de embeddings. Executar detecção facial e extração de embeddings em bilhões de imagens não é algo que se faça em um laptop. Uma única GPU NVIDIA A100 consegue processar aproximadamente de 200 a 400 rostos por segundo em um pipeline completo de detecção + alinhamento + embedding. Para processar 1 bilhão de imagens em um prazo razoável — digamos, menos de uma semana —, você precisa de um cluster com 40 a 80 GPUs funcionando continuamente. Pelos preços da nuvem, isso representa de US$ 50 mil a US$ 150 mil por passagem de processamento, e será necessário reprocessar os dados conforme o modelo for aprimorado ou o pipeline mudar. Comprar o hardware significa investir entre US$ 300 mil e US$ 800 mil em servidores com GPU, além de espaço em rack, energia, refrigeração e alguém para cuidar de tudo.
Armazenamento em escala. Um bilhão de embeddings faciais com 512 números de ponto flutuante — 2 KB cada — representa aproximadamente 2 TB somente de dados vetoriais. Adicione as imagens originais, miniaturas, metadados e estruturas de índice, e você terá de centenas de terabytes a alguns petabytes de armazenamento. O armazenamento NVMe de alto desempenho para índices vetoriais custa entre US$ 0,10 e US$ 0,25 por GB/mês na nuvem. Com 50 TB de armazenamento ativo, são de US$ 5 mil a US$ 12,5 mil por mês apenas para manter tudo funcionando.
Infraestrutura de pesquisa vetorial. O FAISS em uma única máquina atinge seu limite entre aproximadamente 100 milhões e 500 milhões de vetores, dependendo do tipo de índice e da RAM disponível. Acima disso, você precisa de pesquisa distribuída entre vários shards, com balanceamento de carga, replicação para tolerância a falhas e RAM suficiente para manter os índices. Uma implantação distribuída de nível de produção do FAISS ou do Milvus para mais de 1 bilhão de vetores normalmente exige de 8 a 16 máquinas com muita memória — pelo menos 256 GB de RAM cada —, custando entre US$ 15 mil e US$ 40 mil por mês em computação na nuvem.
Rede e largura de banda. Rastrear bilhões de imagens significa baixar petabytes de dados. Com custos de saída de dados entre US$ 0,05 e US$ 0,09 por GB nos principais provedores de nuvem, só a transferência pode custar dezenas de milhares de dólares. Você também precisa de uma rede interna de alta capacidade entre os crawlers, os nós de processamento por GPU e os back-ends de armazenamento.
Estimativa do custo total de infraestrutura para um mecanismo de pesquisa facial em escala da web: de US$ 30 mil a US$ 80 mil por mês em custos contínuos de nuvem, ou de US$ 500 mil a US$ 1,5 milhão em hardware inicial, mais de US$ 10 mil a US$ 20 mil por mês em energia, largura de banda e manutenção. E isso é apenas a infraestrutura, antes que um único engenheiro escreva uma linha de código da aplicação.
O cronograma de engenharia
Criar um sistema de pesquisa facial para produção não é um projeto de hackathon. Veja um cronograma realista para uma equipe de três a cinco engenheiros experientes:
Meses 1 a 3: pipeline principal. Fazer a detecção, o alinhamento e a extração de embeddings funcionarem de forma confiável. Criar o índice vetorial básico. Processar a ingestão de imagens de arquivos locais. Essa é a parte “divertida”, em que tudo parece correr bem e a demonstração impressiona.
Meses 3 a 6: infraestrutura de rastreamento da web. Criar scrapers para as principais plataformas. Lidar com limites de requisições, CAPTCHAs, barreiras de login, renderização dinâmica — sites com muito JavaScript —, desduplicação de imagens e filtragem de conteúdo. Descobrir que cada plataforma de mídia social tem medidas diferentes contra scraping, que quebram seus crawlers semanalmente. Criar monitoramento para detectar quando os crawlers falham silenciosamente. Só essa fase pode demorar mais do que o esperado porque a web é desorganizada e hostil.
Meses 6 a 9: escala e confiabilidade. Seu protótipo funcionou com 1 milhão de rostos. Agora faça-o funcionar com 100 milhões. Descubra que seu índice FAISS já não cabe na RAM. Implemente sharding. Corrija as condições de corrida no pipeline de ingestão. Crie lógica de repetição para os 15% de imagens cujo download falha. Lide com imagens corrompidas, imagens que afirmam ser JPEGs mas não são, imagens com sinalizadores de rotação EXIF e downloads truncados. Adicione monitoramento, alertas e logs para saber quando algo falhar às 3 horas da manhã.
Meses 9 a 12: qualidade e precisão. Perceba que sua taxa de falsos positivos em escala é inaceitável. Implemente pontuação de qualidade facial para filtrar embeddings inúteis. Ajuste os limites por caso de uso. Crie um mecanismo de feedback para que correspondências ruins possam ser sinalizadas e investigadas. Descubra que seu modelo produz resultados diferentes em arquiteturas de GPU distintas devido a diferenças na precisão de ponto flutuante e passe duas semanas investigando o problema.
Meses 12 a 18: preparação para produção. Crie uma camada de API com autenticação, limitação de requisições e acompanhamento de uso. Adicione recursos de conformidade com o GDPR/CCPA: mecanismos de exclusão voluntária, solicitações de eliminação de dados e registros de auditoria. Implemente cache de resultados. Crie ferramentas administrativas. Escreva a documentação. Passe pela auditoria de segurança. Faça testes de carga em tudo. Corrija os vazamentos de memória que você não sabia que existiam.
Meses 18 a 24: operações contínuas. Os crawlers quebram quando os sites mudam o layout. Os modelos sofrem desvio à medida que surgem novos tipos de imagem. Os discos ficam cheios. Os índices precisam ser reconstruídos. Os usuários relatam casos extremos que você nunca previu. Alguém descobre que seu sistema retorna correspondências confiantes para rostos de desenhos animados, e você precisa adicionar um filtro de “rosto real”. Isso nunca termina.
A lista completa de problemas que você encontrará
Além da infraestrutura e do cronograma, aqui estão todos os principais problemas enfrentados por equipes que criam sistemas de reconhecimento facial do zero. Esta lista vem de sistemas reais em produção, não de preocupações teóricas.
Pesadelos relacionados à qualidade dos dados:
- Dados ruins entram, resultados ruins saem. A internet está cheia de memes, rostos gerados por IA, desenhos, fotos de fotos, capas de revistas e estátuas. Seu detector encontrará “rostos” em tudo isso e produzirá embeddings que contaminarão seu índice. Você precisa de classificadores para filtrar rostos sintéticos, rostos ilustrados, recortes de resolução extremamente baixa e conteúdo não fotográfico. Criar e manter esses filtros é um projeto por si só.
- Imagens duplicadas e quase duplicadas. A mesma foto aparece em dezenas de sites, com diferentes recortes, marcas-d'água, níveis de compressão e ajustes de cor. Sem desduplicação, uma foto viral gera centenas de “correspondências” que são todas a mesma imagem, ocultando os resultados reais. O hash perceptual — pHash, dHash — ajuda, mas não é perfeito. Você precisa de desduplicação em vários níveis: por URL, que é trivial; por hash perceptual, que detecta cópias redimensionadas e recomprimidas; e por embedding, que detecta o mesmo rosto fotografado de ângulos ligeiramente diferentes. Cada nível encontra coisas que os outros não encontram, e você gastará mais tempo com desduplicação do que imagina.
- Mudanças de idade e aparência. O embedding facial da foto universitária de alguém talvez não corresponda a uma foto tirada 15 anos depois. Mudanças de peso, envelhecimento, cirurgia plástica, pelos faciais e penteados diferentes afetam a precisão do reconhecimento. Nenhum modelo lida perfeitamente com isso. Os usuários culparão seu sistema quando ele não conseguir encontrar a mesma pessoa em fotos separadas por 20 anos.
- Viés demográfico. Modelos de código aberto treinados predominantemente com conjuntos de dados ocidentais/caucasianos apresentam desempenho inferior em outros grupos demográficos. As diferenças de precisão entre etnias são maiores do que o LFW sugere — aproximadamente 77% do LFW é composto por pessoas caucasianas. Em uma implantação global, as diferenças de precisão entre grupos demográficos podem chegar a 5% a 15% em benchmarks difíceis. Modelos como o FaceNet512, treinados com o MS-Celeb-1M, herdam seu desequilíbrio demográfico. Fazer o ajuste fino com conjuntos de dados equilibrados, como o BUPT-Balancedface, ou usar estratégias de treinamento sensíveis à demografia é importante para obter desempenho equitativo. Se você não avaliar a precisão entre grupos raciais, poderá lançar um sistema que funciona bem para alguns usuários e mal para outros. Isso não é apenas uma questão ética, mas também um problema de qualidade do produto e de responsabilidade jurídica.
- Tratamento da orientação EXIF. Aproximadamente 15% a 20% das imagens na web têm tags de orientação EXIF que, se ignoradas, deixam os rostos de lado ou de cabeça para baixo. A maioria dos detectores faciais não encontra rostos rotacionados. Esse é um destruidor silencioso de precisão, fácil de ignorar em testes — nos quais você usa imagens orientadas corretamente —, mas devastador em produção. Sempre aplique a correção da orientação EXIF como a primeira etapa do pipeline de processamento de imagens.
- Falhas na decodificação de JPEG progressivo e WebP. Algumas bibliotecas de imagem produzem silenciosamente dados de pixels corrompidos a partir de JPEGs progressivos baixados parcialmente ou arquivos WebP truncados. O detector facial ainda pode encontrar um “rosto” nos artefatos da corrupção e produzir um embedding inútil. Você precisa validar a integridade da imagem — verificando se o arquivo é decodificado sem erros e se o buffer de pixels resultante tem dimensões razoáveis — antes do processamento. Sem isso, imagens corrompidas contaminam silenciosamente seu índice.
Problemas de engenharia que não são óbvios no início:
- Versionamento de embeddings. Quando você atualizar o modelo — e fará isso, porque melhorias de precisão importam —, todos os embeddings do banco de dados ficarão incompatíveis com a saída do novo modelo. Você pode gerar novamente os embeddings de todo o banco — algo caro, demorado e que exige conservar todas as imagens originais —, executar índices paralelos durante a migração — dobrando o custo de infraestrutura — ou manter compatibilidade retroativa — algo complexo que limita sua capacidade de melhorar. Não existe uma boa solução, apenas opções menos dolorosas.
- Determinismo de ponto flutuante. A mesma imagem processada em modelos de GPU diferentes, versões distintas do CUDA ou até mesmo com tamanhos de lote diferentes pode produzir embeddings ligeiramente distintos devido à aritmética de ponto flutuante. Essas diferenças são pequenas — de 1e-6 a 1e-4 —, mas se acumulam: uma correspondência que obtém 0,401 em uma máquina pode obter 0,399 em outra, invertendo uma decisão binária baseada em limite. Isso enlouquece você durante a depuração. Atualizações de drivers de GPU são especialmente perigosas: atualizações dos drivers NVIDIA podem mudar o comportamento de ponto flutuante no nível do CUDA. Um embedding calculado com o driver 535.x pode ser diferente para a mesma imagem no 545.x. Em produção, isso significa que você precisa fixar as versões dos drivers em toda a frota e validar a consistência dos embeddings após qualquer atualização.
- Concorrência e condições de corrida. Vários crawlers ingerindo rostos simultaneamente, usuários fazendo consultas enquanto o índice é atualizado, solicitações de exclusão chegando enquanto os resultados da pesquisa são montados. Bancos de dados vetoriais não têm o mesmo suporte maduro a transações que bancos SQL. Você encontrará situações em que um rosto é parcialmente indexado, consultas retornam resultados desatualizados ou uma exclusão não se propaga a todos os shards.
- Gerenciamento de memória. Os índices do FAISS são mapeados em memória, mas o desempenho das consultas depende muito de quanto do índice cabe na RAM. Conforme o índice cresce, a latência das consultas aumenta de forma imprevisível quando o sistema operacional remove páginas do índice da memória. Encerramentos por falta de memória acontecem no pior momento possível. Você conhecerá intimamente o gerenciamento de memória do Linux, as configurações de swap e a topologia [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). O aquecimento após inicializações a frio é outra dor de cabeça: os índices HNSW do FAISS são mapeados em memória, portanto, depois de reiniciar um servidor, as primeiras centenas de consultas ficam de 10 a 100 vezes mais lentas porque as páginas do índice ainda não foram carregadas na RAM. Você precisa de uma fase de aquecimento que pré-carregue o índice antes de aceitar tráfego de produção, ou os primeiros usuários após uma implantação enfrentarão uma latência terrível.
- Falhas silenciosas. Um crawler para de funcionar porque um site mudou o HTML. Seu nó de processamento por GPU começa a produzir embeddings NaN por causa de uma atualização de driver. Um disco fica cheio e novos rostos deixam silenciosamente de ser indexados. Essas falhas não geram erros; apenas degradam discretamente o sistema. Sem monitoramento abrangente e detecção de anomalias, você só saberá quando os usuários reclamarem.
- O problema de atualização do FAISS. Quando você adiciona novos embeddings a um índice IVF, as células de Voronoi ficam desequilibradas. A qualidade da pesquisa se deteriora gradualmente até que o quantizador seja treinado novamente. Em escala da web, o novo treinamento exige horas de GPU com todo o conjunto de dados. As equipes normalmente agrupam as adições e repetem o treinamento semanal ou mensalmente, o que significa que rostos recém-ingeridos não ficam imediatamente pesquisáveis com precisão total. Você está sempre trocando atualidade por qualidade da pesquisa, e não existe solução gratuita.
- Calibração de pontuações entre shards do índice. Quando o índice é dividido em shards distribuídos entre várias máquinas, as pontuações brutas de similaridade de shards diferentes não são diretamente comparáveis, pois cada shard tem uma distribuição de embeddings distinta. Você precisa normalizar as pontuações por shard — normalização por coorte, Z-norm, T-norm — para combinar os resultados de forma significativa. Sem calibração, uma pontuação de 0,45 no Shard A pode representar uma correspondência forte, enquanto 0,45 no Shard B representa uma correspondência mediana. Os resultados combinados deixam de ser confiáveis.
- O problema de fan-out na pesquisa distribuída. Pesquisar em N shards significa N viagens de ida e volta pela rede por consulta. Se algum shard estiver lento — pausa do coletor de lixo, pico de E/S de disco ou falha momentânea na rede —, toda a consulta ficará lenta. A latência P99 é determinada pelo P99 do shard mais lento e piora conforme você adiciona shards. Técnicas como requisições especulativas — enviar solicitações duplicadas e aceitar a que retornar primeiro — e tempos limite adaptativos são essenciais para manter uma latência de cauda aceitável.
Problemas de precisão e correspondência:
- O ajuste de limites nunca está “concluído”. O limite ideal de similaridade muda à medida que o banco de dados cresce. Com 1 milhão de rostos, um limite de 0,45 proporciona um bom equilíbrio entre precisão e recall. Com 100 milhões de rostos, esse mesmo limite produz dez vezes mais falsos positivos simplesmente porque há mais pessoas parecidas e quase correspondentes. Você precisa de limites adaptativos ou de uma reordenação posterior. A matemática subjacente é implacável: conforme o banco cresce de 1 milhão para 100 milhões e depois 1 bilhão de rostos, a distribuição das pontuações de similaridade top-k se desloca para cima porque existem mais pessoas parecidas. Um limite fixo que produz uma taxa de falsos positivos de 0,1% com 1 milhão de rostos pode produzir 10% com 1 bilhão. Você precisa modelar essa distribuição e ajustar os limites dinamicamente, ou aceitar que sua precisão se deteriorará com a escala.
- Reconhecimento de conjunto aberto versus conjunto fechado. A maioria dos benchmarks avalia o desempenho em conjunto fechado, no qual é garantido que a pessoa da consulta existe no banco de dados. A pesquisa facial do mundo real ocorre em conjunto aberto: o rosto consultado talvez nem exista no índice. A avaliação em conjunto aberto exige métricas totalmente diferentes — TPIR com FPIR fixo, em vez de precisão de rank 1 —, e o modo de falha são correspondências falsas, e não classificações erradas. Um sistema que obtém 99% em benchmarks de conjunto fechado pode apresentar uma taxa de falsas correspondências de 10% em uma implantação de conjunto aberto, pois retorna com confiança o rosto “mais próximo” mesmo quando a correspondência real não existe. Lidar corretamente com “nenhuma correspondência encontrada” é tão importante quanto encontrar correspondências corretas.
- Sósias e doppelgängers. Em um banco de dados com mais de 100 milhões de rostos, há muitos pares de pessoas sem parentesco cujos embeddings são surpreendentemente próximos. Quanto maior o banco, mais correspondências falsas aparecerão. Os usuários relatarão regularmente resultados de “pessoa errada”. Você precisa de uma estratégia para lidar com isso: verificação por várias fotos, sinais contextuais — nome e localização — e filas de revisão humana.
- O reconhecimento invariável à pose continua difícil. Até mesmo o FaceNet512 perde desempenho significativamente acima ou abaixo de 60 graus de rotação horizontal. A precisão ao comparar perfil e frente pode cair entre 10% e 20% em relação à comparação entre dois rostos frontais. Em cenários de vigilância, a maioria dos rostos aparece em ângulos oblíquos, o que significa que sua precisão real será substancialmente menor do que os benchmarks sugerem. Modelos treinados com aumento de dados consciente de 3D ou arquiteturas como UV-GAN ajudam, mas aumentam a complexidade. Se seus dados de entrada contêm muitos rostos em ângulos oblíquos, trate isso como uma preocupação central de precisão, não como um caso extremo.
- Entradas adversariais. Os usuários enviarão rostos gerados por IA, deepfakes, imagens mescladas e fotos com perturbações deliberadas. Alguns estarão testando o sistema; outros tentarão manipular os resultados. Seu sistema precisa ter alguma robustez contra essas entradas, ou retornará correspondências confiantes para rostos falsos.
- Manipulação de fotos. Filtros, aplicativos de beleza, maquiagem pesada e softwares de retoque facial. A realidade do Instagram em comparação com a realidade propriamente dita. Essas modificações alteram a geometria facial o suficiente para afetar a similaridade dos embeddings. Uma selfie com muitos filtros talvez não corresponda à foto sem filtros da mesma pessoa.
- Um rosto, muitos embeddings. Uma única pessoa pode ter centenas de fotos on-line em diferentes plataformas, ângulos e anos. Você retorna todas elas como correspondências separadas ou as agrupa em uma única identidade? O agrupamento em escala — centenas de milhões de rostos — é computacionalmente caro e introduz seus próprios modos de falha: agrupamento excessivo, que combina duas pessoas diferentes, e agrupamento insuficiente, que não conecta fotos da mesma pessoa.
Dores de cabeça operacionais:
- Corrida armamentista contra scraping. Todas as principais plataformas de mídia social bloqueiam ativamente os scrapers. Elas mudam estruturas de páginas, adicionam CAPTCHAs, detectam navegadores sem interface gráfica, limitam requisições por IP, identificam padrões de solicitações e, às vezes, apresentam conteúdo falso. Sua infraestrutura de rastreamento vive em uma corrida armamentista constante. Um scraper que funciona hoje pode ser totalmente bloqueado na próxima semana. Manter crawlers é um custo contínuo de engenharia, não um trabalho pontual.
- Modelagem da taxa de mudança. Diferentes fontes são atualizadas em ritmos distintos. Sites de notícias sobre celebridades recebem novas fotos a cada hora; perfis pessoais em redes sociais podem permanecer inalterados por anos. Um agendamento inteligente de novos rastreamentos com base nas taxas históricas de mudança pode reduzir os custos de largura de banda entre 60% e 80%, mantendo o índice mais atualizado onde isso importa. Sem isso, você rastreará excessivamente fontes estáticas — desperdiçando largura de banda e dinheiro — ou rastreará pouco as fontes dinâmicas — fornecendo resultados desatualizados.
- CDN e variação geográfica do conteúdo. A mesma URL pode fornecer imagens diferentes de acordo com a localização do solicitante, o user-agent do dispositivo ou os cookies. Seu crawler pode indexar uma imagem diferente da que o usuário vê, levando a relatos confusos de que “a correspondência não se parece com o resultado”. Algumas CDNs apresentam imagens provisórias de baixa resolução até que um navegador real role a página e coloque a imagem na área visível. Você precisa lidar com esses casos extremos ou aceitar certa porcentagem de resultados fantasma.
- Crescimento dos custos de armazenamento. O armazenamento de imagens cresce linearmente e nunca para. Você não pode excluir os originais se talvez precise gerar novos embeddings. Miniaturas, metadados, vetores de embedding, arquivos de índice e cópias de backup. A conta de armazenamento acelera conforme o sistema amadurece. Equipes que planejaram o orçamento de armazenamento para o primeiro ano ficam chocadas com os custos do terceiro.
- Solicitações de conformidade em escala. O GDPR concede às pessoas o direito de solicitar a exclusão de seus dados. Quando alguém envia uma solicitação de exclusão voluntária, você precisa: encontrar todos os embeddings gerados a partir do rosto da pessoa em todo o banco de dados, excluí-los, garantir que não sejam adicionados novamente quando os crawlers encontrarem as imagens originais e documentar a exclusão para fins de auditoria. Em escala, isso exige ferramentas dedicadas e esforço de engenharia. O [Regulamento Europeu de Inteligência Artificial](https://artificialintelligenceact.eu/) acrescenta outros requisitos para sistemas de IA de alto risco, incluindo reconhecimento facial: avaliações obrigatórias de conformidade, testes de viés, obrigações de transparência e mecanismos de supervisão humana.
- Implementar a exclusão voluntária é mais difícil do que parece. Você não pode simplesmente excluir um embedding; precisa impedir que ele seja indexado novamente quando o crawler encontrar o mesmo rosto. Isso exige manter um índice de “bloqueio” com os embeddings faciais de pessoas que optaram pela exclusão e comparar cada novo embedding com ele antes de indexar. Essa lista de bloqueio precisa ser rápida — é consultada em cada inserção — e levanta suas próprias questões de retenção de dados: você precisa armazenar permanentemente o embedding facial da pessoa que solicitou exclusão para poder compará-lo, o que significa reter dados biométricos para cumprir uma solicitação de exclusão. Essa tensão jurídica é real e continua sem solução em muitas jurisdições.
- O problema do consentimento para dados rastreados publicamente. A base legal do GDPR para processar dados biométricos provenientes de perfis públicos em redes sociais é juridicamente contestada. Várias autoridades de proteção de dados da UE decidiram contra empresas de reconhecimento facial — com destaque para as decisões sobre a Clearview AI em vários Estados-membros da UE. Seu risco jurídico depende da jurisdição, da fonte dos dados e do caso de uso. Isso não é uma preocupação futura hipotética: é uma área de fiscalização ativa.
- Custos de armazenamento da trilha de auditoria. Se você registrar cada consulta e cada correspondência retornada — algo que a conformidade pode exigir —, os logs de auditoria poderão crescer mais rapidamente do que os próprios dados faciais. Um sistema que processa 1 milhão de pesquisas por dia, com 10 resultados cada, gera aproximadamente 10 milhões de registros de auditoria diariamente. Requisitos de retenção — muitas vezes de 1 a 7 anos, dependendo da jurisdição — fazem esses dados crescerem sem parar. Planeje o armazenamento de auditoria como um centro de custos principal, não como uma reflexão tardia.
- Resposta a incidentes. O que acontece quando seu sistema associa incorretamente um rosto e alguém toma uma decisão com base nessa correspondência falsa? Você precisa de trilhas de auditoria que mostrem como cada resultado foi gerado, da capacidade de explicar as decisões de correspondência e de um processo para lidar com contestações. Quando alguém questiona uma correspondência, dizer “a similaridade de cosseno foi de 0,47, superando nosso limite de 0,42” não é uma explicação satisfatória. Técnicas como o GradCAM podem mostrar quais regiões faciais determinaram a correspondência, o que ajuda a resolver disputas e aumenta a confiança. Isso não é apenas uma boa prática de engenharia; pode ser uma exigência legal, dependendo da jurisdição.
- Deterioração de modelos e dependências. Versões do CUDA, do Python, do [ONNX Runtime](https://onnxruntime.ai/) e atualizações do sistema operacional mudam ao longo do tempo e podem quebrar sutilmente seu pipeline de inferência. Fixar versões ajuda até que você precise de uma correção de segurança. Você gastará uma quantidade surpreendente de tempo gerenciando dependências e reproduzindo ambientes.
- Concentração do conhecimento na equipe. O engenheiro que criou a camada de indexação do FAISS entende a lógica de sharding. O engenheiro que ajustou os crawlers sabe quais sites exigem tratamento especial. Quando essas pessoas saírem — e, em um projeto de 18 a 24 meses, há rotatividade —, conhecimentos essenciais irão embora com elas. A documentação ajuda, mas nunca captura totalmente o “porquê” das decisões menos óbvias.
Resumo do custo real
Para um sistema de pesquisa facial em escala da web que pesquisa na internet pública:
- Equipe de engenharia: 3 a 5 engenheiros seniores durante 12 a 24 meses = de US$ 600 mil a US$ 2,5 milhões em salários e despesas indiretas
- Infraestrutura (primeiro ano): de US$ 400 mil a US$ 1 milhão em custos de nuvem ou hardware
- Infraestrutura (contínua): de US$ 30 mil a US$ 80 mil por mês (de US$ 360 mil a US$ 960 mil por ano)
- Jurídico e conformidade: de US$ 50 mil a US$ 200 mil para a avaliação inicial, além de assessoria contínua
- Total no primeiro ano: de US$ 1,4 milhão a US$ 3,7 milhões
- Total a partir do segundo ano: de US$ 500 mil a US$ 1,2 milhão por ano em infraestrutura + manutenção de engenharia
E isso é para um sistema que funciona. Muitas equipes gastam de 6 a 12 meses e mais de US$ 500 mil antes de perceber que o problema é mais difícil do que estimaram e migrar para uma solução por API.
Quando criar e quando usar uma API
Crie seu próprio sistema quando:
- Você tiver um conjunto de dados fechado — crachás de funcionários ou fotos de clientes — com menos de 100 mil rostos
- Precisar que o sistema seja executado localmente ou isolado da rede
- Tiver engenheiros de aprendizagem de máquina capazes de cuidar da otimização de modelos, do ajuste de limites e dos casos extremos
- Seu caso de uso for verificação (1: 1), em vez de pesquisa (1:N na web)
- Você tiver orçamento e prazo para se comprometer com um projeto de engenharia de vários anos
Use uma API quando:
- Precisar pesquisar rostos na internet pública — redes sociais, notícias e web
- Não quiser criar e manter um pipeline de scraping e indexação da web
- Precisar de resultados agora, não depois de 12 a 24 meses de engenharia
- Precisar que o sistema acompanhe os novos conteúdos publicados on-line
- Quiser que outra empresa cuide da conformidade com o GDPR, das solicitações de exclusão voluntária e do Regulamento Europeu de Inteligência Artificial
- Quiser evitar mais de US$ 1 milhão em custos iniciais de infraestrutura e engenharia
- A pesquisa facial não for o produto principal, e o tempo de engenharia puder ser melhor aproveitado no produto propriamente dito
API de pesquisa facial FaceCheck.id
Para desenvolvedores que precisam pesquisar rostos na web pública sem criar toda a infraestrutura do zero, a FaceCheck.id oferece uma API REST que cuida de todo o pipeline: detecção, embedding e pesquisa em um índice continuamente atualizado de imagens faciais disponíveis publicamente em redes sociais, sites de notícias e na web em geral.
A FaceCheck.id usa um modelo proprietário de reconhecimento facial otimizado para pesquisas em escala da web. Ao contrário dos modelos de código aberto, que você precisaria implantar e ajustar por conta própria, o modelo proprietário da empresa é treinado e refinado especificamente para os desafios da pesquisa facial na internet: lidar com uma enorme variação na qualidade das imagens, diversas condições de iluminação, diversidade demográfica e a enorme escala de seu índice continuamente rastreado. Essa abordagem proprietária permite que a empresa aperfeiçoe de forma independente o desempenho do modelo e o otimize para seu pipeline específico de pesquisa de maneiras que modelos de código aberto de uso geral não conseguem. Anos de engenharia, testes e refinamento foram investidos para que o sistema funcionasse em um nível que seria extremamente difícil e caro reproduzir do zero.
O que a API faz:
Você envia uma imagem facial, e a API retorna rostos correspondentes encontrados na internet, com pontuações de confiança e URLs das fontes. A correspondência, a indexação e a infraestrutura em escala da web são gerenciadas pela empresa. Todos os clusters de GPU, pipelines de rastreamento, infraestrutura de pesquisa vetorial, ferramentas de conformidade e manutenção contínua descritos acima são problema dela, não seu.
Noções básicas da API:
- API JSON RESTful
- Autenticação por chave de API
- Envie uma imagem codificada em base64 ou uma URL de imagem
- Retorna: uma matriz de correspondências com pontuações de similaridade, URLs de origem e prévias em miniatura
- Os limites de requisições e preços variam de acordo com o uso
Integração típica:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Casos de uso da API:
- Verificação em aplicativos de namoro: Permita que os usuários verifiquem se as fotos de uma pessoa aparecem em perfis reais de redes sociais
- Proteção de marca: Verifique se alguém está usando fotos de sua equipe em perfis empresariais falsos
- Plataformas de diligência prévia: Adicione pesquisa facial a fluxos de verificação de antecedentes ou KYC
- Sistemas antifraude: Sinalize contas que usam fotos encontradas em outros lugares da internet com nomes diferentes
- Ferramentas OSINT: Crie ferramentas de investigação que incluam correspondência facial em escala da web
Por que usar isso em vez de criar sua própria solução:
Criar um mecanismo de pesquisa facial que pesquise na web pública exige: (1) um pipeline de rastreamento em escala da web que descubra e baixe bilhões de imagens, (2) infraestrutura de GPU que custa centenas de milhares de dólares para executar detecção facial e extração de embeddings, (3) um sistema distribuído de pesquisa vetorial com terabytes de RAM para consultar todo o índice em tempo real, (4) novos rastreamentos contínuos para manter o índice atualizado, (5) infraestrutura de conformidade para exclusões voluntárias, solicitações de eliminação de dados e exigências regulatórias, (6) uma equipe de três a cinco engenheiros dedicados em tempo integral à manutenção e (7) de 12 a 24 meses até o lançamento da primeira versão utilizável. Esse é um projeto de engenharia de vários milhões de dólares, com custos contínuos significativos. A API, impulsionada pelo modelo proprietário e pela infraestrutura comprovada da FaceCheck.id, oferece tudo isso com uma única chamada HTTP.
Os modelos de código aberto apresentados acima são excelentes para criar sistemas fechados de reconhecimento facial — controle de acesso de funcionários, organização de bibliotecas de fotos e fluxos personalizados de verificação. Mas, se seu caso de uso for “pesquisar na internet onde este rosto aparece”, a diferença de engenharia entre um modelo funcional e um produto funcional é enorme. A API FaceCheck.id preenche essa lacuna, permitindo que você lance um produto funcional em dias, em vez de anos.
Comece agora: Acesse facecheck.id/en/Face-Search/API para consultar a documentação, os preços e o cadastro da chave de API.
Perguntas frequentes
Qual modelo de reconhecimento facial de código aberto é o mais preciso?
O FaceNet512, com arquitetura principal Inception-ResNet-v2, atualmente obtém excelentes resultados na maioria dos benchmarks, com 99,65% no LFW. Para cenários com imagens de baixa qualidade — vigilância e CFTV —, o AdaFace apresenta melhor desempenho em benchmarks difíceis, como o IJB-C, com TAR@FAR=1e-4 de 97,39%.
Posso usar comercialmente modelos de reconhecimento facial de código aberto?
Sim. FaceNet512, FaceNet, DeepFace, dlib e AdaFace são todos disponibilizados sob licenças permissivas — MIT ou Boost. Você pode usá-los em produtos comerciais. No entanto, esteja ciente das restrições legais ao processamento de dados biométricos em sua jurisdição — GDPR, BIPA e Regulamento Europeu de Inteligência Artificial —, que se aplicam independentemente da licença do software.
De quantos dados preciso para treinar meu próprio modelo de reconhecimento facial?
Você não precisa treinar do zero. Os modelos pré-treinados listados acima foram treinados em conjuntos de dados com 5 a 12 milhões de imagens de 100 mil a 500 mil identidades. Use esses modelos pré-treinados e só faça o ajuste fino se tiver uma necessidade específica do seu domínio. O ajuste fino normalmente exige entre 10 mil e 100 mil imagens. Treinar do zero requer milhões de imagens e recursos significativos de GPU.
Qual é a diferença entre verificação facial e pesquisa facial?
A verificação facial (1:1) responde à pergunta “essas duas fotos são da mesma pessoa?” comparando diretamente dois embeddings. A pesquisa facial (1:N) responde “onde esta pessoa aparece?” comparando um embedding com um banco de dados de milhões. A verificação é computacionalmente simples. A pesquisa exige uma indexação eficiente de vizinhos mais próximos — FAISS, Milvus — e, para pesquisas em escala da web, uma enorme infraestrutura de rastreamento e indexação que pode custar milhões para ser criada e operada.
Qual é a precisão do reconhecimento facial em imagens de baixa qualidade?
A precisão cai significativamente com a qualidade da imagem. Em fotos nítidas e frontais, os modelos modernos alcançam mais de 99% de precisão. Em imagens desfocadas de vigilância ou fotos nas quais o rosto tem menos de 50 pixels de largura, a precisão pode cair para entre 80% e 90% ou menos. O AdaFace foi projetado especificamente para lidar melhor com variações de qualidade do que modelos padrão. Em qualquer sistema, imagens de entrada com maior resolução produzem resultados drasticamente melhores. A pose também importa: a precisão em rostos de perfil — vistos de lado — pode cair entre 10% e 20% em comparação com rostos frontais, mesmo em imagens de alta resolução.
Quanto custa criar um mecanismo de pesquisa facial?
Para um sistema em escala da web que pesquisa na internet pública: espere custos entre US$ 1,4 milhão e US$ 3,7 milhões no primeiro ano — equipe de engenharia + infraestrutura + jurídico — e entre US$ 500 mil e US$ 1,2 milhão por ano em custos contínuos depois disso. Para um sistema fechado que pesquisa um banco de dados privado com menos de 100 mil rostos, os custos são drasticamente menores: um único servidor com GPU e um engenheiro dão conta. O custo aumenta de acordo com o tamanho do banco de dados de pesquisa e com a necessidade ou não de rastrear a web para preenchê-lo.
Quanto tempo leva para criar um sistema de reconhecimento facial para produção?
Para um sistema simples de verificação — correspondência 1:1 em um banco de dados conhecido —, um engenheiro experiente pode criar um protótipo funcional em uma ou duas semanas e deixá-lo pronto para produção entre um e três meses. Para um sistema de pesquisa facial em escala da web — 1:N na internet —, espere de 12 a 24 meses com uma equipe de três a cinco engenheiros antes de ter algo confiável o suficiente para produção. Os desafios de rastreamento, escalabilidade e conformidade acrescentam um tempo enorme além do trabalho central de aprendizagem de máquina.
Crie algo que importe. Comece com o FaceNet512 para seu sistema fechado. Mas, se você precisa de pesquisa facial em escala da web, pergunte a si mesmo: você realmente quer gastar entre US$ 1,4 milhão e US$ 3,7 milhões, contratar uma equipe de engenheiros seniores e esperar de 12 a 24 meses até obter o primeiro resultado utilizável? Em vez disso, você pode evitar completamente os clusters de GPU, os pesadelos do rastreamento, as dores de cabeça com conformidade e os anos de engenharia, obtendo os primeiros resultados de pesquisa em menos de 5 minutos, a partir de apenas US$ 1, com a API FaceCheck.id.
Leia mais sobre Pesquisa por Selfie
Nova ferramenta de busca por rosto para jornalistas investigativos
Identificar rostos em imagens e vídeos pode ser a chave para desvendar crimes, corrupção e fraudes. Jornalistas investigativos enfrentam o desafio de analisar milhares de arquivos visuais na mão, um processo demorado e cheio de chances de erro. Veja como a tecnologia de reconhecimento facial está transformando investigações complexas.
Sobre o assunto em outras línguas
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Tópicos populares
Deepfake Identidade Mídia Social Reconhecimento Facial Facebook Instagram Identificação Pesquisa Facial Inteligência Artificial Contas Falsas Doppelgänger BiométricoMelhores Alternativas ao PimEyes para Pesquisa de Imagem Reversa: Nossas Principais Escolhas