Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
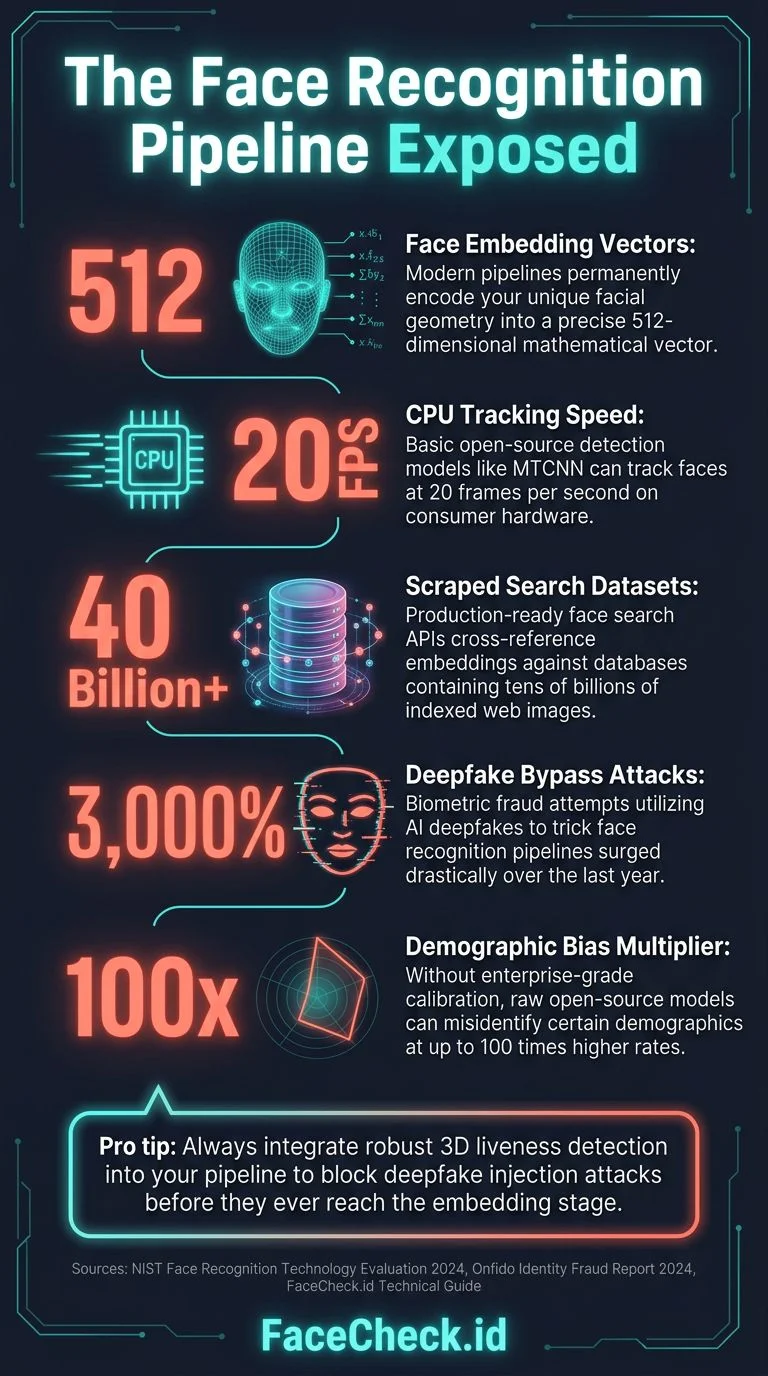
Jeśli tworzysz rozwiązanie, które musi dopasowywać twarze, weryfikować tożsamość na podstawie zdjęcia lub wyszukiwać twarz w zbiorze danych, musisz zrozumieć, jak współczesne rozpoznawanie twarzy naprawdę działa od środka. Nie chodzi o wersję marketingową, lecz o rzeczywisty potok przetwarzania — od surowych pikseli po 512-wymiarowy wektor osadzenia, który koduje unikalną geometrię twarzy danej osoby.
W tym artykule omawiamy cały potok rozpoznawania twarzy, porównujemy najlepsze modele open source dostępne w 2026 roku, przedstawiamy rzeczywiste wyniki wydajności i wyjaśniamy, kiedy warto zbudować własny system, a kiedy skorzystać z produkcyjnego API.
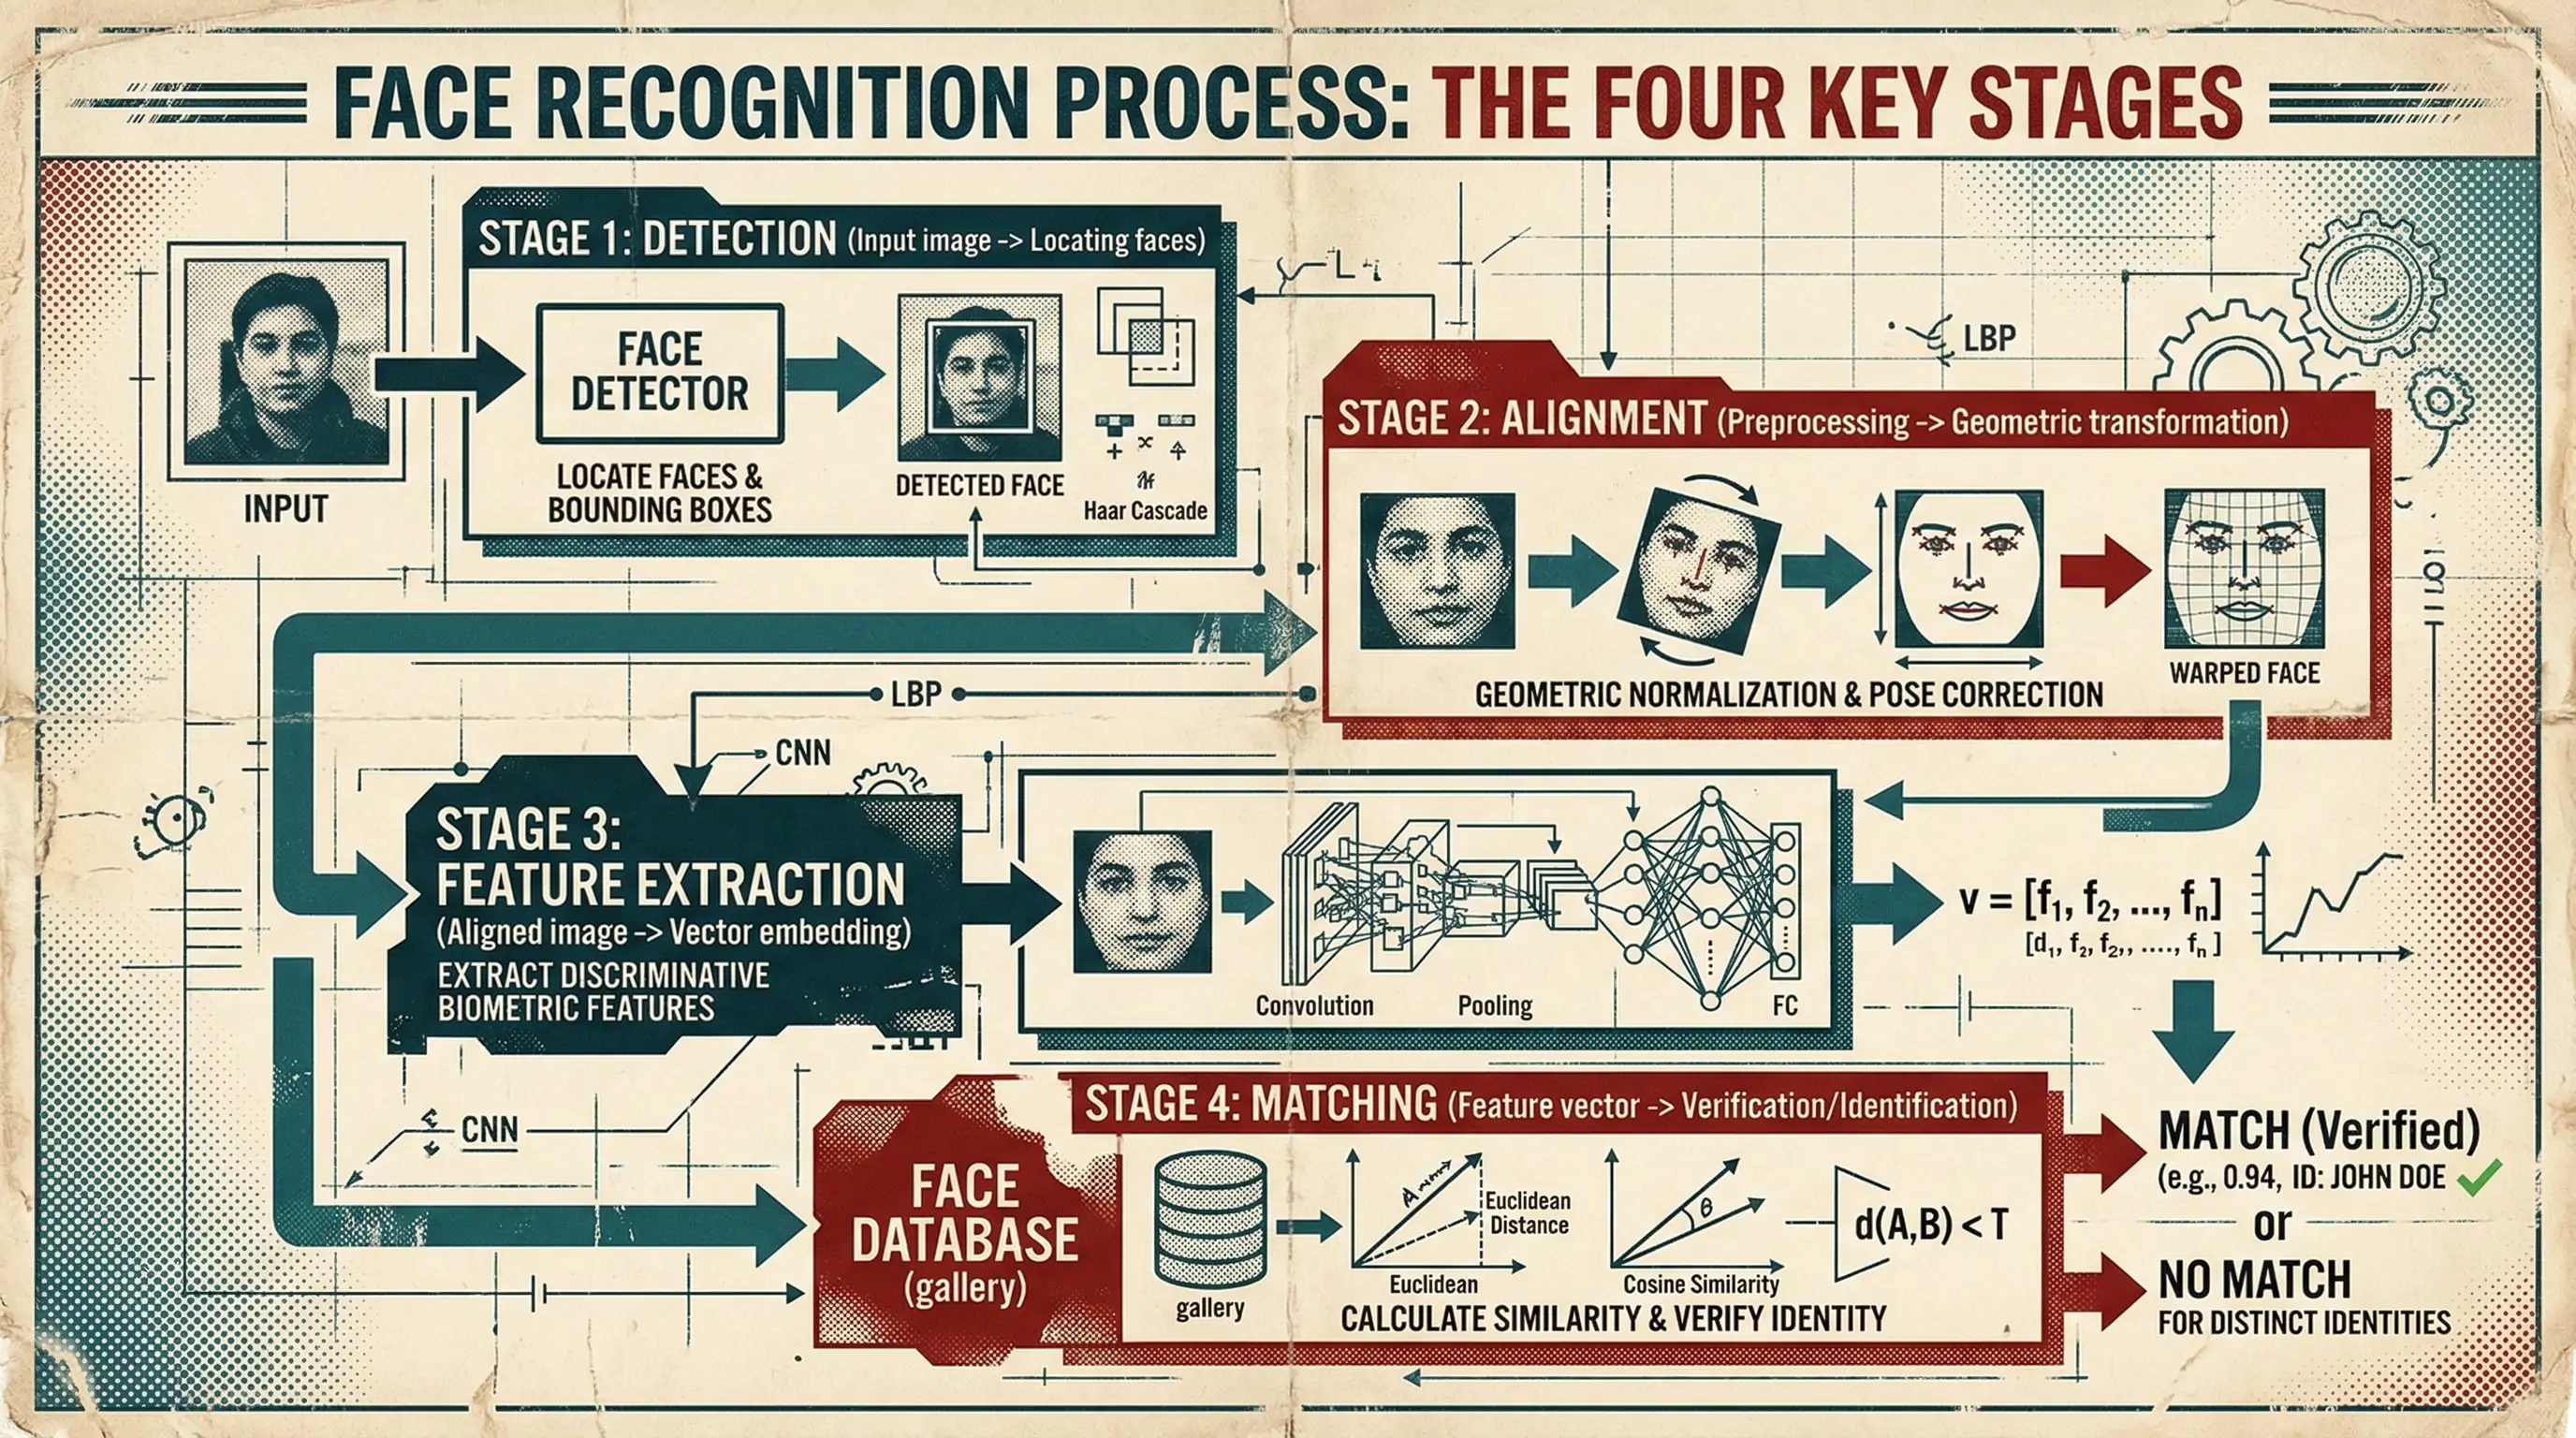
W tym artykule będziemy dyskutować
Potok rozpoznawania twarzy: cztery etapy
Każdy współczesny system rozpoznawania twarzy korzysta z tego samego podstawowego potoku, niezależnie od tego, czy działa na Raspberry Pi za 35 USD, czy w klastrze GPU należącym do agencji rządowej. Zrozumienie tych czterech etapów pomoże Ci ocenić dowolny model lub API.
Etap 1: wykrywanie twarzy
Zanim będzie można rozpoznać twarz, trzeba ją znaleźć. Mechanizm wykrywania twarzy przyjmuje obraz i zwraca prostokąty ograniczające wokół każdej obecnej na nim twarzy. Brzmi to prosto, ale właśnie na tym etapie wiele systemów zawodzi w środowisku produkcyjnym.
Standardowe modele:
- MTCNN (wielozadaniowe kaskadowe sieci konwolucyjne): Podstawowe narzędzie do wykrywania twarzy od 2016 roku. Trzystopniowa kaskada: Proposal Network (P-Net) znajduje obszary kandydujące, Refine Network (R-Net) odfiltrowuje wyniki fałszywie dodatnie, a Output Network (O-Net) doprecyzowuje prostokąty ograniczające i zwraca punkty charakterystyczne twarzy. Nadal jest szeroko stosowany. Dokładny w przypadku twarzy widzianych od przodu, ale gorzej radzi sobie z ekstremalnymi kątami i zasłonięciami. Na nowoczesnym procesorze działa z szybkością około 20 kl./s.
- RetinaFace: Najnowocześniejsze rozwiązanie pod względem dokładności wykrywania. Jednoetapowy detektor zbudowany na szkielecie [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Zwraca prostokąty ograniczające oraz pięć punktów charakterystycznych twarzy (oczy, nos i kąciki ust). Dobrze radzi sobie z różnymi skalami. To domyślny wybór, jeśli dokładność jest ważniejsza niż szybkość. Około 15 kl./s na GPU, wolniej na CPU.
- SCRFD (redystrybucja próbek i obliczeń na potrzeby wydajnego wykrywania twarzy): Mistrz szybkości. Zaprojektowany z myślą o urządzeniach mobilnych i brzegowych. Osiąga dokładność na poziomie RetinaFace przy szybkości większej od 3 do 10 razy. Dostępne są modele o różnych rozmiarach, od 0,5 mln do 34 mln parametrów. Jeśli wdrażasz rozwiązanie mobilne lub potrzebujesz przetwarzania w czasie rzeczywistym, właśnie tego modelu szukasz.
- BlazeFace: Rozwiązanie Google zaprojektowane dla platformy [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Jest wyjątkowo szybkie — na mobilnych GPU osiąga ponad 200 kl./s — ale kosztem części dokładności przy trudnych kątach. Dobrze nadaje się do aplikacji wideo działających w czasie rzeczywistym, w których trzeba przetworzyć każdą klatkę.
Co naprawdę ma znaczenie podczas wykrywania: Trudnymi przypadkami nie są selfie wykonane przy dobrym oświetleniu. Są nimi nagrania z monitoringu, zdjęcia grupowe, na których twarze mają szerokość 50 pikseli, skrajne profile boczne oraz twarze częściowo zasłonięte okularami przeciwsłonecznymi lub maseczkami. Model wykrywania wyznacza górną granicę możliwości całego systemu. Jeśli mechanizm wykrywania pominie twarz, żaden późniejszy etap tego nie naprawi.
Problem wielu twarzy: Gdy obraz zawiera wiele twarzy, trzeba zdecydować, dla której z nich utworzyć osadzenie. Strategie obejmują wybór największej twarzy, twarzy położonej najbliżej środka, twarzy z najwyższą oceną jakości albo utworzenie osadzeń dla wszystkich twarzy i pozostawienie rozstrzygnięcia dalszej logice. Każdy wybór wiąże się z innymi rodzajami błędów. Tworzenie osadzeń dla wszystkich twarzy na zdjęciach grupowych powoduje rozrost indeksu i niejednoznaczne wyniki wyszukiwania, natomiast wybór wyłącznie największej twarzy może pominąć osobę stojącą w tylnym rzędzie. Większość systemów produkcyjnych tworzy osadzenia dla wszystkich wykrytych twarzy przekraczających minimalny próg rozmiaru — zwykle 40–60 pikseli między oczami — i zapisuje je jako osobne wpisy powiązane z tym samym obrazem źródłowym.
Ocena jakości twarzy jako mechanizm kontrolny: Uruchomienie lekkiego estymatora jakości, takiego jak SER-FIQ, lub modułu jakości z modelu MagFace przed obliczaniem kosztownych osadzeń zapobiega trafianiu bezwartościowych danych do indeksu. Rozmyte wycinki, znaczne zasłonięcia i prześwietlone twarze generują osadzenia o niskiej wiarygodności, które zanieczyszczają wyniki wyszukiwania. Odrzucenie na etapie wykrywania twarzy znajdujących się poniżej progu jakości znacząco poprawia precyzję dalszych etapów i oszczędza cykle GPU. Jest to jedna z optymalizacji o najwyższej stopie zwrotu w całym potoku.
Ochrona przed podszywaniem się podczas weryfikacji twarzy: W scenariuszach weryfikacyjnych kluczowe znaczenie ma wykrywanie ataków prezentacyjnych (PAD). Wydruki papierowe, obrazy odtwarzane na ekranach i maski 3D mogą oszukać systemy oparte na osadzeniach. Modele takie jak CDCN lub PatchNet wykrywają te ataki, ale zwiększają opóźnienie o 5–15 ms na twarz i wymagają utrzymywania dodatkowego modelu. Jeśli budujesz rozwiązanie, w którym użytkownik kontroluje obraz wejściowy — kontrolę dostępu, KYC lub uwierzytelnianie — musisz uwzględnić ochronę przed podszywaniem się, bo w przeciwnym razie system zostanie wykorzystany.
Etap 2: wyrównanie twarzy
Po wykryciu twarzy trzeba ją znormalizować. Różne pozycje głowy, kąty kamery i odległości zmieniają wygląd twarzy na surowym obrazie. Wyrównanie przekształca każdą wykrytą twarz do ustandaryzowanej pozycji: oczy znajdują się na jednym poziomie, twarz jest wyśrodkowana, a skala pozostaje spójna.
Standardowe podejście wykorzystuje pięć punktów charakterystycznych uzyskanych podczas wykrywania — lewe oko, prawe oko, czubek nosa, lewy kącik ust i prawy kącik ust — do obliczenia przekształcenia podobieństwa. Mapuje ono wykrytą twarz na kanoniczny wycinek o wymiarach 160 × 160 pikseli, na którym oczy znajdują się na ustalonych współrzędnych pikselowych.
Ten etap jest często pomijany w poradnikach, ale ma kluczowe znaczenie. Błąd wyrównania wynoszący 2 stopnie może obniżyć dokładność rozpoznawania o 1–3%. Większość potoków open source wykonuje wyrównanie automatycznie, ale jeśli tworzysz własne rozwiązanie, wykorzystaj specyfikację wyrównania FaceNet — 160 × 160 pikseli i określone współrzędne oczu — jako standard. Właśnie na niej trenowano większość współczesnych modeli.
Wrażliwość wyrównania na dokładność punktów charakterystycznych: Punkty charakterystyczne modelu RetinaFace mają średni błąd wynoszący około 2 pikseli. Błąd ten przenosi się przez transformację wyrównującą i może spowodować spadek dokładności o 1–5%, zwłaszcza w przypadku mniejszych wycinków twarzy, gdzie 2 piksele stanowią większą część całkowitej szerokości twarzy. Niektóre systemy produkcyjne po początkowym wykryciu uruchamiają dodatkowe doprecyzowanie 68 lub 98 punktów charakterystycznych — na przykład face-alignment autorstwa Adriana Bulata — aby uzyskać dokładniejsze wyrównanie. Dodatkowe 3–5 ms na twarz jest warte poniesienia, gdy przypadek użycia wymaga maksymalnej dokładności, zwłaszcza przy weryfikacji 1:1, gdzie pojedyncza błędna decyzja ma konsekwencje.
Etap 3: wyodrębnianie cech (osadzenie)
To sedno rozpoznawania twarzy. Głęboka sieć neuronowa przyjmuje wyrównany obraz twarzy i zwraca wektor o stałej długości — zwykle 512 wymiarów — nazywany osadzeniem lub wektorem cech. Wektor ten stanowi zwartą, liczbową reprezentację unikalnych właściwości danej twarzy.
Dwie twarze tej samej osoby, niezależnie od oświetlenia, wyrazu twarzy, wieku — w rozsądnych granicach — czy użytej kamery, powinny generować osadzenia położone blisko siebie w przestrzeni wektorowej. Dwie różne osoby powinny generować osadzenia znacznie od siebie oddalone.
Jak działa to od strony technicznej:
Architektura sieci jest zwykle zmodyfikowanym modelem Inception-ResNet lub ResNet, trenowanym na milionach zdjęć twarzy. Kluczową innowacją jest funkcja straty używana podczas treningu, a nie sama architektura.
- Strata softmax (punkt odniesienia): Traktuje rozpoznawanie twarzy jako klasyfikację. Działa, ale generuje osadzenia, które nie są dobrze rozdzielone w przestrzeni kątowej. W rozpoznawaniu jest już w dużej mierze przestarzała.
- Strata trójkowa: Podejście spopularyzowane przez FaceNet. Sieć uczy się przez porównywanie trójek twarzy kotwica/przykład pozytywny/przykład negatywny, zbliżając osadzenia tej samej tożsamości i oddalając osadzenia różnych tożsamości. Wymaga starannego dobierania trudnych trójek podczas treningu. Generuje wysoce rozróżniające osadzenia.
- Strata ArcFace: Prawdopodobnie najczęściej używana funkcja straty w produkcyjnych systemach rozpoznawania twarzy w 2026 roku. Dodaje karę w postaci addytywnego marginesu kątowego w przestrzeni kątowej między wektorem cech a odpowiadającą mu wagą klasy, zapewniając ciaśniejsze grupowanie wewnątrz klas i większe odstępy między klasami niż podejścia oparte na marginesie cosinusowym. Projekt [InsightFace](https://github.com/deepinsight/insightface) udostępnia implementację referencyjną, a większość najnowocześniejszych modeli jest trenowana przy użyciu ArcFace lub jednego z jego wariantów — przykładowo adaptacyjny margines AdaFace bazuje na sformułowaniu ArcFace. Jeśli trenujesz lub dostrajasz własny model rozpoznawania twarzy, ArcFace jest domyślnym punktem wyjścia.
- Strata CosFace: Dodaje margines cosinusowy do straty softmax, wymuszając na sieci generowanie osadzeń ciaśniej zgrupowanych w obrębie każdej tożsamości i lepiej rozdzielonych między tożsamościami.
- SphereFace / A-Softmax: Pierwotne podejście oparte na marginesie kątowym z 2017 roku. Ważne historycznie, ale w dużej mierze zastąpione przez ArcFace i nowocześniejsze funkcje straty.
Dane wyjściowe: Wektor 512 liczb zmiennoprzecinkowych, znormalizowany normą L2 do jednostkowej hipersfery. Cała informacja o twarzy skompresowana do 2 KB danych. To właśnie ten wektor jest przechowywany, indeksowany i porównywany.
Pułapka normalizacji: Wielu programistów zapomina, że przed porównaniem osadzenia muszą zostać znormalizowane normą L2. Nienormalizowane osadzenia generują bardzo niespójne wyniki podobieństwa. Jest to częsty błąd, który trudno zdiagnozować, ponieważ system „w większości działa” — względna kolejność dopasowań może wyglądać prawidłowo podczas testów, ale bezwzględne wyniki podobieństwa zmieniają się między obrazami, przez co decyzje oparte na progach stają się niewiarygodne. FaceNet512 domyślnie generuje znormalizowane osadzenia, ale jeśli używasz własnego modelu lub eksportujesz go przez ONNX, zawsze sprawdzaj, czy wyjściowe osadzenia leżą na jednostkowej hipersferze, czyli czy ich norma L2 wynosi 1,0.
Wdrożenie produkcyjne: ONNX Runtime i kwantyzacja: Wyniki szybkości w testach porównawczych zakładają inferencję FP32 na nieobciążonym GPU. W środowisku produkcyjnym większość systemów jest wdrażana przez ONNX Runtime z kwantyzacją INT8, która skraca czas inferencji 2–3-krotnie przy minimalnej utracie dokładności — zwykle poniżej 0,1% na LFW. Proces wygląda następująco: wyeksportuj model PyTorch lub TensorFlow do ONNX, uruchom narzędzie kwantyzacyjne ONNX Runtime ze zbiorem kalibracyjnym obejmującym około 1000 zdjęć twarzy, a następnie wdróż skwantyzowany model. W ten sposób na tym samym sprzęcie można zejść z „10 ms na twarz” do „3–4 ms na twarz”, co ma ogromne znaczenie przy przetwarzaniu miliardów obrazów.
Inferencja mieszanej precyzji: Użycie FP16 na GPU dla szkieletu i FP32 dla końcowej warstwy osadzeń pozwala uniknąć opisanych w dalszej części artykułu problemów z precyzją zmiennoprzecinkową, a jednocześnie zapewnia przyspieszenie od 1,5 do 2 razy. Jest to praktyczny kompromis między pełnym FP32 — dokładnym, ale wolnym — a pełnym FP16 — szybkim, lecz mogącym generować nieznacznie odmienne osadzenia na różnym sprzęcie.
Destylacja osadzeń na potrzeby wdrożeń brzegowych: Można wytrenować mniejszą sieć uczniowską — MobileFaceNet, około 1 mln parametrów — tak, aby naśladowała osadzenia FaceNet512 za pomocą destylacji wiedzy. Model uczniowski zachowuje ponad 95% dokładności przy dziesięciokrotnie większej szybkości, dzięki czemu nadaje się do wdrożeń mobilnych i brzegowych, w których nie można pozwolić sobie na GPU. Kluczowe jest to, że modelu uczniowskiego nie trzeba trenować od zera na etykietach tożsamości twarzy — trenuje się go tak, aby odtwarzał osadzenia modelu nauczycielskiego na nieoznaczonych danych twarzy, co wymaga znacznie mniejszej mocy obliczeniowej i nie wymaga zbioru danych z etykietami tożsamości.
Etap 4: dopasowywanie
Jak na podstawie dwóch osadzeń twarzy zdecydować, czy przedstawiają tę samą osobę? Istnieją dwa podejścia:
Podobieństwo cosinusowe: Oblicza cosinus kąta między dwoma wektorami osadzeń. Zakres wynosi od -1 do 1, gdzie 1 oznacza identyczność. Typowy próg oznaczający „tę samą osobę” wynosi 0,4–0,6, zależnie od modelu i przypadku użycia. Metoda jest prosta, szybka i skuteczna, ponieważ osadzenia FaceNet512 są znormalizowane normą L2.
Odległość euklidesowa: Oblicza odległość L2 między wektorami. W przypadku znormalizowanych osadzeń jest matematycznie równoważna podobieństwu cosinusowemu (d = sqrt(2 - 2*cos_sim)). Niektóre systemy preferują tę postać.
W przypadku wyszukiwania (dopasowywanie 1:N): Gdy trzeba znaleźć twarz w bazie milionów rekordów, porównywanie metodą siłową jest zbyt wolne. Należy użyć wyszukiwania przybliżonych najbliższych sąsiadów (ANN):
- FAISS (Facebook AI Similarity Search): Standardowa biblioteka. Obsługuje akcelerację GPU oraz wiele typów indeksów (IVF, HNSW, PQ). Potrafi przeszukać 1 mld wektorów w ciągu milisekund. Bezpłatna i open source.
- Milvus: Specjalistyczna baza wektorowa wykorzystująca pod spodem FAISS, uzupełniona o trwałość danych, skalowanie i warstwy API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Zarządzane bazy wektorowe dla osób, które nie chcą samodzielnie utrzymywać infrastruktury.
W przypadku bazy zawierającej 10 mln twarzy dobrze dostrojony indeks HNSW FAISS na pojedynczym GPU może zwrócić 10 najlepszych dopasowań w czasie krótszym niż 5 ms.
Wybór typu indeksu FAISS ma ogromne znaczenie. IVF-PQ zapewnia doskonałą kompresję — 8–16 bajtów na wektor zamiast 2 KB — ale obniża dokładność przy granicznych dopasowaniach, gdy błąd kwantyzacji spycha prawdziwe dopasowanie poniżej progu. HNSW zachowuje dokładność, lecz zużywa od 4 do 8 razy więcej pamięci, ponieważ przechowuje pełne wektory zmiennoprzecinkowe wraz ze strukturą grafu. Hybrydowe indeksy IVF-HNSW zapewniają najlepszy kompromis przy skali od 10 mln do 1 mld rekordów. Większość zespołów początkowo wybiera niewłaściwy typ indeksu na podstawie zaleceń z poradników, a sześć miesięcy później, po napotkaniu jego ograniczeń, musi przebudować całą infrastrukturę indeksowania. Przed wyborem typu indeksu przetestuj własne obciążenie z realistyczną ilością danych i wzorcami zapytań.
Problem zimnego startu indeksów ANN: Indeksy HNSW i IVF potrzebują minimalnej liczby wektorów, aby działać dobrze. Przy mniej niż około 10 tys. wektorów wyszukiwanie metodą siłową jest w rzeczywistości szybsze niż wyszukiwanie indeksowane, ponieważ narzut indeksu — przechodzenie grafu i porównywanie centroidów — dominuje nad właściwymi obliczeniami. Na wczesnym etapie wzrostu zacznij od wyszukiwania metodą siłową (FAISS IndexFlatIP), a po przekroczeniu przez bazę 50–100 tys. wektorów przejdź na indeks ANN.
Filtrowanie wstępne przy użyciu kodów binarnych: Obliczenie binarnego skrótu każdego osadzenia — za pomocą binaryzacji lub SimHash — pozwala wykonać tani filtr wstępny oparty na odległości Hamminga przed kosztownymi porównaniami liczb zmiennoprzecinkowych. Może to zmniejszyć zbiór kandydatów o ponad 90% przy minimalnej utracie czułości. Pomysł polega na przechowywaniu 256- lub 512-bitowego kodu binarnego obok każdego pełnego osadzenia. Dla zapytania najpierw oblicza się odległość Hamminga do wszystkich kodów binarnych — wyjątkowo szybko dzięki instrukcjom CPU POPCNT — wybiera od 1 do 5% najlepszych kandydatów, a następnie oblicza dokładne podobieństwo cosinusowe wyłącznie dla nich. To dwuetapowe podejście jest szczególnie skuteczne, gdy zbiór danych przekracza dostępną pamięć GPU.
Ponowne szeregowanie na podstawie atrybutów twarzy: Początkowe wyszukiwanie osadzeń zwraca kandydatów; drugi przebieg z użyciem szacowanych atrybutów — przedziału wieku, płci, odcienia skóry czy zarostu — może odfiltrować oczywiście błędne dopasowania. Jeśli osoba z zapytania jest oceniana jako 25-letnia kobieta, a kandydat jako 60-letni mężczyzna, jest to niemal na pewno wynik fałszywie dodatni bez względu na wynik podobieństwa osadzeń. Ta prosta heurystyka może ograniczyć liczbę wyników fałszywie dodatnich o 30–50% przy minimalnym koszcie obliczeniowym i jest jedną z najbardziej niedocenianych technik w produkcyjnym wyszukiwaniu twarzy.
Spójność czasowa w materiale wideo: Jeśli dopasowujesz twarze z filmu zamiast ze zdjęć, uśrednianie osadzeń z wielu klatek tej samej śledzonej twarzy znacząco poprawia dokładność — często o 5–10% w trudnych testach porównawczych. Agregacja osadzeń na poziomie ścieżki jest zdecydowanie lepsza niż dopasowywanie na poziomie klatek. Podejście wygląda następująco: użyj mechanizmu śledzenia twarzy, takiego jak SORT lub DeepSORT, aby powiązać wykrycia między klatkami, oblicz osadzenia dla każdego wykrycia i zagreguj je w jedno „osadzenie ścieżki” za pomocą średniej ważonej jakością, gdzie wagą jakości jest ocena jakości twarzy z etapu wykrywania.
Najlepsze modele open source do rozpoznawania twarzy (2026)
FaceNet512
Złoty standard. FaceNet512 to wariant architektury Google FaceNet generujący 512-wymiarowe osadzenia, oferujący większą i bardziej rozróżniającą przestrzeń osadzeń niż pierwotna wersja 128-wymiarowa.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Architektura: Szkielet Inception-ResNet-v2 generujący osadzenia 512-wymiarowe
- Licencja: MIT (liberalna, zezwala na użytek komercyjny)
- Dokładność na LFW: 99,65%
- Rozmiar osadzenia: 512 wymiarów
- Obejmuje: Współpracuje ze standardowymi potokami wykrywania (MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)), zapewniając kompleksowe rozpoznawanie
- API dla Pythona: Dostępne za pośrednictwem biblioteki
deepfacelub niezależnych implementacji
Werdykt: Jeśli w 2026 roku budujesz system rozpoznawania twarzy, FaceNet512 jest solidnym punktem wyjścia. Oferuje doskonałą dokładność, 512-wymiarowe osadzenia o dużej zdolności rozróżniania, liberalną licencję MIT i szerokie wsparcie ekosystemu.
FaceNet (Google, oryginalna wersja 128-wymiarowa)
Model, który w 2015 roku spopularyzował podejście oparte na osadzeniach. Wprowadził trening ze stratą trójkową, w którym sieć uczy się przez porównywanie trójek twarzy kotwica/przykład pozytywny/przykład negatywny.
- Oryginalna publikacja: „FaceNet: ujednolicone osadzenia do rozpoznawania i grupowania twarzy” (Schroff i in., 2015)
- Repozytorium: Wiele implementacji (davidsandberg/facenet to klasyczna wersja dla TensorFlow)
- Licencja: MIT
- Dokładność na LFW: 99,63% (oryginalna), do 99,75% przy nowoczesnym treningu
- Rozmiar osadzenia: 128 wymiarów
- Architektura: Inception-ResNet-v1 lub Inception-ResNet-v2
Werdykt: Model ważny historycznie, który nadal działa dobrze. Osadzenie 128-wymiarowe jest bardziej zwarte, ale nieco mniej rozróżniające niż 512-wymiarowy wariant FaceNet512. Użyj go, jeśli potrzebujesz mniejszych osadzeń lub pracujesz w środowisku TensorFlow z ograniczoną pamięcią.
DeepFace (Facebook/Meta)
Nie należy go mylić z biblioteką Pythona deepface pisaną małymi literami. DeepFace firmy Meta z 2014 roku był jednym z pierwszych podejść do rozpoznawania twarzy opartych na głębokim uczeniu i osiągał na LFW dokładność zbliżoną do ludzkiej.
Bardziej istotnym obecnie projektem jest biblioteka Pythona deepface autorstwa Serengila:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repozytorium: github.com/serengil/deepface
- Licencja: MIT
- Działanie: Biblioteka opakowująca, która udostępnia ujednolicone API dla wielu modeli zaplecza: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib i SFace
- Obejmuje: Weryfikację, wyszukiwanie i analizę atrybutów twarzy (wiek, płeć, rasa, emocje)
- Łatwość użycia: Wyjątkowo proste API
Werdykt: Najlepszy wybór do prototypowania i eksperymentów. Ujednolicone API pozwala przełączać się między modelami przez zmianę jednego parametru. W środowisku produkcyjnym warto używać FaceNet512 bezpośrednio, aby uzyskać lepszą wydajność i większą kontrolę.
dlib
Biblioteka C++ z powiązaniami dla Pythona, utrzymywana przez Davisa Kinga. Zawiera model rozpoznawania twarzy wytrenowany na zbiorze 3 mln obrazów.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repozytorium: github.com/davisking/dlib
- Licencja: Boost Software License (liberalna)
- Dokładność na LFW: 99,38%
- Rozmiar osadzenia: 128 wymiarów
- Wykrywanie: Oparte na HOG (szybkie i przyjazne dla CPU) oraz CNN (dokładniejsze)
Werdykt: Niezwykle solidny, sprawdzony bojowo kod C++ z dobrymi powiązaniami dla Pythona. Ma niższą dokładność niż FaceNet512, ale jest wyjątkowo niezawodny. To dobry wybór, jeśli pracujesz w C++ lub potrzebujesz lekkiego rozwiązania bez zależności od PyTorch/ONNX.
AdaFace
Nowszy model z 2022 roku, który został zaprojektowany specjalnie z myślą o zróżnicowanej jakości obrazów. Standardowe modele są trenowane na obrazach wysokiej jakości i działają gorzej na danych wejściowych o niskiej rozdzielczości lub rozmytych. AdaFace dostosowuje karę marginesu podczas treningu na podstawie jakości obrazu.
- Repozytorium: github.com/mk-minchul/AdaFace
- Licencja: MIT
- Kluczowa zaleta: Lepsza skuteczność na obrazach niskiej jakości (monitoring, kamery dalekiego zasięgu)
- Dokładność na LFW: 99,82%
- IJB-C TAR@FAR=1e-4: 97,39% (przewyższa większość modeli open source w trudnych testach porównawczych)
Werdykt: Użyj go, gdy obrazy wejściowe są niskiej jakości. W przypadku monitoringu, analizy CCTV i każdego scenariusza, w którym nie możesz kontrolować jakości obrazu, AdaFace zapewnia wymiernie lepsze wyniki niż standardowe modele.
Tabela porównawcza wydajności
| Model | LFW (%) | Osadzenie | Szybkość (ms/twarz) | Licencja |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 wym. | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 wym. | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 wym. | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 wym. | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2048 wym. | ~15 ms (GPU) | CC BY-SA |
LFW (Labeled Faces in the Wild) jest standardowym testem porównawczym, ale problem ten został już w zasadzie rozwiązany. Każdy współczesny model osiąga wynik powyżej 99%. Rzeczywiste różnice ujawniają się w trudniejszych testach, takich jak IJB-C — zróżnicowane warunki — i TinyFace — niska rozdzielczość.
Uwaga dotycząca różnicy między testami a rzeczywistością: Podane wyniki szybkości dotyczą inferencji FP32 dla jednej twarzy na rozgrzanym GPU. W środowisku produkcyjnym z kwantyzacją INT8 w ONNX Runtime można oczekiwać 2–3-krotnie większej szybkości. Należy jednak pamiętać, że pełny potok — wykrywanie + wyrównanie + ocena jakości + osadzenie — zajmuje od 3 do 5 razy więcej czasu niż samo wyodrębnianie osadzenia. Realistyczna kompleksowa przepustowość pełnego potoku na pojedynczym GPU A100 wynosi 200–400 twarzy na sekundę, a nie tysiące sugerowane przez testy obejmujące wyłącznie osadzenia.
Luka między modelami open source a systemami produkcyjnymi
Oto czego nie mówią poradniki: uruchomienie modelu rozpoznawania twarzy w notatniku Jupyter jest łatwą częścią. Zbudowanie produkcyjnego systemu, który naprawdę działa na dużą skalę, wymaga rozwiązania długiej listy problemów inżynieryjnych, których żaden model nie rozwiąże za Ciebie. Większość zespołów zdecydowanie nie doszacowuje zarówno kosztów, jak i czasu realizacji. Projekt wyglądający na „wystarczy podłączyć model” zamienia się w przedsięwzięcie inżynieryjne trwające 12–24 miesiące, które przed osiągnięciem gotowości produkcyjnej może z łatwością pochłonąć od 500 tys. do ponad 2 mln USD — jeszcze przed uwzględnieniem bieżących kosztów operacyjnych.
Rachunek za infrastrukturę
Moc GPU do wyodrębniania osadzeń. Wykrywania twarzy i wyodrębniania osadzeń z miliardów obrazów nie wykonuje się na laptopie. Pojedynczy GPU NVIDIA A100 może przetwarzać około 200–400 twarzy na sekundę za pomocą pełnego potoku wykrywanie + wyrównanie + osadzenie. Aby przetworzyć 1 mld obrazów w rozsądnym czasie — na przykład w mniej niż tydzień — potrzebny jest klaster od 40 do 80 GPU działających bez przerwy. Przy stawkach chmurowych kosztuje to od 50 tys. do 150 tys. USD za jeden przebieg, a wraz z ulepszaniem modelu lub zmianami w potoku konieczne będzie ponowne przetwarzanie. Zakup sprzętu na własność oznacza wydatek od 300 tys. do 800 tys. USD na serwery GPU, a także miejsce w szafach, energię, chłodzenie i pracownika utrzymującego całość.
Pamięć masowa na dużą skalę. 1 mld osadzeń twarzy po 512 liczb zmiennoprzecinkowych — po 2 KB każde — to około 2 TB samych danych wektorowych. Po dodaniu oryginalnych obrazów, miniatur, metadanych i struktur indeksów otrzymujemy od setek terabajtów do kilku petabajtów danych. Wydajna pamięć NVMe dla indeksów wektorowych kosztuje w chmurze 0,10–0,25 USD za GB miesięcznie. Przy 50 TB aktywnej pamięci jest to od 5 tys. do 12,5 tys. USD miesięcznie za samo utrzymanie działania systemu.
Infrastruktura wyszukiwania wektorowego. FAISS na pojedynczej maszynie osiąga limit przy około 100–500 mln wektorów, zależnie od typu indeksu i dostępnej pamięci RAM. Powyżej tego poziomu potrzebne jest wyszukiwanie rozproszone między wieloma fragmentami, równoważenie obciążenia, replikacja zapewniająca odporność na awarie oraz wystarczająca ilość pamięci RAM na indeksy. Produkcyjne, rozproszone wdrożenie FAISS lub Milvus dla ponad 1 mld wektorów zwykle wymaga od 8 do 16 maszyn z dużą ilością pamięci — co najmniej 256 GB RAM każda — i kosztuje w chmurze od 15 tys. do 40 tys. USD miesięcznie.
Sieć i przepustowość. Indeksowanie miliardów obrazów oznacza pobieranie petabajtów danych. Przy opłatach za transfer wychodzący u głównych dostawców chmury wynoszących 0,05–0,09 USD za GB sam transfer może kosztować dziesiątki tysięcy dolarów. Potrzebna jest również wewnętrzna sieć o dużej przepustowości między robotami indeksującymi, węzłami przetwarzania GPU i systemami pamięci masowej.
Szacowany całkowity koszt infrastruktury wyszukiwarki twarzy działającej w skali internetu: od 30 tys. do 80 tys. USD miesięcznie w bieżących kosztach chmurowych albo od 500 tys. do 1,5 mln USD na sprzęt z góry oraz od 10 tys. do 20 tys. USD miesięcznie na energię, transfer i utrzymanie. A to tylko infrastruktura, zanim choć jeden inżynier napisze pierwszą linię kodu aplikacji.
Harmonogram prac inżynieryjnych
Budowa produkcyjnego systemu wyszukiwania twarzy nie jest projektem na hackathon. Oto realistyczny harmonogram dla zespołu od 3 do 5 doświadczonych inżynierów:
Miesiące 1–3: podstawowy potok. Niezawodne uruchomienie wykrywania, wyrównywania i wyodrębniania osadzeń. Zbudowanie podstawowego indeksu wektorowego. Obsługa pozyskiwania obrazów z plików lokalnych. To „przyjemna” część, podczas której wszystko zdaje się przebiegać dobrze, a demonstracja wygląda imponująco.
Miesiące 3–6: infrastruktura indeksowania internetu. Zbudowanie scraperów dla najważniejszych platform. Obsługa ograniczeń szybkości, CAPTCHA, ekranów logowania, dynamicznego renderowania — witryn intensywnie korzystających z JavaScript — deduplikacji obrazów i filtrowania treści. Odkrycie, że każda platforma społecznościowa stosuje inne zabezpieczenia przed scrapingiem, które co tydzień psują roboty indeksujące. Zbudowanie monitoringu wykrywającego ich ciche awarie. Sam ten etap może trwać dłużej, niż oczekiwano, ponieważ internet jest chaotyczny i wrogi automatyzacji.
Miesiące 6–9: skala i niezawodność. Prototyp działał na 1 mln twarzy. Teraz trzeba sprawić, by działał na 100 mln. Okazuje się, że indeks FAISS nie mieści się już w pamięci RAM. Trzeba wdrożyć fragmentację. Naprawić warunki wyścigu w potoku pozyskiwania. Zbudować mechanizm ponawiania dla 15% obrazów, których nie udaje się pobrać. Obsłużyć uszkodzone obrazy, pliki deklarujące format JPEG, choć nim nie są, obrazy z flagami obrotu EXIF i przerwane pobieranie. Dodać monitoring, alerty i dzienniki, aby wiedzieć, kiedy coś zepsuje się o 3:00 nad ranem.
Miesiące 9–12: jakość i dokładność. Uświadomienie sobie, że odsetek wyników fałszywie dodatnich jest na dużą skalę nieakceptowalny. Wdrożenie oceny jakości twarzy w celu odfiltrowania bezwartościowych osadzeń. Dostosowanie progów do poszczególnych przypadków użycia. Zbudowanie mechanizmu informacji zwrotnej pozwalającego oznaczać i badać złe dopasowania. Odkrycie, że model generuje różne wyniki na różnych architekturach GPU z powodu różnic w precyzji zmiennoprzecinkowej, i poświęcenie dwóch tygodni na znalezienie przyczyny.
Miesiące 12–18: przygotowanie produkcyjne. Zbudowanie warstwy API z uwierzytelnianiem, ograniczaniem szybkości i śledzeniem użycia. Dodanie funkcji zgodności z RODO/CCPA: mechanizmów rezygnacji, żądań usunięcia danych i dzienników audytowych. Wdrożenie pamięci podręcznej wyników. Zbudowanie narzędzi administracyjnych. Napisanie dokumentacji. Przejście audytu bezpieczeństwa. Testowanie wszystkiego pod obciążeniem. Naprawienie wycieków pamięci, o których istnieniu nikt wcześniej nie wiedział.
Miesiące 18–24: bieżąca eksploatacja. Roboty indeksujące przestają działać, gdy witryny zmieniają układ. Modele tracą dopasowanie, gdy pojawiają się nowe rodzaje obrazów. Kończy się miejsce na dysku. Indeksy trzeba przebudowywać. Użytkownicy zgłaszają przypadki brzegowe, których nikt nie przewidział. Ktoś odkrywa, że system zwraca pewne dopasowania dla twarzy z kreskówek, więc trzeba dodać filtr „prawdziwej twarzy”. To nigdy się nie kończy.
Pełna lista problemów, które napotkasz
Poza infrastrukturą i harmonogramem poniżej przedstawiamy wszystkie główne problemy, z którymi spotykają się zespoły budujące systemy rozpoznawania twarzy od podstaw. Lista pochodzi z rzeczywistych systemów produkcyjnych, a nie z rozważań teoretycznych.
Koszmary związane z jakością danych:
- Jakie dane na wejściu, takie wyniki na wyjściu. Internet jest pełen memów, twarzy wygenerowanych przez AI, rysunków, zdjęć innych zdjęć, okładek czasopism i posągów. Detektor znajdzie „twarze” we wszystkich tych materiałach i utworzy osadzenia zanieczyszczające indeks. Potrzebne są klasyfikatory odfiltrowujące twarze syntetyczne, ilustrowane, wycinki o skrajnie niskiej rozdzielczości i treści niefotograficzne. Budowa i utrzymanie tych filtrów stanowią osobny projekt.
- Duplikaty i obrazy niemal identyczne. To samo zdjęcie pojawia się w dziesiątkach witryn z różnymi kadrami, znakami wodnymi, poziomami kompresji i korektami kolorów. Bez deduplikacji jedno popularne zdjęcie generuje setki „dopasowań”, które są w istocie tym samym obrazem, i zasłania rzeczywiste wyniki. Haszowanie percepcyjne — pHash, dHash — pomaga, ale nie jest idealne. Deduplikacja jest potrzebna na wielu poziomach: adresu URL — trywialna — skrótu percepcyjnego — wykrywa kopie o zmienionym rozmiarze i ponownie skompresowane — oraz osadzeń — wykrywa tę samą twarz sfotografowaną pod nieco innymi kątami. Każdy poziom wykrywa przypadki pomijane przez pozostałe, a deduplikacja zajmie więcej czasu, niż się spodziewasz.
- Zmiany wieku i wyglądu. Osadzenie twarzy ze zdjęcia z czasów studiów może nie pasować do zdjęcia tej samej osoby wykonanego 15 lat później. Zmiany masy ciała, starzenie, operacje plastyczne, zarost i inne fryzury wpływają na dokładność rozpoznawania. Żaden model nie radzi sobie z tym idealnie. Użytkownicy będą obwiniać system, gdy nie dopasuje osoby przy różnicy 20 lat.
- Uprzedzenia demograficzne. Modele open source trenowane głównie na zachodnich zbiorach danych obejmujących osoby białe działają gorzej dla innych grup demograficznych. Różnice dokładności między grupami etnicznymi są większe, niż sugeruje LFW — około 77% tego zbioru stanowią osoby białe. Przy wdrożeniu globalnym różnice dokładności między grupami demograficznymi mogą wynosić od 5 do 15% w trudnych testach. Modele takie jak FaceNet512, trenowane na MS-Celeb-1M, dziedziczą jego nierównowagę demograficzną. Dla zapewnienia sprawiedliwej skuteczności ważne jest dostrajanie na zrównoważonych zbiorach, takich jak BUPT-Balancedface, lub używanie strategii treningowych uwzględniających demografię. Jeśli nie oceniasz dokładności w poszczególnych grupach rasowych, możesz wdrożyć system działający dobrze dla jednych użytkowników, a źle dla innych. Jest to nie tylko problem etyczny, ale też kwestia jakości produktu i odpowiedzialności prawnej.
- Obsługa orientacji EXIF. Około 15–20% obrazów w internecie zawiera znaczniki orientacji EXIF, których zignorowanie skutkuje twarzami obróconymi bokiem lub do góry nogami. Większość detektorów nie potrafi znaleźć obróconych twarzy. Jest to cichy zabójca dokładności, łatwy do przeoczenia podczas testów — gdzie używa się poprawnie zorientowanych obrazów — ale katastrofalny w środowisku produkcyjnym. Korektę orientacji EXIF należy zawsze wykonywać jako pierwszy krok potoku przetwarzania obrazu.
- Błędy dekodowania progresywnych plików JPEG i WebP. Niektóre biblioteki obrazów bez ostrzeżenia generują uszkodzone dane pikselowe z częściowo pobranych progresywnych plików JPEG lub obciętych plików WebP. Detektor może mimo to znaleźć „twarz” w artefaktach uszkodzenia i wygenerować bezwartościowe osadzenie. Przed przetwarzaniem trzeba sprawdzić integralność obrazu — czy plik dekoduje się bez błędów i czy wynikowy bufor pikseli ma rozsądne wymiary. Bez tego uszkodzone obrazy po cichu zanieczyszczają indeks.
Problemy inżynieryjne, które początkowo nie są oczywiste:
- Wersjonowanie osadzeń. Gdy zaktualizujesz model — a zrobisz to, ponieważ poprawa dokładności ma znaczenie — każde osadzenie w bazie stanie się niezgodne z danymi wyjściowymi nowego modelu. Możesz ponownie utworzyć osadzenia dla całej bazy — co jest kosztowne, czasochłonne i wymaga przechowywania wszystkich oryginalnych obrazów — utrzymywać równoległe indeksy podczas migracji — podwajając koszt infrastruktury — albo zachować zgodność wsteczną — co jest skomplikowane i ogranicza możliwości ulepszania. Nie ma dobrego rozwiązania, są tylko mniej bolesne.
- Determinizm zmiennoprzecinkowy. Ten sam obraz przetwarzany na różnych modelach GPU, w różnych wersjach CUDA, a nawet przy różnych rozmiarach partii może generować nieco odmienne osadzenia z powodu arytmetyki zmiennoprzecinkowej. Różnice są niewielkie — od 1e-6 do 1e-4 — ale ich skutki się kumulują: dopasowanie z wynikiem 0,401 na jednej maszynie może uzyskać 0,399 na innej, odwracając binarną decyzję progową. Doprowadza to do szału podczas debugowania. Szczególną pułapką są aktualizacje sterowników GPU — sterowniki NVIDIA mogą zmienić zachowanie obliczeń zmiennoprzecinkowych na poziomie CUDA. Osadzenie obliczone na sterowniku 535.x może różnić się od wyniku dla tego samego obrazu na 545.x. W produkcji oznacza to konieczność przypięcia wersji sterowników w całej flocie i sprawdzania spójności osadzeń po każdej aktualizacji.
- Współbieżność i warunki wyścigu. Wiele robotów jednocześnie pozyskujących twarze, użytkownicy wysyłający zapytania podczas aktualizacji indeksu, żądania usunięcia przychodzące w trakcie składania wyników wyszukiwania. Bazy wektorowe nie mają tak dojrzałej obsługi transakcji jak bazy SQL. Pojawią się sytuacje, w których twarz zostanie zaindeksowana częściowo, zapytania zwrócą nieaktualne wyniki albo usunięcie nie zostanie rozpropagowane do wszystkich fragmentów.
- Zarządzanie pamięcią. Indeksy FAISS są mapowane do pamięci, ale wydajność zapytań w dużym stopniu zależy od tego, jaka część indeksu mieści się w RAM. Wraz ze wzrostem indeksu opóźnienia zapytań rosną w nieprzewidywalny sposób, gdy system operacyjny usuwa z pamięci jego strony. Procesy zabijane z powodu braku pamięci zdarzają się w najgorszych możliwych momentach. Bardzo dokładnie poznasz zarządzanie pamięcią w Linuksie, ustawienia pamięci wymiany i topologię [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). Kolejnym problemem jest rozgrzewanie po zimnym starcie: indeksy FAISS HNSW są mapowane do pamięci, więc po restarcie serwera pierwsze kilkaset zapytań działa od 10 do 100 razy wolniej, ponieważ strony indeksu nie zostały jeszcze załadowane do RAM. Przed przyjęciem ruchu produkcyjnego potrzebna jest faza rozgrzewania, która wstępnie załaduje indeks, inaczej pierwsi użytkownicy po wdrożeniu doświadczą fatalnych opóźnień.
- Ciche awarie. Robot przestaje działać, ponieważ witryna zmieniła kod HTML. Węzeł przetwarzania GPU zaczyna generować osadzenia NaN po aktualizacji sterownika. Dysk się zapełnia i nowe twarze po cichu przestają być indeksowane. Awarie te nie powodują błędów, lecz po prostu niezauważalnie pogarszają działanie systemu. Bez kompleksowego monitoringu i wykrywania anomalii dowiesz się o nich dopiero od użytkowników.
- Problem odświeżania FAISS. Gdy dodajesz nowe osadzenia do indeksu IVF, komórki Woronoja tracą równowagę. Jakość wyszukiwania stopniowo spada, aż kwantyzator zostanie ponownie wytrenowany. W skali internetu ponowny trening oznacza wiele godzin pracy GPU na pełnym zbiorze danych. Zespoły zwykle dodają dane partiami i ponawiają trening co tydzień lub co miesiąc, przez co nowo pozyskane twarze nie są od razu dostępne z pełną dokładnością. Zawsze trzeba wybierać między aktualnością a jakością wyszukiwania — nie ma darmowych rozwiązań.
- Kalibracja wyników między fragmentami indeksu. Gdy indeks jest podzielony między wiele maszyn, surowe wyniki podobieństwa z różnych fragmentów nie są bezpośrednio porównywalne, ponieważ każdy fragment ma inny rozkład osadzeń. Aby sensownie połączyć wyniki, potrzebna jest normalizacja wyników osobna dla każdego fragmentu — normalizacja kohortowa, Z-norm lub T-norm. Bez kalibracji wynik 0,45 z fragmentu A może oznaczać silne dopasowanie, podczas gdy 0,45 z fragmentu B oznacza dopasowanie przeciętne. Połączone wyniki stają się niewiarygodne.
- Problem rozsyłania zapytań w wyszukiwaniu rozproszonym. Przeszukanie N fragmentów oznacza N podróży sieciowych w obie strony dla każdego zapytania. Jeśli którykolwiek fragment działa wolno — z powodu pauzy GC, skoku operacji wejścia/wyjścia dysku lub zakłócenia sieci — całe zapytanie jest wolne. Opóźnienie P99 zależy od P99 najwolniejszego fragmentu i pogarsza się wraz z dodawaniem kolejnych fragmentów. Techniki takie jak zapytania zabezpieczające — wysyłanie duplikatów i przyjmowanie pierwszej odpowiedzi — oraz adaptacyjne limity czasu są niezbędne do utrzymania akceptowalnych opóźnień skrajnych.
Problemy z dokładnością i dopasowywaniem:
- Strojenie progów nigdy nie jest „skończone”. Optymalny próg podobieństwa zmienia się wraz ze wzrostem bazy. Przy 1 mln twarzy próg 0,45 zapewnia dobrą równowagę między precyzją a czułością. Przy 100 mln twarzy ten sam próg generuje dziesięć razy więcej wyników fałszywie dodatnich, ponieważ istnieje więcej podobnych osób, które prawie pasują. Potrzebne są progi adaptacyjne albo ponowne szeregowanie wyników. Matematyka jest bezlitosna: gdy baza rośnie z 1 mln do 100 mln, a następnie 1 mld twarzy, rozkład wyników podobieństwa top-k przesuwa się w górę, bo pojawia się więcej podobnych osób. Stały próg dający 0,1% wyników fałszywie dodatnich przy 1 mln twarzy może dawać 10% przy 1 mld. Trzeba modelować ten rozkład i dynamicznie dostosowywać progi albo zaakceptować spadek precyzji wraz ze wzrostem skali.
- Rozpoznawanie w zbiorze otwartym i zamkniętym. Większość testów ocenia działanie w zbiorze zamkniętym, gdzie osoba z zapytania na pewno istnieje w bazie. Rzeczywiste wyszukiwanie twarzy działa w zbiorze otwartym: osoba z zapytania może w ogóle nie istnieć w indeksie. Ocena zbioru otwartego wymaga zupełnie innych metryk — TPIR przy stałym FPIR zamiast dokładności rank-1 — a rodzajem błędu są fałszywe dopasowania, nie błędne pozycje w rankingu. System osiągający 99% w testach zbioru zamkniętego może mieć 10-procentowy odsetek fałszywych dopasowań we wdrożeniu otwartym, ponieważ z dużą pewnością zwraca „najbliższą” twarz nawet wtedy, gdy prawdziwego dopasowania nie ma. Prawidłowa obsługa komunikatu „nie znaleziono dopasowania” jest równie ważna jak znajdowanie właściwych wyników.
- Sobowtóry i osoby podobne. W bazie ponad 100 mln twarzy istnieje wiele par niespokrewnionych osób, których osadzenia są zaskakująco podobne. Im większa baza, tym więcej fałszywych dopasowań. Użytkownicy będą regularnie zgłaszać wyniki przedstawiające „niewłaściwą osobę”. Potrzebna jest strategia obsługi takich sytuacji: weryfikacja na podstawie wielu zdjęć, sygnały kontekstowe — imię i nazwisko, lokalizacja — oraz kolejki do weryfikacji przez człowieka.
- Rozpoznawanie niezależne od pozy pozostaje trudne. Nawet FaceNet512 działa znacznie gorzej przy odchyleniu głowy przekraczającym plus lub minus 60 stopni. Dokładność dopasowywania profilu do zdjęcia frontalnego może spaść o 10–20% w porównaniu z dopasowaniem dwóch zdjęć frontalnych. W monitoringu większość twarzy jest ustawiona pod kątem, więc rzeczywista dokładność jest znacznie niższa, niż sugerują testy. Pomagają modele trenowane z augmentacją uwzględniającą 3D lub architektury takie jak UV-GAN, ale zwiększają złożoność. Jeśli dane wejściowe zawierają wiele twarzy ustawionych pod dużym kątem, potraktuj to jako podstawowy problem dokładności, a nie przypadek brzegowy.
- Dane wejściowe o charakterze ataku. Użytkownicy będą przesyłać twarze wygenerowane przez AI, deepfake’i, obrazy zmorfowane i zdjęcia z celowo wprowadzonymi zakłóceniami. Niektórzy testują system, inni próbują manipulować wynikami. System musi być w pewnym stopniu odporny na takie dane, w przeciwnym razie będzie zwracał pewne dopasowania dla fałszywych twarzy.
- Manipulowanie zdjęciami. Filtry, aplikacje upiększające, mocny makijaż i oprogramowanie zmieniające twarz. Instagramowa rzeczywistość kontra prawdziwa rzeczywistość. Modyfikacje te zmieniają geometrię twarzy na tyle, by wpłynąć na podobieństwo osadzeń. Mocno przefiltrowane selfie może nie pasować do nieprzetworzonego zdjęcia tej samej osoby.
- Jedna twarz, wiele osadzeń. Jedna osoba może mieć w internecie setki zdjęć z różnych platform, kątów i lat. Czy należy zwrócić je wszystkie jako osobne dopasowania, czy zgrupować w jedną tożsamość? Grupowanie na dużą skalę — setek milionów twarzy — jest kosztowne obliczeniowo i wprowadza własne rodzaje błędów: nadmierne łączenie — połączenie dwóch różnych osób — oraz niedostateczne łączenie — brak powiązania zdjęć tej samej osoby.
Problemy operacyjne:
- Wyścig z zabezpieczeniami przed scrapingiem. Każda duża platforma społecznościowa aktywnie blokuje scrapery. Platformy zmieniają strukturę stron, dodają CAPTCHA, wykrywają przeglądarki bez interfejsu, ograniczają szybkość według adresu IP, identyfikują wzorce żądań, a czasem serwują treści-wabiki. Infrastruktura indeksująca uczestniczy w ciągłym wyścigu zbrojeń. Scraper działający dziś może zostać całkowicie zablokowany w przyszłym tygodniu. Utrzymanie robotów to stały koszt inżynieryjny, a nie jednorazowa praca.
- Modelowanie tempa zmian. Różne źródła aktualizują się z różną częstotliwością. Serwisy z wiadomościami o celebrytach publikują nowe zdjęcia co godzinę, a prywatne profile społecznościowe mogą nie zmieniać się przez lata. Inteligentne planowanie ponownego indeksowania na podstawie historycznego tempa zmian może obniżyć koszty transferu o 60–80%, jednocześnie utrzymując większą aktualność indeksu tam, gdzie ma to znaczenie. Bez tego albo zbyt często indeksujesz statyczne źródła — marnując transfer i pieniądze — albo zbyt rzadko indeksujesz źródła dynamiczne — pokazując nieaktualne wyniki.
- CDN i geograficzne różnice treści. Ten sam adres URL może zwracać różne obrazy zależnie od lokalizacji osoby wysyłającej żądanie, identyfikatora urządzenia w nagłówku user-agent lub plików cookie. Robot może zaindeksować inny obraz niż ten widziany przez użytkownika, co prowadzi do mylących zgłoszeń, że „dopasowanie nie wygląda jak wynik”. Niektóre sieci CDN pokazują miniatury o niskiej rozdzielczości, dopóki prawdziwa przeglądarka nie przewinie obrazu do widocznego obszaru. Trzeba obsłużyć te przypadki brzegowe albo zaakceptować pewien odsetek widmowych wyników.
- Wzrost kosztów pamięci masowej. Ilość przechowywanych obrazów rośnie liniowo i nigdy nie przestaje. Nie można usunąć oryginałów, jeśli mogą być potrzebne do ponownego utworzenia osadzeń. Miniatury, metadane, wektory osadzeń, pliki indeksu i kopie zapasowe — rachunek rośnie coraz szybciej wraz z dojrzewaniem systemu. Zespoły, które zaplanowały budżet na pamięć dla pierwszego roku, są zaskoczone kosztami w roku trzecim.
- Żądania dotyczące zgodności na dużą skalę. RODO daje osobom fizycznym prawo do żądania usunięcia danych. Gdy ktoś rezygnuje z obecności w systemie, trzeba znaleźć wszystkie osadzenia wygenerowane z jego twarzy w całej bazie, usunąć je, dopilnować, aby nie zostały ponownie dodane po znalezieniu oryginalnych obrazów przez roboty, i udokumentować usunięcie na potrzeby audytu. Na dużą skalę wymaga to specjalnych narzędzi i pracy inżynieryjnej. [Unijny akt w sprawie sztucznej inteligencji](https://artificialintelligenceact.eu/) nakłada dodatkowe wymagania na systemy AI wysokiego ryzyka, w tym rozpoznawanie twarzy: obowiązkowe oceny zgodności, badanie uprzedzeń, obowiązki przejrzystości i mechanizmy nadzoru człowieka.
- Wdrożenie rezygnacji jest trudniejsze, niż się wydaje. Nie wystarczy usunąć osadzenia; trzeba zapobiec ponownemu zaindeksowaniu, gdy robot ponownie natrafi na tę samą twarz. Wymaga to utrzymywania indeksu „listy blokad” osadzeń osób, które zrezygnowały, i porównywania z nim każdego nowego osadzenia przed indeksowaniem. Sama lista musi działać szybko — jest sprawdzana przy każdym dodaniu — i rodzi własne pytania dotyczące retencji danych: trzeba trwale przechowywać osadzenie twarzy osoby, która zrezygnowała, aby móc je później rozpoznać. Oznacza to zachowywanie danych biometrycznych w celu spełnienia żądania usunięcia. To rzeczywiste napięcie prawne, które w wielu jurysdykcjach pozostaje nierozwiązane.
- Problem zgody przy danych pozyskiwanych publicznie. Zgodna z RODO podstawa prawna przetwarzania danych biometrycznych z publicznych profili społecznościowych jest przedmiotem sporów. Kilka unijnych organów ochrony danych wydało decyzje przeciwko firmom zajmującym się rozpoznawaniem twarzy — zwłaszcza decyzje dotyczące Clearview AI w wielu państwach UE. Ryzyko prawne zależy od jurysdykcji, źródła danych i przypadku użycia. Nie jest to hipotetyczny problem przyszłości, lecz obszar aktywnego egzekwowania prawa.
- Koszty przechowywania ścieżki audytowej. Jeśli zapisujesz każde zapytanie i każde zwrócone dopasowanie — czego może wymagać zgodność z przepisami — dzienniki audytowe mogą rosnąć szybciej niż same dane twarzy. System obsługujący 1 mln wyszukiwań dziennie i zwracający po 10 wyników generuje około 10 mln rekordów audytowych każdego dnia. Okresy retencji — często od 1 do 7 lat zależnie od jurysdykcji — sprawiają, że dane nieustannie się kumulują. Pamięć na audyty należy traktować jako główną pozycję kosztową, a nie późniejszy dodatek.
- Reagowanie na incydenty. Co się stanie, gdy system błędnie dopasuje twarz, a ktoś podejmie działanie na podstawie tego wyniku? Potrzebne są ścieżki audytowe pokazujące sposób wygenerowania każdego wyniku, możliwość wyjaśnienia decyzji dopasowującej i procedura rozpatrywania sporów. Gdy ktoś podważa dopasowanie, stwierdzenie „podobieństwo cosinusowe wynosiło 0,47, czyli przekroczyło nasz próg 0,42” nie jest satysfakcjonującym wyjaśnieniem. Techniki takie jak GradCAM mogą pokazać, które obszary twarzy wpłynęły na dopasowanie, co pomaga rozstrzygać spory i buduje zaufanie. Nie jest to wyłącznie dobra praktyka inżynieryjna — zależnie od jurysdykcji może być wymagane prawnie.
- Starzenie się modeli i zależności. Wersje CUDA, Pythona, [ONNX Runtime](https://onnxruntime.ai/), aktualizacje systemu operacyjnego — wszystko to zmienia się z czasem i może subtelnie zepsuć potok inferencji. Przypinanie wersji pomaga, dopóki nie pojawi się konieczność instalacji poprawki bezpieczeństwa. Zaskakująco dużo czasu poświęcisz na zarządzanie zależnościami i odtwarzalność środowiska.
- Koncentracja wiedzy w zespole. Inżynier, który zbudował warstwę indeksowania FAISS, rozumie logikę fragmentacji. Inżynier, który dostroił roboty, wie, które witryny wymagają specjalnej obsługi. Gdy te osoby odchodzą — a przy projekcie trwającym 18–24 miesiące rotacja jest nieunikniona — krytyczna wiedza odchodzi razem z nimi. Dokumentacja pomaga, ale nigdy w pełni nie oddaje powodów stojących za nieoczywistymi decyzjami.
Podsumowanie rzeczywistych kosztów
Dla internetowego systemu wyszukiwania twarzy przeszukującego publiczną sieć:
- Zespół inżynieryjny: 3–5 starszych inżynierów przez 12–24 miesiące = od 600 tys. do 2,5 mln USD na wynagrodzenia i koszty pośrednie
- Infrastruktura (rok 1): od 400 tys. do 1 mln USD na chmurę lub sprzęt
- Infrastruktura (bieżąca): od 30 tys. do 80 tys. USD miesięcznie (od 360 tys. do 960 tys. USD rocznie)
- Prawo i zgodność: od 50 tys. do 200 tys. USD na wstępną ocenę oraz bieżącą obsługę prawną
- Łącznie w roku 1: od 1,4 mln do 3,7 mln USD
- Łącznie od roku 2: od 500 tys. do 1,2 mln USD rocznie na infrastrukturę i utrzymanie inżynieryjne
I mówimy o systemie, który działa. Wiele zespołów poświęca od 6 do 12 miesięcy i ponad 500 tys. USD, zanim zda sobie sprawę, że problem jest trudniejszy, niż zakładano, i przejdzie na rozwiązanie oparte na API.
Kiedy budować, a kiedy użyć API
Zbuduj własne rozwiązanie, gdy:
- Masz zamknięty zbiór danych — identyfikatory pracowników, zdjęcia klientów — obejmujący mniej niż 100 tys. twarzy
- System musi działać lokalnie lub w środowisku odizolowanym od sieci
- Masz inżynierów uczenia maszynowego, którzy poradzą sobie z optymalizacją modelu, strojeniem progów i przypadkami brzegowymi
- Twój przypadek użycia dotyczy weryfikacji (1: 1), a nie wyszukiwania (1:N w internecie)
- Masz budżet i czas na wieloletni projekt inżynieryjny
Użyj API, gdy:
- Musisz wyszukiwać twarze w publicznym internecie — mediach społecznościowych, serwisach informacyjnych i witrynach
- Nie chcesz budować i utrzymywać potoku scrapingu oraz indeksowania internetu
- Potrzebujesz wyników teraz, a nie po 12–24 miesiącach prac inżynieryjnych
- System musi być na bieżąco z nowymi treściami publikowanymi online
- Chcesz, aby ktoś inny zajmował się zgodnością z RODO, żądaniami rezygnacji i unijnym aktem w sprawie sztucznej inteligencji
- Chcesz uniknąć ponad 1 mln USD początkowych kosztów infrastruktury i prac inżynieryjnych
- Wyszukiwanie twarzy nie jest główną funkcją Twojego produktu, a czas inżynierów lepiej przeznaczyć na właściwy produkt
API wyszukiwania twarzy FaceCheck.id
Dla programistów potrzebujących wyszukiwania twarzy w publicznym internecie bez budowania infrastruktury od podstaw FaceCheck.id oferuje interfejs REST API, który obsługuje cały potok: wykrywanie, tworzenie osadzeń i wyszukiwanie w stale aktualizowanym indeksie publicznie dostępnych zdjęć twarzy z mediów społecznościowych, serwisów informacyjnych i szerzej pojętego internetu.
FaceCheck.id wykorzystuje autorski model rozpoznawania twarzy zoptymalizowany do wyszukiwania w skali internetu. W przeciwieństwie do modeli open source, które trzeba samodzielnie wdrażać i dostrajać, ich autorski model został specjalnie wytrenowany i dostrojony do wyzwań związanych z wyszukiwaniem twarzy w internecie: bardzo zróżnicowanej jakości obrazów, różnych warunków oświetleniowych, różnorodności demograficznej i ogromnej skali stale indeksowanej bazy. Takie autorskie podejście pozwala niezależnie ulepszać skuteczność modelu i optymalizować go pod kątem konkretnego potoku wyszukiwania w sposób niedostępny dla uniwersalnych modeli open source. Lata prac inżynieryjnych, testów i udoskonaleń sprawiły, że system działa na poziomie, którego odtworzenie od podstaw byłoby niezwykle trudne i kosztowne.
Działanie API:
Wysyłasz obraz twarzy, a API zwraca pasujące twarze znalezione w internecie wraz z ocenami pewności i adresami URL źródeł. Dopasowywanie, indeksowanie i infrastruktura działająca w skali internetu są obsługiwane po stronie usługi. Wszystkie opisane wcześniej klastry GPU, potoki indeksujące, infrastruktura wyszukiwania wektorowego, narzędzia zgodności i bieżące utrzymanie są ich problemem, nie Twoim.
Podstawowe informacje o API:
- Interfejs RESTful JSON API
- Uwierzytelnianie za pomocą klucza API
- Wysyłanie obrazu zakodowanego w base64 lub adresu URL obrazu
- Zwracane dane: tablica dopasowań z wynikami podobieństwa, adresami URL źródeł i podglądami miniatur
- Limity szybkości i ceny skalowane zależnie od użycia
Typowa integracja:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Przypadki użycia API:
- Weryfikacja w aplikacji randkowej: Pozwól użytkownikom sprawdzić, czy zdjęcia dopasowanej osoby występują na prawdziwych profilach społecznościowych
- Ochrona marki: Sprawdź, czy ktoś używa zdjęć Twojego zespołu w fałszywych profilach firmowych
- Platformy należytej staranności: Dodaj wyszukiwanie twarzy do procesów sprawdzania przeszłości lub KYC
- Systemy zwalczania oszustw: Oznaczaj konta używające zdjęć występujących w innych miejscach internetu pod różnymi nazwiskami
- Narzędzia OSINT: Twórz narzędzia śledcze obejmujące dopasowywanie twarzy w skali internetu
Dlaczego warto użyć tego rozwiązania zamiast tworzyć własne:
Zbudowanie wyszukiwarki twarzy przeszukującej publiczny internet wymaga: (1) potoku indeksującego w skali internetu, który znajduje i pobiera miliardy obrazów, (2) infrastruktury GPU kosztującej setki tysięcy dolarów do wykonywania wykrywania twarzy i wyodrębniania osadzeń, (3) rozproszonego systemu wyszukiwania wektorowego z terabajtami pamięci RAM, umożliwiającego odpytywanie pełnego indeksu w czasie rzeczywistym, (4) ciągłego ponownego indeksowania, aby zachować aktualność bazy, (5) infrastruktury zgodności obsługującej rezygnacje, żądania usunięcia danych i wymagania regulacyjne, (6) zespołu od 3 do 5 inżynierów utrzymujących system na pełen etat oraz (7) od 12 do 24 miesięcy do wydania pierwszej użytecznej wersji. Jest to wielomilionowy projekt inżynieryjny ze znacznymi kosztami bieżącymi. API, oparte na autorskim modelu FaceCheck.id i sprawdzonej w praktyce infrastrukturze, zapewnia to wszystko za pomocą jednego wywołania HTTP.
Opisane powyżej modele open source doskonale nadają się do tworzenia zamkniętych systemów rozpoznawania twarzy — kontroli dostępu pracowników, porządkowania bibliotek zdjęć czy niestandardowych procesów weryfikacji. Jeśli jednak Twój przypadek użycia brzmi „przeszukaj internet i znajdź miejsca, w których pojawia się ta twarz”, różnica inżynieryjna między działającym modelem a działającym produktem jest ogromna. API FaceCheck.id wypełnia tę lukę, umożliwiając wydanie działającego produktu w ciągu dni, a nie lat.
Zacznij: Odwiedź facecheck.id/en/Face-Search/API, aby znaleźć dokumentację, ceny i formularz rejestracji klucza API.
Najczęściej zadawane pytania
Który model open source do rozpoznawania twarzy jest najdokładniejszy?
FaceNet512 ze szkieletem Inception-ResNet-v2 osiąga obecnie doskonałe wyniki w większości testów, w tym 99,65% na LFW. W scenariuszach z obrazami niskiej jakości — monitoring, CCTV — AdaFace osiąga lepsze wyniki w trudnych testach takich jak IJB-C, uzyskując TAR@FAR=1e-4 na poziomie 97,39%.
Czy mogę komercyjnie używać modeli open source do rozpoznawania twarzy?
Tak. FaceNet512, FaceNet, DeepFace, dlib i AdaFace są udostępniane na liberalnych licencjach — MIT lub Boost. Można ich używać w produktach komercyjnych. Należy jednak pamiętać o ograniczeniach prawnych dotyczących przetwarzania danych biometrycznych w danej jurysdykcji — RODO, BIPA, unijny akt w sprawie sztucznej inteligencji — które obowiązują niezależnie od licencji oprogramowania.
Ile danych potrzebuję do wytrenowania własnego modelu rozpoznawania twarzy?
Nie musisz trenować modelu od zera. Wymienione wcześniej modele wstępnie wytrenowano na zbiorach zawierających od 5 do 12 mln obrazów i od 100 tys. do 500 tys. tożsamości. Użyj tych modeli i dostrajaj je tylko wtedy, gdy masz konkretne potrzeby dziedzinowe. Dostrajanie wymaga zwykle od 10 tys. do 100 tys. obrazów. Trening od zera wymaga milionów obrazów i znacznych zasobów GPU.
Czym różni się weryfikacja twarzy od wyszukiwania twarzy?
Weryfikacja twarzy (1:1) odpowiada na pytanie „czy te dwa zdjęcia przedstawiają tę samą osobę?”, porównując bezpośrednio dwa osadzenia. Wyszukiwanie twarzy (1:N) odpowiada na pytanie „gdzie pojawia się ta osoba?”, porównując jedno osadzenie z bazą milionów rekordów. Weryfikacja jest prosta obliczeniowo. Wyszukiwanie wymaga wydajnego indeksowania najbliższych sąsiadów — FAISS, Milvus — a w skali internetu również ogromnej infrastruktury indeksującej, której budowa i eksploatacja mogą kosztować miliony.
Jak dokładne jest rozpoznawanie twarzy na obrazach niskiej jakości?
Dokładność znacząco spada wraz z jakością obrazu. Na wyraźnych zdjęciach twarzy widzianych od przodu współczesne modele osiągają ponad 99% dokładności. Na rozmytych nagraniach z monitoringu lub zdjęciach, na których twarz ma mniej niż 50 pikseli szerokości, dokładność może spaść do 80–90% lub jeszcze niżej. AdaFace został zaprojektowany specjalnie po to, by radzić sobie ze zróżnicowaną jakością lepiej niż standardowe modele. W każdym systemie obrazy wejściowe o wyższej rozdzielczości zapewniają zdecydowanie lepsze wyniki. Znaczenie ma również poza: dokładność dla twarzy widzianych z profilu może być o 10–20% niższa niż dla twarzy widzianych od przodu, nawet na obrazach wysokiej rozdzielczości.
Ile kosztuje zbudowanie wyszukiwarki twarzy?
W przypadku systemu działającego w skali internetu i przeszukującego publiczną sieć należy oczekiwać kosztów od 1,4 mln do 3,7 mln USD w pierwszym roku — zespół inżynieryjny + infrastruktura + obsługa prawna — oraz od 500 tys. do 1,2 mln USD rocznie w kolejnych latach. W zamkniętym systemie przeszukującym prywatną bazę zawierającą mniej niż 100 tys. twarzy koszty są radykalnie niższe — wystarczy jeden serwer GPU i jeden inżynier. Koszt rośnie wraz z rozmiarem przeszukiwanej bazy i zależy od tego, czy do jej zapełnienia trzeba indeksować internet.
Ile czasu zajmuje zbudowanie produkcyjnego systemu rozpoznawania twarzy?
W przypadku prostego systemu weryfikacji — dopasowywania 1:1 względem znanej bazy — doświadczony inżynier może zbudować działający prototyp w ciągu 1–2 tygodni i przygotować go do produkcji w ciągu 1–3 miesięcy. W przypadku systemu wyszukiwania twarzy działającego w skali internetu — 1:N względem sieci — należy oczekiwać od 12 do 24 miesięcy pracy zespołu liczącego od 3 do 5 inżynierów, zanim powstanie rozwiązanie wystarczająco niezawodne do produkcji. Wyzwania związane z indeksowaniem, skalowaniem i zgodnością z przepisami wymagają ogromnej ilości czasu poza samą pracą nad uczeniem maszynowym.
Zbuduj coś, co ma znaczenie. W zamkniętym systemie zacznij od FaceNet512. Jeśli jednak potrzebujesz wyszukiwania twarzy w skali internetu, zadaj sobie pytanie: czy naprawdę chcesz wydać od 1,4 mln do 3,7 mln USD, zatrudnić zespół starszych inżynierów i czekać od 12 do 24 miesięcy na pierwszy użyteczny wynik? Zamiast tego możesz całkowicie pominąć klastry GPU, koszmary związane z indeksowaniem, problemy ze zgodnością i lata prac inżynieryjnych, a pierwsze wyniki wyszukiwania uzyskać w mniej niż 5 minut, zaczynając już od 1 USD, dzięki API FaceCheck.id.
Czytaj więcej o wyszukiwaniu przez selfie
Czy istnieje DARMOWA strona do rozpoznawania twarzy?
Chcesz sprawdzić, gdzie Twoje zdjęcie krąży w sieci? A może zastanawiasz się, czy jakiś profil na Instagramie jest prawdziwy? Technologia rozpoznawania twarzy potrafi przeszukać miliony zdjęć w kilka sekund. Zobacz, jak to działa i co możesz dzięki niej zrobić.
Na temat w innych językach
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Popularne tematy
Deepfake Tożsamość Media Społecznościowe Rozpoznawanie Twarzy Facebook Instagram Wyszukiwarka Twarzy Oszuści Identyfikacja Fałszywe Profile Egzekwowanie Prawa Wyszukiwanie Twarzy Sztuczna Inteligencja BiometrycznyPorównanie głów do głowy: PimEyes vs FaceCheck do wyszukiwania twarzy