얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
얼굴을 대조하거나, 사진으로 신원을 확인하거나, 데이터셋 전체에서 특정 얼굴을 검색하는 기능을 개발하려면 현대 얼굴 인식이 내부적으로 실제 어떻게 작동하는지 이해해야 합니다. 마케팅용 설명이 아니라, 원시 픽셀에서 한 사람의 고유한 얼굴 기하학적 특징을 인코딩한 512차원 임베딩 벡터에 이르는 실제 파이프라인을 알아야 합니다.
이 글에서는 전체 얼굴 인식 파이프라인을 분석하고, 2026년에 사용할 수 있는 최고의 오픈 소스 모델을 비교하며, 실제 성능 수치를 제시하고, 자체 시스템을 구축하는 것이 적절한 경우와 프로덕션 API를 사용하는 것이 적절한 경우를 설명합니다.
이 기사에서, 우리는 논의할 예정입니다
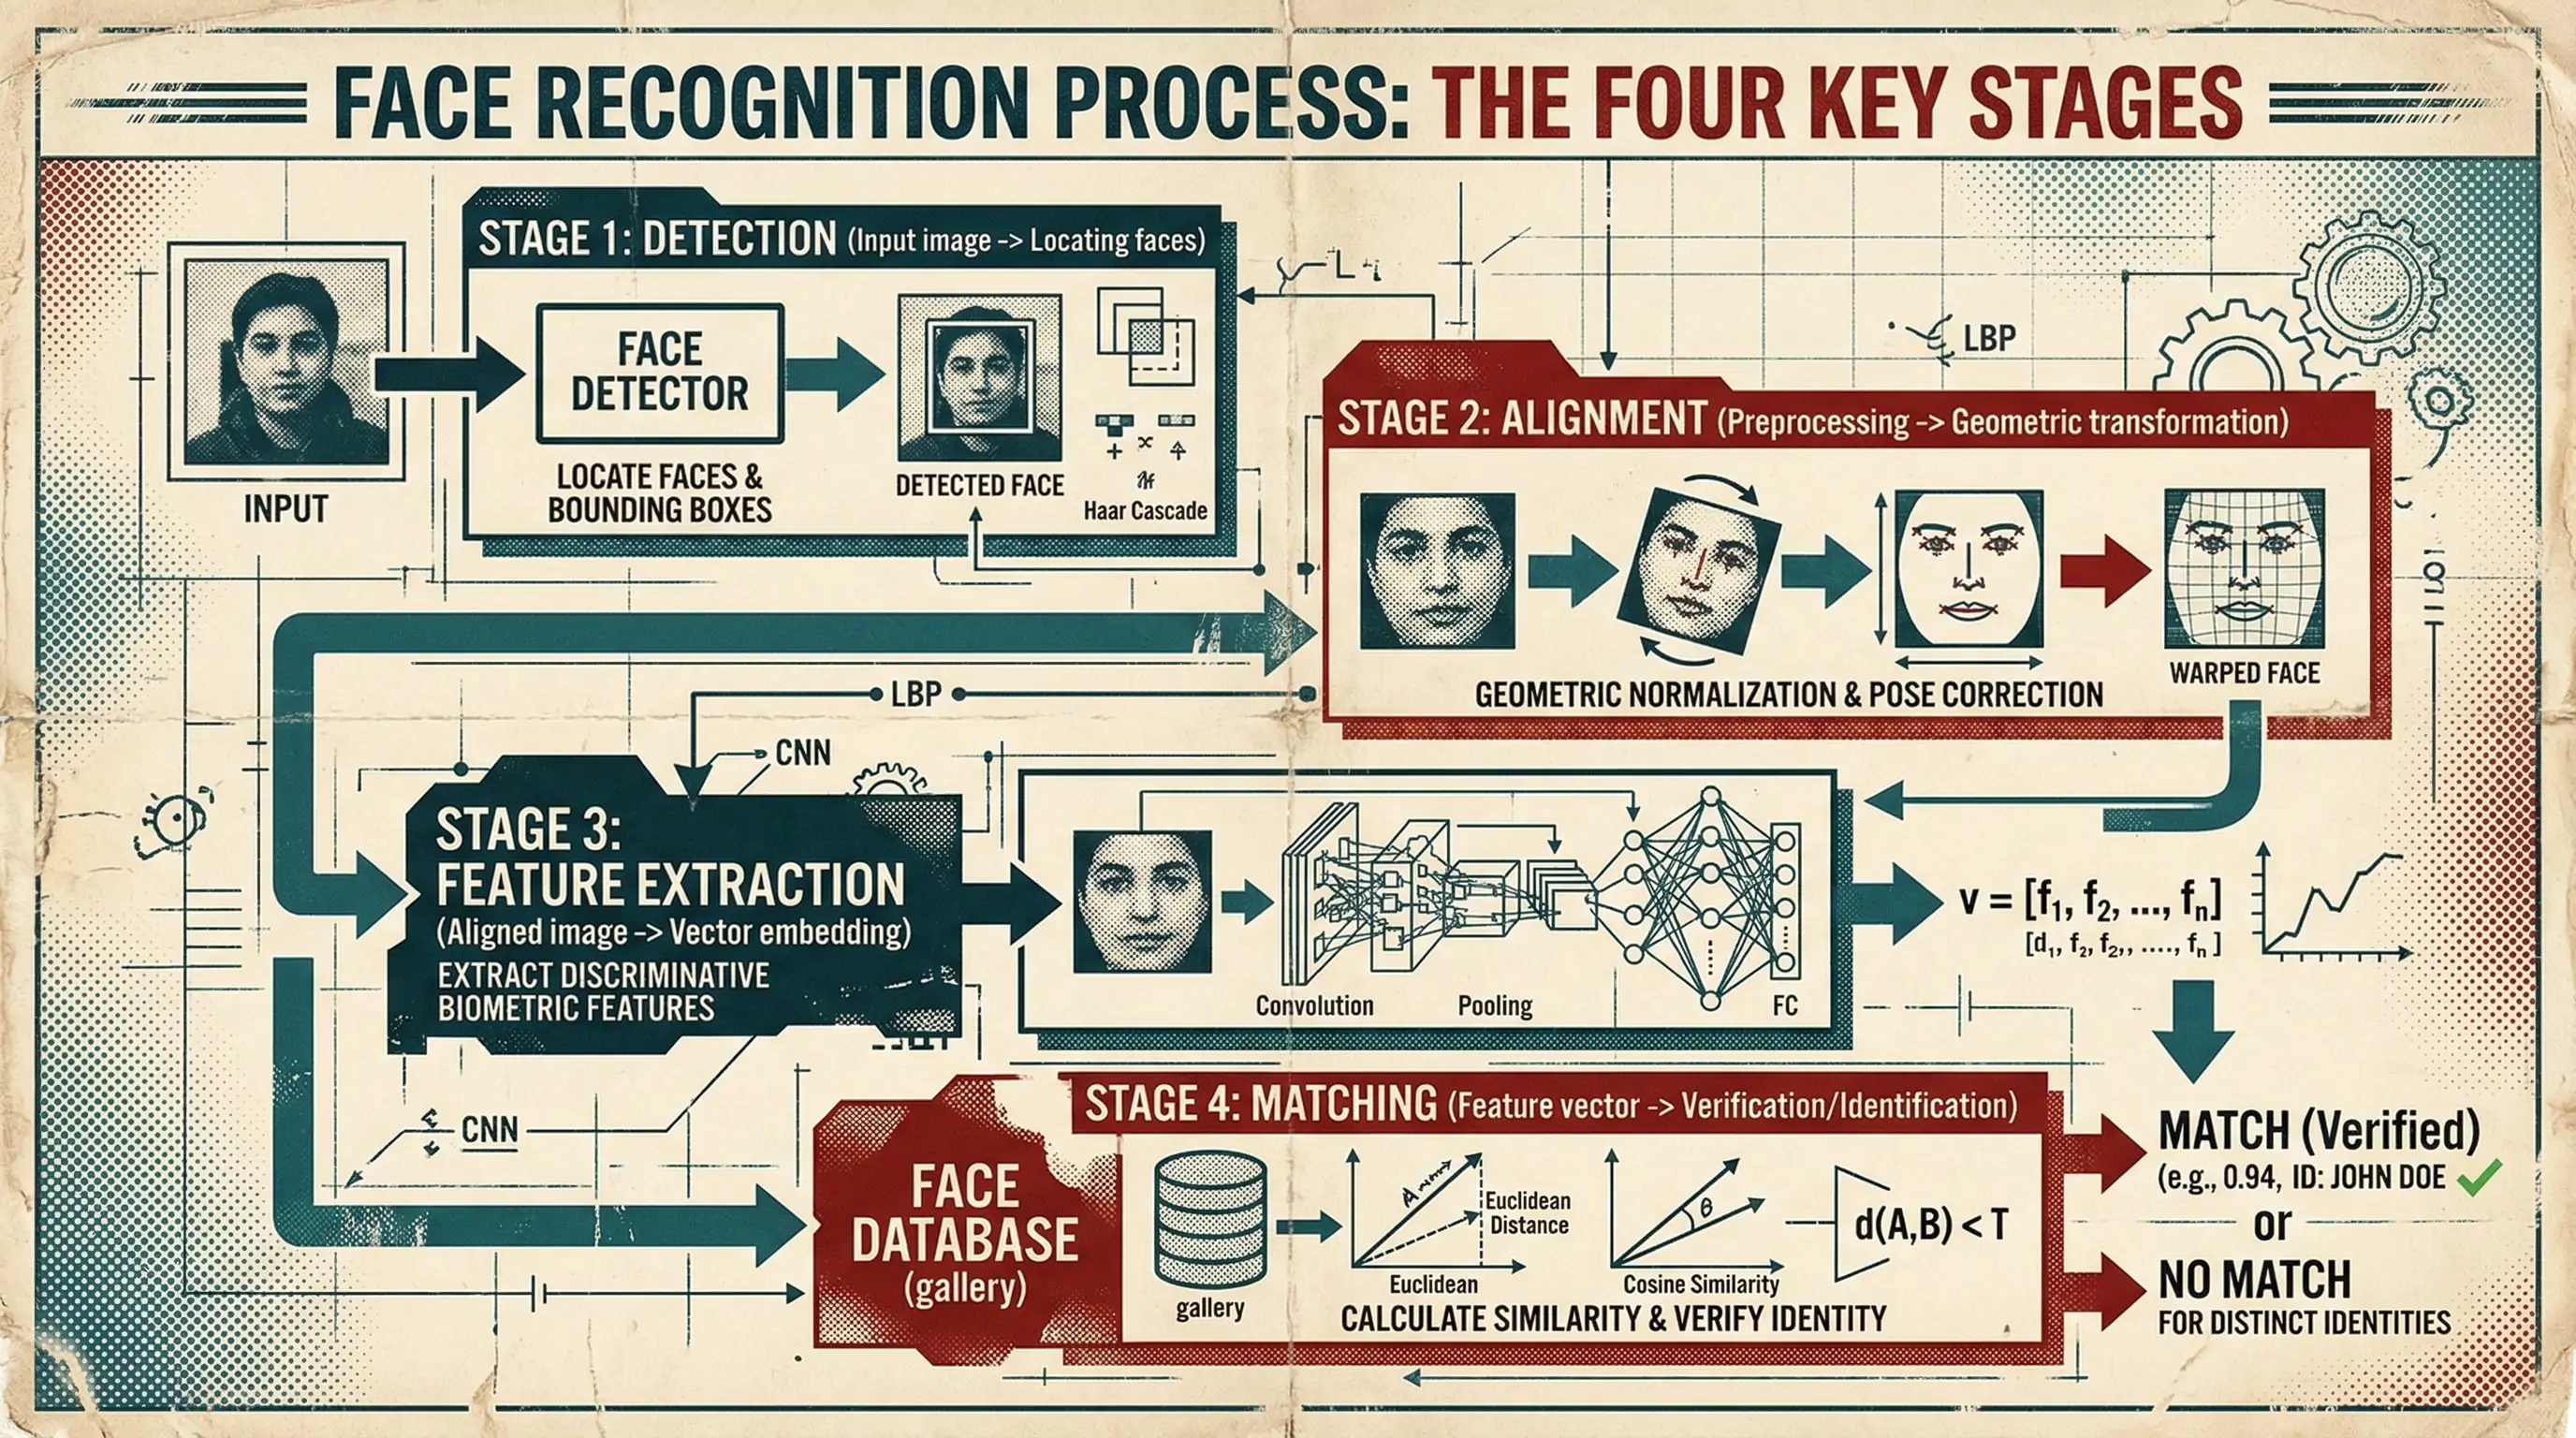
얼굴 인식 파이프라인: 네 단계
현대의 모든 얼굴 인식 시스템은 35달러짜리 Raspberry Pi에서 실행되든 정부 기관의 GPU 클러스터에서 실행되든 동일한 기본 파이프라인을 따릅니다. 이 네 단계를 이해하면 어떤 모델이나 API든 평가할 수 있습니다.
1단계: 얼굴 감지
얼굴을 인식하려면 먼저 얼굴을 찾아야 합니다. 얼굴 감지는 이미지를 입력받아 이미지에 존재하는 모든 얼굴 주위의 경계 상자를 출력합니다. 간단하게 들리지만, 실제 프로덕션 환경에서 많은 시스템이 실패하는 지점입니다.
표준 모델:
- MTCNN (다중 작업 캐스케이드 합성곱 신경망): 2016년부터 얼굴 감지 분야에서 널리 쓰인 대표 모델입니다. 제안 네트워크(P-Net)가 후보 영역을 찾고, 정제 네트워크(R-Net)가 오탐을 걸러내며, 출력 네트워크(O-Net)가 경계 상자를 정교하게 조정하고 얼굴 랜드마크를 출력하는 3단계 캐스케이드 구조입니다. 지금도 널리 사용됩니다. 정면 얼굴에는 정확하지만 극단적인 각도와 가림에는 약합니다. 최신 CPU에서 약 20 FPS로 실행됩니다.
- RetinaFace: 감지 정확도 측면에서 최첨단 모델입니다. [특징 피라미드 네트워크](https://arxiv.org/abs/1612.03144) 백본을 기반으로 구축된 단일 단계 감지기입니다. 경계 상자와 함께 눈, 코, 입꼬리 등 5개의 얼굴 랜드마크를 반환합니다. 다양한 크기를 잘 처리합니다. 속도보다 정확도가 중요하다면 가장 먼저 선택할 모델입니다. GPU에서는 약 15 FPS이며 CPU에서는 더 느립니다.
- SCRFD (효율적인 얼굴 감지를 위한 샘플 및 연산 재분배): 속도 면에서 가장 뛰어난 모델입니다. 모바일 및 엣지 배포용으로 설계되었습니다. RetinaFace 수준의 정확도를 3~10배 빠른 속도로 달성합니다. 매개변수 50만 개부터 3,400만 개까지 다양한 모델 크기를 제공합니다. 모바일에 배포하거나 실시간 처리가 필요하다면 적합한 선택입니다.
- BlazeFace: [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide)를 위해 설계된 Google의 모델입니다. 매우 빠르지만 모바일 GPU에서 200 FPS 이상으로 실행되는 대신 까다로운 각도에서는 정확도가 다소 낮습니다. 모든 프레임을 처리해야 하는 실시간 영상 애플리케이션에 적합합니다.
감지에서 실제로 중요한 요소: 어려운 사례는 조명이 좋은 셀카가 아닙니다. 감시 영상, 얼굴 너비가 50픽셀에 불과한 단체 사진, 극단적인 측면 얼굴, 선글라스나 마스크로 일부가 가려진 얼굴입니다. 감지 모델은 전체 시스템의 성능 상한을 결정합니다. 감지 단계에서 얼굴을 놓치면 후속 단계에서는 이를 복구할 수 없습니다.
다중 얼굴 문제: 이미지에 여러 얼굴이 포함되어 있으면 어떤 얼굴을 임베딩할지 결정해야 합니다. 가장 큰 얼굴, 중앙에 가장 가까운 얼굴, 품질 점수가 가장 높은 얼굴을 선택하거나, 모든 얼굴을 임베딩한 뒤 후속 로직에서 처리하는 전략이 있습니다. 각 선택에는 서로 다른 실패 유형이 있습니다. 단체 사진의 모든 얼굴을 임베딩하면 인덱스가 불필요하게 커지고 검색 결과가 모호해지며, 가장 큰 얼굴만 선택하면 뒷줄에 서 있는 사람을 놓칠 수 있습니다. 대부분의 프로덕션 시스템은 최소 크기 기준, 일반적으로 두 눈 사이가 40~60픽셀 이상인 모든 감지 얼굴을 임베딩하고, 동일한 원본 이미지에 연결된 별도 항목으로 관리합니다.
게이트키퍼 역할을 하는 얼굴 품질 점수: 비용이 큰 임베딩을 계산하기 전에 SER-FIQ 같은 경량 품질 평가기나 MagFace의 품질 브랜치를 실행하면 불량 데이터가 인덱스에 들어가는 것을 방지할 수 있습니다. 흐릿한 얼굴 크롭, 심한 가림, 과다 노출된 얼굴은 모두 신뢰도가 낮은 임베딩을 생성해 검색 결과를 오염시킵니다. 감지 단계에서 품질 기준 미만의 얼굴을 거부하면 후속 정밀도가 크게 향상되고 GPU 연산도 절약됩니다. 이는 전체 파이프라인에서 투자 대비 효과가 가장 높은 최적화 중 하나입니다.
검증을 위한 얼굴 위조 방지: 검증 시나리오에서는 프레젠테이션 공격 감지(PAD)가 매우 중요합니다. 종이 출력물, 화면 재생, 3D 마스크는 모두 임베딩 기반 시스템을 속일 수 있습니다. CDCN이나 PatchNet 같은 모델은 이러한 공격을 감지하지만 얼굴당 5~15ms의 지연 시간이 추가되고 별도의 모델 유지 관리가 필요합니다. 사용자가 입력 이미지를 통제하는 출입 통제, KYC, 인증 시스템을 구축한다면 반드시 위조 방지 기능을 포함해야 합니다. 그렇지 않으면 악용될 수 있습니다.
2단계: 얼굴 정렬
얼굴을 감지한 다음에는 정규화해야 합니다. 머리 자세, 카메라 각도, 거리에 따라 원본 이미지에서 얼굴이 다르게 보이기 때문입니다. 정렬은 감지된 모든 얼굴을 눈이 수평이고, 얼굴이 중앙에 있으며, 크기가 일정한 표준 위치로 변환합니다.
표준 방식은 감지 단계에서 얻은 5개 랜드마크인 왼쪽 눈, 오른쪽 눈, 코끝, 왼쪽 입꼬리, 오른쪽 입꼬리를 사용해 유사 변환을 계산합니다. 이를 통해 감지된 얼굴을 눈이 고정된 픽셀 좌표에 위치하는 표준 160x160픽셀 크롭으로 매핑합니다.
튜토리얼에서는 이 단계를 자주 간과하지만 매우 중요합니다. 정렬에서 2도만 회전 오차가 생겨도 인식 정확도가 1~3% 낮아질 수 있습니다. 대부분의 오픈 소스 파이프라인은 이를 자동으로 처리하지만, 맞춤형 시스템을 구축한다면 FaceNet의 정렬 규격인 160x160 크기와 지정된 눈 좌표를 표준으로 사용하십시오. 대부분의 현대 모델이 이 규격으로 학습되었습니다.
랜드마크 정확도에 대한 정렬 민감도: RetinaFace 랜드마크에는 평균적으로 약 2픽셀의 오차가 있습니다. 이 오차는 정렬 변환 전체로 전파되어 정확도를 1~5% 낮출 수 있습니다. 특히 작은 얼굴 크롭에서는 2픽셀이 전체 얼굴 너비에서 차지하는 비중이 더 크므로 영향도 커집니다. 일부 프로덕션 시스템은 초기 감지 후 더 정밀한 정렬을 위해 Adrian Bulat의 face-alignment 같은 68포인트 또는 98포인트 랜드마크 정제 모델을 추가로 실행합니다. 얼굴당 3~5ms가 더 들지만 최대 정확도가 필요한 사용 사례, 특히 한 번의 잘못된 판단이 중대한 결과를 초래하는 1:1 검증에서는 그만한 가치가 있습니다.
3단계: 특징 추출(임베딩)
얼굴 인식의 핵심 단계입니다. 심층 신경망은 정렬된 얼굴 이미지를 입력받아 임베딩 또는 특징 벡터라고 하는 고정 길이 벡터, 일반적으로 512차원을 출력합니다. 이 벡터는 해당 얼굴의 고유한 특징을 압축해 수치로 표현한 것입니다.
조명, 표정, 합리적인 범위의 나이, 카메라가 달라도 같은 사람의 두 얼굴은 벡터 공간에서 서로 가까운 임베딩을 생성해야 합니다. 서로 다른 두 사람은 멀리 떨어진 임베딩을 생성해야 합니다.
기술적 작동 원리:
네트워크 아키텍처는 일반적으로 수백만 장의 얼굴 이미지로 학습된 수정형 Inception-ResNet 또는 ResNet입니다. 핵심 혁신은 아키텍처 자체가 아니라 학습에 사용되는 손실 함수입니다.
- Softmax 손실(기준선): 얼굴 인식을 분류 문제로 처리합니다. 작동은 하지만 각도 공간에서 임베딩이 충분히 분리되지 않습니다. 현재 인식 용도로는 대부분 더 이상 사용되지 않습니다.
- Triplet 손실: FaceNet이 대중화한 접근 방식입니다. 네트워크가 앵커, 양성, 음성 얼굴 삼중항을 비교하면서 같은 신원의 임베딩은 가깝게, 다른 신원의 임베딩은 멀게 학습합니다. 학습 중 어려운 삼중항을 신중하게 마이닝해야 합니다. 변별력이 매우 높은 임베딩을 생성합니다.
- ArcFace 손실: 2026년 기준으로 프로덕션 얼굴 인식 시스템에서 가장 널리 사용되는 손실 함수라고 할 수 있습니다. 특징 벡터와 이에 대응하는 클래스 가중치 사이의 각도 공간에 가산 각도 마진 페널티를 추가해, 코사인 마진 방식보다 클래스 내부 군집은 더 조밀하고 클래스 간 간격은 더 넓게 만듭니다. [InsightFace](https://github.com/deepinsight/insightface) 프로젝트가 참조 구현을 제공하며, 대부분의 최첨단 모델은 ArcFace 또는 그 변형으로 학습됩니다. 예를 들어 AdaFace의 적응형 마진도 ArcFace 공식을 기반으로 합니다. 자체 얼굴 인식 모델을 학습하거나 미세 조정한다면 ArcFace가 기본 출발점입니다.
- CosFace 손실: Softmax 손실에 코사인 마진을 추가해 네트워크가 각 신원 내부에서는 더 조밀하게 군집되고 신원 간에는 더 멀리 분리된 임베딩을 생성하도록 합니다.
- SphereFace / A-Softmax: 2017년에 등장한 최초의 각도 마진 방식입니다. 역사적으로 중요하지만 현재는 대부분 ArcFace와 더 현대적인 손실 함수로 대체되었습니다.
출력: 단위 초구면에 L2 정규화된 512개 부동소수점 값의 벡터입니다. 얼굴에 관한 모든 정보가 2KB 데이터로 압축됩니다. 이것이 저장되고, 인덱싱되고, 비교되는 데이터입니다.
정규화의 함정: 많은 개발자가 비교 전에 임베딩을 L2 정규화해야 한다는 점을 잊습니다. 정규화되지 않은 임베딩은 매우 일관성 없는 유사도 점수를 생성합니다. 테스트에서는 일치 항목의 상대적 순서가 올바르게 보여 “대체로 작동”하기 때문에 진단하기 어려운 흔한 버그입니다. 하지만 이미지마다 절대 유사도 점수가 변동해 임계값 기반 판단을 신뢰할 수 없게 됩니다. FaceNet512는 기본적으로 정규화된 임베딩을 생성하지만, 맞춤형 모델을 사용하거나 ONNX로 내보낸다면 출력 임베딩이 단위 초구면 위에 있는지, 즉 L2 노름이 1.0인지 반드시 확인해야 합니다.
프로덕션 배포: ONNX Runtime과 양자화: 벤치마크의 속도 수치는 정상 상태의 GPU에서 FP32 추론을 수행한다고 가정합니다. 프로덕션에서는 대부분 ONNX Runtime과 INT8 양자화를 사용하며, 정확도 손실을 최소화하면서 추론 시간을 2~3배 단축합니다. LFW 기준 정확도 손실은 일반적으로 0.1% 미만입니다. 작업 흐름은 PyTorch 또는 TensorFlow 모델을 ONNX로 내보내고, 약 1,000장의 얼굴 이미지로 구성된 보정 데이터셋을 사용해 ONNX Runtime 양자화 도구를 실행한 뒤 양자화된 모델을 배포하는 것입니다. 같은 하드웨어에서 얼굴당 10ms를 3~4ms로 줄이는 방법이며, 수십억 장의 이미지를 처리할 때는 매우 중요합니다.
혼합 정밀도 추론: GPU 백본에는 FP16을 사용하고 최종 임베딩 계층에는 FP32를 사용하면 이 글의 뒷부분에서 설명할 부동소수점 정밀도 문제를 피하면서도 1.5~2배의 속도 향상을 얻을 수 있습니다. 이는 정확하지만 느린 완전 FP32와, 빠르지만 하드웨어에 따라 미묘하게 다른 임베딩을 생성할 수 있는 완전 FP16 사이의 실용적인 절충안입니다.
엣지 배포를 위한 임베딩 증류: 지식 증류를 통해 더 작은 학생 네트워크인 MobileFaceNet, 약 100만 개 매개변수가 FaceNet512의 임베딩을 모방하도록 학습할 수 있습니다. 학생 모델은 10배 빠른 속도로 95% 이상의 정확도를 확보할 수 있어 GPU를 사용할 수 없는 모바일 및 엣지 배포에 적합합니다. 핵심은 학생 모델을 얼굴 신원 레이블로 처음부터 학습할 필요가 없다는 것입니다. 레이블이 없는 얼굴 데이터에서 교사 모델의 임베딩을 재현하도록 학습하므로 훨씬 적은 연산 자원만 필요하고 신원 레이블 데이터셋도 필요하지 않습니다.
4단계: 대조
두 얼굴 임베딩이 주어졌을 때 같은 사람인지 어떻게 판단할까요? 두 가지 접근 방식이 있습니다.
코사인 유사도: 두 임베딩 벡터 사이 각도의 코사인을 계산합니다. 범위는 -1부터 1까지이며 1은 동일함을 의미합니다. “같은 사람”을 판단하는 일반적인 임계값은 모델과 사용 사례에 따라 0.4~0.6입니다. 간단하고 빠르며 FaceNet512 임베딩이 L2 정규화되어 있어 효과적으로 작동합니다.
유클리드 거리: 벡터 사이의 L2 거리를 계산합니다. 정규화된 임베딩에서는 코사인 유사도와 수학적으로 동등합니다(d = sqrt(2 - 2*cos_sim)). 일부 시스템은 이 공식을 선호합니다.
검색(1:N 대조)의 경우: 수백만 개의 데이터베이스에서 얼굴을 찾아야 할 때는 무차별 비교가 너무 느립니다. 근사 최근접 이웃(ANN) 검색을 사용하십시오.
- FAISS (Facebook AI 유사도 검색): 표준 라이브러리입니다. GPU 가속과 IVF, HNSW, PQ 등 여러 인덱스 유형을 지원합니다. 10억 개의 벡터를 밀리초 단위로 검색할 수 있습니다. 무료 오픈 소스입니다.
- Milvus: 내부적으로 FAISS를 사용하면서 영속성, 확장성, API 계층을 추가한 벡터 전용 데이터베이스입니다.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): 인프라를 직접 운영하고 싶지 않을 때 사용할 수 있는 관리형 벡터 데이터베이스입니다.
얼굴 1,000만 개로 구성된 데이터베이스에서 잘 조정된 FAISS HNSW 인덱스를 단일 GPU에서 실행하면 5밀리초 이내에 상위 10개 일치 항목을 반환할 수 있습니다.
FAISS 인덱스 유형 선택은 매우 중요합니다. IVF-PQ는 벡터당 2KB 대신 8~16바이트를 사용하는 뛰어난 압축률을 제공하지만, 양자화 오차로 실제 일치 항목이 임계값 아래로 밀리는 경계선 사례에서는 정확도를 잃습니다. HNSW는 정확도를 보존하지만 전체 부동소수점 벡터와 그래프 구조를 함께 저장하므로 메모리를 4~8배 더 사용합니다. IVF-HNSW 하이브리드 인덱스는 1,000만~10억 규모에서 가장 좋은 절충안을 제공합니다. 대부분의 팀은 처음에 튜토리얼 추천만 보고 잘못된 인덱스 유형을 선택한 뒤, 6개월 후 한계에 도달해 전체 인덱스 인프라를 다시 구축합니다. 특정 인덱스 유형을 채택하기 전에 현실적인 데이터 규모와 쿼리 패턴으로 실제 워크로드를 테스트하십시오.
ANN 인덱스의 콜드 스타트 문제: HNSW와 IVF 인덱스가 제대로 작동하려면 최소한의 벡터 수가 필요합니다. 벡터가 약 1만 개 미만이면 그래프 순회와 중심점 비교 같은 인덱스 오버헤드가 연산보다 커져 무차별 검색이 오히려 더 빠릅니다. 초기 성장 단계에는 무차별 검색인 FAISS IndexFlatIP로 시작하고, 데이터베이스가 5만~10만 개 벡터를 넘으면 ANN 인덱스로 이전하십시오.
이진 코드를 이용한 사전 필터링: 각 임베딩의 이진 해시를 이진화 또는 SimHash로 계산하면 비용이 큰 부동소수점 비교 전에 저렴한 해밍 거리 사전 필터를 적용할 수 있습니다. 재현율 손실을 최소화하면서 후보 집합을 90% 이상 줄일 수 있습니다. 각 전체 임베딩과 함께 256비트 또는 512비트 이진 코드를 저장하는 방식입니다. 쿼리가 들어오면 먼저 모든 이진 코드와의 해밍 거리를 계산하고, CPU POPCNT 명령어로 매우 빠르게 처리한 뒤, 상위 1~5% 후보에 대해서만 정확한 코사인 유사도를 계산합니다. 이 2단계 방식은 데이터셋이 사용 가능한 GPU 메모리를 초과할 때 특히 효과적입니다.
얼굴 속성을 이용한 재순위화: 최초 임베딩 검색이 후보를 반환하면, 추정 속성인 연령대, 성별, 피부색, 수염 등을 사용하는 두 번째 단계에서 명백한 오탐을 걸러낼 수 있습니다. 쿼리 얼굴이 25세 여성으로 추정되고 후보는 60세 남성으로 추정된다면 임베딩 유사도 점수와 관계없이 거의 확실한 오탐입니다. 이 간단한 휴리스틱은 적은 연산 비용으로 오탐을 30~50% 줄일 수 있으며, 프로덕션 얼굴 검색에서 가장 적게 활용되는 기법 중 하나입니다.
영상의 시간적 일관성: 정지 이미지가 아니라 영상에서 얼굴을 대조한다면 추적된 동일 얼굴의 여러 프레임에 걸쳐 임베딩을 평균화하는 방식으로 정확도를 크게 높일 수 있습니다. 어려운 벤치마크에서는 흔히 5~10% 향상됩니다. 트랙 수준 임베딩 집계는 프레임 수준 대조보다 확실히 우수합니다. SORT 또는 DeepSORT 같은 얼굴 추적기를 사용해 프레임 간 감지를 연결하고, 각 감지에 대한 임베딩을 계산한 뒤, 감지 단계의 얼굴 품질 점수를 가중치로 사용하는 품질 가중 평균을 통해 하나의 “트랙 임베딩”으로 집계합니다.
최고의 오픈 소스 얼굴 인식 모델(2026년)
FaceNet512
업계 표준입니다. FaceNet512는 Google FaceNet 아키텍처의 512차원 임베딩 변형으로, 원래의 128차원 버전보다 더 크고 변별력 높은 임베딩 공간을 제공합니다.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- 아키텍처: 512차원 임베딩을 생성하는 Inception-ResNet-v2 백본
- 라이선스: MIT, 제한이 적고 상업적 사용 가능
- LFW 정확도: 99.65%
- 임베딩 크기: 512차원
- 포함 사항: 엔드투엔드 인식을 위해 표준 감지 파이프라인인 MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)와 연동
- Python API:
deepface라이브러리 또는 독립형 구현을 통해 이용 가능
평가: 2026년에 얼굴 인식 시스템을 구축한다면 FaceNet512는 강력한 출발점입니다. 뛰어난 정확도, 높은 변별력을 제공하는 512차원 임베딩, 제한이 적은 MIT 라이선스, 폭넓은 생태계 지원이 장점입니다.
FaceNet (Google, 원본 128차원)
2015년에 임베딩 접근 방식을 대중화한 모델입니다. 네트워크가 앵커, 양성, 음성 얼굴 삼중항을 비교해 학습하는 Triplet 손실 학습을 도입했습니다.
- 원 논문: “FaceNet: 얼굴 인식 및 군집화를 위한 통합 임베딩” (Schroff 외, 2015년)
- 저장소: 여러 구현이 있으며 davidsandberg/facenet이 대표적인 TensorFlow 버전
- 라이선스: MIT
- LFW 정확도: 원본 99.63%, 현대적 학습 적용 시 최대 99.75%
- 임베딩 크기: 128차원
- 아키텍처: Inception-ResNet-v1 또는 Inception-ResNet-v2
평가: 역사적으로 중요하며 지금도 잘 작동합니다. 128차원 임베딩은 더 작지만 512차원 FaceNet512 변형보다 변별력이 약간 낮습니다. 임베딩 저장 공간을 줄여야 하거나 메모리 제약이 있는 TensorFlow 환경에서 작업할 때 사용하십시오.
DeepFace (Facebook/Meta)
Python 라이브러리 deepface(소문자)와 혼동하면 안 됩니다. Meta의 DeepFace(2014년)는 얼굴 인식에 딥러닝을 적용한 초기 접근 방식 중 하나로, LFW에서 인간에 가까운 정확도를 달성했습니다.
오늘날 더 관련성이 높은 프로젝트는 Serengil의 deepface Python 라이브러리입니다.
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- 저장소: github.com/serengil/deepface
- 라이선스: MIT
- 기능: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib, SFace 등 여러 백엔드 모델에 통합 API를 제공하는 래퍼 라이브러리
- 포함 사항: 검증, 검색, 얼굴 속성 분석(나이, 성별, 인종, 감정)
- 사용 편의성: 매우 간단한 API
평가: 프로토타이핑과 실험에 가장 적합합니다. 통합 API를 사용하면 매개변수 하나만 변경해 모델을 교체할 수 있습니다. 프로덕션에서는 성능과 제어 능력을 높이기 위해 FaceNet512를 직접 사용하는 것이 좋습니다.
dlib
Davis King이 관리하는 Python 바인딩 포함 C++ 라이브러리입니다. 300만 장의 이미지 데이터셋으로 학습된 얼굴 인식 모델을 포함합니다.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- 저장소: github.com/davisking/dlib
- 라이선스: Boost 소프트웨어 라이선스, 제한이 적음
- LFW 정확도: 99.38%
- 임베딩 크기: 128차원
- 감지: HOG 기반, 빠르고 CPU 친화적이며 CNN 기반은 더 정확함
평가: 견고하고 실전에서 검증된 C++ 라이브러리로 Python 바인딩도 우수합니다. FaceNet512보다 정확도는 낮지만 매우 안정적입니다. C++로 작업하거나 PyTorch/ONNX 의존성이 없는 경량 솔루션이 필요할 때 좋은 선택입니다.
AdaFace
이미지 품질 편차를 구체적으로 해결하는 비교적 새로운 모델로 2022년에 공개되었습니다. 표준 모델은 고품질 이미지로 학습되므로 저해상도 또는 흐릿한 입력에서 성능이 저하됩니다. AdaFace는 학습 중 이미지 품질에 따라 마진 페널티를 조정합니다.
- 저장소: github.com/mk-minchul/AdaFace
- 라이선스: MIT
- 주요 장점: 저품질 이미지에서 뛰어난 성능, 감시 영상과 장거리 카메라에 적합
- LFW 정확도: 99.82%
- IJB-C TAR@FAR=1e-4: 97.39%, 어려운 벤치마크에서 대부분의 오픈 소스 모델보다 우수
평가: 입력 이미지 품질이 낮을 때 사용하십시오. 감시, CCTV 분석 또는 이미지 품질을 통제할 수 없는 시나리오에서 AdaFace는 표준 모델보다 측정 가능한 수준으로 더 나은 결과를 제공합니다.
성능 비교표
| 모델 | LFW(%) | 임베딩 | 속도(얼굴당 ms) | 라이선스 |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99.65 | 512차원 | 약 10ms(GPU) | MIT |
| FaceNet (IR-v1) | 99.63 | 128차원 | 약 12ms(GPU) | MIT |
| AdaFace (R100) | 99.82 | 512차원 | 약 9ms(GPU) | MIT |
| dlib ResNet | 99.38 | 128차원 | 약 25ms(CPU) | Boost |
| VGG-Face2 | 99.43 | 2048차원 | 약 15ms(GPU) | CC BY-SA |
LFW(Labeled Faces in the Wild)는 표준 벤치마크지만 사실상 이미 정복되었습니다. 모든 현대 모델이 99% 이상의 점수를 기록합니다. 실제 차이는 다양한 조건을 다루는 IJB-C와 저해상도를 다루는 TinyFace 같은 더 어려운 벤치마크에서 나타납니다.
벤치마크와 현실의 차이: 이 속도 수치는 예열된 GPU에서 단일 얼굴에 대해 FP32 추론을 실행한 결과입니다. 프로덕션에서 ONNX Runtime INT8 양자화를 사용하면 2~3배 더 빠른 속도를 기대할 수 있습니다. 하지만 감지, 정렬, 품질 점수, 임베딩을 포함한 전체 파이프라인은 임베딩 추출만 수행할 때보다 3~5배 오래 걸립니다. 단일 A100 GPU에서 전체 파이프라인의 현실적인 엔드투엔드 처리량은 초당 얼굴 200~400개이며, 임베딩 전용 벤치마크가 암시하는 수천 개 수준은 아닙니다.
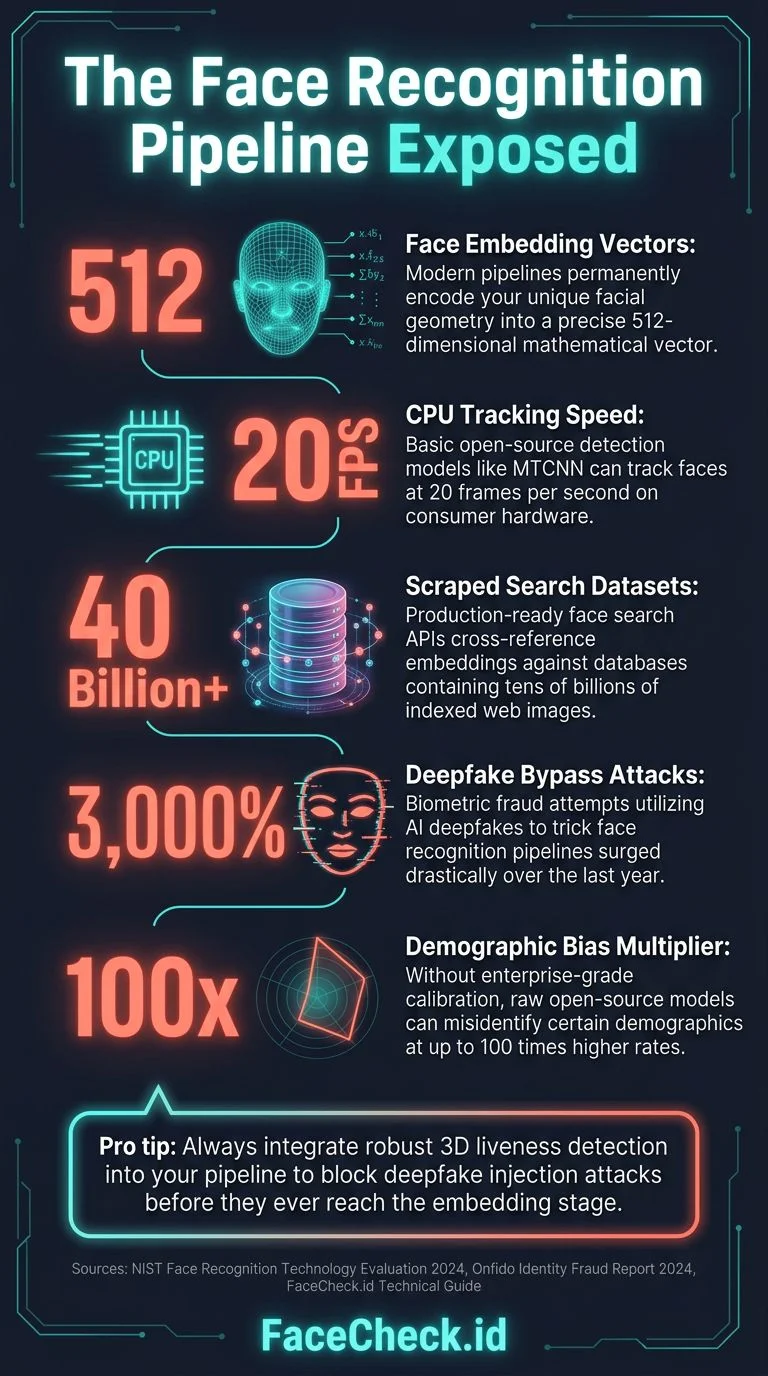
오픈 소스 모델과 프로덕션 시스템 사이의 격차
튜토리얼에서 알려주지 않는 사실이 있습니다. Jupyter 노트북에서 얼굴 인식 모델을 실행하는 것은 쉬운 부분입니다. 대규모로 실제 작동하는 프로덕션 시스템을 구축하려면 어떤 모델도 대신 해결해 주지 않는 수많은 엔지니어링 문제를 해결해야 합니다. 대부분의 팀은 비용과 일정을 모두 크게 과소평가합니다. “모델만 연결하면 된다”고 보였던 프로젝트는 프로덕션 준비 전까지 50만~200만 달러 이상이 쉽게 투입되는 12~24개월짜리 엔지니어링 작업으로 변합니다. 지속적인 운영 비용은 여기에 포함되지도 않습니다.
인프라 비용
임베딩 추출용 GPU 연산. 수십억 장의 이미지에서 얼굴 감지와 임베딩 추출을 실행하는 작업은 노트북으로 할 수 있는 일이 아닙니다. 단일 NVIDIA A100 GPU는 감지, 정렬, 임베딩을 포함한 전체 파이프라인에서 초당 약 200~400개의 얼굴을 처리할 수 있습니다. 10억 장의 이미지를 합리적인 기간인 일주일 이내에 처리하려면 GPU 40~80대로 구성된 클러스터를 계속 가동해야 합니다. 클라우드 요금 기준으로 처리 1회당 5만~15만 달러가 들며, 모델이 개선되거나 파이프라인이 변경될 때마다 다시 처리해야 합니다. 하드웨어를 직접 구매하면 GPU 서버에 30만~80만 달러가 들고, 랙 공간, 전력, 냉각 및 유지 관리 인력도 필요합니다.
대규모 저장 공간. 512개 부동소수점 값, 즉 각각 2KB인 얼굴 임베딩 10억 개는 벡터 데이터만 약 2TB입니다. 원본 이미지, 썸네일, 메타데이터, 인덱스 구조를 더하면 수백 TB에서 수 PB의 저장 공간이 필요합니다. 벡터 인덱스용 고성능 NVMe 스토리지는 클라우드에서 월 GB당 0.10~0.25달러입니다. 핫 스토리지 50TB라면 시스템 유지에만 매월 5,000~12,500달러가 듭니다.
벡터 검색 인프라. 단일 시스템의 FAISS는 인덱스 유형과 사용 가능한 RAM에 따라 약 1억~5억 개 벡터가 한계입니다. 이를 넘으면 여러 샤드에 걸친 분산 검색, 부하 분산, 장애 허용을 위한 복제, 인덱스를 담을 충분한 RAM이 필요합니다. 10억 개 이상의 벡터를 위한 프로덕션급 분산 FAISS 또는 Milvus 배포에는 일반적으로 각각 256GB 이상의 RAM을 갖춘 고용량 메모리 시스템 8~16대가 필요하며, 클라우드 연산 비용은 월 1만 5,000~4만 달러입니다.
네트워크와 대역폭. 수십억 장의 이미지를 크롤링하려면 수 PB의 데이터를 내려받아야 합니다. 주요 클라우드 제공업체의 외부 전송 비용이 GB당 0.05~0.09달러이므로 데이터 전송만으로 수만 달러가 들 수 있습니다. 크롤러, GPU 처리 노드, 스토리지 백엔드 사이에 높은 처리량을 제공하는 내부 네트워크도 필요합니다.
웹 규모 얼굴 검색 엔진의 총 인프라 비용 추정치: 지속적인 클라우드 비용으로 월 3만~8만 달러, 또는 초기 하드웨어 비용 50만~150만 달러에 전력, 대역폭, 유지 관리 비용으로 월 1만~2만 달러가 필요합니다. 이는 엔지니어가 애플리케이션 코드 한 줄을 작성하기도 전의 인프라 비용입니다.
엔지니어링 일정
프로덕션 얼굴 검색 시스템 구축은 해커톤 프로젝트가 아닙니다. 숙련된 엔지니어 3~5명으로 구성된 팀의 현실적인 일정은 다음과 같습니다.
1~3개월: 핵심 파이프라인. 감지, 정렬, 임베딩 추출이 안정적으로 작동하도록 합니다. 기본 벡터 인덱스를 구축합니다. 로컬 파일의 이미지 수집을 처리합니다. 모든 것이 순조로워 보이고 데모도 인상적으로 보이는 “재미있는” 단계입니다.
3~6개월: 웹 크롤링 인프라. 주요 플랫폼용 스크레이퍼를 구축합니다. 속도 제한, CAPTCHA, 로그인 장벽, 동적 렌더링, JavaScript 중심 사이트, 이미지 중복 제거, 콘텐츠 필터링을 처리합니다. 소셜 미디어 플랫폼마다 서로 다른 스크래핑 방지 조치가 있고 매주 크롤러를 망가뜨린다는 사실을 알게 됩니다. 크롤러가 조용히 실패할 때 이를 감지하는 모니터링을 구축합니다. 웹은 복잡하고 적대적이므로 이 단계만 예상보다 오래 걸릴 수 있습니다.
6~9개월: 규모와 안정성. 프로토타입은 얼굴 100만 개에서 작동했습니다. 이제 1억 개에서 작동하도록 만들어야 합니다. FAISS 인덱스가 더 이상 RAM에 들어가지 않는다는 사실을 발견합니다. 샤딩을 구현합니다. 수집 파이프라인의 경쟁 상태를 수정합니다. 다운로드에 실패하는 이미지 15%를 위한 재시도 로직을 구축합니다. 손상된 이미지, JPEG라고 주장하지만 실제로는 아닌 이미지, EXIF 회전 플래그가 있는 이미지, 불완전하게 다운로드된 이미지를 처리합니다. 새벽 3시에 문제가 발생했을 때 알 수 있도록 모니터링, 경고, 로깅을 추가합니다.
9~12개월: 품질과 정확도. 대규모 환경에서 오탐률을 감당할 수 없다는 사실을 깨닫습니다. 불량 임베딩을 거르기 위해 얼굴 품질 점수를 구현합니다. 사용 사례별로 임계값을 조정합니다. 잘못된 일치 항목을 신고하고 조사할 수 있는 피드백 메커니즘을 구축합니다. 부동소수점 정밀도 차이 때문에 GPU 아키텍처별로 모델 결과가 다르다는 사실을 발견하고 이를 추적하는 데 2주를 보냅니다.
12~18개월: 프로덕션 강화. 인증, 속도 제한, 사용량 추적 기능이 있는 API 계층을 구축합니다. GDPR/CCPA 준수 기능인 거부 메커니즘, 데이터 삭제 요청, 감사 로그를 추가합니다. 결과 캐싱을 구현합니다. 관리 도구를 구축합니다. 문서를 작성합니다. 보안 감사를 처리합니다. 모든 요소에 부하 테스트를 수행합니다. 존재하는지도 몰랐던 메모리 누수를 수정합니다.
18~24개월: 지속적인 운영. 웹사이트가 레이아웃을 바꾸면 크롤러가 작동하지 않습니다. 새로운 유형의 이미지가 나타나면서 모델이 드리프트합니다. 디스크가 가득 찹니다. 인덱스를 재구축해야 합니다. 사용자가 예상하지 못한 예외 사례를 신고합니다. 시스템이 만화 얼굴에도 확신도 높은 일치 결과를 반환한다는 사실을 누군가 발견해 “실제 얼굴” 필터를 추가해야 합니다. 이 과정은 끝나지 않습니다.
겪게 될 문제의 전체 목록
인프라와 일정 외에도 팀이 얼굴 인식 시스템을 처음부터 구축하면서 겪는 모든 주요 문제를 살펴보겠습니다. 이 목록은 이론적인 우려가 아니라 실제 프로덕션 시스템에서 나온 것입니다.
데이터 품질의 악몽:
- 입력이 쓰레기면 출력도 쓰레기입니다. 인터넷에는 밈, AI 생성 얼굴, 그림, 사진을 다시 찍은 사진, 잡지 표지, 동상이 넘쳐납니다. 감지기는 이 모든 것에서 “얼굴”을 찾아 인덱스를 오염시키는 임베딩을 생성합니다. 합성 얼굴, 삽화 얼굴, 극단적으로 저해상도인 크롭, 사진이 아닌 콘텐츠를 걸러낼 분류기가 필요합니다. 이러한 필터를 구축하고 유지하는 것 자체가 하나의 프로젝트입니다.
- 중복 및 유사 중복 이미지. 같은 사진이 서로 다른 크롭, 워터마크, 압축 수준, 색상 조정이 적용되어 수십 개 사이트에 나타납니다. 중복 제거를 하지 않으면 바이럴 사진 하나가 모두 같은 이미지인 “일치 항목” 수백 개를 생성해 실제 결과를 묻어버립니다. 지각 해싱, 즉 pHash와 dHash가 도움이 되지만 완벽하지는 않습니다. URL 수준 중복 제거, 크기 변경 및 재압축된 사본을 잡는 지각 해시 중복 제거, 약간 다른 각도에서 촬영된 같은 얼굴을 잡는 임베딩 수준 중복 제거 등 여러 수준에서 처리해야 합니다. 각 수준은 다른 수준이 놓치는 항목을 잡아내며, 예상보다 훨씬 많은 시간을 중복 제거에 쓰게 됩니다.
- 나이와 외모 변화. 대학 시절 사진에서 생성한 얼굴 임베딩은 15년 후 사진과 일치하지 않을 수 있습니다. 체중 변화, 노화, 성형 수술, 수염, 헤어스타일 차이는 모두 인식 정확도에 영향을 줍니다. 이를 완벽하게 처리하는 모델은 없습니다. 20년 차이의 사진을 대조하지 못하면 사용자는 시스템을 탓할 것입니다.
- 인구통계학적 편향. 주로 서구인 또는 백인 데이터셋으로 학습된 오픈 소스 모델은 다른 인구 집단에서 성능이 낮습니다. 민족 간 정확도 격차는 LFW가 보여주는 것보다 큽니다. LFW는 약 77%가 백인입니다. 전 세계에 배포하면 어려운 벤치마크에서 인구 집단 간 정확도 격차가 5~15%에 이를 수 있습니다. MS-Celeb-1M으로 학습된 FaceNet512 같은 모델은 해당 데이터셋의 인구통계학적 편향을 물려받습니다. BUPT-Balancedface 같은 균형 잡힌 데이터셋으로 미세 조정하거나 인구통계를 고려한 학습 전략을 사용하는 것이 공정한 성능을 위해 중요합니다. 인종 집단별 정확도를 평가하지 않으면 일부 사용자에게는 잘 작동하고 다른 사용자에게는 제대로 작동하지 않는 시스템을 출시할 수 있습니다. 이는 윤리 문제일 뿐 아니라 제품 품질과 법적 책임의 문제이기도 합니다.
- EXIF 방향 처리. 웹 이미지의 약 15~20%에는 EXIF 방향 태그가 있으며, 이를 무시하면 얼굴이 옆으로 눕거나 거꾸로 표시됩니다. 대부분의 얼굴 감지기는 회전된 얼굴을 찾지 못합니다. 테스트에서는 올바른 방향의 이미지를 사용하므로 놓치기 쉽지만 프로덕션에는 치명적인 조용한 정확도 저하 요인입니다. 이미지 처리 파이프라인의 첫 단계에서 항상 EXIF 방향을 보정하십시오.
- 프로그레시브 JPEG 및 WebP 디코딩 실패. 일부 이미지 라이브러리는 일부만 다운로드된 프로그레시브 JPEG나 잘린 WebP 파일에서 손상된 픽셀 데이터를 아무 경고 없이 생성합니다. 얼굴 감지기는 손상 아티팩트에서 여전히 “얼굴”을 찾아 불량 임베딩을 생성할 수 있습니다. 처리 전에 파일이 오류 없이 디코딩되는지, 결과 픽셀 버퍼의 크기가 합리적인지 확인하는 이미지 무결성 검증이 필요합니다. 그렇지 않으면 손상된 이미지가 조용히 인덱스를 오염시킵니다.
처음에는 명확하지 않은 엔지니어링 문제:
- 임베딩 버전 관리. 모델을 업그레이드하면, 정확도 개선이 중요하므로 결국 업그레이드하게 됩니다. 데이터베이스의 모든 임베딩이 새 모델의 출력과 호환되지 않게 됩니다. 전체 데이터베이스를 다시 임베딩하거나, 비용과 시간이 많이 들며 모든 원본 이미지를 보관해야 합니다. 이전 중에는 병렬 인덱스를 실행해 인프라 비용을 두 배로 부담하거나, 복잡하고 개선 능력을 제한하는 하위 호환성을 유지해야 합니다. 좋은 해결책은 없고 덜 고통스러운 선택지만 있습니다.
- 부동소수점 결정성. 같은 이미지라도 GPU 모델, CUDA 버전, 심지어 배치 크기가 다르면 부동소수점 연산 때문에 임베딩이 약간 다를 수 있습니다. 차이는 1e-6~1e-4로 작지만 누적됩니다. 한 시스템에서 0.401인 일치 점수가 다른 시스템에서는 0.399가 되어 이진 임계값 판단이 뒤집힐 수 있습니다. 디버깅할 때 매우 골치 아픈 문제입니다. GPU 드라이버 업데이트는 특히 위험합니다. NVIDIA 드라이버 업데이트는 CUDA 수준의 부동소수점 동작을 바꿀 수 있습니다. 535.x 드라이버에서 계산한 임베딩은 545.x에서 같은 이미지를 처리한 결과와 다를 수 있습니다. 프로덕션에서는 전체 시스템의 드라이버 버전을 고정하고 업데이트 후 임베딩 일관성을 검증해야 합니다.
- 동시성과 경쟁 상태. 여러 크롤러가 동시에 얼굴을 수집하고, 인덱스를 업데이트하는 동안 사용자가 쿼리하며, 검색 결과를 조립하는 도중 삭제 요청이 들어옵니다. 벡터 데이터베이스에는 SQL 데이터베이스만큼 성숙한 트랜잭션 지원이 없습니다. 얼굴이 일부만 인덱싱되거나, 쿼리가 오래된 결과를 반환하거나, 삭제가 모든 샤드에 전파되지 않는 상황을 겪게 됩니다.
- 메모리 관리. FAISS 인덱스는 메모리 매핑되지만 쿼리 성능은 인덱스의 어느 정도가 RAM에 들어가는지에 크게 좌우됩니다. 인덱스가 커지면 운영체제가 인덱스 페이지를 메모리에서 축출할 때 쿼리 지연 시간이 예측할 수 없이 급증합니다. OOM 종료는 항상 최악의 순간에 발생합니다. Linux 메모리 관리, 스왑 설정, [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access) 토폴로지를 깊이 이해하게 될 것입니다. 콜드 스타트 후 예열도 문제입니다. FAISS HNSW 인덱스는 메모리 매핑되므로 서버 재시작 후 인덱스 페이지가 아직 RAM에 로드되지 않은 초기 수백 개 쿼리는 10~100배 느립니다. 프로덕션 트래픽을 받기 전에 인덱스를 미리 로드하는 예열 단계가 필요하며, 그렇지 않으면 배포 직후 첫 사용자들이 심각한 지연을 경험합니다.
- 조용한 실패. 웹사이트가 HTML을 변경해 크롤러가 작동을 멈춥니다. 드라이버 업데이트로 GPU 처리 노드가 NaN 임베딩을 생성하기 시작합니다. 디스크가 가득 차 새 얼굴이 아무 경고 없이 인덱싱되지 않습니다. 이러한 실패는 오류를 발생시키지 않고 시스템 품질을 조용히 떨어뜨립니다. 포괄적인 모니터링과 이상 감지가 없으면 사용자가 불만을 제기할 때까지 알 수 없습니다.
- FAISS 갱신 문제. IVF 인덱스에 새 임베딩을 추가하면 보로노이 셀의 균형이 무너집니다. 양자화기를 다시 학습할 때까지 검색 품질이 점차 저하됩니다. 웹 규모에서는 재학습에 전체 데이터셋을 대상으로 몇 시간의 GPU 시간이 필요합니다. 팀은 일반적으로 추가 항목을 일괄 처리하고 매주 또는 매월 다시 학습하므로 새로 수집된 얼굴은 즉시 전체 정확도로 검색되지 않습니다. 항상 최신성과 검색 품질 사이에서 절충해야 하며 공짜 해결책은 없습니다.
- 인덱스 샤드 간 점수 보정. 인덱스가 여러 시스템에 샤딩되면 각 샤드의 임베딩 분포가 다르므로 샤드별 원시 유사도 점수를 직접 비교할 수 없습니다. 결과를 의미 있게 병합하려면 코호트 정규화, Z-norm, T-norm 같은 샤드별 점수 정규화가 필요합니다. 보정하지 않으면 샤드 A의 0.45는 강한 일치일 수 있지만 샤드 B의 0.45는 평범한 일치일 수 있습니다. 병합 결과를 신뢰할 수 없게 됩니다.
- 분산 검색의 팬아웃 문제. N개 샤드를 검색하려면 쿼리당 N번의 네트워크 왕복이 필요합니다. 가비지 컬렉션 일시 중지, 디스크 I/O 급증, 네트워크 문제 등으로 샤드 하나라도 느리면 전체 쿼리가 느려집니다. P99 지연 시간은 가장 느린 샤드의 P99에 의해 결정되며 샤드를 추가할수록 악화됩니다. 중복 요청을 보내 먼저 반환되는 결과를 사용하는 헤지 요청과 적응형 타임아웃 같은 기법이 허용 가능한 꼬리 지연 시간을 유지하는 데 필수적입니다.
정확도와 대조 문제:
- 임계값 조정에는 끝이 없습니다. 데이터베이스가 커질수록 최적 유사도 임계값이 바뀝니다. 얼굴 100만 개에서는 0.45라는 임계값이 정밀도와 재현율의 적절한 균형을 제공할 수 있습니다. 얼굴 1억 개에서는 비슷하게 생긴 근접 오탐 후보가 더 많아 같은 임계값에서 오탐이 10배 증가합니다. 적응형 임계값이나 후처리 재순위화가 필요합니다. 근본적인 수학은 냉혹합니다. 데이터베이스가 얼굴 100만 개에서 1억 개, 10억 개로 커지면 근접 오탐 후보가 증가해 상위 k개 유사도 점수 분포가 위로 이동합니다. 얼굴 100만 개에서 오탐률 0.1%를 내는 고정 임계값이 10억 개에서는 10%를 낼 수 있습니다. 이 분포를 모델링하고 임계값을 동적으로 조정하지 않으면 규모가 커질수록 정밀도가 낮아지는 것을 감수해야 합니다.
- 오픈셋과 클로즈드셋 인식. 대부분의 벤치마크는 쿼리 인물이 데이터베이스에 반드시 존재하는 클로즈드셋 성능을 평가합니다. 실제 얼굴 검색은 쿼리 얼굴이 인덱스에 전혀 없을 수 있는 오픈셋입니다. 오픈셋 평가에는 순위 1 정확도가 아니라 고정 FPIR에서의 TPIR처럼 완전히 다른 지표가 필요하며, 실패 유형도 잘못된 순위가 아니라 오탐입니다. 클로즈드셋 벤치마크에서 99%를 기록한 시스템도 실제 일치 항목이 없는데 가장 “가까운” 얼굴을 확신 있게 반환해 오픈셋 배포에서 오탐률이 10%일 수 있습니다. “일치 항목 없음”을 올바르게 처리하는 것은 올바른 일치 항목을 찾는 것만큼 중요합니다.
- 닮은 사람과 도플갱어. 얼굴이 1억 개 이상인 데이터베이스에는 서로 관계가 없지만 임베딩이 놀랄 만큼 가까운 사람 쌍이 많습니다. 데이터베이스가 클수록 더 많은 오탐이 발생합니다. 사용자는 “다른 사람” 결과를 정기적으로 신고할 것입니다. 여러 사진을 이용한 검증, 이름과 위치 같은 맥락 신호, 인간 검토 대기열 등의 대응 전략이 필요합니다.
- 자세 불변 인식은 여전히 어렵습니다. FaceNet512도 좌우 60도를 넘는 요 각도에서는 성능이 크게 저하됩니다. 측면과 정면을 대조하는 정확도는 정면끼리 대조할 때보다 10~20% 낮아질 수 있습니다. 감시 시나리오에서는 대부분의 얼굴이 비스듬하므로 실제 정확도는 벤치마크가 보여주는 것보다 상당히 낮습니다. 3D 인식 증강으로 학습한 모델이나 UV-GAN 같은 아키텍처가 도움이 되지만 복잡성이 증가합니다. 입력 데이터에 비스듬한 얼굴이 많다면 이를 예외 사례가 아니라 최우선 정확도 문제로 봐야 합니다.
- 적대적 입력. 사용자는 AI 생성 얼굴, 딥페이크, 모핑 이미지, 의도적으로 교란한 사진을 제출합니다. 일부는 시스템을 시험하고 일부는 결과를 조작하려 합니다. 이러한 입력에 어느 정도 견고하지 않으면 가짜 얼굴에도 확신도 높은 일치 결과를 반환하게 됩니다.
- 사진 조작. 필터, 뷰티 앱, 짙은 화장, 얼굴 보정 소프트웨어가 있습니다. Instagram 속 모습과 실제 모습은 다릅니다. 이러한 수정은 임베딩 유사도에 영향을 줄 만큼 얼굴 기하학을 바꿉니다. 필터가 심하게 적용된 셀카는 같은 사람의 필터 없는 사진과 일치하지 않을 수 있습니다.
- 한 얼굴, 여러 임베딩. 한 사람의 사진이 여러 플랫폼, 각도, 연도에 걸쳐 온라인에 수백 장 존재할 수 있습니다. 이를 모두 별도 일치 항목으로 반환할 것인지, 하나의 신원으로 군집화할 것인지 결정해야 합니다. 수억 개 얼굴을 대규모로 군집화하는 것은 연산 비용이 크고, 서로 다른 두 사람을 합치는 과병합과 같은 사람의 사진을 연결하지 못하는 과소병합이라는 고유한 오류 유형을 만듭니다.
운영상의 골칫거리:
- 스크래핑 방지 경쟁. 모든 주요 소셜 미디어 플랫폼은 스크레이퍼를 적극적으로 차단합니다. 페이지 구조를 바꾸고, CAPTCHA를 추가하고, 헤드리스 브라우저를 감지하고, IP별 속도를 제한하고, 요청 패턴을 지문화하며, 때로는 미끼 콘텐츠를 제공합니다. 크롤링 인프라는 끊임없는 경쟁을 벌입니다. 오늘 작동하는 스크레이퍼가 다음 주에는 완전히 차단될 수 있습니다. 크롤러 유지 관리는 일회성 구축이 아니라 지속적인 엔지니어링 비용입니다.
- 변화율 모델링. 소스마다 업데이트 속도가 다릅니다. 유명인 뉴스 사이트에는 매시간 새 사진이 올라오지만 개인 소셜 미디어 프로필은 수년 동안 변하지 않을 수 있습니다. 과거 변화율을 기반으로 지능형 재크롤링 일정을 사용하면 중요한 영역의 최신성을 유지하면서 대역폭 비용을 60~80% 줄일 수 있습니다. 그렇지 않으면 정적인 소스를 과도하게 크롤링해 대역폭과 비용을 낭비하거나, 동적인 소스를 충분히 크롤링하지 않아 오래된 결과를 제공합니다.
- CDN 및 지리적 콘텐츠 차이. 같은 URL이 요청자의 위치, 기기 사용자 에이전트, 쿠키에 따라 서로 다른 이미지를 제공할 수 있습니다. 크롤러가 사용자가 보는 것과 다른 이미지를 인덱싱해 “일치 항목이 결과와 다르게 보인다”는 혼란스러운 신고가 발생할 수 있습니다. 일부 CDN은 실제 브라우저가 이미지를 뷰포트로 스크롤할 때까지 저해상도 자리표시자를 제공합니다. 이러한 예외 사례를 처리하지 않으면 일정 비율의 유령 결과를 감수해야 합니다.
- 저장 비용 증가. 이미지 저장 공간은 선형적으로 증가하며 절대 멈추지 않습니다. 나중에 다시 임베딩해야 할 수 있으므로 원본을 삭제할 수도 없습니다. 썸네일, 메타데이터, 임베딩 벡터, 인덱스 파일, 백업 사본도 있습니다. 시스템이 성숙할수록 저장 비용은 더 빠르게 증가합니다. 1년 차 저장 공간만 예산에 반영한 팀은 3년 차 비용에 충격을 받습니다.
- 대규모 규정 준수 요청. GDPR은 개인에게 자신의 데이터 삭제를 요청할 권리를 부여합니다. 누군가 수집 거부를 신청하면 전체 데이터베이스에서 해당 얼굴로 생성된 모든 임베딩을 찾고, 삭제하고, 크롤러가 원본 이미지를 다시 발견해도 재추가되지 않도록 하며, 감사를 위해 삭제 내용을 문서화해야 합니다. 대규모 환경에서는 전용 도구와 엔지니어링 작업이 필요합니다. [EU AI 법](https://artificialintelligenceact.eu/)은 얼굴 인식을 포함한 고위험 AI 시스템에 의무 적합성 평가, 편향 테스트, 투명성 의무, 인간 감독 메커니즘 등 추가 요건을 부과합니다.
- 수집 거부 구현은 생각보다 어렵습니다. 임베딩 하나만 삭제하면 끝나는 것이 아닙니다. 크롤러가 같은 얼굴을 다시 만나도 재인덱싱되지 않게 해야 합니다. 이를 위해 수집 거부된 얼굴 임베딩의 “차단 목록” 인덱스를 유지하고, 모든 새 임베딩을 인덱싱하기 전에 이 목록과 비교해야 합니다. 이 차단 목록은 모든 삽입 때 조회되므로 빨라야 하며, 자체적인 데이터 보존 문제도 야기합니다. 삭제 요청을 준수하려면 수집 거부한 사람의 얼굴 임베딩을 영구 저장해 대조해야 하기 때문에 생체 데이터를 삭제하기 위해 생체 데이터를 보관하는 셈입니다. 이러한 법적 긴장은 실제로 존재하며 많은 관할권에서 아직 해결되지 않았습니다.
- 공개 크롤링 데이터의 동의 문제. 공개 소셜 미디어 프로필의 생체 데이터를 처리할 때 적용할 GDPR의 적법한 근거는 법적으로 논쟁 중입니다. 여러 EU 데이터 보호 기관이 얼굴 인식 회사에 불리한 결정을 내렸으며, 여러 EU 회원국의 Clearview AI 결정이 대표적입니다. 법적 위험은 관할권, 데이터 출처, 사용 사례에 따라 달라집니다. 이는 가상의 미래 문제가 아니라 현재 적극적으로 집행되는 영역입니다.
- 감사 추적 저장 비용. 규정 준수를 위해 필요할 수 있는 모든 검색 쿼리와 반환된 모든 일치 항목을 기록하면 감사 로그가 실제 얼굴 데이터보다 더 빠르게 증가할 수 있습니다. 하루 100만 건의 검색을 처리하고 각각 결과 10개를 반환하는 시스템은 하루에 약 1,000만 건의 감사 레코드를 생성합니다. 관할권에 따라 흔히 1~7년인 보존 요건 때문에 데이터가 끊임없이 누적됩니다. 감사 저장 공간을 나중에 생각할 문제가 아니라 주요 비용 항목으로 계획하십시오.
- 사고 대응. 시스템이 얼굴을 잘못 대조하고 누군가가 그 오탐을 근거로 조치를 취하면 어떻게 해야 할까요? 각 결과가 어떻게 생성되었는지 보여주는 감사 추적, 대조 판단을 설명하는 기능, 이의 제기를 처리하는 절차가 필요합니다. 누군가 일치 결과에 이의를 제기할 때 “코사인 유사도가 0.47로 임계값 0.42를 넘었습니다”라는 설명으로는 충분하지 않습니다. GradCAM 같은 기법은 어떤 얼굴 영역이 일치 판단에 영향을 주었는지 보여줄 수 있어 분쟁 해결과 신뢰 형성에 도움이 됩니다. 이는 좋은 엔지니어링 관행일 뿐 아니라 관할권에 따라 법적 의무일 수도 있습니다.
- 모델 및 의존성 노후화. CUDA, Python, [ONNX Runtime](https://onnxruntime.ai/), 운영체제 버전은 모두 시간이 지나면서 바뀌고 추론 파이프라인을 미묘한 방식으로 망가뜨릴 수 있습니다. 버전을 고정하면 도움이 되지만 보안 패치를 적용해야 할 때까지뿐입니다. 의존성 관리와 환경 재현성에 놀랄 만큼 많은 시간을 쓰게 됩니다.
- 팀 지식의 집중. FAISS 인덱싱 계층을 만든 엔지니어는 샤딩 로직을 이해합니다. 크롤러를 조정한 엔지니어는 어떤 사이트에 특별한 처리가 필요한지 압니다. 이들이 떠나면, 18~24개월짜리 프로젝트에서는 이직이 발생하기 마련입니다. 핵심 지식도 함께 사라집니다. 문서화가 도움이 되지만 명확하지 않은 결정의 “이유”까지 완전히 담지는 못합니다.
실제 비용 요약
공개 인터넷을 검색하는 웹 규모 얼굴 검색 시스템의 경우:
- 엔지니어링 팀: 선임 엔지니어 3~5명, 12~24개월 = 급여 및 간접비 60만~250만 달러
- 인프라(1년 차): 클라우드 비용 또는 하드웨어 40만~100만 달러
- 인프라(지속 비용): 월 3만~8만 달러, 연간 36만~96만 달러
- 법률 및 규정 준수: 초기 평가에 5만~20만 달러, 이후 지속적인 법률 자문
- 1년 차 총비용: 140만~370만 달러
- 2년 차 이후 총비용: 인프라 및 엔지니어링 유지 관리에 연간 50만~120만 달러
이마저도 제대로 작동하는 시스템을 기준으로 한 수치입니다. 많은 팀이 문제가 예상보다 어렵다는 사실을 깨닫고 API 솔루션으로 전환하기 전까지 6~12개월과 50만 달러 이상을 지출합니다.
직접 구축할 때와 API를 사용할 때
다음과 같은 경우 직접 구축하십시오:
- 직원 배지나 고객 사진처럼 얼굴 10만 개 미만의 폐쇄형 데이터셋을 보유한 경우
- 시스템을 온프레미스 또는 에어갭 환경에서 실행해야 하는 경우
- 모델 최적화, 임계값 조정, 예외 사례를 처리할 수 있는 ML 엔지니어가 있는 경우
- 사용 사례가 웹 대상 검색(1: N)이 아니라 검증(1:1)인 경우
- 다년간의 엔지니어링 프로젝트에 투입할 예산과 일정이 있는 경우
다음과 같은 경우 API를 사용하십시오:
- 소셜 미디어, 뉴스, 웹 등 공개 인터넷에서 얼굴을 검색해야 하는 경우
- 웹 스크래핑 및 인덱싱 파이프라인을 구축하고 유지하고 싶지 않은 경우
- 12~24개월의 엔지니어링 후가 아니라 지금 결과가 필요한 경우
- 온라인에 새로 게시되는 콘텐츠를 반영해 시스템을 최신 상태로 유지해야 하는 경우
- GDPR 준수, 수집 거부 요청, EU AI 법 처리를 다른 주체에게 맡기고 싶은 경우
- 초기 인프라 및 엔지니어링 비용 100만 달러 이상을 피하고 싶은 경우
- 핵심 제품 자체가 얼굴 검색이 아니며 엔지니어링 시간을 실제 제품에 쓰는 편이 나은 경우
FaceCheck.id 얼굴 검색 API
인프라를 처음부터 구축하지 않고 공개 웹에서 얼굴을 검색해야 하는 개발자를 위해 FaceCheck.id는 REST API를 제공합니다. 이 API는 감지, 임베딩, 그리고 소셜 미디어, 뉴스 사이트, 광범위한 웹에 공개된 얼굴 이미지로 구성되어 지속적으로 업데이트되는 인덱스 검색까지 전체 파이프라인을 처리합니다.
FaceCheck.id는 웹 규모 검색에 최적화된 독점 얼굴 인식 모델을 사용합니다. 직접 배포하고 조정해야 하는 오픈 소스 모델과 달리, 이 독점 모델은 크게 달라지는 이미지 품질, 다양한 조명 조건, 인구통계학적 다양성, 지속적으로 크롤링되는 방대한 인덱스 등 인터넷 얼굴 검색의 어려움을 처리하도록 특별히 학습되고 미세 조정되었습니다. 이 독점 접근 방식 덕분에 범용 오픈 소스 모델로는 불가능한 방식으로 모델 성능을 독립적으로 개선하고 특정 검색 파이프라인에 맞게 최적화할 수 있습니다. 시스템을 처음부터 복제하기에는 극도로 어렵고 비용이 많이 드는 수준으로 만들기 위해 수년간 엔지니어링, 테스트, 개선이 이루어졌습니다.
API의 기능:
얼굴 이미지를 전송하면 API가 인터넷 전체에서 찾은 일치 얼굴을 신뢰도 점수 및 출처 URL과 함께 반환합니다. 대조, 인덱싱, 웹 규모 인프라는 FaceCheck.id 측에서 처리합니다. 앞서 설명한 모든 GPU 클러스터, 크롤링 파이프라인, 벡터 검색 인프라, 규정 준수 도구, 지속적인 유지 관리는 사용자가 아니라 FaceCheck.id가 해결할 문제입니다.
API 기본 사항:
- RESTful JSON API
- API 키를 통한 인증
- Base64로 인코딩된 이미지 또는 이미지 URL 전송
- 반환값: 유사도 점수, 출처 URL, 썸네일 미리보기를 포함한 일치 항목 배열
- 사용량에 따라 확장되는 속도 제한 및 요금
일반적인 통합 방식:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
API 사용 사례:
- 데이트 앱 검증: 상대방의 사진이 실제 소셜 미디어 프로필에 나타나는지 사용자가 확인할 수 있도록 지원
- 브랜드 보호: 누군가 팀원의 사진을 가짜 비즈니스 프로필에 사용하는지 확인
- 실사 플랫폼: 신원 조회 또는 KYC 작업 흐름에 얼굴 검색 추가
- 사기 방지 시스템: 인터넷의 다른 곳에서 다른 이름으로 나타나는 사진을 사용하는 계정 표시
- OSINT 도구: 웹 규모 얼굴 대조를 포함하는 조사 도구 구축
직접 구축하는 대신 이 API를 사용해야 하는 이유:
공개 웹을 검색하는 얼굴 검색 엔진을 구축하려면 (1) 수십억 장의 이미지를 발견하고 다운로드하는 웹 규모 크롤링 파이프라인, (2) 얼굴 감지와 임베딩 추출을 실행하기 위한 수십만 달러 규모의 GPU 인프라, (3) 전체 인덱스를 실시간으로 조회하기 위해 수 TB의 RAM을 갖춘 분산 벡터 검색 시스템, (4) 인덱스를 최신 상태로 유지하기 위한 지속적인 재크롤링, (5) 수집 거부, 데이터 삭제 요청, 규제 요건을 위한 규정 준수 인프라, (6) 이를 상시 유지 관리하는 엔지니어 3~5명으로 구성된 팀, (7) 최초 사용 가능 버전 출시 전까지 12~24개월이 필요합니다. 이는 지속적인 비용도 상당한 수백만 달러 규모의 엔지니어링 프로젝트입니다. FaceCheck.id의 독점 모델과 실전에서 검증된 인프라로 구동되는 API는 단 한 번의 HTTP 호출로 이 모든 것을 제공합니다.
위에서 다룬 오픈 소스 모델은 직원 출입 통제, 사진 라이브러리 정리, 맞춤형 검증 흐름 같은 폐쇄형 얼굴 인식 시스템을 구축하는 데 뛰어납니다. 하지만 사용 사례가 “이 얼굴이 인터넷 어디에 나타나는지 검색”하는 것이라면 작동하는 모델과 작동하는 제품 사이의 엔지니어링 격차는 엄청납니다. FaceCheck.id API는 이 격차를 메워 수년이 아니라 며칠 만에 작동하는 제품을 출시할 수 있게 합니다.
시작하기: 문서, 요금, API 키 등록은 facecheck.id/en/Face-Search/API에서 확인하십시오.
자주 묻는 질문
가장 정확한 오픈 소스 얼굴 인식 모델은 무엇인가요?
Inception-ResNet-v2 백본을 사용하는 FaceNet512는 현재 대부분의 벤치마크에서 뛰어난 결과를 내며 LFW에서 99.65%를 달성합니다. 감시 영상이나 CCTV 같은 저품질 이미지 시나리오에서는 AdaFace가 IJB-C 같은 어려운 벤치마크에서 더 좋은 성능을 보이며 TAR@FAR=1e-4에서 97.39%를 기록합니다.
오픈 소스 얼굴 인식 모델을 상업적으로 사용할 수 있나요?
예. FaceNet512, FaceNet, DeepFace, dlib, AdaFace는 모두 제한이 적은 MIT 또는 Boost 라이선스로 배포됩니다. 상용 제품에서 사용할 수 있습니다. 다만 소프트웨어 라이선스와 관계없이 적용되는 관할권의 생체 데이터 처리 관련 법적 제한인 GDPR, BIPA, EU AI 법에 유의해야 합니다.
자체 얼굴 인식 모델을 학습하려면 데이터가 얼마나 필요한가요?
처음부터 학습할 필요는 없습니다. 위에 나열된 사전 학습 모델은 10만~50만 명의 신원에 걸친 500만~1,200만 장의 이미지 데이터셋으로 학습되었습니다. 이러한 사전 학습 모델을 사용하고 특정 도메인 요구가 있을 때만 미세 조정하십시오. 미세 조정에는 일반적으로 이미지 1만~10만 장이 필요합니다. 처음부터 학습하려면 수백만 장의 이미지와 상당한 GPU 자원이 필요합니다.
얼굴 검증과 얼굴 검색의 차이는 무엇인가요?
얼굴 검증(1:1)은 두 임베딩을 직접 비교해 “이 두 사진이 같은 사람인가?”에 답합니다. 얼굴 검색(1:N)은 하나의 임베딩을 수백만 개의 데이터베이스와 비교해 “이 사람이 어디에 나타나는가?”에 답합니다. 검증은 연산상 간단합니다. 검색에는 효율적인 최근접 이웃 인덱싱인 FAISS, Milvus가 필요하며, 웹 규모 검색의 경우 구축 및 운영에 수백만 달러가 들 수 있는 방대한 크롤링 및 인덱싱 인프라도 필요합니다.
저품질 이미지에서 얼굴 인식은 얼마나 정확한가요?
이미지 품질이 낮아지면 정확도도 크게 떨어집니다. 선명한 정면 사진에서는 현대 모델이 99% 이상의 정확도를 달성합니다. 흐릿한 감시 영상이나 얼굴 너비가 50픽셀 미만인 사진에서는 정확도가 80~90% 이하로 떨어질 수 있습니다. AdaFace는 표준 모델보다 품질 편차를 잘 처리하도록 특별히 설계되었습니다. 어떤 시스템에서든 더 높은 해상도의 입력 이미지는 훨씬 나은 결과를 제공합니다. 자세도 중요합니다. 고해상도 이미지에서도 측면 얼굴의 정확도는 정면 얼굴보다 10~20% 낮을 수 있습니다.
얼굴 검색 엔진을 구축하는 데 비용이 얼마나 드나요?
공개 인터넷을 검색하는 웹 규모 시스템의 경우 1년 차에는 엔지니어링 팀, 인프라, 법률 비용으로 140만~370만 달러, 이후에는 연간 50만~120만 달러의 지속 비용을 예상해야 합니다. 얼굴 10만 개 미만의 비공개 데이터베이스를 검색하는 폐쇄형 시스템은 비용이 훨씬 낮아 단일 GPU 서버와 엔지니어 한 명으로 처리할 수 있습니다. 비용은 검색 데이터베이스의 크기와 데이터를 채우기 위해 웹을 크롤링해야 하는지에 따라 달라집니다.
프로덕션 얼굴 인식 시스템을 구축하는 데 얼마나 걸리나요?
알려진 데이터베이스와 1:1로 대조하는 간단한 검증 시스템은 숙련된 엔지니어가 1~2주 안에 작동하는 프로토타입을 만들고 1~3개월 안에 프로덕션 준비를 완료할 수 있습니다. 인터넷을 대상으로 1:N 검색을 수행하는 웹 규모 얼굴 검색 시스템은 엔지니어 3~5명으로 구성된 팀이 프로덕션에서 신뢰할 수 있는 수준의 시스템을 만들기까지 12~24개월이 걸립니다. 크롤링, 확장, 규정 준수 문제는 핵심 ML 작업 외에 막대한 시간을 추가합니다.
의미 있는 것을 만드십시오. 폐쇄형 시스템에는 FaceNet512로 시작하십시오. 하지만 웹 규모 얼굴 검색이 필요하다면 스스로 물어보십시오. 정말 140만~370만 달러를 지출하고, 선임 엔지니어 팀을 고용하고, 처음 쓸 만한 결과를 얻기까지 12~24개월을 기다리고 싶습니까? 대신 FaceCheck.id API를 사용하면 GPU 클러스터, 크롤링의 악몽, 규정 준수의 골칫거리, 수년간의 엔지니어링을 모두 건너뛰고, 단 1달러부터 시작해 5분 이내에 첫 검색 결과를 얻을 수 있습니다.
그림으로 검색하는 방법에 대해 더 읽어보기
FaceCheck 검색 결과가 없나요? 얼굴 검색 결과가 비어 있는 이유와 해결 방법
얼굴 검색 결과가 비어 있다면 대개 사람 자체가 아니라 사진이 문제입니다. FaceCheck.ID에서 아무것도 찾지 못하는 가장 흔한 9가지 이유와 각각의 해결 방법, 그리고 언제 '검색 결과 없음'이 단순히 솔직한 답인지 구별하는 방법을 알아보세요.
다른 언어로 된 주제에 대하여"
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
최고의 이미지 역검색 엔진 순위: PimEyes vs FaceCheck