顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
顔の照合、写真による本人確認、データセット全体からの顔検索を必要とするものを開発するなら、現代の顔認識が内部で実際にどう機能しているかを理解する必要があります。マーケティング向けの説明ではありません。生のピクセルから、その人固有の顔形状を符号化した512次元の埋め込みベクトルに至るまでの、実際のパイプラインです。
この記事では、顔認識パイプライン全体を詳しく解説し、2026年時点で利用できる最良のオープンソースモデルを比較し、実際の性能数値を示したうえで、独自システムを構築すべき場合と本番環境向けAPIを利用すべき場合を説明します。
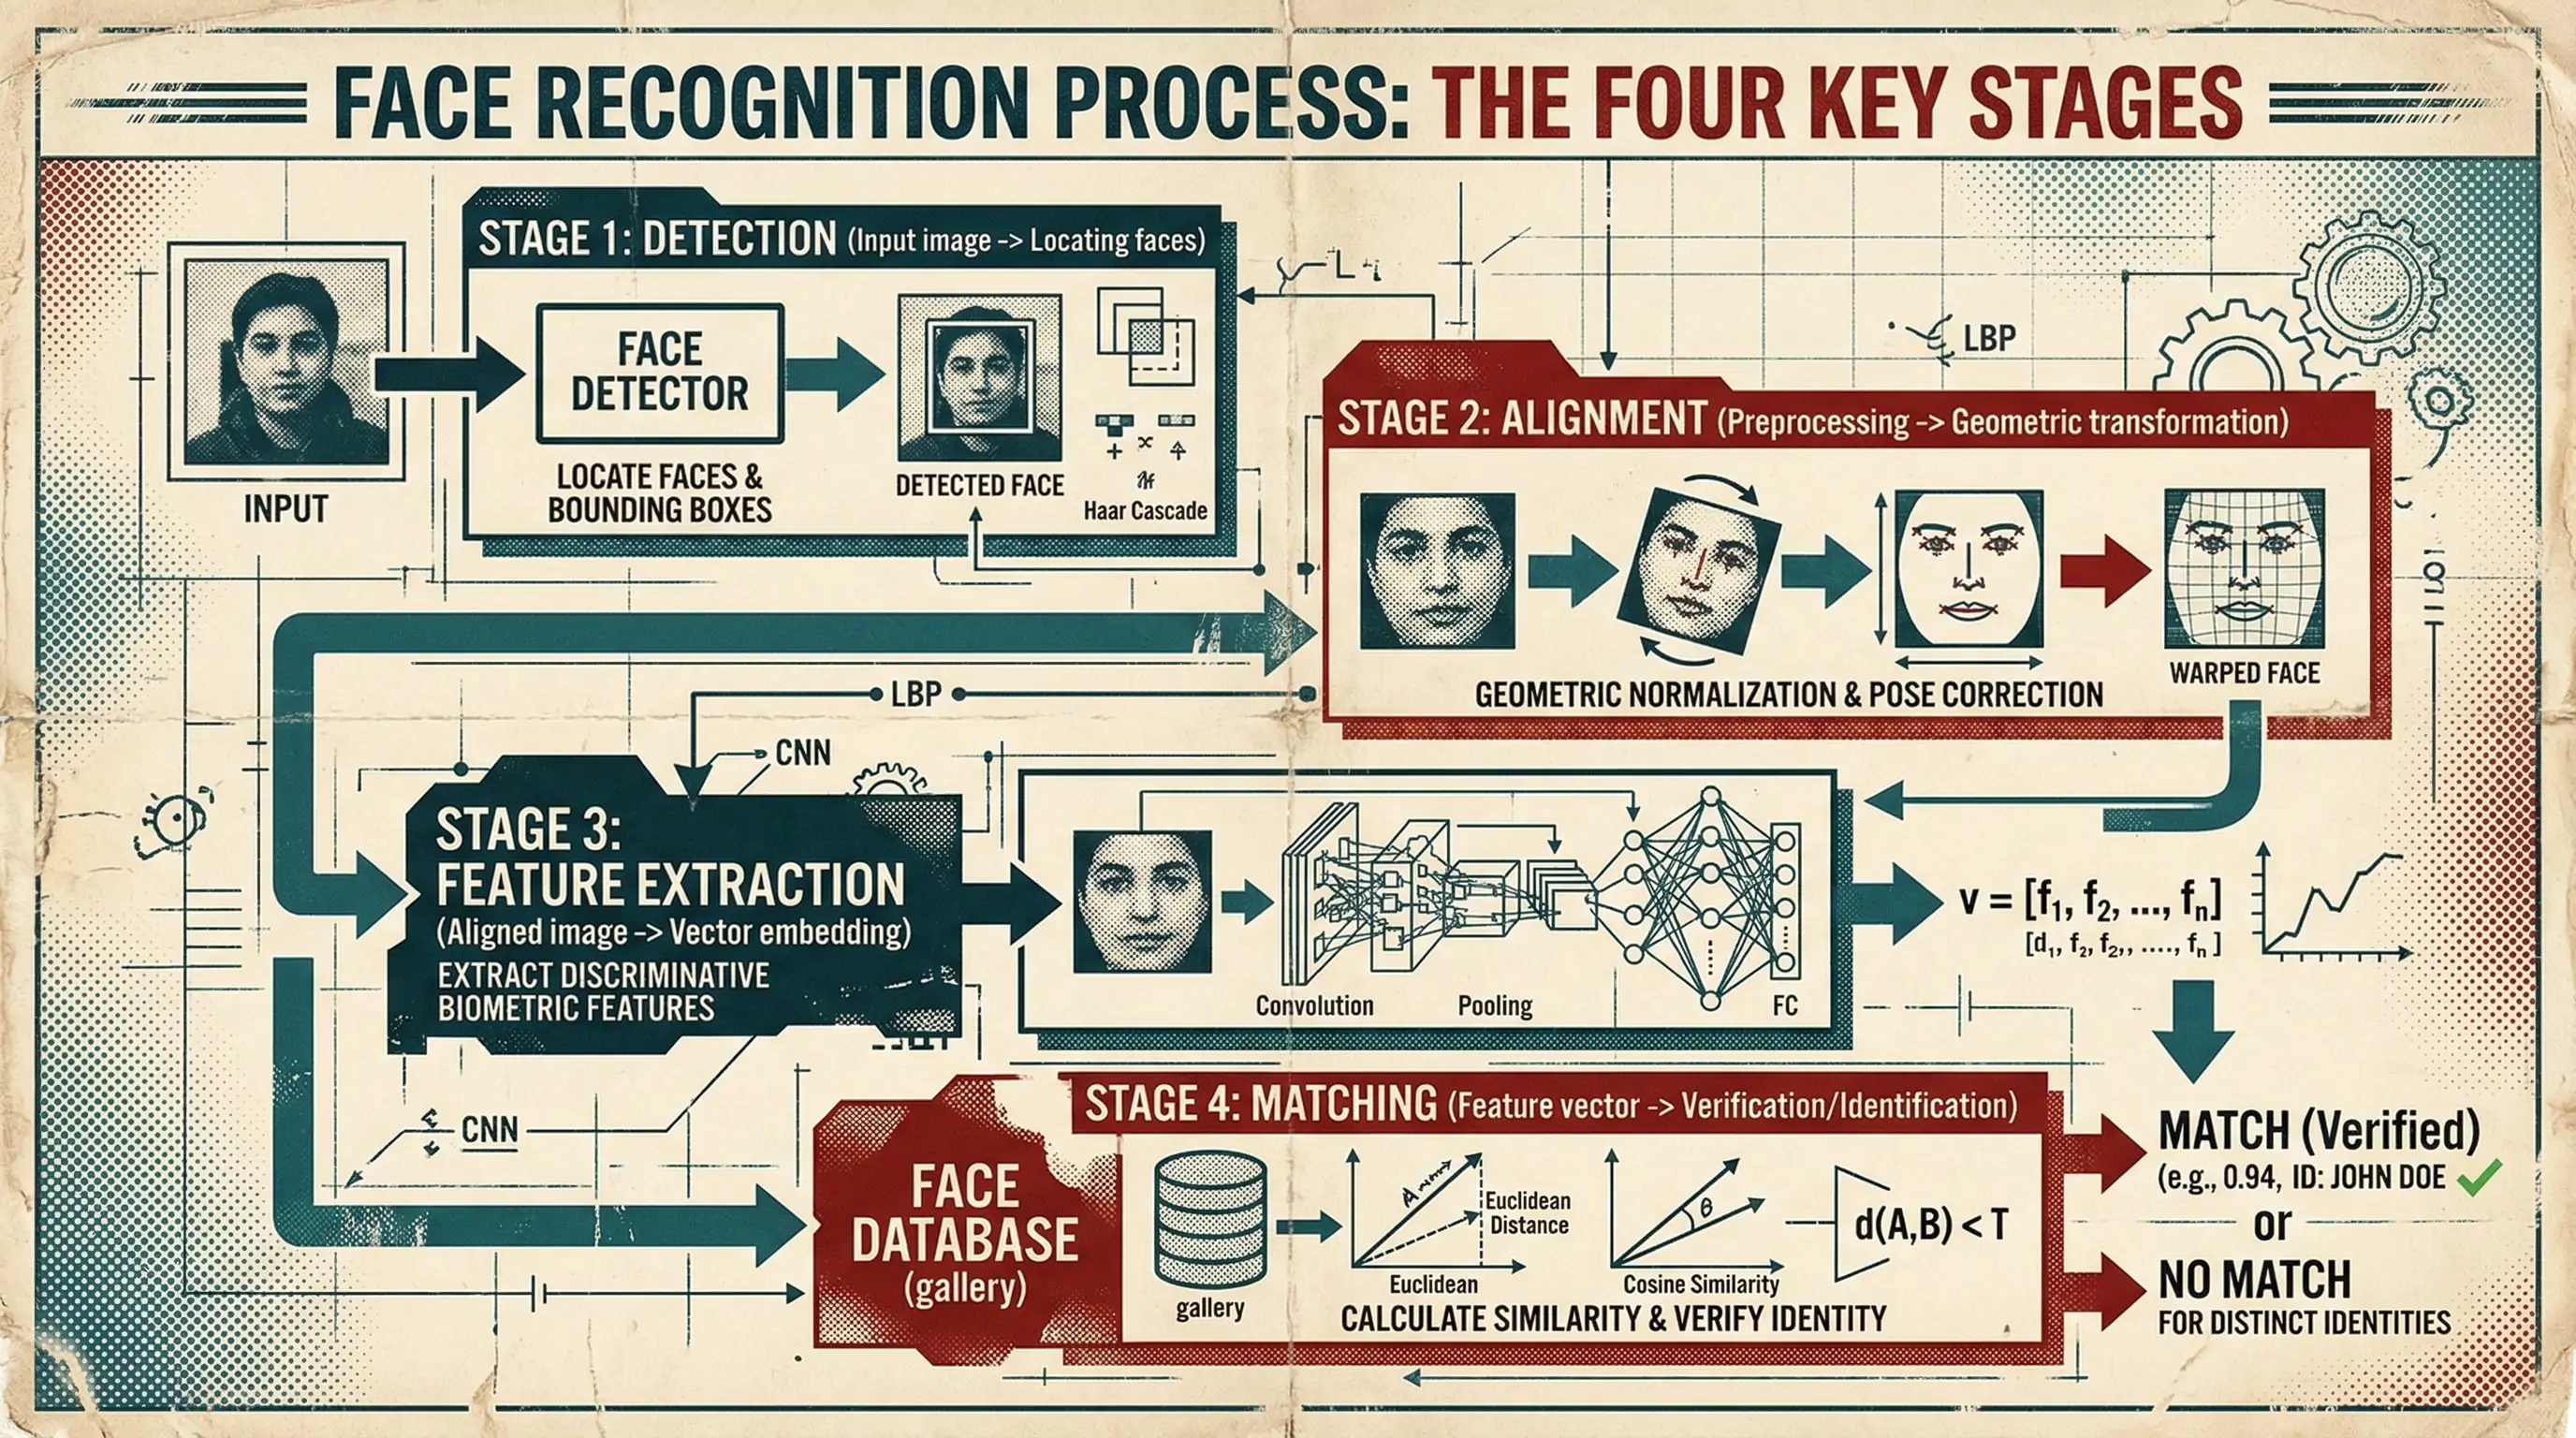
この記事では、私たちは議論するつもりです
顔認識パイプライン:4つの段階
現代の顔認識システムは、35ドルのRaspberry Piで動作するものでも、政府機関のGPUクラスターで動作するものでも、すべて同じ基本的なパイプラインに従います。この4つの段階を理解すれば、あらゆるモデルやAPIを評価しやすくなります。
第1段階:顔検出
顔を認識する前に、まず顔を見つける必要があります。顔検出は画像を入力として受け取り、存在するすべての顔を囲むバウンディングボックスを出力します。簡単に聞こえますが、本番環境では多くのシステムがここで失敗します。
標準的なモデル:
- MTCNN(Multi-task Cascaded Convolutional Networks):2016年以来、顔検出の定番として使われてきたモデルです。3段階のカスケード構成で、Proposal Network(P-Net)が候補領域を見つけ、Refine Network(R-Net)が誤検出を除外し、Output Network(O-Net)がバウンディングボックスを調整して顔ランドマークを出力します。現在も広く利用されています。正面顔には高精度ですが、極端な角度や遮蔽には弱点があります。最新のCPUで約20 FPSです。
- RetinaFace:検出精度では最先端です。[Feature Pyramid Network](https://arxiv.org/abs/1612.03144)をバックボーンとする単段検出器です。バウンディングボックスに加え、5つの顔ランドマーク(両目、鼻、口角)を返します。複数スケールに強く、速度より精度が重要な場合の定番です。GPUで約15 FPS、CPUではさらに低速です。
- SCRFD(Sample and Computation Redistribution for Efficient Face Detection):速度重視の代表格です。モバイルおよびエッジ環境への導入を目的として設計されています。RetinaFace級の精度を3~10倍の速度で実現します。パラメーター数は50万から3,400万まで、複数のモデルサイズがあります。モバイルに導入する場合やリアルタイム処理が必要な場合に適しています。
- BlazeFace:Googleが提供する、[MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide)向けに設計されたモデルです。非常に高速で、モバイルGPU上でも200 FPS以上で動作しますが、難しい角度では多少精度を犠牲にしています。全フレームを処理する必要があるリアルタイム動画アプリケーションに適しています。
検出で本当に重要なこと: 難しいのは、照明の良い自撮り写真ではありません。監視映像、顔の幅が50ピクセルしかない集合写真、極端な横顔、サングラスやマスクで一部が隠れた顔です。検出モデルがシステム全体の性能上限を決めます。検出段階で顔を見逃せば、後続処理で修正することはできません。
複数顔の問題: 画像に複数の顔が含まれる場合、どの顔を埋め込みに変換するかを決める必要があります。最大の顔、中央に最も近い顔、品質スコアが最も高い顔を選ぶ方法や、すべてを埋め込み化して後続ロジックに判断させる方法があります。それぞれに異なる失敗パターンがあります。集合写真のすべての顔を埋め込み化するとインデックスが肥大化し、検索結果が曖昧になります。一方、最大の顔だけを選ぶと、後列に立つ人物を見逃します。多くの本番システムでは、最小サイズのしきい値(通常は両目の間が40~60ピクセル)を上回る検出顔をすべて埋め込み化し、同じ元画像に関連付けられた個別エントリーとして扱います。
ゲートキーパーとしての顔品質スコアリング: 高コストな埋め込み計算の前に、SER-FIQやMagFaceの品質ブランチのような軽量品質推定器を実行すると、低品質データがインデックスに入るのを防げます。ぼやけた切り抜き、極端な遮蔽、露出過多の顔は、検索結果を汚染する信頼度の低い埋め込みを生成します。検出段階で品質しきい値未満の顔を除外すれば、後続処理の適合率が大幅に向上し、GPU処理量も節約できます。これは、パイプライン全体で最も投資対効果の高い最適化の1つです。
本人確認向けの顔なりすまし防止: 本人確認では、提示攻撃検知(PAD)が不可欠です。紙への印刷、画面の再生、3Dマスクはいずれも埋め込みベースのシステムを欺く可能性があります。CDCNやPatchNetのようなモデルはこうした攻撃を検知できますが、顔ごとに5~15ミリ秒の遅延が加わり、追加のモデル保守も必要です。アクセス制御、KYC、認証など、ユーザーが入力画像を制御できるものを構築する場合、なりすまし防止を組み込まなければ、必ず悪用されます。
第2段階:顔アラインメント
顔を検出したら、次に正規化する必要があります。頭部の姿勢、カメラアングル、距離が異なると、生画像内での顔の見え方も変わります。アラインメントでは、検出された各顔を、目が水平で、顔が中央にあり、縮尺が統一された標準位置へ変換します。
標準的な方法では、検出時に得られた5つのランドマーク(左目、右目、鼻先、左口角、右口角)を使って相似変換を計算します。これにより、検出された顔を、目が固定されたピクセル座標に位置する標準的な160x160ピクセルの切り抜きへ変換します。
この段階はチュートリアルでは見落とされがちですが、非常に重要です。アラインメントに2度の回転誤差があるだけで、認識精度が1~3%低下することがあります。ほとんどのオープンソースパイプラインは自動で処理しますが、独自に構築する場合は、FaceNetのアラインメント仕様(160x160、所定の目の座標)を標準として使用してください。現代のモデルの多くは、この仕様で学習されています。
ランドマーク精度に対するアラインメントの感度: RetinaFaceのランドマークには、平均で約2ピクセルの誤差があります。この誤差はアラインメント変換を通じて伝播し、特に2ピクセルが顔幅に対して大きな割合を占める小さな顔の切り抜きでは、精度が1~5%低下する可能性があります。一部の本番システムでは、初期検出後に、Adrian Bulatによるface-alignmentのような68点または98点のランドマーク調整を追加実行し、より厳密に位置合わせします。顔ごとに3~5ミリ秒余分にかかりますが、最大精度が求められる用途、特に1回の誤判定が重大な結果を招く1:1本人確認では、その価値があります。
第3段階:特徴抽出(埋め込み)
これは顔認識の中核です。ディープニューラルネットワークが位置合わせ済みの顔画像を受け取り、埋め込みまたは特徴ベクトルと呼ばれる固定長ベクトル(通常は512次元)を出力します。このベクトルは、その顔固有の特徴をコンパクトな数値として表現したものです。
照明、表情、年齢(常識的な範囲内)、カメラが異なっても、同一人物の2つの顔からは、ベクトル空間上で互いに近い埋め込みが生成されるべきです。異なる人物からは、互いに離れた埋め込みが生成されるべきです。
技術的な仕組み:
ネットワークアーキテクチャは通常、数百万枚の顔画像で学習された、改良版のInception-ResNetまたはResNetです。重要な革新はアーキテクチャそのものではなく、学習時に使われる損失関数にあります。
- Softmax損失(基準方式):顔認識を分類問題として扱います。機能はしますが、角度空間で十分に分離された埋め込みを生成できません。顔認識用途では、ほぼ時代遅れです。
- Triplet損失:FaceNetによって広まった手法です。ネットワークはアンカー/ポジティブ/ネガティブの顔トリプレットを比較し、同一人物の埋め込みを近づけ、異なる人物の埋め込みを遠ざけることで学習します。学習中には、難しいトリプレットを慎重にマイニングする必要があります。識別力の非常に高い埋め込みを生成します。
- ArcFace損失:2026年時点で、本番の顔認識システムにおいて最も広く使われている損失関数と言ってよいでしょう。特徴ベクトルと対応するクラス重みの間の角度空間に加法的角度マージンのペナルティを加え、コサインマージン方式よりもクラス内クラスタを密にし、クラス間の差を広げます。[InsightFace](https://github.com/deepinsight/insightface)プロジェクトが参照実装を提供しており、最先端モデルの多くはArcFaceまたはその派生版で学習されています。たとえばAdaFaceの適応的マージンも、ArcFaceの定式化を基盤としています。独自の顔認識モデルを学習またはファインチューニングする場合、ArcFaceが標準的な出発点です。
- CosFace損失:Softmax損失にコサインマージンを加え、各人物内でより密にまとまり、人物間ではより分離した埋め込みをネットワークに生成させます。
- SphereFace/A-Softmax:2017年に登場した初期の角度マージン方式です。歴史的には重要ですが、ArcFaceやより新しい損失関数にほぼ取って代わられています。
出力: 単位超球面へL2正規化された、512個の浮動小数点数から成るベクトルです。顔に関するすべての情報が、2KBのデータに圧縮されます。これが保存、インデックス作成、比較の対象になります。
正規化の落とし穴: 多くの開発者は、比較前に埋め込みをL2正規化する必要があることを忘れます。正規化されていない埋め込みでは、類似度スコアが大きく不安定になります。「おおむね動作する」ため診断しにくい一般的なバグです。テストでは一致候補の相対順位が正しく見えても、絶対的な類似度スコアが画像ごとに変動し、しきい値に基づく判定が信頼できなくなります。FaceNet512はデフォルトで正規化済みの埋め込みを生成しますが、独自モデルを使用する場合やONNX経由でエクスポートする場合は、出力埋め込みが単位超球面上にあること、つまりL2ノルムが1.0であることを必ず確認してください。
本番環境への導入:ONNX Runtimeと量子化: ベンチマークの速度値は、クリーンなGPU上でFP32推論を行う前提です。本番では、多くのシステムがINT8量子化を適用したONNX Runtimeを使用します。これにより、精度低下を最小限(通常、LFWで0.1%未満)に抑えながら、推論時間を2~3倍高速化できます。手順は、PyTorchまたはTensorFlowモデルをONNXへエクスポートし、約1,000枚の顔画像から成るキャリブレーション用データセットを使ってONNX Runtimeの量子化ツールを実行し、量子化済みモデルを導入するというものです。同じハードウェアで「顔ごとに10ミリ秒」から「顔ごとに3~4ミリ秒」へ短縮できます。数十億枚の画像を処理する場合、この差は極めて重要です。
混合精度推論: GPU上のバックボーンにはFP16を使用し、最終埋め込み層にはFP32を使用すると、この記事の後半で説明する浮動小数点精度の問題を回避しながら、1.5~2倍高速化できます。これは、全面的なFP32(高精度だが低速)と全面的なFP16(高速だが、ハードウェアごとに微妙に異なる埋め込みを生成する可能性がある)の間の実用的な妥協点です。
エッジ導入向けの埋め込み蒸留: 知識蒸留を利用し、FaceNet512の埋め込みを模倣する小型の生徒ネットワーク(MobileFaceNet、約100万パラメーター)を学習できます。生徒モデルは10倍の速度で95%以上の精度を実現できるため、GPUを利用できないモバイルやエッジ環境でも実用的です。重要なのは、顔の人物ラベルを使って生徒モデルをゼロから学習する必要がないことです。ラベルなしの顔データに対して教師モデルの埋め込みを再現するよう学習するため、必要な計算量がはるかに少なく、人物ラベル付きデータセットも不要です。
第4段階:照合
2つの顔埋め込みが与えられたとき、同一人物かどうかをどう判断すればよいでしょうか。方法は2つあります。
コサイン類似度: 2つの埋め込みベクトル間の角度のコサインを計算します。範囲は-1~1で、1は同一を意味します。「同一人物」と判断する一般的なしきい値は、モデルや用途に応じて0.4~0.6です。シンプルで高速であり、FaceNet512の埋め込みはL2正規化されているため、良好に機能します。
ユークリッド距離: ベクトル間のL2距離を計算します。正規化された埋め込みでは、コサイン類似度と数学的に等価です(d = sqrt(2 - 2*cos_sim))。この形式を好むシステムもあります。
検索(1:N照合)の場合: 数百万件のデータベースから顔を探す場合、総当たり比較では遅すぎます。近似最近傍(ANN)検索を使用します。
- FAISS(Facebook AI Similarity Search):標準的なライブラリです。GPUアクセラレーションと複数のインデックス形式(IVF、HNSW、PQ)に対応しています。10億個のベクトルを数ミリ秒で検索できます。無料かつオープンソースです。
- Milvus:内部でFAISSを使用し、永続化、スケーリング、APIレイヤーを追加した専用ベクトルデータベースです。
- Qdrant/[Weaviate](https://weaviate.io/)/[Pinecone](https://www.pinecone.io/):インフラを自分で運用したくない場合に利用できる、マネージド型ベクトルデータベースです。
1,000万件の顔データベースであれば、単一GPU上で適切に調整されたFAISSのHNSWインデックスにより、上位10件を5ミリ秒未満で返せます。
FAISSのインデックス形式の選択は極めて重要です。 IVF-PQは高い圧縮率(ベクトルあたり2KBではなく8~16バイト)を実現しますが、量子化誤差によって真の一致がしきい値を下回るような、境界付近の一致では精度が低下します。HNSWは精度を維持できますが、完全な浮動小数点ベクトルとグラフ構造を保存するため、メモリ使用量が4~8倍になります。IVF-HNSWのハイブリッドインデックスは、1,000万~10億件規模で最良のバランスを提供します。多くのチームは当初、チュートリアルの推奨に従って誤ったインデックス形式を選び、制約に直面した6か月後にインデックス基盤全体を再構築することになります。インデックス形式を決定する前に、現実的なデータ量とクエリパターンを使って、実際のワークロードをテストしてください。
ANNインデックスのコールドスタート問題: HNSWとIVFインデックスが良好に機能するには、最低限のベクトル数が必要です。ベクトルが約1万件未満なら、インデックスのオーバーヘッド(グラフ探索や重心比較)が計算処理を上回るため、実際には総当たり検索の方が高速です。成長初期は総当たり検索(FAISS IndexFlatIP)で開始し、データベースが5万~10万ベクトルを超えた段階でANNインデックスへ移行してください。
バイナリコードによる事前フィルタリング: 各埋め込みのバイナリハッシュを、二値化またはSimHashによって計算すると、高コストな浮動小数点比較の前に、低コストなハミング距離フィルターを実行できます。再現率の低下を最小限に抑えながら、候補集合を90%以上削減できることがあります。各完全埋め込みと一緒に、256ビットまたは512ビットのバイナリコードを保存します。クエリ時には、まず全バイナリコードとのハミング距離を計算し(CPUのPOPCNT命令により非常に高速)、上位1~5%の候補を選び、その候補だけに正確なコサイン類似度を計算します。この2段階方式は、データセットが利用可能なGPUメモリを超える場合に特に有効です。
顔属性による再ランキング: 最初の埋め込み検索で候補を取得し、推定属性(年齢範囲、性別、肌の色、ひげ)を利用した2回目の処理で、明らかな誤一致を除外できます。クエリ顔が25歳の女性と推定され、候補が60歳の男性と推定されるなら、埋め込みの類似度スコアにかかわらず、ほぼ確実に誤検出です。この単純なヒューリスティックにより、最小限の計算コストで誤検出を30~50%削減できます。本番の顔検索で最も活用されていない手法の1つです。
動画における時間的一貫性: 静止画ではなく動画の顔を照合する場合、追跡された同じ顔の複数フレームから埋め込みを平均すると、精度が大幅に向上します。難しいベンチマークでは、5~10%向上することもあります。トラック単位の埋め込み集約は、フレーム単位の照合より明らかに優れています。SORTやDeepSORTのような顔トラッカーでフレーム間の検出を関連付け、各検出の埋め込みを計算し、検出段階の顔品質スコアを重みとする品質加重平均によって、単一の「トラック埋め込み」に集約します。
最良のオープンソース顔認識モデル(2026年)
FaceNet512
業界標準。 FaceNet512は、GoogleのFaceNetアーキテクチャの512次元埋め込み版で、元の128次元版よりも広く、識別力の高い埋め込み空間を提供します。
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- アーキテクチャ:Inception-ResNet-v2バックボーンから512次元埋め込みを生成
- ライセンス:MIT(制約が少なく、商用利用可能)
- LFW精度:99.65%
- 埋め込みサイズ:512次元
- 対応内容:標準的な検出パイプライン(MTCNN、[RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface))と組み合わせ、エンドツーエンドの認識に対応
- Python API:「deepface」ライブラリまたは単独実装で利用可能
評価: 2026年に顔認識システムを構築するなら、FaceNet512は有力な出発点です。優れた精度、高い識別力を持つ512次元埋め込み、制約の少ないMITライセンス、幅広いエコシステム対応を備えています。
FaceNet(Google、オリジナル128次元版)
2015年に埋め込み方式を普及させたモデルです。アンカー/ポジティブ/ネガティブの顔トリプレットを比較してネットワークが学習する、Triplet損失を導入しました。
- 原論文:"FaceNet: A Unified Embedding for Face Recognition and Clustering"(Schroffほか、2015年)
- リポジトリ:複数の実装あり(davidsandberg/facenetは定番のTensorFlow版)
- ライセンス:MIT
- LFW精度:99.63%(オリジナル)、最新の学習手法では最大99.75%
- 埋め込みサイズ:128次元
- アーキテクチャ:Inception-ResNet-v1またはInception-ResNet-v2
評価: 歴史的に重要であり、現在も良好に機能します。128次元埋め込みはよりコンパクトですが、512次元のFaceNet512版より識別力がわずかに劣ります。埋め込みの保存容量を小さくする必要がある場合や、メモリ制約のあるTensorFlow環境で作業する場合に適しています。
DeepFace(Facebook/Meta)
Pythonライブラリのdeepface(小文字)とは別物です。MetaのDeepFace(2014年)は、顔認識へディープラーニングを適用した最初期の手法の1つで、LFWにおいて人間に近い精度を達成しました。
現在、より関連性が高いのは、Serengilによる「deepface」Pythonライブラリです。
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- リポジトリ:github.com/serengil/deepface
- ライセンス:MIT
- 機能:FaceNet512、FaceNet、VGG-Face、OpenFace、DeepID、Dlib、SFaceという複数のバックエンドモデルに統一APIを提供するラッパーライブラリ
- 対応内容:本人確認、検索、顔属性分析(年齢、性別、人種、感情)
- 使いやすさ:非常にシンプルなAPI
評価: プロトタイピングと実験には最適です。統一APIにより、1つのパラメーターを変更するだけでモデルを切り替えられます。本番では、性能と制御性を高めるため、FaceNet512を直接使用するのがよいでしょう。
dlib
Davis Kingが保守する、Pythonバインディング付きのC++ライブラリです。300万枚の画像データセットで学習された顔認識モデルが含まれています。
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- リポジトリ:github.com/davisking/dlib
- ライセンス:Boost Software License(制約が少ない)
- LFW精度:99.38%
- 埋め込みサイズ:128次元
- 検出:HOGベース(高速でCPU向け)およびCNNベース(より高精度)
評価: 堅牢で実績のあるC++実装であり、優れたPythonバインディングを備えています。FaceNet512より精度は低いものの、信頼性は非常に高いです。C++で作業する場合や、PyTorch/ONNXへの依存がない軽量ソリューションが必要な場合に適しています。
AdaFace
画像品質のばらつきに特化して対処する比較的新しいモデル(2022年)です。標準モデルは高品質画像で学習されており、低解像度またはぼやけた入力では性能が低下します。AdaFaceは、学習中に画像品質に応じてマージンペナルティを調整します。
- リポジトリ:github.com/mk-minchul/AdaFace
- ライセンス:MIT
- 主な利点:低品質画像(監視映像、遠距離カメラ)で優れた性能
- LFW精度:99.82%
- IJB-C TAR@FAR=1e-4:97.39%(難しいベンチマークで多くのオープンソースモデルを上回る)
評価: 入力画像の品質が低い場合に使用してください。監視、CCTV分析、その他画像品質を制御できない状況では、AdaFaceは標準モデルより明確に優れた結果を示します。
性能比較表
| モデル | LFW(%) | 埋め込み | 速度(ミリ秒/顔) | ライセンス |
|---|---|---|---|---|
| FaceNet512(IR-v2) | 99.65 | 512次元 | 約10ミリ秒(GPU) | MIT |
| FaceNet(IR-v1) | 99.63 | 128次元 | 約12ミリ秒(GPU) | MIT |
| AdaFace(R100) | 99.82 | 512次元 | 約9ミリ秒(GPU) | MIT |
| dlib ResNet | 99.38 | 128次元 | 約25ミリ秒(CPU) | Boost |
| VGG-Face2 | 99.43 | 2048次元 | 約15ミリ秒(GPU) | CC BY-SA |
LFW(Labeled Faces in the Wild)は標準ベンチマークですが、実質的には解決済みです。現代のすべてのモデルが99%を超えています。実際の差は、IJB-C(多様な条件)やTinyFace(低解像度)のような、より難しいベンチマークで現れます。
ベンチマークと現実について: これらの速度値は、ウォームアップ済みのGPUで単一顔にFP32推論を実行した場合です。本番でONNX RuntimeのINT8量子化を利用すれば、2~3倍の高速化を期待できます。ただし、検出、アラインメント、品質スコアリング、埋め込みを含む完全なパイプラインには、埋め込み抽出単体の3~5倍の時間がかかることも忘れないでください。単一のA100 GPUにおける完全なパイプラインの現実的なエンドツーエンド処理性能は、埋め込み単体のベンチマークが示唆する毎秒数千顔ではなく、毎秒200~400顔です。
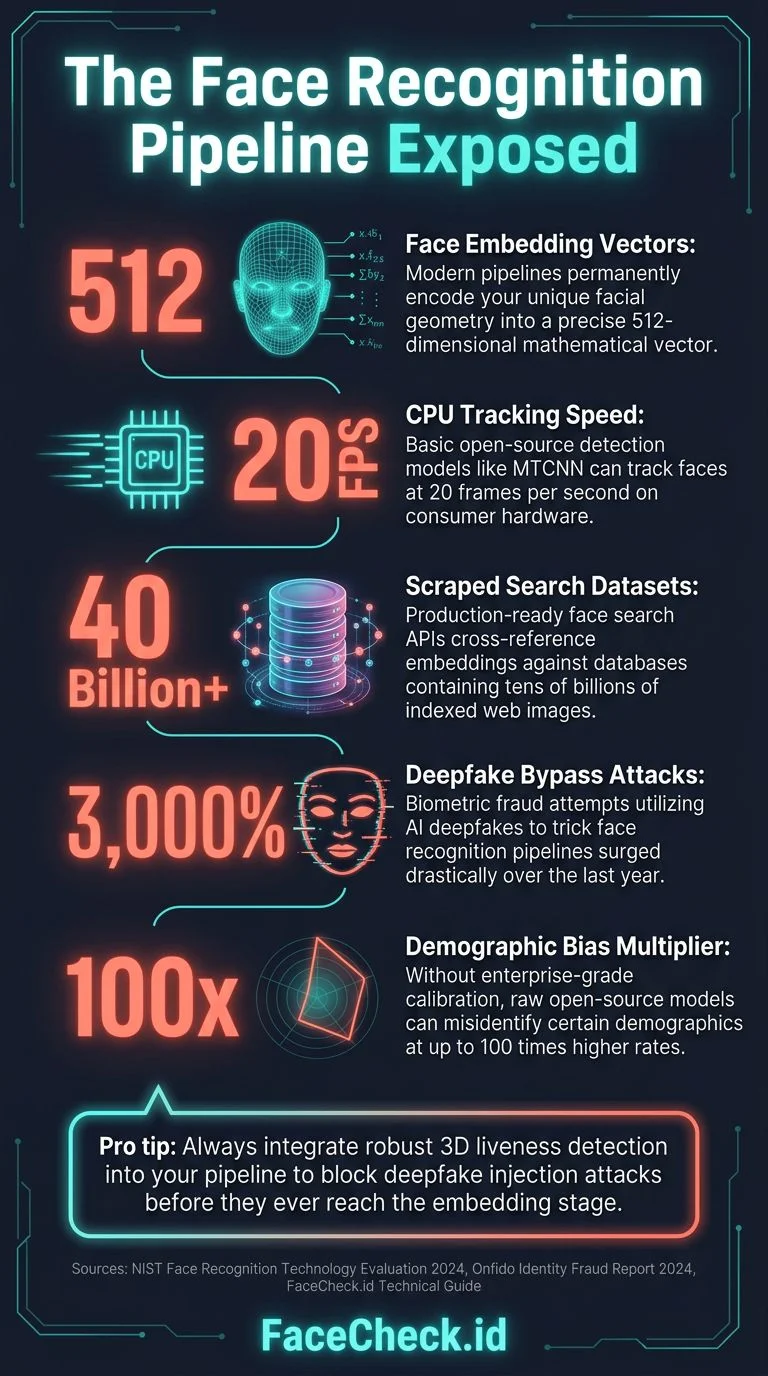
オープンソースモデルと本番システムの隔たり
チュートリアルでは語られないことがあります。Jupyter notebookで顔認識モデルを動かすのは簡単です。実際に大規模運用できる本番システムを構築するには、どのモデルも解決してくれない長いリストのエンジニアリング課題に対処する必要があります。ほとんどのチームは、コストと期間の両方を大幅に過小評価します。「モデルを接続するだけ」に見えたプロジェクトは、本番運用可能になるまでに50万~200万ドル以上を容易に消費する、12~24か月の開発作業へ変わります。しかも、これは継続的な運用コストを含まない金額です。
インフラ費用
埋め込み抽出向けGPU計算処理。 数十億枚の画像に対して顔検出と埋め込み抽出を実行する作業は、ノートパソコンではできません。単一のNVIDIA A100 GPUは、検出、アラインメント、埋め込みを含む完全なパイプラインで、毎秒約200~400顔を処理できます。10億枚の画像を現実的な期間、たとえば1週間以内で処理するには、40~80基のGPUを連続稼働させるクラスターが必要です。クラウド料金では、処理1回につき5万~15万ドルかかり、モデルの改善やパイプラインの変更に伴って再処理も必要になります。ハードウェアを購入する場合、GPUサーバーに30万~80万ドルかかるほか、ラックスペース、電力、冷却、保守担当者も必要です。
大規模ストレージ。 512個の浮動小数点数(各2KB)から成る10億件の顔埋め込みだけで、ベクトルデータは約2TBになります。元画像、サムネイル、メタデータ、インデックス構造を加えると、数百TBから数PB規模のストレージが必要です。ベクトルインデックス向けの高性能NVMeストレージは、クラウドで月額1GBあたり0.10~0.25ドルです。50TBのホットストレージなら、維持するだけで月額5,000~1万2,500ドルかかります。
ベクトル検索インフラ。 単一マシン上のFAISSは、インデックス形式と利用可能なRAMに応じて、約1億~5億ベクトルが上限です。それを超えると、複数シャードへの分散検索、負荷分散、耐障害性のためのレプリケーション、インデックスを保持する十分なRAMが必要になります。10億ベクトル以上に対応する本番品質の分散FAISSまたはMilvus環境には、通常、8~16台の大容量メモリマシン(各256GB以上のRAM)が必要で、クラウド計算費用は月額1万5,000~4万ドルになります。
ネットワークと帯域幅。 数十億枚の画像をクロールするには、数PBのデータをダウンロードする必要があります。主要クラウドプロバイダーの外向き転送料金が1GBあたり0.05~0.09ドルなら、データ転送だけで数万ドルかかることがあります。また、クローラー、GPU処理ノード、ストレージバックエンド間には、高スループットの内部ネットワークが必要です。
ウェブ規模の顔検索エンジンに必要なインフラ総費用の見積もり: 継続的なクラウド費用は月額3万~8万ドルです。自社ハードウェアの場合は、初期費用50万~150万ドルに加え、電力、帯域幅、保守に月額1万~2万ドルかかります。これはインフラだけの費用であり、エンジニアがアプリケーションコードを1行でも書く前の金額です。
エンジニアリングの期間
本番用の顔検索システムは、ハッカソンで作れるプロジェクトではありません。経験豊富なエンジニア3~5人のチームを想定した現実的なスケジュールは次のとおりです。
1~3か月目:中核パイプライン。 検出、アラインメント、埋め込み抽出を安定して動作させます。基本的なベクトルインデックスを構築し、ローカルファイルからの画像取り込みに対応します。ここは、すべてが順調に進み、デモも印象的に見える「楽しい」段階です。
3~6か月目:ウェブクローリング基盤。 主要プラットフォーム向けスクレイパーを構築します。レート制限、CAPTCHA、ログイン障壁、動的レンダリング(JavaScriptを多用するサイト)、画像重複排除、コンテンツフィルタリングに対処します。ソーシャルメディアごとに異なるスクレイピング防止策があり、クローラーが毎週のように壊れることに気づきます。クローラーが何も通知せず停止したことを検知する監視機能も構築します。ウェブは乱雑で敵対的なため、この段階だけでも予想以上の時間がかかります。
6~9か月目:規模と信頼性。 試作版は100万件の顔で動作しました。次は1億件に対応させます。FAISSインデックスがRAMに収まらないことに気づき、シャーディングを実装します。取り込みパイプラインの競合状態を修正します。ダウンロードに失敗する15%の画像向けに再試行ロジックを構築します。破損画像、JPEGを名乗りながら実際は異なる形式の画像、EXIF回転フラグ付き画像、不完全なダウンロードに対処します。午前3時に障害が発生しても把握できるよう、監視、アラート、ログを追加します。
9~12か月目:品質と精度。 大規模環境での誤検出率が許容できないことに気づきます。低品質な埋め込みを除外する顔品質スコアリングを実装します。用途ごとにしきい値を調整します。不適切な一致を報告して調査できるフィードバック機構を構築します。浮動小数点精度の違いにより、GPUアーキテクチャごとにモデルが異なる結果を生成することに気づき、その原因追跡に2週間を費やします。
12~18か月目:本番環境向けの堅牢化。 認証、レート制限、利用状況追跡を備えたAPIレイヤーを構築します。GDPR/CCPA準拠機能として、オプトアウト機構、データ削除要求、監査ログを追加します。結果キャッシュを実装し、管理ツールを構築し、ドキュメントを作成します。セキュリティ監査に対応し、すべてを負荷テストします。それまで気づかなかったメモリリークを修正します。
18~24か月目:継続運用。 ウェブサイトのレイアウト変更によりクローラーが壊れます。新しい種類の画像が登場してモデルがドリフトします。ディスク容量が尽き、インデックスの再構築が必要になります。ユーザーから予想もしなかったエッジケースが報告されます。システムが漫画の顔にも確信度の高い一致を返すことが判明し、「実在する顔」フィルターを追加する必要が生じます。これは終わることがありません。
遭遇する問題の完全なリスト
インフラと期間以外にも、顔認識システムをゼロから構築するチームが遭遇する主要な問題をすべて挙げます。これは理論上の懸念ではなく、実際の本番システムで発生した問題です。
データ品質の悪夢:
- 入力がゴミなら出力もゴミ。 インターネットには、ミーム、AI生成顔、イラスト、写真を撮影した画像、雑誌の表紙、彫像があふれています。検出器はそのすべてから「顔」を見つけ、インデックスを汚染する埋め込みを生成します。合成顔、イラスト顔、極端に低解像度の切り抜き、写真ではないコンテンツを除外する分類器が必要です。こうしたフィルターの構築と保守だけでも、1つのプロジェクトになります。
- 重複画像と類似画像。 同じ写真が、異なる切り抜き、透かし、圧縮レベル、色調整を施され、数十のサイトに掲載されています。重複排除を行わないと、1枚の拡散画像から、すべて同じ画像である数百件の「一致」が生成され、本来の検索結果が埋もれます。知覚ハッシュ(pHash、dHash)は役立ちますが、完全ではありません。複数のレベルで重複排除が必要です。URL単位の重複排除(簡単)、知覚ハッシュによる重複排除(サイズ変更や再圧縮された複製を検出)、埋め込み単位の重複排除(少し異なる角度から撮影された同じ顔を検出)です。各レベルは他では見逃すものを検出するため、重複排除には予想以上の時間を費やすことになります。
- 年齢と外見の変化。 大学時代の写真から生成された顔埋め込みは、15年後の写真と一致しないことがあります。体重の変化、加齢、美容整形、ひげ、異なる髪型は、いずれも認識精度に影響します。これを完全に処理できるモデルはありません。20年間の隔たりがある同一人物を照合できなければ、ユーザーはシステムを非難します。
- 人口統計上の偏り。 欧米人/白人中心のデータセットで学習されたオープンソースモデルは、他の人口集団で性能が低下します。民族間の精度差はLFWから推測されるより大きく、LFWは約77%が白人です。世界規模で導入すると、難しいベンチマークにおける人口集団間の精度差は5~15%になる場合があります。MS-Celeb-1Mで学習されたFaceNet512のようなモデルは、その人口統計上の偏りを受け継ぎます。公平な性能を実現するには、BUPT-Balancedfaceのような均衡データセットでファインチューニングするか、人口統計を考慮した学習手法を使うことが重要です。人種集団ごとの精度を評価しなければ、一部のユーザーには良好に動作し、他のユーザーにはうまく動作しないシステムを公開する可能性があります。これは倫理的な問題だけでなく、製品品質と法的責任の問題でもあります。
- EXIF方向情報の処理。 ウェブ上の画像の約15~20%にはEXIF方向タグがあり、無視すると顔が横向きまたは上下逆になります。ほとんどの顔検出器は回転した顔を検出できません。適切な向きの画像を使用するテストでは見逃しやすい一方、本番環境では壊滅的な影響を与える、静かな精度低下要因です。画像処理パイプラインの最初の段階で、必ずEXIF方向補正を適用してください。
- プログレッシブJPEGとWebPのデコード失敗。 一部の画像ライブラリは、部分的にダウンロードされたプログレッシブJPEGや切り詰められたWebPファイルから、破損したピクセルデータを通知なしに生成します。顔検出器が破損アーティファクト内から「顔」を見つけ、無意味な埋め込みを生成することもあります。処理前に、ファイルがエラーなくデコードでき、生成されたピクセルバッファの寸法が妥当であることを確認する画像整合性検証が必要です。これがなければ、破損画像が気づかれないままインデックスを汚染します。
最初は明らかでないエンジニアリング上の問題:
- 埋め込みのバージョン管理。 モデルをアップグレードすると、データベース内のすべての埋め込みが新モデルの出力と互換性を失います。精度向上は重要なので、アップグレードは必ず発生します。データベース全体を再埋め込みするか、高コストで時間がかかり、すべての元画像を保持しておく必要があります。移行中に並列インデックスを運用するか、インフラ費用が2倍になります。後方互換性を維持するか、複雑になり、改善能力が制限されます。良い解決策はなく、比較的苦痛の少ない方法があるだけです。
- 浮動小数点演算の決定性。 同じ画像でも、GPUモデル、CUDAバージョン、さらにはバッチサイズが異なると、浮動小数点演算のため微妙に異なる埋め込みが生成される場合があります。差は小さいものの(1e-6~1e-4)、積み重なります。あるマシンでは0.401だった一致スコアが、別のマシンでは0.399となり、二値のしきい値判定が逆転する可能性があります。デバッグ時には非常に厄介です。特に危険なのがGPUドライバーの更新です。NVIDIAドライバーの更新によって、CUDAレベルの浮動小数点動作が変わる場合があります。535.xドライバーで計算した埋め込みは、同じ画像を545.xで処理した結果と異なる可能性があります。本番では、全機器でドライバーバージョンを固定し、更新のたびに埋め込みの一貫性を検証する必要があります。
- 並行処理と競合状態。 複数のクローラーが同時に顔を取り込み、インデックスの更新中にユーザーが検索し、検索結果の組み立て中に削除要求が届きます。ベクトルデータベースには、SQLデータベースと同じ成熟したトランザクション機能がありません。顔が部分的にしかインデックス化されない、クエリが古い結果を返す、削除が全シャードに反映されないといった状況に遭遇します。
- メモリ管理。 FAISSインデックスはメモリマップされますが、クエリ性能はインデックスのどの程度をRAMに収められるかに大きく左右されます。インデックスが成長すると、OSがインデックスページをメモリから追い出した際に、クエリ遅延が予測不能に急増します。OOMキルは最悪のタイミングで発生します。Linuxのメモリ管理、スワップ設定、[NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access)トポロジーを徹底的に理解することになります。コールドスタート後のウォームアップも問題です。FAISS HNSWインデックスはメモリマップされるため、サーバー再起動後の最初の数百クエリは、インデックスページがまだRAMに読み込まれておらず、10~100倍遅くなります。本番トラフィックを受け付ける前にインデックスを事前ロードするウォームアップ段階が必要です。さもなければ、デプロイ後の最初のユーザーが極めて大きな遅延を経験します。
- 通知されない障害。 ウェブサイトのHTML変更によりクローラーが停止します。ドライバー更新により、GPU処理ノードがNaNの埋め込みを生成し始めます。ディスクが満杯になり、新しい顔が通知なしにインデックス化されなくなります。これらの障害はエラーを発生させず、静かにシステムを劣化させます。包括的な監視と異常検知がなければ、ユーザーから苦情が来るまで気づきません。
- FAISSの更新問題。 IVFインデックスへ新しい埋め込みを追加すると、ボロノイ領域の均衡が崩れます。量子化器を再学習するまで、検索品質は徐々に低下します。ウェブ規模では、再学習にデータセット全体で数時間のGPU処理が必要です。通常、チームは追加分をまとめ、毎週または毎月再学習します。そのため、新しく取り込まれた顔は、完全な精度ですぐに検索できません。常に鮮度と検索品質を天秤にかける必要があり、無償で両方を得る方法はありません。
- インデックスシャード間のスコア較正。 インデックスを複数マシンへ分割すると、シャードごとに埋め込み分布が異なるため、異なるシャードの生の類似度スコアを直接比較できません。結果を有意義に統合するには、シャードごとのスコア正規化(コホート正規化、Z-norm、T-norm)が必要です。較正しなければ、シャードAの0.45は強い一致を表す一方、シャードBの0.45は平凡な一致を表すことがあります。統合結果は信頼できなくなります。
- 分散検索のファンアウト問題。 N個のシャードを検索すると、クエリごとにN回のネットワーク往復が発生します。どれか1つのシャードが遅ければ、GC停止、ディスクI/Oの急増、ネットワーク障害などにより、クエリ全体が遅くなります。P99遅延は最も遅いシャードのP99によって決まり、シャードが増えるほど悪化します。許容可能なテールレイテンシを維持するには、ヘッジリクエスト(重複リクエストを送信し、先に返った方を採用)や適応的タイムアウトのような手法が不可欠です。
精度と照合の問題:
- しきい値調整に「完了」はありません。 データベースの成長に伴い、最適な類似度しきい値は変化します。100万件の顔なら、0.45というしきい値で適合率と再現率の良好なバランスが得られます。1億件では、似ている別人が増えるだけで、同じしきい値から10倍の誤検出が生じます。適応的なしきい値または後処理による再ランキングが必要です。根底にある数学は容赦がありません。データベースが100万件から1億件、10億件へ成長すると、似ている別人が増えるため、上位k件の類似度スコア分布は上方へ移動します。100万件で誤検出率0.1%だった固定しきい値が、10億件では10%になる可能性があります。この分布をモデル化してしきい値を動的に調整するか、規模の拡大に伴う適合率低下を受け入れる必要があります。
- オープンセット認識とクローズドセット認識。 ほとんどのベンチマークは、クエリ対象の人物がデータベースに必ず存在するクローズドセット性能を評価します。現実の顔検索はオープンセットです。クエリの顔がインデックスにまったく存在しない場合があります。オープンセット評価にはまったく異なる指標(ランク1精度ではなく、一定のFPIRにおけるTPIR)が必要で、失敗モードは順位の誤りではなく誤一致です。クローズドセットのベンチマークで99%を記録したシステムでも、実際の一致が存在しない場合に最も「近い」顔を確信を持って返してしまい、オープンセット環境では誤一致率が10%になる可能性があります。「一致なし」を正しく処理することは、正しい一致を見つけるのと同じくらい重要です。
- そっくりな人物とドッペルゲンガー。 1億件以上の顔データベースには、埋め込みが驚くほど近い無関係な人物の組み合わせが多数存在します。データベースが大きいほど、誤一致も増えます。ユーザーから「別人」の結果が定期的に報告されます。複数写真による確認、文脈情報(名前、場所)、人間による確認キューなど、これを処理する戦略が必要です。
- 姿勢に依存しない認識は依然として困難。 FaceNet512でさえ、ヨー角がプラスまたはマイナス60度を超えると性能が大幅に低下します。横顔と正面顔の照合精度は、正面顔同士と比べて10~20%低下することがあります。監視用途では、多くの顔が斜めを向いているため、実環境での精度はベンチマークが示す値よりかなり低くなります。3D対応データ拡張で学習したモデルやUV-GANのようなアーキテクチャは役立ちますが、複雑さが増します。入力データに斜めの顔が多い場合、これを例外ではなく、最優先の精度問題として扱ってください。
- 敵対的入力。 ユーザーはAI生成顔、ディープフェイク、モーフィング画像、意図的な摂動を加えた写真を送信します。システムを試している人もいれば、結果を操作しようとしている人もいます。こうした入力に対する一定の堅牢性がなければ、偽の顔に確信度の高い一致を返してしまいます。
- 写真加工。 フィルター、美容アプリ、濃い化粧、顔補正ソフトウェア。Instagram上の現実と実際の現実は異なります。こうした加工は、埋め込みの類似度に影響するほど顔形状を変化させます。強く加工された自撮り写真は、同じ人物の無加工写真と一致しない場合があります。
- 1つの顔、多数の埋め込み。 1人の人物について、異なるプラットフォーム、角度、年代にまたがる数百枚の写真がオンライン上に存在する場合があります。すべてを個別の一致として返すのか、単一人物にクラスタリングするのかを決める必要があります。大規模なクラスタリング(数億件の顔)は計算コストが高く、過剰統合(異なる2人を統合)と統合不足(同一人物の写真を関連付けられない)という独自の失敗モードも生じます。
運用上の悩み:
- スクレイピング防止の軍拡競争。 主要なソーシャルメディアプラットフォームは、すべて積極的にスクレイパーをブロックしています。ページ構造の変更、CAPTCHAの追加、ヘッドレスブラウザーの検出、IP単位のレート制限、リクエストパターンのフィンガープリント、場合によってはおとりコンテンツの配信も行います。クローリング基盤は絶え間ない軍拡競争に置かれます。今日動作するスクレイパーが、翌週には完全にブロックされる可能性があります。クローラーの保守は継続的なエンジニアリングコストであり、一度構築すれば終わりではありません。
- 変化率のモデル化。 情報源ごとに更新頻度は異なります。有名人のニュースサイトには毎時新しい写真が追加されますが、個人のソーシャルメディアプロフィールは何年も変わらないことがあります。過去の変化率に基づくインテリジェントな再クロールスケジュールにより、重要な場所のインデックス鮮度を維持しながら、帯域幅コストを60~80%削減できます。これがなければ、静的な情報源を過剰にクロールして帯域幅と費用を無駄にするか、動的な情報源のクロールが不足して古い結果を返すことになります。
- CDNと地域ごとのコンテンツ差。 同じURLでも、リクエスト元の場所、端末のユーザーエージェント、Cookieに応じて異なる画像が配信される場合があります。クローラーがインデックス化した画像とユーザーが見る画像が異なり、「一致結果が表示先の画像と違う」という紛らわしい報告につながります。一部のCDNは、実際のブラウザーが画像の位置までスクロールするまで低解像度のプレースホルダーを配信します。こうしたエッジケースに対応するか、一定割合の幻の結果を受け入れる必要があります。
- ストレージ費用の増大。 画像ストレージは線形に増加し続け、止まりません。再埋め込みの可能性があるなら、元画像を削除できません。サムネイル、メタデータ、埋め込みベクトル、インデックスファイル、バックアップコピーもあります。システムが成熟するにつれて、ストレージ費用は加速します。1年目のストレージだけを予算化したチームは、3年目の費用に驚きます。
- 大規模なコンプライアンス要求。 GDPRは、個人に自身のデータの削除を要求する権利を与えています。オプトアウト要求を受けた場合、データベース全体からその人物の顔から生成されたすべての埋め込みを見つけて削除し、クローラーが元画像を再発見しても再追加されないようにし、監査のため削除を記録する必要があります。大規模環境では、専用ツールとエンジニアリング作業が必要です。[EU AI Act](https://artificialintelligenceact.eu/)は、顔認識を含む高リスクAIシステムに対し、適合性評価、偏りテスト、透明性義務、人間による監督機構などの追加要件を課します。
- オプトアウトの実装は見かけ以上に困難。 埋め込みを削除するだけでは不十分です。クローラーが同じ顔を再び見つけたときの再インデックス化を防ぐ必要があります。そのため、オプトアウト済み顔埋め込みの「ブロックリスト」インデックスを維持し、すべての新規埋め込みをインデックス化前に照合する必要があります。このブロックリスト自体も高速でなければならず、挿入のたびに照会されます。また、独自のデータ保持問題も生じます。削除要求に準拠するため、その人物と照合できるよう顔埋め込みを永久に保存しなければなりません。つまり、生体データの削除要求に従うために、生体データを保持することになります。この法的な矛盾は現実に存在し、多くの法域で未解決です。
- 公開クロールデータに関する同意の問題。 公開ソーシャルメディアプロフィールの生体データを処理する際のGDPR上の法的根拠については、法的な争いがあります。複数のEUデータ保護機関が顔認識企業に不利な判断を下しており、特に複数のEU加盟国におけるClearview AIへの決定が有名です。法的リスクは、法域、データソース、用途によって異なります。これは仮定上の将来的な懸念ではなく、現在進行中の執行分野です。
- 監査証跡の保存費用。 すべての検索クエリと返されたすべての一致を記録すると、コンプライアンス上必要になる場合がありますが、監査ログは実際の顔データより速く増える可能性があります。1日100万件の検索を処理し、それぞれ10件の結果を返すシステムは、1日あたり約1,000万件の監査レコードを生成します。保持義務は法域により1~7年の場合が多く、このデータは容赦なく蓄積します。監査用ストレージを後付けではなく、主要なコスト項目として計画してください。
- インシデント対応。 システムが顔を誤照合し、その誤一致に基づいて誰かが行動した場合、どうなるでしょうか。各結果がどのように生成されたかを示す監査証跡、照合判断を説明する機能、異議申立てを処理する手順が必要です。誰かが一致に異議を唱えたとき、「コサイン類似度が0.47で、しきい値の0.42を超えたから」という説明では納得を得られません。GradCAMのような手法を使えば、顔のどの領域が一致判断に寄与したかを示せます。これは紛争解決に役立ち、信頼を構築します。単に優れたエンジニアリングというだけでなく、法域によっては法的に要求される可能性があります。
- モデルと依存関係の劣化。 CUDA、Python、[ONNX Runtime](https://onnxruntime.ai/)、オペレーティングシステムの各バージョンは時間とともに変化し、推論パイプラインを微妙な形で壊す可能性があります。バージョン固定は役立ちますが、セキュリティパッチが必要になるまでです。依存関係の管理と環境の再現性に、驚くほど多くの時間を費やします。
- チーム内の知識集中。 FAISSのインデックス層を構築したエンジニアが、シャーディングロジックを理解しています。クローラーを調整したエンジニアが、特別な処理を必要とするサイトを知っています。こうした人が退職すると、18~24か月のプロジェクトでは人員の入れ替わりが発生しますが、重要な知識も失われます。ドキュメントは役立ちますが、直感的でない判断の「理由」までは完全に残せません。
実際の費用まとめ
公開インターネットを検索するウェブ規模の顔検索システムの場合:
- エンジニアリングチーム:シニアエンジニア3~5人を12~24か月=給与と間接費で60万~250万ドル
- インフラ(1年目):クラウド費用またはハードウェアに40万~100万ドル
- インフラ(継続):月額3万~8万ドル(年額36万~96万ドル)
- 法務とコンプライアンス:初期評価に5万~20万ドル、さらに継続的な法律相談費用
- 1年目の合計:140万~370万ドル
- 2年目以降の合計:インフラとエンジニアリング保守に年額50万~120万ドル
これは正常に動作するシステムの場合です。多くのチームは、問題が見積もりより困難だと気づいてAPIソリューションへ方向転換するまでに、6~12か月と50万ドル以上を費やします。
自社構築すべき場合とAPIを使うべき場合
自社構築に適している場合:
- 管理下にあるクローズドデータセット(社員証、顧客写真)が10万顔未満
- オンプレミスまたはエアギャップ環境で実行する必要がある
- モデル最適化、しきい値調整、エッジケースに対応できるMLエンジニアがいる
- 用途が検索(ウェブに対する1: N)ではなく本人確認(1:1)
- 複数年のエンジニアリングプロジェクトに予算と期間を投入できる
APIの利用に適している場合:
- 公開インターネット(ソーシャルメディア、ニュース、ウェブ)から顔を検索する必要がある
- ウェブスクレイピングとインデックス作成のパイプラインを構築、保守したくない
- 12~24か月の開発後ではなく、今すぐ結果が必要
- オンラインに投稿される新しいコンテンツへ継続的に対応する必要がある
- GDPR対応、オプトアウト要求、EU AI Actへの対応を他者に任せたい
- 100万ドル以上の初期インフラ費用と開発費用を避けたい
- 中核製品が顔検索そのものではなく、エンジニアリング時間を本来の製品に使う方がよい
FaceCheck.id顔検索API
インフラをゼロから構築せずに公開ウェブ上の顔検索を必要とする開発者向けに、FaceCheck.idはREST APIを提供しています。このAPIは、顔検出、埋め込み、ソーシャルメディア、ニュースサイト、広範なウェブ上の公開顔画像を継続的に更新するインデックスでの検索という、パイプライン全体を処理します。
FaceCheck.idは、ウェブ規模の検索向けに最適化された独自の顔認識モデルを使用しています。自分で導入して調整する必要があるオープンソースモデルとは異なり、この独自モデルは、インターネット顔検索特有の課題に合わせて学習、ファインチューニングされています。極端にばらつく画像品質、多様な照明条件、人口統計上の多様性、継続的にクロールされる巨大なインデックスに対応します。この独自方式により、汎用オープンソースモデルでは不可能な形で、モデル性能を独立して反復改善し、固有の検索パイプラインに最適化できます。ゼロから再現するには極めて困難かつ高額になる水準でシステムを動作させるため、何年ものエンジニアリング、テスト、改良が行われています。
APIの機能:
顔画像を送信すると、APIはインターネット上で見つかった一致顔を、信頼度スコアと参照元URLとともに返します。照合、インデックス作成、ウェブ規模のインフラはFaceCheck.id側で処理されます。前述したすべてのGPUクラスター、クローリングパイプライン、ベクトル検索基盤、コンプライアンスツール、継続的な保守は、利用者ではなくFaceCheck.id側の問題になります。
APIの基本:
- RESTful JSON API
- APIキーによる認証
- Base64エンコード画像または画像URLを送信
- 戻り値:類似度スコア、参照元URL、サムネイルプレビューを含む一致結果の配列
- レート制限と料金は利用量に応じて拡張
一般的な統合例:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
APIの用途:
- 出会い系アプリの本人確認:マッチ相手の写真が実在するソーシャルメディアプロフィールに掲載されているか確認できるようにする
- ブランド保護:チームの写真が偽のビジネスプロフィールに使われていないか確認する
- デューデリジェンス・プラットフォーム:身元調査やKYCワークフローに顔検索を追加する
- 不正防止システム:インターネット上の別の場所で異なる名前とともに掲載されている写真を使うアカウントに警告を付ける
- OSINTツール:ウェブ規模の顔照合を含む調査ツールを構築する
自社開発ではなく、このAPIを使う理由:
公開ウェブを検索する顔検索エンジンの構築には、(1)数十億枚の画像を発見してダウンロードするウェブ規模のクローリングパイプライン、(2)顔検出と埋め込み抽出を実行するために数十万ドルかかるGPU基盤、(3)完全なインデックスをリアルタイム検索するために数TBのRAMを備えた分散ベクトル検索システム、(4)インデックスの鮮度を保つ継続的な再クロール、(5)オプトアウト、データ削除要求、規制要件に対応するコンプライアンス基盤、(6)常勤で保守する3~5人のエンジニアチーム、(7)最初の実用版を公開するまでの12~24か月が必要です。これは、継続的な多額の費用も伴う、数百万ドル規模のエンジニアリングプロジェクトです。FaceCheck.idの独自モデルと実戦で検証済みのインフラを利用するAPIなら、そのすべてを1回のHTTP呼び出しで利用できます。
上で紹介したオープンソースモデルは、クローズドシステムの顔認識(社員の入退室管理、写真ライブラリの整理、独自の本人確認フロー)の構築には優れています。しかし、用途が「この顔がインターネット上のどこに掲載されているかを検索する」ことであれば、動作するモデルと動作する製品の間にあるエンジニアリング上の隔たりは巨大です。FaceCheck.id APIはその隔たりを埋め、数年ではなく数日で動作する製品を公開できるようにします。
利用開始: ドキュメント、料金、APIキー登録については、facecheck.id/en/Face-Search/APIをご覧ください。
よくある質問
最も精度の高いオープンソース顔認識モデルはどれですか?
Inception-ResNet-v2バックボーンを備えたFaceNet512は、現在、多くのベンチマークで優れた結果を達成しており、LFWでは99.65%です。低品質画像(監視、CCTV)の状況では、AdaFaceがIJB-Cのような難しいベンチマークでより優れた性能を示し、TAR@FAR=1e-4で97.39%を達成しています。
オープンソースの顔認識モデルを商用利用できますか?
はい。FaceNet512、FaceNet、DeepFace、dlib、AdaFaceは、すべて制約の少ないライセンス(MITまたはBoost)で公開されています。商用製品で利用できます。ただし、ソフトウェアライセンスにかかわらず適用される、法域内の生体データ処理に関する法的制限(GDPR、BIPA、EU AI Act)に注意してください。
独自の顔認識モデルを学習するには、どの程度のデータが必要ですか?
ゼロから学習する必要はありません。上記の事前学習済みモデルは、10万~50万人分、500万~1,200万枚の画像データセットで学習されています。特定分野の要件がある場合のみ、これらの事前学習済みモデルをファインチューニングしてください。ファインチューニングには通常、1万~10万枚の画像が必要です。ゼロからの学習には、数百万枚の画像と大量のGPUリソースが必要です。
顔の本人確認と顔検索の違いは何ですか?
顔の本人確認(1:1)は、2つの埋め込みを直接比較して「この2枚の写真は同一人物か?」に答えます。顔検索(1:N)は、1つの埋め込みを数百万件のデータベースと比較して「この人物はどこに登場するか?」に答えます。本人確認は計算上シンプルです。検索には効率的な最近傍インデックス(FAISS、Milvus)が必要です。ウェブ規模の検索では、構築と運用に数百万ドルかかる可能性がある、大規模なクローリングおよびインデックス基盤も必要です。
低品質画像での顔認識精度はどの程度ですか?
画像品質が低下すると、精度は大幅に低下します。鮮明な正面写真では、現代のモデルは99%以上の精度を達成します。ぼやけた監視映像や、顔幅が50ピクセル未満の写真では、精度が80~90%以下に低下する場合があります。AdaFaceは、標準モデルより品質のばらつきへ適切に対処できるよう特別に設計されています。どのシステムでも、入力画像の解像度が高いほど結果は劇的に改善します。姿勢も重要です。高解像度画像でも、横顔の精度は正面顔と比べて10~20%低下することがあります。
顔検索エンジンの構築費用はいくらですか?
公開インターネットを検索するウェブ規模のシステムでは、1年目の費用として140万~370万ドル(エンジニアリングチーム、インフラ、法務)を見込んでください。その後の継続費用は年額50万~120万ドルです。10万件未満の顔を含む非公開データベースを検索するクローズドシステムなら、費用は大幅に下がります。単一のGPUサーバーと1人のエンジニアで対応できます。費用は検索データベースの規模と、そのデータを収集するためにウェブをクロールする必要があるかどうかに応じて増加します。
本番用の顔認識システムを構築するには、どのくらいかかりますか?
単純な本人確認システム(既知のデータベースに対する1:1照合)なら、経験豊富なエンジニアが1~2週間で動作する試作版を構築し、1~3か月で本番運用可能にできます。ウェブ規模の顔検索システム(インターネットに対する1:N)の場合、本番で十分信頼できるものを作るには、3~5人のエンジニアチームで12~24か月を見込んでください。クローリング、スケーリング、コンプライアンスの課題により、中核の機械学習作業に加えて膨大な時間が必要になります。
価値のあるものを構築しましょう。クローズドシステムなら、FaceNet512から始めてください。しかし、ウェブ規模の顔検索が必要なら、自問してみてください。最初の実用的な結果を得るまでに、本当に140万~370万ドルを費やし、シニアエンジニアのチームを採用し、12~24か月待ちたいでしょうか。その代わりに、GPUクラスター、クローリングの悪夢、コンプライアンスの悩み、数年に及ぶ開発をすべて省き、FaceCheck.id APIを使えば、わずか1米ドルから始めて、5分以内に最初の検索結果を得られます。
画像検索に関してもっと読む
顔認識:基本を理解する
顔認識技術は、スマホのロック解除から犯罪捜査まで、私たちの生活にすっかり浸透しています。でも、その仕組みや精度、プライバシーへの影響をちゃんと理解している人は意外と少ないのではないでしょうか。この技術って本当に安全なの?人種によって精度に差があるって本当?専門家の解説動画とあわせて、押さえておきたい基本をわかりやすく解説します。
他の言語での主題について
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
どの顔検索エンジンがあなたに合っているか? PimEyes vs FaceCheck