Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
Si estás desarrollando algo que necesite comparar rostros, verificar identidades mediante una foto o buscar un rostro en un conjunto de datos, debes entender cómo funciona realmente el reconocimiento facial moderno por dentro. No la versión de marketing. El proceso real, desde los píxeles sin procesar hasta un vector de incrustación de 512 dimensiones que codifica la geometría facial única de una persona.
Este artículo desglosa todo el proceso de reconocimiento facial, compara los mejores modelos de código abierto disponibles en 2026, muestra las cifras reales de rendimiento y explica cuándo conviene desarrollar tu propio sistema y cuándo utilizar una API de producción.
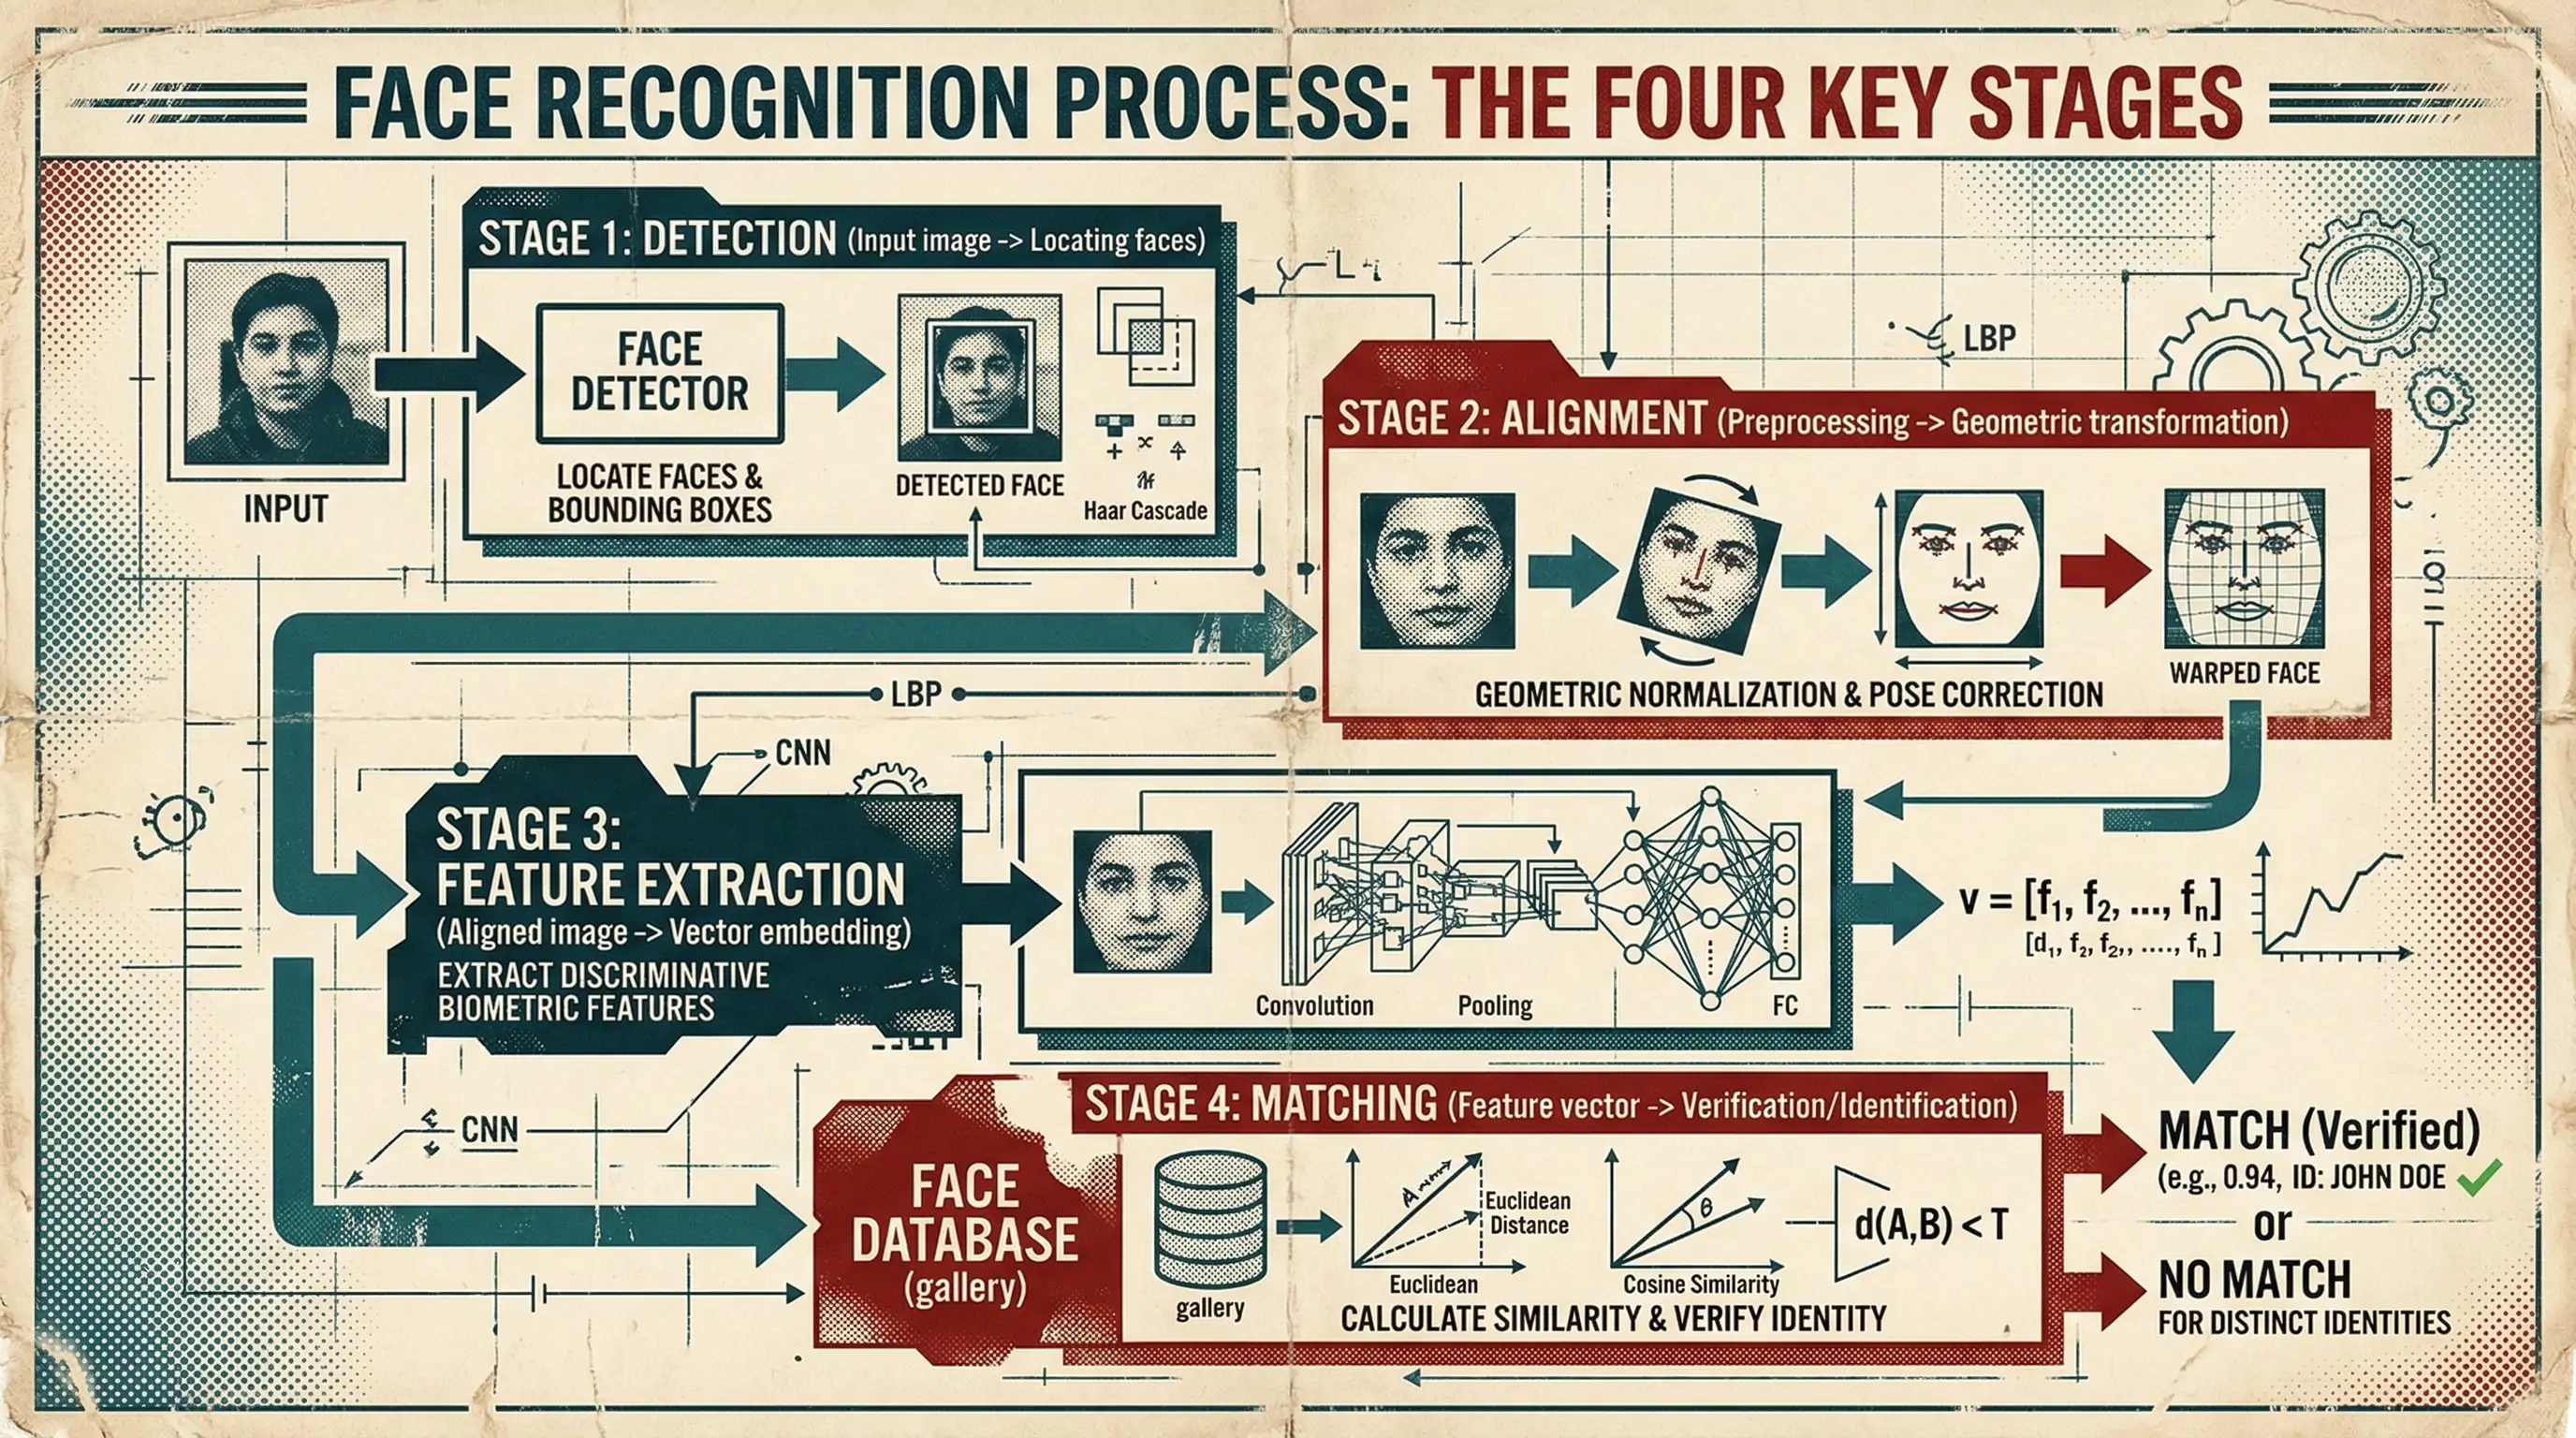
En este artículo, vamos a discutir
- El proceso de reconocimiento facial: cuatro etapas
- Mejores modelos de reconocimiento facial de código abierto (2026)
- Tabla comparativa de rendimiento
- La brecha entre los modelos de código abierto y los sistemas de producción
- Cuándo desarrollar y cuándo utilizar una API
- API de búsqueda facial de FaceCheck.id
- Preguntas frecuentes
El proceso de reconocimiento facial: cuatro etapas
Todos los sistemas modernos de reconocimiento facial siguen el mismo proceso básico, independientemente de si se ejecutan en una Raspberry Pi de 35 dólares o en un clúster de GPU de una agencia gubernamental. Entender estas cuatro etapas te ayudará a evaluar cualquier modelo o API.
Etapa 1: detección de rostros
Antes de poder reconocer un rostro, necesitas encontrarlo. La detección de rostros toma una imagen y genera cuadros delimitadores alrededor de cada rostro presente. Parece sencillo, pero es donde muchos sistemas fallan en producción.
Los modelos estándar:
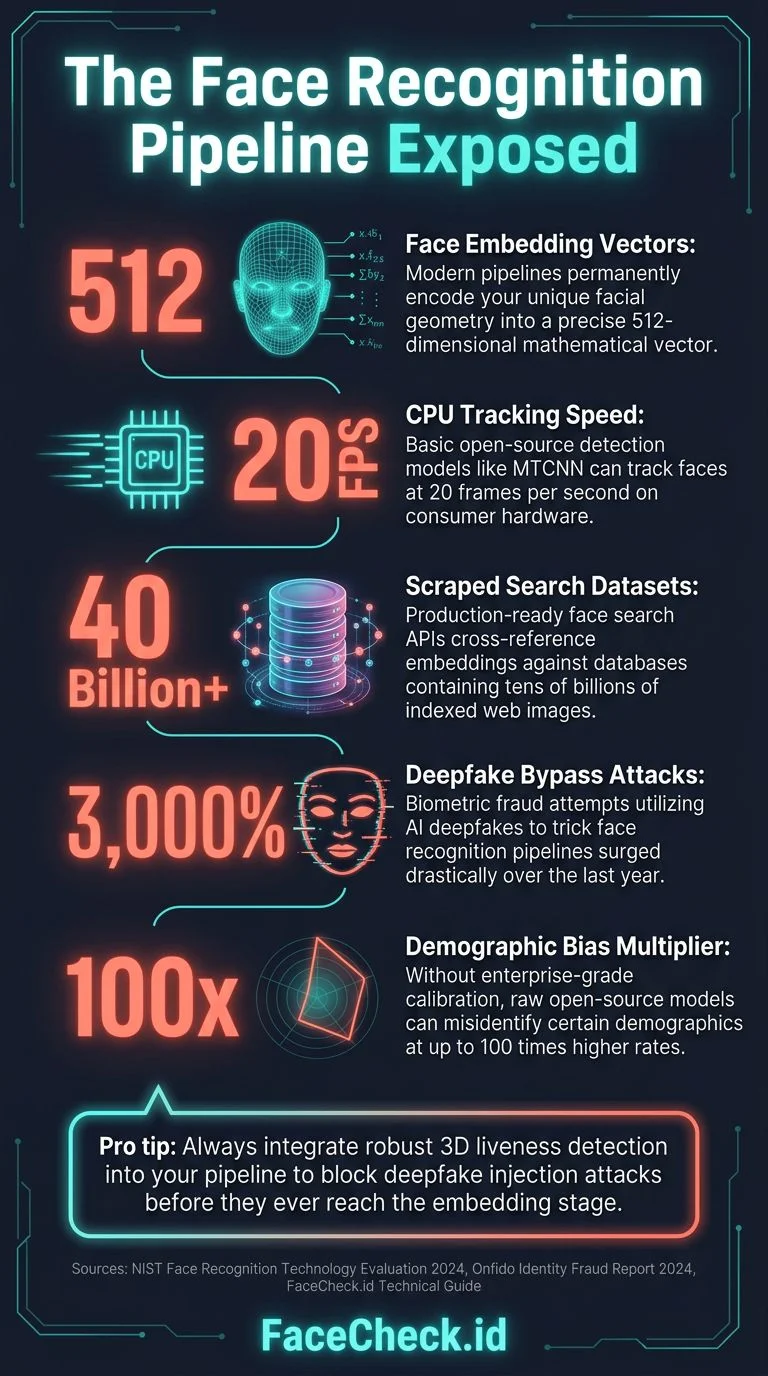
- MTCNN (redes convolucionales en cascada multitarea): El caballo de batalla de la detección facial desde 2016. Cascada de tres etapas: la red de propuestas (P-Net) encuentra regiones candidatas, la red de refinamiento (R-Net) filtra falsos positivos y la red de salida (O-Net) refina los cuadros delimitadores y genera puntos de referencia faciales. Sigue siendo muy utilizada. Es precisa con rostros frontales, pero tiene dificultades con ángulos extremos y oclusiones. Funciona a unos 20 FPS en una CPU moderna.
- RetinaFace: Lo más avanzado en precisión de detección. Detector de una sola etapa basado en una arquitectura de [red piramidal de características](https://arxiv.org/abs/1612.03144). Devuelve cuadros delimitadores y cinco puntos de referencia faciales (ojos, nariz y comisuras de la boca). Gestiona bien múltiples escalas. Es la opción preferida si la precisión importa más que la velocidad. Unos 15 FPS en GPU y más lento en CPU.
- SCRFD (redistribución de muestras y cómputo para una detección facial eficiente): El campeón de la velocidad. Diseñado para implementaciones móviles y en el borde. Alcanza una precisión comparable a RetinaFace con una velocidad entre 3 y 10 veces mayor. Existen varios tamaños de modelo, desde 0,5 millones hasta 34 millones de parámetros. Si vas a implementarlo en dispositivos móviles o necesitas procesamiento en tiempo real, esto es lo que buscas.
- BlazeFace: La aportación de Google, diseñada para [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Es extremadamente rápida (funciona a más de 200 FPS en GPU móviles), aunque sacrifica algo de precisión en ángulos difíciles. Es adecuada para aplicaciones de vídeo en tiempo real donde es necesario procesar cada fotograma.
Lo que realmente importa en la detección: Los casos difíciles no son los selfis con buena iluminación. Son las grabaciones de vigilancia, las fotos de grupo donde los rostros tienen 50 píxeles de ancho, los perfiles laterales extremos y los rostros parcialmente ocultos por gafas de sol o mascarillas. Tu modelo de detección determina el límite máximo de todo el sistema. Si la detección no encuentra un rostro, nada de lo que ocurra después podrá solucionarlo.
El problema de los múltiples rostros: Cuando una imagen contiene varios rostros, debes decidir cuáles convertir en incrustaciones. Entre las estrategias posibles están elegir el rostro más grande, el más centrado, el que tenga la puntuación de calidad más alta o convertirlos todos y dejar que la lógica posterior los clasifique. Cada opción presenta modos de fallo distintos. Generar incrustaciones de todos los rostros de las fotos de grupo infla el índice y produce resultados de búsqueda ambiguos; elegir solo el rostro más grande hace que se pierda a la persona situada en la última fila. La mayoría de los sistemas de producción generan incrustaciones de todos los rostros detectados que superan un umbral mínimo de tamaño —normalmente entre 40 y 60 píxeles entre los ojos— y los asocian como entradas independientes vinculadas a la misma imagen de origen.
La puntuación de calidad facial como filtro de acceso: Ejecutar un estimador ligero de calidad como SER-FIQ o la rama de calidad de MagFace antes de calcular incrustaciones costosas evita que datos basura lleguen a entrar en el índice. Los recortes borrosos, las oclusiones extremas y los rostros sobreexpuestos producen incrustaciones de baja confianza que contaminan los resultados de búsqueda. Rechazar los rostros que quedan por debajo de un umbral de calidad durante la fase de detección mejora radicalmente la precisión posterior y ahorra ciclos de GPU. Esta es una de las optimizaciones con mayor retorno de la inversión de todo el proceso.
Antisuplantación facial para la verificación: En situaciones de verificación, la detección de ataques de presentación (PAD) es fundamental. Las fotografías impresas en papel, las reproducciones en pantalla y las máscaras 3D pueden engañar a los sistemas basados en incrustaciones. Modelos como CDCN o PatchNet detectan estos ataques, pero añaden entre 5 y 15 ms de latencia por rostro y requieren mantenimiento adicional. Si estás desarrollando algo en lo que el usuario controla la imagen de entrada —control de acceso, KYC o autenticación—, debes incluir medidas antisuplantación o tu sistema será explotado.
Etapa 2: alineación facial
Una vez detectado un rostro, debes normalizarlo. Las distintas poses de la cabeza, los ángulos de cámara y las distancias cambian la apariencia del rostro en la imagen original. La alineación transforma cada rostro detectado para colocarlo en una posición estandarizada: ojos nivelados, rostro centrado y escala uniforme.
El método estándar utiliza los cinco puntos de referencia obtenidos durante la detección —ojo izquierdo, ojo derecho, punta de la nariz, comisura izquierda y comisura derecha— para calcular una transformación de similitud. Esto asigna el rostro detectado a un recorte canónico de 160 × 160 píxeles, con los ojos situados en coordenadas de píxel fijas.
Este paso suele pasarse por alto en los tutoriales, pero es fundamental. Un error de rotación de 2 grados en la alineación puede reducir la precisión del reconocimiento entre un 1 y un 3 %. La mayoría de los procesos de código abierto lo gestionan automáticamente, pero, si estás desarrollando uno personalizado, utiliza como estándar la especificación de alineación de FaceNet —160 × 160 y coordenadas específicas para los ojos—. Es la que se utilizó para entrenar la mayoría de los modelos modernos.
Sensibilidad de la alineación a la precisión de los puntos de referencia: Los puntos de referencia de RetinaFace presentan un error medio aproximado de 2 píxeles. Ese error se propaga por la transformación de alineación y puede causar una degradación de la precisión de entre el 1 y el 5 %, especialmente en recortes faciales pequeños, donde 2 píxeles representan una proporción mayor de la anchura total del rostro. Algunos sistemas de producción ejecutan, después de la detección inicial, un refinamiento secundario de 68 o 98 puntos de referencia —como face-alignment, de Adrian Bulat— para lograr una alineación más precisa. Los 3-5 ms adicionales por rostro merecen la pena cuando el caso de uso exige la máxima precisión, especialmente en verificaciones 1:1 donde una sola decisión incorrecta tiene consecuencias.
Etapa 3: extracción de características (incrustación)
Este es el núcleo del reconocimiento facial. Una red neuronal profunda recibe la imagen facial alineada y genera un vector de longitud fija —normalmente de 512 dimensiones— denominado incrustación o vector de características. Este vector es una representación numérica compacta de las características únicas del rostro.
Dos rostros de la misma persona, independientemente de la iluminación, la expresión, la edad —dentro de unos límites razonables— o la cámara, deberían producir incrustaciones cercanas entre sí en el espacio vectorial. Dos personas distintas deberían producir incrustaciones alejadas entre sí.
Cómo funciona técnicamente:
La arquitectura de la red suele ser una versión modificada de Inception-ResNet o ResNet, entrenada con millones de imágenes faciales. La innovación clave está en la función de pérdida utilizada durante el entrenamiento, no en la arquitectura propiamente dicha.
- Pérdida softmax (la referencia básica): Trata el reconocimiento facial como un problema de clasificación. Funciona, pero produce incrustaciones que no quedan bien separadas en el espacio angular. Está prácticamente obsoleta para el reconocimiento.
- Pérdida triplete: El método popularizado por FaceNet. La red aprende comparando tripletes de rostros ancla/positivo/negativo, acercando las incrustaciones de la misma identidad y alejando las de identidades distintas. Requiere seleccionar cuidadosamente tripletes difíciles durante el entrenamiento. Produce incrustaciones muy discriminativas.
- Pérdida ArcFace: Probablemente la función de pérdida más utilizada en los sistemas de reconocimiento facial de producción en 2026. Añade una penalización de margen angular aditivo en el espacio angular entre el vector de características y el peso de clase correspondiente, lo que produce agrupaciones intraclase más compactas y separaciones entre clases mayores que los métodos basados en margen coseno. El proyecto [InsightFace](https://github.com/deepinsight/insightface) proporciona la implementación de referencia, y la mayoría de los modelos más avanzados se entrenan con ArcFace o alguna de sus variantes —por ejemplo, el margen adaptativo de AdaFace se basa en la formulación de ArcFace—. Si vas a entrenar o ajustar tu propio modelo de reconocimiento facial, ArcFace es el punto de partida predeterminado.
- Pérdida CosFace: Añade un margen coseno a la pérdida softmax, obligando a la red a producir incrustaciones más agrupadas dentro de cada identidad y más separadas entre identidades.
- SphereFace / A-Softmax: El método original de margen angular de 2017. Es importante desde el punto de vista histórico, pero ArcFace y otras funciones de pérdida más modernas lo han sustituido en gran medida.
El resultado: Un vector de 512 números de coma flotante, normalizado mediante L2 sobre la hiperesfera unitaria. Toda la información sobre un rostro, comprimida en 2 KB de datos. Esto es lo que se almacena, indexa y compara.
La trampa de la normalización: Muchos desarrolladores olvidan que las incrustaciones deben normalizarse mediante L2 antes de compararlas. Las incrustaciones sin normalizar producen puntuaciones de similitud extremadamente inconsistentes. Es un error habitual y difícil de diagnosticar porque «funciona más o menos»: el orden relativo de las coincidencias puede parecer correcto durante las pruebas, pero las puntuaciones absolutas de similitud varían entre imágenes, lo que vuelve poco fiables las decisiones basadas en umbrales. FaceNet512 produce incrustaciones normalizadas de forma predeterminada, pero, si utilizas un modelo personalizado o exportas mediante ONNX, comprueba siempre que las incrustaciones de salida estén sobre la hiperesfera unitaria —es decir, que su norma L2 sea igual a 1,0—.
Implementación en producción: ONNX Runtime y cuantización: Las cifras de velocidad de las pruebas de rendimiento presuponen inferencia FP32 en una GPU sin otras cargas. En producción, la mayoría de los sistemas se implementan mediante ONNX Runtime con cuantización INT8, lo que reduce el tiempo de inferencia entre 2 y 3 veces con una pérdida mínima de precisión —normalmente inferior al 0,1 % en LFW—. El proceso es el siguiente: exportar el modelo de PyTorch o TensorFlow a ONNX, ejecutar la herramienta de cuantización de ONNX Runtime con un conjunto de calibración de unas 1.000 imágenes faciales e implementar el modelo cuantizado. Así se pasa de «10 ms por rostro» a «3-4 ms por rostro» en el mismo hardware, algo enormemente importante cuando se procesan miles de millones de imágenes.
Inferencia de precisión mixta: Utilizar FP16 en la GPU para la red troncal, pero FP32 para la capa final de incrustación, evita los problemas de precisión de coma flotante descritos más adelante en este artículo y, al mismo tiempo, ofrece una aceleración de entre 1,5 y 2 veces. Es un punto intermedio práctico entre FP32 completo —preciso pero lento— y FP16 completo —rápido, pero capaz de producir incrustaciones ligeramente distintas en hardware diferente—.
Destilación de incrustaciones para implementaciones en el borde: Puedes entrenar una red estudiante más pequeña —MobileFaceNet, con alrededor de 1 millón de parámetros— para imitar las incrustaciones de FaceNet512 mediante destilación de conocimiento. El modelo estudiante consigue más del 95 % de la precisión con una velocidad 10 veces mayor, lo que permite utilizarlo en dispositivos móviles y en el borde donde no es viable disponer de una GPU. La idea clave es que no necesitas entrenar al estudiante desde cero con etiquetas de identidad facial: lo entrenas para reproducir las incrustaciones del modelo profesor sobre datos faciales sin etiquetar, lo que requiere mucha menos capacidad de cómputo y ningún conjunto de datos con identidades etiquetadas.
Etapa 4: comparación
Dadas dos incrustaciones faciales, ¿cómo decides si pertenecen a la misma persona? Hay dos métodos:
Similitud coseno: Calcula el coseno del ángulo entre dos vectores de incrustación. El intervalo va de -1 a 1, donde 1 significa que son idénticos. Un umbral habitual para considerar que se trata de la «misma persona» es de 0,4 a 0,6, dependiendo del modelo y del caso de uso. Es sencillo, rápido y funciona bien porque las incrustaciones de FaceNet512 están normalizadas mediante L2.
Distancia euclídea: Calcula la distancia L2 entre vectores. Para incrustaciones normalizadas, es matemáticamente equivalente a la similitud coseno (d = sqrt(2 - 2*cos_sim)). Algunos sistemas prefieren esta formulación.
Para búsquedas (comparación 1:N): Cuando necesitas encontrar un rostro en una base de datos con millones de entradas, la comparación por fuerza bruta es demasiado lenta. Utiliza una búsqueda aproximada de vecinos más cercanos (ANN):
- FAISS (Facebook AI Similarity Search): La biblioteca estándar. Admite aceleración mediante GPU y varios tipos de índice (IVF, HNSW y PQ). Puede buscar entre 1.000 millones de vectores en milisegundos. Es gratuita y de código abierto.
- Milvus: Base de datos vectorial diseñada específicamente para este fin, con FAISS por debajo y capas adicionales de persistencia, escalabilidad y API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): Opciones de bases de datos vectoriales administradas si no quieres gestionar la infraestructura.
Para una base de datos de 10 millones de rostros, un índice HNSW de FAISS bien ajustado en una sola GPU puede devolver las 10 mejores coincidencias en menos de 5 milisegundos.
La elección del tipo de índice de FAISS importa enormemente. IVF-PQ proporciona una compresión excelente —entre 8 y 16 bytes por vector en lugar de 2 KB—, pero pierde precisión en coincidencias limítrofes donde el error de cuantización hace que una coincidencia real caiga por debajo del umbral. HNSW conserva la precisión, pero utiliza entre 4 y 8 veces más memoria porque almacena tanto los vectores completos de coma flotante como la estructura del grafo. Los índices híbridos IVF-HNSW ofrecen el mejor equilibrio para escalas de entre 10 millones y 1.000 millones de entradas. La mayoría de los equipos eligen inicialmente el tipo de índice equivocado basándose en recomendaciones de tutoriales y deben reconstruir toda su infraestructura de índices seis meses después, cuando se encuentran con sus limitaciones. Prueba tu carga de trabajo concreta con volúmenes de datos y patrones de consulta realistas antes de comprometerte con un tipo de índice.
El problema del arranque en frío de los índices ANN: Los índices HNSW e IVF necesitan una cantidad mínima de vectores para funcionar bien. Con menos de unos 10.000 vectores, la búsqueda por fuerza bruta es en realidad más rápida que la búsqueda indexada porque la sobrecarga del índice —recorrido del grafo y comparación de centroides— domina el cálculo. Empieza con fuerza bruta (FAISS IndexFlatIP) durante la fase inicial de crecimiento y migra a un índice ANN cuando tu base de datos supere los 50.000-100.000 vectores.
Filtrado previo con códigos binarios: Calcular un hash binario de cada incrustación —mediante binarización o SimHash— permite realizar un filtrado previo barato por distancia de Hamming antes de las costosas comparaciones de números de coma flotante. Esto puede reducir el conjunto de candidatos en más de un 90 % con una pérdida mínima de exhaustividad. La idea consiste en almacenar un código binario de 256 o 512 bits junto a cada incrustación completa. Para una consulta, primero se calcula la distancia de Hamming respecto a todos los códigos binarios —algo extremadamente rápido con las instrucciones POPCNT de la CPU—, se selecciona el 1-5 % de mejores candidatos y solo entonces se calcula la similitud coseno exacta para ellos. Este método de dos etapas resulta especialmente eficaz cuando el conjunto de datos supera la memoria de GPU disponible.
Reordenación mediante atributos faciales: La búsqueda inicial de incrustaciones devuelve candidatos; una segunda pasada basada en atributos estimados —intervalo de edad, género, tono de piel y vello facial— puede filtrar falsos positivos evidentes. Si se estima que el rostro de consulta pertenece a una mujer de 25 años y una coincidencia candidata a un hombre de 60 años, casi con total seguridad se trata de un falso positivo, independientemente de la puntuación de similitud de las incrustaciones. Esta sencilla heurística puede reducir los falsos positivos entre un 30 y un 50 % con un coste computacional mínimo y es una de las técnicas menos utilizadas en la búsqueda facial de producción.
Coherencia temporal en vídeo: Si comparas rostros de un vídeo en lugar de imágenes fijas, promediar las incrustaciones de varios fotogramas del mismo rostro rastreado mejora radicalmente la precisión —a menudo entre un 5 y un 10 % en pruebas difíciles—. La agregación de incrustaciones por trayectoria es estrictamente mejor que la comparación fotograma a fotograma. El método consiste en utilizar un rastreador facial —como SORT o DeepSORT— para vincular detecciones entre fotogramas, calcular las incrustaciones de cada detección y agregarlas en una única «incrustación de trayectoria» mediante un promedio ponderado por calidad, donde el peso es la puntuación de calidad facial obtenida en la etapa de detección.
Mejores modelos de reconocimiento facial de código abierto (2026)
FaceNet512
El estándar de referencia. FaceNet512 es la variante de incrustaciones de 512 dimensiones de la arquitectura FaceNet de Google y ofrece un espacio de incrustación mayor y más discriminativo que la versión original de 128 dimensiones.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Arquitectura: Red troncal Inception-ResNet-v2 que produce incrustaciones de 512 dimensiones
- Licencia: MIT (permisiva, permite el uso comercial)
- Precisión en LFW: 99,65 %
- Tamaño de la incrustación: 512 dimensiones
- Incluye: Funciona con procesos estándar de detección —MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface)— para el reconocimiento de extremo a extremo
- API de Python: Disponible mediante la biblioteca
deepfaceo implementaciones independientes
Veredicto: Si estás desarrollando un sistema de reconocimiento facial en 2026, FaceNet512 es un punto de partida sólido. Ofrece una precisión excelente, incrustaciones de 512 dimensiones con gran capacidad discriminativa, una licencia MIT permisiva y un amplio respaldo del ecosistema.
FaceNet (Google, original de 128 dimensiones)
El modelo que popularizó el uso de incrustaciones en 2015. Introdujo el entrenamiento con pérdida triplete, en el que la red aprende comparando tripletes faciales ancla/positivo/negativo.
- Artículo original: «FaceNet: una incrustación unificada para el reconocimiento y la agrupación de rostros» (Schroff et al., 2015)
- Repositorio: Existen varias implementaciones (davidsandberg/facenet es la versión clásica de TensorFlow)
- Licencia: MIT
- Precisión en LFW: 99,63 % (original), hasta un 99,75 % con entrenamiento moderno
- Tamaño de la incrustación: 128 dimensiones
- Arquitectura: Inception-ResNet-v1 o Inception-ResNet-v2
Veredicto: Es históricamente importante y sigue funcionando bien. La incrustación de 128 dimensiones es más compacta, pero ligeramente menos discriminativa que la variante FaceNet512 de 512 dimensiones. Utilízalo si necesitas reducir el tamaño de las incrustaciones o trabajas en TensorFlow con restricciones de memoria.
DeepFace (Facebook/Meta)
No debe confundirse con la biblioteca de Python deepface —en minúsculas—. DeepFace de Meta (2014) fue uno de los primeros métodos de aprendizaje profundo para reconocimiento facial y alcanzó una precisión casi humana en LFW.
El proyecto más relevante hoy es la biblioteca de Python deepface de Serengil:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Repositorio: github.com/serengil/deepface
- Licencia: MIT
- Qué hace: Biblioteca contenedora que proporciona una API unificada para varios modelos subyacentes: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib y SFace
- Incluye: Verificación, búsqueda y análisis de atributos faciales —edad, género, raza y emociones—
- Facilidad de uso: API extremadamente sencilla
Veredicto: La mejor opción para crear prototipos y experimentar. La API unificada permite cambiar de modelo modificando un solo parámetro. En producción, conviene utilizar FaceNet512 directamente para obtener un mayor rendimiento y control.
dlib
Biblioteca de C++ con enlaces para Python, mantenida por Davis King. Incluye un modelo de reconocimiento facial entrenado con un conjunto de datos de 3 millones de imágenes.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Repositorio: github.com/davisking/dlib
- Licencia: Boost Software License (permisiva)
- Precisión en LFW: 99,38 %
- Tamaño de la incrustación: 128 dimensiones
- Detección: Basada en HOG —rápida y apta para CPU— y basada en CNN —más precisa—
Veredicto: C++ extremadamente sólido y probado en producción, con buenos enlaces para Python. Su precisión es inferior a la de FaceNet512, pero resulta muy fiable. Es una buena opción si trabajas en C++ o necesitas una solución ligera sin dependencias de PyTorch/ONNX.
AdaFace
Un modelo más reciente (2022) que aborda específicamente las variaciones en la calidad de imagen. Los modelos estándar se entrenan con imágenes de alta calidad y su rendimiento empeora con entradas borrosas o de baja resolución. AdaFace adapta durante el entrenamiento la penalización de margen en función de la calidad de la imagen.
- Repositorio: github.com/mk-minchul/AdaFace
- Licencia: MIT
- Ventaja principal: Rendimiento superior con imágenes de baja calidad —vigilancia y cámaras de largo alcance—
- Precisión en LFW: 99,82 %
- TAR@FAR=1e-4 en IJB-C: 97,39 % (supera a la mayoría de los modelos de código abierto en pruebas difíciles)
Veredicto: Utilízalo cuando las imágenes de entrada sean de baja calidad. Para vigilancia, análisis de CCTV o cualquier situación en la que no puedas controlar la calidad de imagen, AdaFace ofrece resultados cuantificablemente mejores que los modelos estándar.
Tabla comparativa de rendimiento
| Modelo | LFW (%) | Incrustación | Velocidad (ms/rostro) | Licencia |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 dimensiones | ~10 ms (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 dimensiones | ~12 ms (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 dimensiones | ~9 ms (GPU) | MIT |
| dlib ResNet | 99,38 | 128 dimensiones | ~25 ms (CPU) | Boost |
| VGG-Face2 | 99,43 | 2.048 dimensiones | ~15 ms (GPU) | CC BY-SA |
LFW (Rostros etiquetados en entornos naturales) es la prueba de referencia estándar, pero está prácticamente resuelta. Todos los modelos modernos superan el 99 %. Las diferencias reales aparecen en pruebas más difíciles como IJB-C —condiciones variadas— y TinyFace —baja resolución—.
Una observación sobre las pruebas frente a la realidad: Estas cifras de velocidad corresponden a inferencia FP32 sobre un único rostro con una GPU ya preparada. En producción, con cuantización INT8 de ONNX Runtime, cabe esperar una velocidad entre 2 y 3 veces mayor. Pero también debes recordar que el proceso completo —detección + alineación + puntuación de calidad + incrustación— tarda entre 3 y 5 veces más que la extracción de incrustaciones por sí sola. Un rendimiento realista de extremo a extremo para el proceso completo en una sola GPU A100 es de 200-400 rostros por segundo, no los miles que podrían sugerir las pruebas exclusivas de incrustación.
La brecha entre los modelos de código abierto y los sistemas de producción
Esto es lo que no te cuentan los tutoriales: conseguir que un modelo de reconocimiento facial funcione en un cuaderno de Jupyter es la parte fácil. Desarrollar un sistema de producción que funcione realmente a escala exige resolver una larga lista de problemas de ingeniería que ningún modelo soluciona por ti. La mayoría de los equipos subestiman enormemente tanto el coste como los plazos. Lo que parece un proyecto de «simplemente conectar el modelo» se convierte en un esfuerzo de ingeniería de entre 12 y 24 meses que puede consumir fácilmente entre 500.000 y más de 2 millones de dólares antes de estar listo para producción, y eso sin contar los costes operativos continuos.
La factura de infraestructura
Cómputo mediante GPU para extraer incrustaciones. Ejecutar la detección facial y la extracción de incrustaciones sobre miles de millones de imágenes no es algo que se haga en un portátil. Una sola GPU NVIDIA A100 puede procesar aproximadamente entre 200 y 400 rostros por segundo mediante un proceso completo de detección + alineación + incrustación. Para procesar 1.000 millones de imágenes en un plazo razonable —por ejemplo, menos de una semana— necesitas un clúster de entre 40 y 80 GPU funcionando de forma continua. Con las tarifas de la nube, eso supone entre 50.000 y 150.000 dólares por cada pasada de procesamiento, y tendrás que repetirla a medida que mejore el modelo o cambie el proceso. Comprar el hardware supone entre 300.000 y 800.000 dólares en servidores con GPU, además de espacio en bastidores, electricidad, refrigeración y una persona que se encargue del mantenimiento.
Almacenamiento a escala. Mil millones de incrustaciones faciales de 512 números de coma flotante —2 KB cada una— equivalen aproximadamente a 2 TB solo de datos vectoriales. Si añades las imágenes originales, miniaturas, metadatos y estructuras de índice, hablamos de cientos de terabytes o unos pocos petabytes de almacenamiento. El almacenamiento NVMe de alto rendimiento para índices vectoriales cuesta en la nube entre 0,10 y 0,25 dólares por GB al mes. Con 50 TB de almacenamiento activo, son entre 5.000 y 12.500 dólares mensuales solo para mantener el sistema encendido.
Infraestructura de búsqueda vectorial. FAISS en una sola máquina alcanza su límite en torno a los 100-500 millones de vectores, dependiendo del tipo de índice y de la RAM disponible. Por encima de eso, necesitas una búsqueda distribuida entre varios fragmentos, con equilibrio de carga, replicación para tolerancia a fallos y suficiente RAM para alojar los índices. Una implementación distribuida de FAISS o Milvus apta para producción y con más de 1.000 millones de vectores suele requerir entre 8 y 16 máquinas con mucha memoria —más de 256 GB de RAM cada una—, lo que cuesta entre 15.000 y 40.000 dólares mensuales en cómputo en la nube.
Red y ancho de banda. Rastrear miles de millones de imágenes significa descargar petabytes de datos. A entre 0,05 y 0,09 dólares por GB de transferencia saliente en los principales proveedores de nube, la transferencia de datos por sí sola puede costar decenas de miles de dólares. También necesitas redes internas de alto rendimiento entre los rastreadores, los nodos de procesamiento con GPU y los sistemas de almacenamiento.
Estimación del coste total de infraestructura para un motor de búsqueda facial a escala web: Entre 30.000 y 80.000 dólares mensuales en costes continuos de nube, o entre 500.000 y 1,5 millones de dólares en hardware inicial, más entre 10.000 y 20.000 dólares mensuales en electricidad, ancho de banda y mantenimiento. Y esto es solo la infraestructura, antes de que un solo ingeniero escriba una línea de código de la aplicación.
El calendario de ingeniería
Desarrollar un sistema de búsqueda facial para producción no es un proyecto de hackatón. Este es un calendario realista para un equipo de entre 3 y 5 ingenieros experimentados:
Meses 1-3: proceso principal. Conseguir que la detección, la alineación y la extracción de incrustaciones funcionen de forma fiable. Crear el índice vectorial básico. Gestionar la ingestión de imágenes desde archivos locales. Esta es la parte «divertida», cuando todo parece ir bien y la demostración resulta impresionante.
Meses 3-6: infraestructura de rastreo web. Crear extractores para las principales plataformas. Gestionar límites de velocidad, CAPTCHA, barreras de inicio de sesión, renderizado dinámico —sitios con mucho JavaScript—, deduplicación de imágenes y filtrado de contenido. Descubrir que cada plataforma social tiene medidas distintas contra el rastreo que rompen tus rastreadores todas las semanas. Crear sistemas de supervisión para detectar cuándo fallan silenciosamente. Esta fase por sí sola puede tardar más de lo esperado porque la web es caótica y hostil.
Meses 6-9: escala y fiabilidad. Tu prototipo funcionaba con 1 millón de rostros. Ahora haz que funcione con 100 millones. Descubre que tu índice de FAISS ya no cabe en la RAM. Implementa la fragmentación. Corrige las condiciones de carrera del proceso de ingestión. Crea lógica de reintento para el 15 % de las imágenes que no se descargan. Gestiona imágenes dañadas, imágenes que dicen ser JPEG pero no lo son, imágenes con indicadores de rotación EXIF y descargas truncadas. Añade supervisión, alertas y registros para saber cuándo algo falla a las 3 de la madrugada.
Meses 9-12: calidad y precisión. Descubre que la tasa de falsos positivos a escala es inaceptable. Implementa puntuaciones de calidad facial para filtrar incrustaciones basura. Ajusta los umbrales para cada caso de uso. Crea un mecanismo de comentarios para señalar e investigar coincidencias incorrectas. Descubre que el modelo produce resultados distintos en diferentes arquitecturas de GPU por diferencias de precisión de coma flotante y dedica dos semanas a localizar el problema.
Meses 12-18: endurecimiento para producción. Crea una capa de API con autenticación, limitación de solicitudes y seguimiento del uso. Añade funciones de cumplimiento del RGPD/CCPA: mecanismos de exclusión, solicitudes de eliminación de datos y registros de auditoría. Implementa almacenamiento en caché de resultados. Crea herramientas administrativas. Redacta documentación. Supera la auditoría de seguridad. Realiza pruebas de carga de todo el sistema. Corrige las fugas de memoria cuya existencia desconocías.
Meses 18-24: operaciones continuas. Los rastreadores dejan de funcionar cuando los sitios web cambian su diseño. Los modelos derivan a medida que aparecen nuevos tipos de imágenes. Los discos se llenan. Hay que reconstruir los índices. Los usuarios informan de casos extremos que nunca habías previsto. Alguien descubre que el sistema devuelve coincidencias de alta confianza para rostros de dibujos animados y debes añadir un filtro de «rostro real». Esto nunca termina.
La lista completa de problemas que encontrarás
Además de la infraestructura y los plazos, estos son todos los problemas importantes que encuentran los equipos al desarrollar sistemas de reconocimiento facial desde cero. Esta lista procede de sistemas de producción reales, no de inquietudes teóricas.
Pesadillas relacionadas con la calidad de los datos:
- Si entra basura, sale basura. Internet está lleno de memes, rostros generados por IA, dibujos, fotos de fotos, portadas de revistas y estatuas. Tu detector encontrará «rostros» en todos ellos y producirá incrustaciones que contaminarán el índice. Necesitas clasificadores para filtrar rostros sintéticos, rostros ilustrados, recortes de resolución extremadamente baja y contenido no fotográfico. Crear y mantener estos filtros es un proyecto en sí mismo.
- Imágenes duplicadas y casi duplicadas. La misma foto aparece en decenas de sitios con recortes, marcas de agua, niveles de compresión y ajustes de color distintos. Sin deduplicación, una foto viral genera cientos de «coincidencias» que en realidad son la misma imagen y ocultan los resultados reales. El hash perceptual —pHash, dHash— ayuda, pero no es perfecto. Necesitas deduplicar en varios niveles: por URL —trivial—, por hash perceptual —detecta copias redimensionadas y recomprimidas— y por incrustación —detecta el mismo rostro fotografiado desde ángulos ligeramente distintos—. Cada nivel detecta elementos que los demás pasan por alto, y dedicarás más tiempo del previsto a la deduplicación.
- Cambios de edad y apariencia. Es posible que la incrustación facial obtenida de la foto universitaria de una persona no coincida con una foto tomada 15 años después. Los cambios de peso, el envejecimiento, la cirugía estética, el vello facial y los peinados distintos afectan a la precisión. Ningún modelo gestiona esto a la perfección. Los usuarios culparán a tu sistema cuando no reconozca a alguien con 20 años de diferencia.
- Sesgo demográfico. Los modelos de código abierto entrenados principalmente con conjuntos de datos occidentales o caucásicos funcionan peor con otros grupos demográficos. Las diferencias de precisión entre grupos étnicos son mayores de lo que sugiere LFW, que contiene aproximadamente un 77 % de personas caucásicas. En implementaciones globales, las diferencias de precisión entre grupos demográficos pueden situarse entre el 5 y el 15 % en pruebas difíciles. Modelos como FaceNet512, entrenados con MS-Celeb-1M, heredan su sesgo demográfico. El ajuste con conjuntos de datos equilibrados —como BUPT-Balancedface— o el uso de estrategias de entrenamiento conscientes de la demografía es importante para obtener un rendimiento equitativo. Si no evalúas la precisión entre grupos raciales, puedes lanzar un sistema que funcione bien para algunos usuarios y mal para otros. No es solo una cuestión ética, sino también un problema de calidad del producto y responsabilidad legal.
- Gestión de la orientación EXIF. Aproximadamente entre el 15 y el 20 % de las imágenes de la web tienen etiquetas de orientación EXIF que, si se ignoran, dejan los rostros de lado o boca abajo. La mayoría de los detectores faciales no encuentran rostros rotados. Es un destructor silencioso de la precisión que resulta fácil pasar por alto durante las pruebas —donde se utilizan imágenes correctamente orientadas—, pero devastador en producción. Aplica siempre la corrección de orientación EXIF como primer paso del proceso de imágenes.
- Fallos al decodificar JPEG progresivo y WebP. Algunas bibliotecas de imágenes producen silenciosamente datos de píxeles dañados a partir de archivos JPEG progresivos parcialmente descargados o archivos WebP truncados. El detector facial puede seguir encontrando un «rostro» entre los artefactos y producir una incrustación basura. Antes de procesar, necesitas validar la integridad de la imagen: comprobar que el archivo se decodifica sin errores y que el búfer de píxeles resultante tiene dimensiones razonables. Sin esto, las imágenes dañadas contaminan silenciosamente el índice.
Problemas de ingeniería que no resultan evidentes al principio:
- Versionado de incrustaciones. Cuando actualices el modelo —y lo harás, porque las mejoras de precisión importan—, todas las incrustaciones de tu base de datos se volverán incompatibles con la salida del nuevo modelo. Puedes volver a generar las incrustaciones de toda la base de datos —caro, lento y exige conservar todas las imágenes originales—, ejecutar índices paralelos durante la migración —duplica el coste de infraestructura— o mantener la compatibilidad retroactiva —complejo y limita la capacidad de mejora—. No existe una solución buena, solo soluciones menos dolorosas.
- Determinismo de coma flotante. La misma imagen procesada en distintos modelos de GPU, distintas versiones de CUDA o incluso con tamaños de lote diferentes puede producir incrustaciones ligeramente distintas debido a la aritmética de coma flotante. Las diferencias son pequeñas —de 1e-6 a 1e-4—, pero se acumulan: una coincidencia con una puntuación de 0,401 en una máquina puede obtener 0,399 en otra, invirtiendo una decisión binaria basada en un umbral. Esto te volverá loco durante la depuración. Las actualizaciones de controladores de GPU son especialmente peligrosas: las actualizaciones de NVIDIA pueden cambiar el comportamiento de coma flotante en el nivel de CUDA. Una incrustación calculada con el controlador 535.x puede diferir de la misma imagen procesada con 545.x. En producción, esto significa que debes fijar las versiones de los controladores en toda la flota y validar la coherencia de las incrustaciones después de cualquier actualización.
- Concurrencia y condiciones de carrera. Varios rastreadores incorporan rostros simultáneamente, los usuarios consultan mientras se actualiza el índice y llegan solicitudes de eliminación mientras se elaboran los resultados. Las bases de datos vectoriales no tienen un soporte transaccional tan maduro como las bases SQL. Encontrarás situaciones donde un rostro está indexado parcialmente, las consultas devuelven resultados obsoletos o la eliminación no se propaga a todos los fragmentos.
- Gestión de memoria. Los índices de FAISS están asignados en memoria, pero el rendimiento de las consultas depende enormemente de qué proporción del índice cabe en la RAM. A medida que crece el índice, la latencia aumenta de forma imprevisible cuando el sistema operativo expulsa páginas del índice de la memoria. Los cierres por falta de memoria ocurren en el peor momento posible. Acabarás conociendo íntimamente la gestión de memoria de Linux, la configuración de intercambio y la topología [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). El calentamiento tras un arranque en frío es otro problema: los índices HNSW de FAISS están asignados en memoria, por lo que, después de reiniciar un servidor, las primeras centenas de consultas son entre 10 y 100 veces más lentas porque las páginas del índice aún no se han cargado en la RAM. Necesitas una fase de calentamiento que precargue el índice antes de aceptar tráfico de producción o los primeros usuarios tras una implementación sufrirán una latencia terrible.
- Fallos silenciosos. Un rastreador deja de funcionar porque un sitio web ha cambiado su HTML. Un nodo de procesamiento con GPU empieza a generar incrustaciones NaN por una actualización del controlador. Un disco se llena y los rostros nuevos dejan de indexarse silenciosamente. Estos fallos no producen errores; simplemente degradan el sistema en silencio. Sin supervisión exhaustiva y detección de anomalías, no te enterarás hasta que los usuarios se quejen.
- El problema de actualización de FAISS. Cuando añades nuevas incrustaciones a un índice IVF, las celdas de Voronoi se desequilibran. La calidad de búsqueda se degrada gradualmente hasta que vuelves a entrenar el cuantizador. A escala web, volver a entrenarlo supone horas de GPU sobre todo el conjunto de datos. Los equipos suelen agrupar las incorporaciones y repetir el entrenamiento semanal o mensualmente, por lo que los rostros recién incorporados no pueden buscarse inmediatamente con la máxima precisión. Siempre tendrás que equilibrar la actualidad y la calidad de búsqueda; no hay una solución gratuita.
- Calibración de puntuaciones entre fragmentos del índice. Cuando el índice se divide entre varias máquinas, las puntuaciones de similitud sin procesar de los distintos fragmentos no son directamente comparables porque cada fragmento tiene una distribución de incrustaciones diferente. Necesitas normalizar las puntuaciones por fragmento —normalización por cohortes, Z-norm o T-norm— para combinar los resultados de forma significativa. Sin calibración, una puntuación de 0,45 en el fragmento A podría representar una coincidencia sólida, mientras que 0,45 en el fragmento B sería mediocre. Los resultados combinados dejan de ser fiables.
- El problema de la distribución en abanico en las búsquedas distribuidas. Buscar en N fragmentos implica N viajes de ida y vuelta por la red para cada consulta. Si algún fragmento va lento —pausa del recolector de basura, pico de E/S del disco o problema de red—, toda la consulta se ralentiza. La latencia P99 queda determinada por el P99 del fragmento más lento y empeora a medida que se añaden fragmentos. Técnicas como las solicitudes especulativas —enviar solicitudes duplicadas y aceptar la primera respuesta— y los tiempos de espera adaptativos son esenciales para mantener una latencia de cola aceptable.
Problemas de precisión y comparación:
- El ajuste de umbrales nunca «termina». El umbral óptimo de similitud cambia a medida que crece la base de datos. Con 1 millón de rostros, un umbral de 0,45 ofrece un buen equilibrio entre precisión y exhaustividad. Con 100 millones, ese mismo umbral produce diez veces más falsos positivos simplemente porque hay más personas parecidas que casi coinciden. Necesitas umbrales adaptativos o una reordenación posterior. Las matemáticas subyacentes son implacables: cuando la base crece de 1 millón a 100 millones y luego a 1.000 millones de rostros, la distribución de las puntuaciones de similitud top-k se desplaza hacia arriba porque existen más parecidos cercanos. Un umbral fijo con una tasa de falsos positivos del 0,1 % para 1 millón de rostros podría producir un 10 % con 1.000 millones. Debes modelar esta distribución y ajustar dinámicamente los umbrales o aceptar que la precisión se degrade con la escala.
- Reconocimiento de conjunto abierto frente a conjunto cerrado. La mayoría de las pruebas evalúan el rendimiento en conjuntos cerrados, donde se garantiza que la persona consultada está en la base de datos. La búsqueda facial real utiliza conjuntos abiertos: el rostro consultado podría no existir en el índice. La evaluación de conjuntos abiertos exige métricas completamente distintas —TPIR con un FPIR fijo en lugar de precisión de rango 1— y el modo de fallo son las coincidencias falsas, no las clasificaciones incorrectas. Un sistema que obtiene un 99 % en pruebas de conjunto cerrado puede tener una tasa de coincidencias falsas del 10 % en una implementación abierta porque devuelve con seguridad el rostro «más cercano» aunque la coincidencia real no exista. Gestionar correctamente «no se encontró ninguna coincidencia» es tan importante como encontrar coincidencias correctas.
- Parecidos y dobles. En una base de datos de más de 100 millones de rostros, hay muchas parejas de personas sin relación cuyas incrustaciones son sorprendentemente cercanas. Cuanto mayor sea la base, más coincidencias falsas aparecerán. Los usuarios informarán con frecuencia de resultados de «persona equivocada». Necesitas una estrategia: verificación con varias fotos, señales contextuales —nombre y ubicación— y colas de revisión humana.
- El reconocimiento invariable a la pose sigue siendo difícil. Incluso FaceNet512 empeora significativamente por encima o por debajo de 60 grados de giro horizontal. La precisión al comparar un perfil con una vista frontal puede caer entre un 10 y un 20 % respecto a la comparación entre dos vistas frontales. En situaciones de vigilancia, la mayoría de los rostros aparecen inclinados, por lo que la precisión real es considerablemente inferior a la sugerida por las pruebas. Los modelos entrenados con aumentación consciente de 3D o arquitecturas como UV-GAN ayudan, pero añaden complejidad. Si tus datos contienen muchos rostros inclinados, considéralo un problema de precisión de primer orden, no un caso extremo.
- Entradas adversarias. Los usuarios enviarán rostros generados por IA, ultrafalsificaciones, imágenes fusionadas y fotos con perturbaciones deliberadas. Algunos pondrán a prueba el sistema; otros intentarán manipular los resultados. El sistema necesita cierta resistencia frente a estas entradas o devolverá coincidencias de alta confianza para rostros falsos.
- Manipulación fotográfica. Filtros, aplicaciones de belleza, maquillaje intenso y programas de retoque facial. La realidad de Instagram frente a la realidad auténtica. Estas modificaciones alteran la geometría facial lo suficiente para afectar a la similitud de las incrustaciones. Un selfi con muchos filtros podría no coincidir con una foto sin filtros de la misma persona.
- Un rostro, muchas incrustaciones. Una sola persona puede tener cientos de fotos en línea en distintas plataformas, ángulos y años. ¿Devuelves todas como coincidencias independientes o las agrupas en una única identidad? La agrupación a escala —cientos de millones de rostros— es computacionalmente cara e introduce sus propios modos de fallo: fusión excesiva —combinar dos personas diferentes— y fusión insuficiente —no conectar fotos de la misma persona—.
Problemas operativos:
- Carrera armamentística contra el rastreo. Todas las grandes plataformas sociales bloquean activamente los rastreadores. Cambian las estructuras de las páginas, añaden CAPTCHA, detectan navegadores sin interfaz, limitan solicitudes por IP, generan huellas de patrones de solicitudes y, a veces, sirven contenido señuelo. Tu infraestructura de rastreo participa en una carrera armamentística constante. Un extractor que funciona hoy podría quedar completamente bloqueado la próxima semana. Mantener rastreadores es un coste de ingeniería continuo, no un desarrollo puntual.
- Modelado de la tasa de cambio. Las distintas fuentes se actualizan a ritmos diferentes. Los sitios de noticias sobre famosos reciben fotos nuevas cada hora; los perfiles personales de redes sociales pueden no cambiar durante años. Una programación inteligente del nuevo rastreo basada en las tasas históricas de cambio puede reducir los costes de ancho de banda entre un 60 y un 80 % y mantener más actualizado el índice donde importa. Sin ella, rastrearás en exceso fuentes estáticas —desperdiciando ancho de banda y dinero— o demasiado poco las fuentes dinámicas —sirviendo resultados obsoletos—.
- CDN y variación geográfica del contenido. Una misma URL puede servir imágenes distintas según la ubicación del solicitante, el agente de usuario del dispositivo o las cookies. El rastreador podría indexar una imagen distinta de la que ve el usuario, lo que genera informes confusos de «la coincidencia no se parece al resultado». Algunas CDN sirven marcadores de posición de baja resolución hasta que un navegador real desplaza la imagen dentro del área visible. Debes gestionar estos casos extremos o aceptar cierto porcentaje de resultados fantasma.
- Crecimiento de los costes de almacenamiento. El almacenamiento de imágenes crece de forma lineal y nunca se detiene. No puedes eliminar los originales si existe la posibilidad de tener que volver a generar las incrustaciones. Miniaturas, metadatos, vectores de incrustación, archivos de índice y copias de seguridad. La factura de almacenamiento se acelera a medida que madura el sistema. Los equipos que presupuestaron el almacenamiento del primer año quedan sorprendidos por los costes del tercero.
- Solicitudes de cumplimiento a escala. El RGPD concede a las personas el derecho a solicitar la eliminación de sus datos. Cuando alguien presenta una solicitud de exclusión, debes encontrar todas las incrustaciones generadas a partir de su rostro en toda la base de datos, eliminarlas, asegurarte de que no vuelvan a añadirse cuando los rastreadores encuentren las imágenes originales y documentar la eliminación para fines de auditoría. A escala, esto requiere herramientas específicas y trabajo de ingeniería. La [Ley de IA de la UE](https://artificialintelligenceact.eu/) añade requisitos adicionales para sistemas de IA de alto riesgo, incluido el reconocimiento facial: evaluaciones obligatorias de conformidad, pruebas de sesgo, obligaciones de transparencia y mecanismos de supervisión humana.
- Implementar la exclusión es más difícil de lo que parece. No basta con eliminar una incrustación; debes evitar que vuelva a indexarse cuando el rastreador encuentre de nuevo el mismo rostro. Esto exige mantener un índice de «lista de bloqueo» con las incrustaciones de los rostros excluidos y comparar cada nueva incrustación antes de indexarla. Esta lista debe ser rápida —se consulta en cada inserción— y plantea sus propias preguntas sobre conservación de datos: debes almacenar permanentemente la incrustación facial de la persona excluida para poder compararla, lo que significa conservar datos biométricos para cumplir una solicitud de eliminación. Esta tensión jurídica es real y sigue sin resolverse en muchas jurisdicciones.
- El problema del consentimiento en datos rastreados públicamente. La base jurídica del RGPD para procesar datos biométricos de perfiles públicos de redes sociales es objeto de disputas legales. Varias autoridades de protección de datos de la UE se han pronunciado contra empresas de reconocimiento facial —en particular, las decisiones sobre Clearview AI en varios Estados miembros—. Tu riesgo legal depende de la jurisdicción, la fuente de los datos y el caso de uso. No es una preocupación futura e hipotética, sino un ámbito sometido actualmente a medidas coercitivas.
- Costes de almacenamiento del registro de auditoría. Si registras cada consulta y cada coincidencia devuelta —algo que podría exigir la normativa—, los registros de auditoría pueden crecer más rápido que los propios datos faciales. Un sistema que gestione 1 millón de búsquedas diarias con 10 resultados cada una genera aproximadamente 10 millones de registros de auditoría al día. Los requisitos de conservación —a menudo entre 1 y 7 años según la jurisdicción— hacen que estos datos se acumulen sin descanso. Planifica el almacenamiento de auditoría como un centro de costes principal, no como una consideración secundaria.
- Respuesta ante incidentes. ¿Qué ocurre cuando el sistema identifica incorrectamente un rostro y alguien actúa basándose en esa coincidencia falsa? Necesitas registros de auditoría que muestren cómo se generó cada resultado, capacidad para explicar las decisiones y un proceso para gestionar disputas. Cuando alguien cuestiona una coincidencia, decir «la similitud coseno fue de 0,47 y superó nuestro umbral de 0,42» no es una explicación satisfactoria. Técnicas como GradCAM pueden mostrar qué regiones faciales determinaron la coincidencia, lo que ayuda a resolver disputas y genera confianza. No es solo una buena práctica de ingeniería; puede ser un requisito legal según la jurisdicción.
- Deterioro de modelos y dependencias. Las versiones de CUDA, Python y [ONNX Runtime](https://onnxruntime.ai/), así como las actualizaciones del sistema operativo, cambian con el tiempo y pueden romper sutilmente el proceso de inferencia. Fijar versiones ayuda hasta que necesitas un parche de seguridad. Dedicarás una cantidad sorprendente de tiempo a gestionar dependencias y reproducir entornos.
- Concentración del conocimiento en el equipo. El ingeniero que creó la capa de indexación de FAISS entiende la lógica de fragmentación. El ingeniero que ajustó los rastreadores sabe qué sitios requieren un tratamiento especial. Cuando estas personas se marchan —y en un proyecto de entre 18 y 24 meses hay rotación—, el conocimiento crítico desaparece con ellas. La documentación ayuda, pero nunca captura por completo el «porqué» de las decisiones menos evidentes.
Resumen del coste real
Para un sistema de búsqueda facial a escala web que busque en la Internet pública:
- Equipo de ingeniería: Entre 3 y 5 ingenieros sénior durante 12-24 meses = entre 600.000 y 2,5 millones de dólares en salarios y gastos generales
- Infraestructura (primer año): Entre 400.000 y 1 millón de dólares en costes de nube o hardware
- Infraestructura (continua): Entre 30.000 y 80.000 dólares mensuales —entre 360.000 y 960.000 dólares anuales—
- Asesoramiento jurídico y cumplimiento: Entre 50.000 y 200.000 dólares para la evaluación inicial, más asesoramiento continuo
- Total del primer año: Entre 1,4 y 3,7 millones de dólares
- Total a partir del segundo año: Entre 500.000 y 1,2 millones de dólares anuales en infraestructura y mantenimiento de ingeniería
Y eso corresponde a un sistema que funciona. Muchos equipos gastan entre 6 y 12 meses y más de 500.000 dólares antes de darse cuenta de que el problema es más difícil de lo calculado y optar por una solución mediante API.
Cuándo desarrollar y cuándo utilizar una API
Desarrolla tu propio sistema cuando:
- Tengas un conjunto de datos cerrado —credenciales de empleados o fotos de clientes— con menos de 100.000 rostros
- Necesites que el sistema se ejecute en tus instalaciones o aislado de la red
- Tengas ingenieros de aprendizaje automático capaces de gestionar la optimización de modelos, el ajuste de umbrales y los casos extremos
- Tu caso de uso sea la verificación (1: 1), no la búsqueda (1:N en la web)
- Dispongas del presupuesto y el tiempo necesarios para comprometerte con un proyecto de ingeniería de varios años
Utiliza una API cuando:
- Necesites buscar rostros en la Internet pública —redes sociales, noticias y web—
- No quieras crear y mantener un proceso de rastreo e indexación web
- Necesites resultados ahora, no después de 12-24 meses de ingeniería
- Necesites mantener el sistema actualizado con el contenido nuevo publicado en línea
- Quieras que otro se encargue del cumplimiento del RGPD, las solicitudes de exclusión y la Ley de IA de la UE
- Quieras evitar más de 1 millón de dólares en costes iniciales de infraestructura e ingeniería
- La búsqueda facial no sea el núcleo de tu producto y convenga dedicar el tiempo de ingeniería al producto real
API de búsqueda facial de FaceCheck.id
Para desarrolladores que necesiten buscar rostros en la web pública sin crear toda la infraestructura desde cero, FaceCheck.id ofrece una API REST que gestiona todo el proceso: detección, incrustación y búsqueda en un índice actualizado continuamente de imágenes faciales disponibles públicamente en redes sociales, sitios de noticias y la web en general.
FaceCheck.id utiliza un modelo propio de reconocimiento facial optimizado para búsquedas a escala web. A diferencia de los modelos de código abierto que tendrías que implementar y ajustar por tu cuenta, su modelo propio está específicamente entrenado y perfeccionado para los retos de la búsqueda facial en Internet: gestionar calidades de imagen extremadamente variables, diversas condiciones de iluminación, diversidad demográfica y la enorme escala de su índice rastreado continuamente. Este enfoque propio les permite mejorar el rendimiento del modelo de forma independiente y optimizarlo para su proceso específico de búsqueda de maneras que los modelos genéricos de código abierto no pueden. Se han invertido años de ingeniería, pruebas y perfeccionamiento para lograr que el sistema funcione a un nivel que sería extremadamente difícil y caro reproducir desde cero.
Qué hace la API:
Envías una imagen facial y la API devuelve los rostros coincidentes encontrados en Internet, junto con puntuaciones de confianza y URL de origen. La comparación, la indexación y la infraestructura a escala web se gestionan en sus sistemas. Todos los clústeres de GPU, procesos de rastreo, infraestructura de búsqueda vectorial, herramientas de cumplimiento y mantenimiento continuo descritos anteriormente son problema suyo, no tuyo.
Aspectos básicos de la API:
- API JSON RESTful
- Autenticación mediante clave de API
- Envío de una imagen codificada en base64 o de una URL de imagen
- Devuelve: matriz de coincidencias con puntuaciones de similitud, URL de origen y vistas previas en miniatura
- Los límites de solicitudes y los precios escalan según el uso
Integración típica:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Casos de uso de la API:
- Verificación en aplicaciones de citas: Permite a los usuarios comprobar que las fotos de una posible pareja aparecen en perfiles reales de redes sociales
- Protección de marca: Comprueba si alguien utiliza fotos de tu equipo en perfiles empresariales falsos
- Plataformas de diligencia debida: Añade búsqueda facial a procesos de verificación de antecedentes o KYC
- Sistemas antifraude: Señala cuentas que utilizan fotos que aparecen en otros lugares de Internet con nombres diferentes
- Herramientas OSINT: Crea herramientas de investigación que incluyan comparación facial a escala web
Por qué utilizar esto en lugar de crear tu propio sistema:
Desarrollar un motor de búsqueda facial que explore la web pública exige: (1) un proceso de rastreo a escala web que descubra y descargue miles de millones de imágenes, (2) infraestructura de GPU que cuesta cientos de miles de dólares para ejecutar la detección facial y la extracción de incrustaciones, (3) un sistema distribuido de búsqueda vectorial con terabytes de RAM para consultar todo el índice en tiempo real, (4) rastreo continuo para mantener actualizado el índice, (5) infraestructura de cumplimiento para exclusiones, solicitudes de eliminación y requisitos normativos, (6) un equipo de entre 3 y 5 ingenieros dedicado a tiempo completo al mantenimiento y (7) entre 12 y 24 meses hasta publicar la primera versión utilizable. Es un proyecto de ingeniería de varios millones de dólares con costes continuos significativos. La API, impulsada por el modelo propio de FaceCheck.id y una infraestructura ampliamente probada, te ofrece todo eso mediante una única llamada HTTP.
Los modelos de código abierto descritos anteriormente son excelentes para crear sistemas cerrados de reconocimiento facial —control de acceso de empleados, organización de bibliotecas fotográficas y procesos personalizados de verificación—. Pero, si tu caso de uso es «buscar en Internet dónde aparece este rostro», la diferencia de ingeniería entre un modelo funcional y un producto funcional es enorme. La API de FaceCheck.id cubre esa brecha y te permite lanzar un producto funcional en días, no en años.
Primeros pasos: Visita facecheck.id/en/Face-Search/API para consultar la documentación, los precios y el registro de claves de API.
Preguntas frecuentes
¿Cuál es el modelo de reconocimiento facial de código abierto más preciso?
FaceNet512, con una red troncal Inception-ResNet-v2, obtiene actualmente resultados excelentes en la mayoría de las pruebas, con un 99,65 % en LFW. Para situaciones con imágenes de baja calidad —vigilancia y CCTV—, AdaFace ofrece un rendimiento superior en pruebas difíciles como IJB-C, con un TAR@FAR=1e-4 del 97,39 %.
¿Puedo utilizar comercialmente modelos de reconocimiento facial de código abierto?
Sí. FaceNet512, FaceNet, DeepFace, dlib y AdaFace se publican con licencias permisivas —MIT o Boost—. Puedes utilizarlos en productos comerciales. Sin embargo, debes conocer las restricciones legales sobre el tratamiento de datos biométricos en tu jurisdicción —RGPD, BIPA y Ley de IA de la UE—, que se aplican independientemente de la licencia del software.
¿Cuántos datos necesito para entrenar mi propio modelo de reconocimiento facial?
No necesitas entrenarlo desde cero. Los modelos preentrenados mencionados anteriormente se entrenaron con conjuntos de entre 5 y 12 millones de imágenes correspondientes a entre 100.000 y 500.000 identidades. Utiliza estos modelos preentrenados y ajústalos solo si tienes una necesidad específica de un dominio. El ajuste suele requerir entre 10.000 y 100.000 imágenes. Entrenar desde cero exige millones de imágenes y considerables recursos de GPU.
¿Cuál es la diferencia entre la verificación facial y la búsqueda facial?
La verificación facial (1:1) responde a «¿pertenecen estas dos fotos a la misma persona?» comparando directamente dos incrustaciones. La búsqueda facial (1:N) responde a «¿dónde aparece esta persona?» comparando una incrustación con una base de datos de millones. La verificación es computacionalmente sencilla. La búsqueda requiere índices eficientes de vecinos más cercanos —FAISS, Milvus— y, para búsquedas a escala web, una enorme infraestructura de rastreo e indexación cuyo desarrollo y funcionamiento pueden costar millones.
¿Qué precisión tiene el reconocimiento facial con imágenes de baja calidad?
La precisión disminuye significativamente con la calidad de imagen. En fotos claras y frontales, los modelos modernos superan el 99 % de precisión. En grabaciones borrosas de vigilancia o fotos donde el rostro mide menos de 50 píxeles de ancho, la precisión puede caer al 80-90 % o menos. AdaFace está diseñado específicamente para gestionar mejor que los modelos estándar las variaciones de calidad. En cualquier sistema, las imágenes de entrada con mayor resolución producen resultados radicalmente mejores. La pose también importa: la precisión con rostros de perfil —vista lateral— puede caer entre un 10 y un 20 % frente a los rostros frontales, incluso con imágenes de alta resolución.
¿Cuánto cuesta desarrollar un motor de búsqueda facial?
Para un sistema a escala web que busque en la Internet pública, cabe esperar unos costes de entre 1,4 y 3,7 millones de dólares durante el primer año —equipo de ingeniería + infraestructura + asesoramiento jurídico— y entre 500.000 y 1,2 millones de dólares anuales de costes continuos después. Para un sistema cerrado que busque en una base de datos privada con menos de 100.000 rostros, los costes son radicalmente inferiores: basta con un único servidor con GPU y un ingeniero. El coste aumenta según el tamaño de la base de búsqueda y la necesidad de rastrear la web para llenarla.
¿Cuánto tiempo se tarda en desarrollar un sistema de reconocimiento facial para producción?
Para un sistema sencillo de verificación —comparación 1:1 con una base de datos conocida—, un ingeniero experimentado puede crear un prototipo funcional en 1-2 semanas y dejarlo listo para producción en 1-3 meses. Para un sistema de búsqueda facial a escala web —1:N en Internet—, calcula entre 12 y 24 meses con un equipo de entre 3 y 5 ingenieros antes de disponer de algo suficientemente fiable para producción. Los retos de rastreo, escalabilidad y cumplimiento añaden una enorme cantidad de tiempo al trabajo central de aprendizaje automático.
Crea algo que importe. Empieza con FaceNet512 para tu sistema cerrado. Pero, si necesitas búsqueda facial a escala web, pregúntate: ¿realmente quieres gastar entre 1,4 y 3,7 millones de dólares, contratar un equipo de ingenieros sénior y esperar entre 12 y 24 meses para obtener tu primer resultado utilizable? En su lugar, puedes evitar por completo los clústeres de GPU, las pesadillas del rastreo, los problemas de cumplimiento y los años de ingeniería, y obtener tus primeros resultados de búsqueda en menos de 5 minutos, desde tan solo 1 dólar estadounidense, con la API de FaceCheck.id.
Lea más sobre la búsqueda por imagen
Buscador de OnlyFans: cómo buscar por rostro para encontrar perfiles
¿Buscas a un creador específico de OnlyFans, pero solo tienes una foto? FaceCheck.id te permite buscar perfiles de OnlyFans por rostro y encontrar coincidencias en millones de páginas en cuestión de segundos. Te explicamos cómo funciona y por qué es la opción más fiable en 2026.
Sobre el tema en otros idiomas
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Temas populares
Deepfake Identidad Redes Sociales Reconocimiento Facial Facebook Instagram Búsqueda Facial BiométricoDuelo de motores de búsqueda de rostros: PimEyes vs FaceCheck - Análisis detallado