Системы распознавания лиц: как они работают, лучшие модели с открытым исходным кодом и промышленные API
Если вы разрабатываете что-либо, где требуется сопоставлять лица, подтверждать личность по фотографии или искать лицо в наборе данных, вам необходимо понимать, как современные системы распознавания лиц работают изнутри. Не маркетинговую версию, а реальный конвейер: от необработанных пикселей до 512-мерного вектора эмбеддинга, кодирующего уникальную геометрию лица человека.
В этой статье подробно разбирается весь конвейер распознавания лиц, сравниваются лучшие модели с открытым исходным кодом, доступные в 2026 году, приводятся реальные показатели производительности и объясняется, когда имеет смысл создавать собственную систему, а когда — использовать промышленный API.
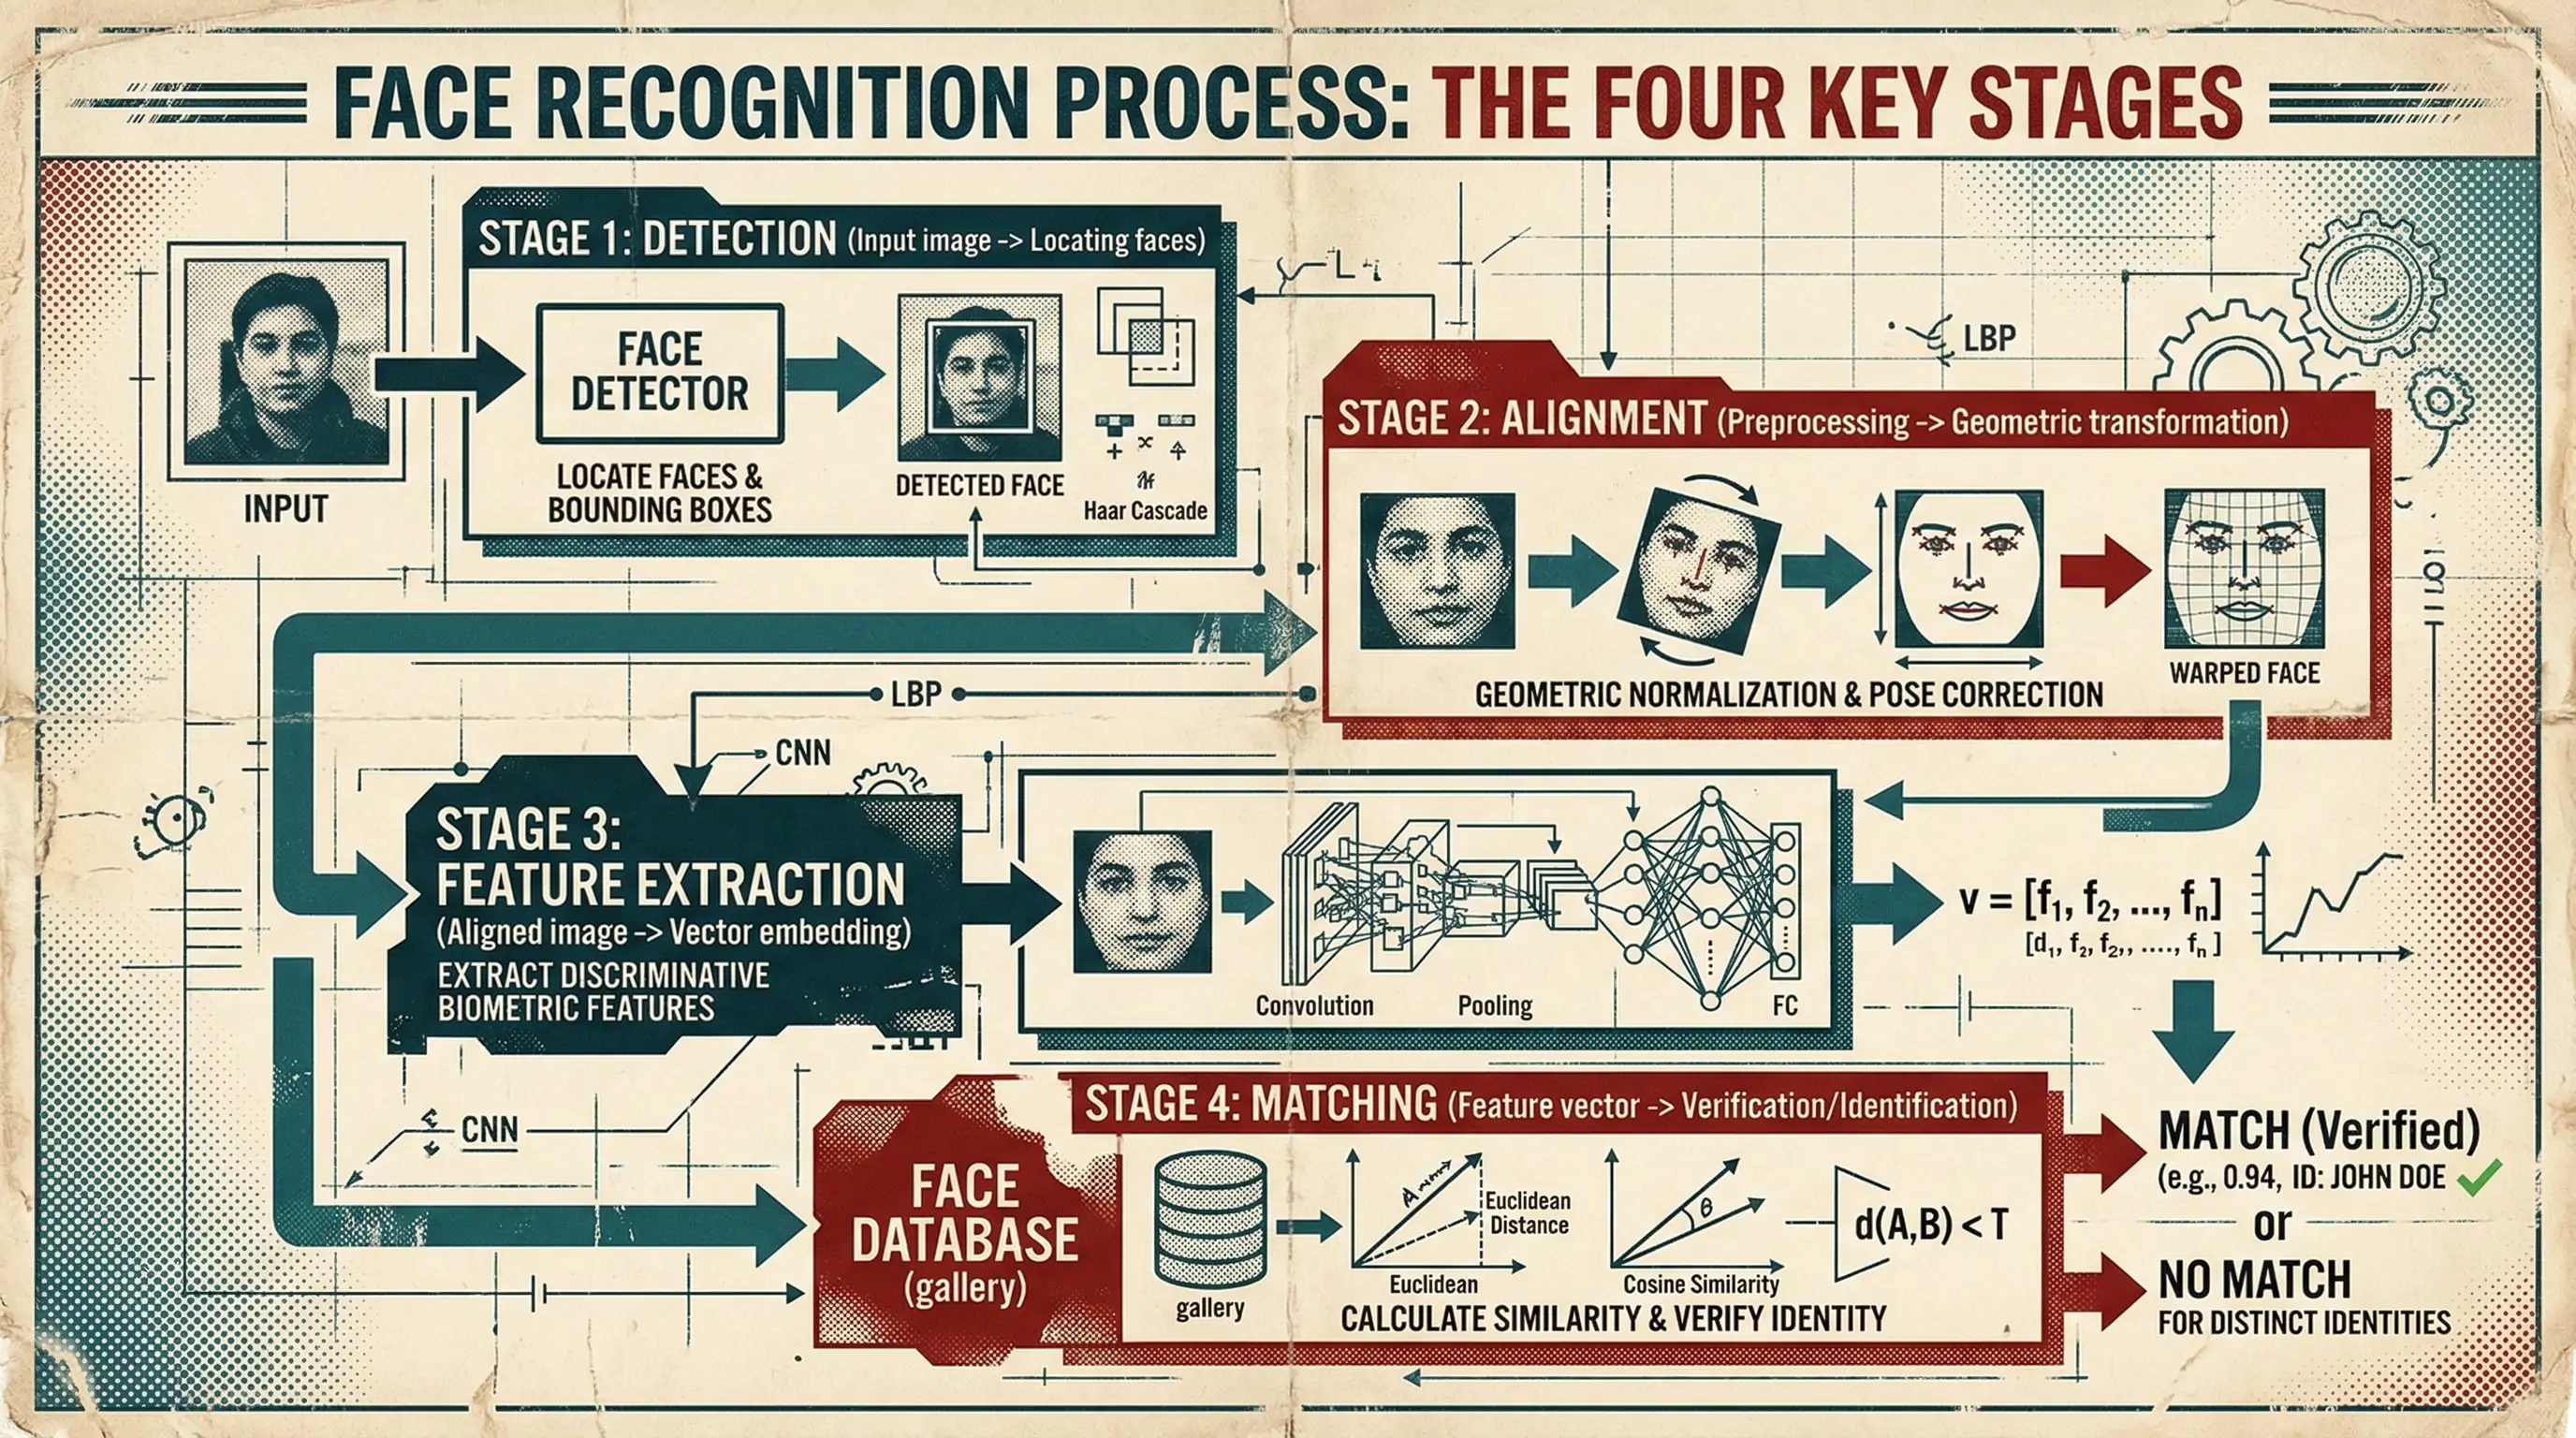
В этой статье мы будем обсуждать
- Конвейер распознавания лиц: четыре этапа
- Лучшие модели распознавания лиц с открытым исходным кодом (2026)
- Таблица сравнения производительности
- Разрыв между моделями с открытым исходным кодом и промышленными системами
- Когда создавать свою систему, а когда использовать API
- API поиска лиц FaceCheck.id
- Часто задаваемые вопросы
Конвейер распознавания лиц: четыре этапа
Каждая современная система распознавания лиц работает по одному и тому же базовому конвейеру — независимо от того, запущена ли она на Raspberry Pi за 35 долларов или на кластере GPU в государственном учреждении. Понимание этих четырех этапов поможет вам оценить любую модель или API.
Этап 1: обнаружение лиц
Прежде чем распознать лицо, его нужно найти. Система обнаружения лиц принимает изображение и возвращает ограничивающие рамки вокруг всех присутствующих на нем лиц. Звучит просто, но именно на этом этапе многие системы дают сбой в промышленной эксплуатации.
Стандартные модели:
- MTCNN (многозадачные каскадные сверточные сети): основная рабочая лошадка для обнаружения лиц с 2016 года. Трехэтапный каскад: Proposal Network (P-Net) находит потенциальные области, Refine Network (R-Net) отсеивает ложные срабатывания, а Output Network (O-Net) уточняет ограничивающие рамки и определяет ключевые точки лица. По-прежнему широко используется. Точна на лицах анфас, но хуже справляется с экстремальными ракурсами и перекрытиями. Работает со скоростью около 20 кадров/с на современном CPU.
- RetinaFace: передовое решение по точности обнаружения. Одноэтапный детектор на основе архитектуры [Feature Pyramid Network](https://arxiv.org/abs/1612.03144). Возвращает ограничивающие рамки и пять ключевых точек лица: глаза, нос и уголки рта. Хорошо работает с объектами разного масштаба. Основной выбор, если точность важнее скорости. Около 15 кадров/с на GPU и медленнее на CPU.
- SCRFD (перераспределение выборок и вычислений для эффективного обнаружения лиц): лидер по скорости. Разработана для мобильных и периферийных устройств. Обеспечивает точность уровня RetinaFace при скорости в 3–10 раз выше. Доступны модели разных размеров — от 0,5 млн до 34 млн параметров. Если вы развертываете систему на мобильных устройствах или вам нужна обработка в реальном времени, это подходящий вариант.
- BlazeFace: разработка Google для [MediaPipe](https://ai.google.dev/edge/mediapipe/solutions/guide). Чрезвычайно быстрая модель — работает со скоростью более 200 кадров/с на мобильных GPU, — но уступает в точности на сложных ракурсах. Хорошо подходит для видеоприложений реального времени, где необходимо обрабатывать каждый кадр.
Что действительно важно при обнаружении: сложные случаи — это не селфи при хорошем освещении. Это записи с камер наблюдения, групповые фотографии, на которых ширина лица составляет 50 пикселей, крайние боковые ракурсы, а также лица, частично закрытые солнцезащитными очками или масками. Модель обнаружения определяет верхний предел качества всей системы. Если детектор пропустил лицо, последующие этапы уже ничего не исправят.
Проблема нескольких лиц: если на изображении несколько лиц, необходимо решить, для какого из них создавать эмбеддинг. Можно выбрать самое крупное лицо, наиболее близкое к центру, лицо с наивысшей оценкой качества либо создать эмбеддинги для всех лиц и предоставить последующей логике разобраться с ними. У каждого подхода свои типичные ошибки. Создание эмбеддингов для всех лиц на групповых фотографиях раздувает индекс и приводит к неоднозначным результатам поиска, а выбор только самого крупного лица позволяет пропустить человека в заднем ряду. Большинство промышленных систем создают эмбеддинги для всех обнаруженных лиц, превышающих минимальный порог размера — обычно 40–60 пикселей между глазами, — и сохраняют их как отдельные записи, связанные с одним исходным изображением.
Оценка качества лица как входной фильтр: запуск облегченного оценщика качества, например SER-FIQ или ветви оценки качества из MagFace, перед вычислением ресурсоемких эмбеддингов не позволяет мусорным данным попасть в индекс. Размытые фрагменты, сильные перекрытия и пересвеченные лица создают эмбеддинги с низкой достоверностью, загрязняющие результаты поиска. Отбрасывание лиц ниже порога качества еще на этапе обнаружения значительно повышает точность последующих этапов и экономит ресурсы GPU. Это одна из самых выгодных оптимизаций во всем конвейере.
Защита от подделок при верификации лица: в сценариях верификации критически важно обнаруживать атаки предъявления, или PAD. Бумажные распечатки, повторное воспроизведение изображения на экране и трехмерные маски способны обмануть системы на основе эмбеддингов. Такие модели, как CDCN или PatchNet, обнаруживают эти атаки, но увеличивают задержку на 5–15 мс на каждое лицо и требуют сопровождения дополнительной модели. Если вы создаете систему, в которой пользователь контролирует входное изображение, — контроль доступа, KYC или аутентификацию, — необходимо включить защиту от подделок, иначе систему будут эксплуатировать злоумышленники.
Этап 2: выравнивание лица
После обнаружения лица его необходимо нормализовать. Разные положения головы, углы камеры и расстояния меняют то, как лицо выглядит на исходном изображении. Выравнивание преобразует каждое обнаруженное лицо к стандартному виду: глаза расположены горизонтально, лицо находится по центру, масштаб одинаков.
Стандартный подход использует пять ключевых точек, полученных при обнаружении, — левый глаз, правый глаз, кончик носа, левый и правый уголки рта — для вычисления преобразования подобия. Оно отображает обнаруженное лицо в канонический фрагмент размером 160x160 пикселей, где глаза находятся в фиксированных пиксельных координатах.
В учебных материалах этот этап часто упускают, хотя он критически важен. Ошибка выравнивания всего на 2 градуса может снизить точность распознавания на 1–3%. Большинство конвейеров с открытым исходным кодом выполняют выравнивание автоматически, но при создании собственной системы используйте в качестве стандарта спецификацию выравнивания FaceNet: размер 160x160 и конкретные координаты глаз. Именно на ней обучалось большинство современных моделей.
Чувствительность выравнивания к точности ключевых точек: ключевые точки RetinaFace в среднем имеют погрешность около 2 пикселей. Эта ошибка переносится в преобразование выравнивания и может снизить точность на 1–5%, особенно для небольших фрагментов лица, где 2 пикселя составляют значительную долю общей ширины лица. Некоторые промышленные системы после первичного обнаружения выполняют дополнительное уточнение по 68 или 98 точкам, например с помощью face-alignment Адриана Булата. Дополнительные 3–5 мс на лицо оправданы, когда сценарий требует максимальной точности, особенно при верификации 1:1, где одно неверное решение может иметь серьезные последствия.
Этап 3: извлечение признаков (эмбеддинг)
Это основа распознавания лиц. Глубокая нейронная сеть принимает выровненное изображение лица и возвращает вектор фиксированной длины — обычно 512 измерений, — называемый эмбеддингом или вектором признаков. Этот вектор представляет собой компактное числовое описание уникальных характеристик лица.
Два лица одного человека, независимо от освещения, выражения, возраста в разумных пределах или камеры, должны создавать эмбеддинги, близкие друг к другу в векторном пространстве. Эмбеддинги двух разных людей должны находиться далеко друг от друга.
Как это работает с технической точки зрения:
Архитектура сети обычно представляет собой модифицированную Inception-ResNet или ResNet, обученную на миллионах изображений лиц. Главное новшество заключается не в самой архитектуре, а в функции потерь, используемой при обучении.
- Потери Softmax (базовый вариант): рассматривают распознавание лиц как задачу классификации. Подход работает, но создает эмбеддинги, недостаточно хорошо разделенные в угловом пространстве. Для распознавания в основном устарел.
- Триплетные потери: подход, популяризированный FaceNet. Сеть учится, сравнивая тройки лиц «якорь/положительный пример/отрицательный пример», сближая эмбеддинги одной личности и отдаляя эмбеддинги разных людей. При обучении требуется тщательно подбирать сложные триплеты. Подход создает эмбеддинги с высокой различающей способностью.
- Потери ArcFace: пожалуй, наиболее широко используемая функция потерь в промышленных системах распознавания лиц по состоянию на 2026 год. Она добавляет штраф в виде аддитивного углового отступа в угловом пространстве между вектором признаков и соответствующим ему весом класса, формируя более плотные внутриклассовые кластеры и более широкие межклассовые промежутки, чем подходы с косинусным отступом. Проект [InsightFace](https://github.com/deepinsight/insightface) предоставляет эталонную реализацию, а большинство передовых моделей обучаются с ArcFace или одним из ее вариантов — например, адаптивный отступ AdaFace построен поверх формулировки ArcFace. Если вы обучаете или дообучаете собственную модель распознавания лиц, ArcFace является стандартной отправной точкой.
- Потери CosFace: добавляют косинусный отступ к потерям Softmax, заставляя сеть создавать эмбеддинги, плотнее сгруппированные внутри каждой личности и лучше разделенные между разными личностями.
- SphereFace / A-Softmax: первоначальный подход с угловым отступом, предложенный в 2017 году. Исторически важен, но в основном вытеснен ArcFace и более современными функциями потерь.
Результат: вектор из 512 чисел с плавающей точкой, L2-нормализованный к единичной гиперсфере. Вся информация о лице сжата в 2 КБ данных. Именно этот вектор хранится, индексируется и сравнивается.
Ловушка нормализации: многие разработчики забывают, что перед сравнением эмбеддинги необходимо L2-нормализовать. Ненормализованные эмбеддинги дают крайне нестабильные оценки сходства. Это распространенная ошибка, которую трудно диагностировать, поскольку система «в основном работает»: относительный порядок совпадений при тестировании может выглядеть правильным, но абсолютные оценки сходства меняются от изображения к изображению, делая решения на основе порогов ненадежными. FaceNet512 по умолчанию создает нормализованные эмбеддинги, но при использовании собственной модели или экспорте через ONNX всегда проверяйте, что выходные эмбеддинги лежат на единичной гиперсфере, то есть их L2-норма равна 1,0.
Промышленное развертывание: ONNX Runtime и квантование: показатели скорости в тестах предполагают инференс FP32 на незагруженном GPU. В промышленной среде большинство систем развертываются через ONNX Runtime с квантованием INT8, которое сокращает время инференса в 2–3 раза при минимальной потере точности — обычно менее 0,1% на LFW. Процесс выглядит так: экспортируйте модель PyTorch или TensorFlow в ONNX, запустите инструмент квантования ONNX Runtime с калибровочным набором примерно из 1000 изображений лиц и разверните квантованную модель. Именно так на одном и том же оборудовании можно перейти от 10 мс на лицо к 3–4 мс, что имеет огромное значение при обработке миллиардов изображений.
Инференс со смешанной точностью: использование FP16 на GPU для основной сети и FP32 для последнего слоя эмбеддинга позволяет избежать проблем с точностью чисел с плавающей точкой, описанных далее в статье, и при этом получить ускорение в 1,5–2 раза. Это практичный компромисс между полным FP32 — точным, но медленным — и полным FP16 — быстрым, но способным создавать немного разные эмбеддинги на разном оборудовании.
Дистилляция эмбеддингов для периферийных устройств: можно обучить меньшую сеть-ученика, например MobileFaceNet примерно с 1 млн параметров, имитировать эмбеддинги FaceNet512 с помощью дистилляции знаний. Модель-ученик достигает более 95% точности при десятикратном ускорении, что делает ее пригодной для мобильных и периферийных устройств, где использование GPU невозможно. Ключевая идея заключается в том, что ученика не нужно обучать с нуля на метках личностей: его обучают воспроизводить эмбеддинги учителя на неразмеченных данных лиц, что требует значительно меньше вычислений и не требует набора данных с идентификационными метками.
Этап 4: сопоставление
Как определить, принадлежат ли два эмбеддинга лица одному человеку? Существуют два подхода:
Косинусное сходство: вычисляется косинус угла между двумя векторами эмбеддингов. Диапазон — от -1 до 1, где 1 означает полную идентичность. Типичный порог для решения «один и тот же человек» составляет 0,4–0,6 в зависимости от модели и сценария. Метод прост, быстр и хорошо работает, поскольку эмбеддинги FaceNet512 L2-нормализованы.
Евклидово расстояние: вычисляется L2-расстояние между векторами. Для нормализованных эмбеддингов оно математически эквивалентно косинусному сходству: d = sqrt(2 - 2*cos_sim). Некоторые системы предпочитают эту формулировку.
Для поиска — сопоставления 1:N: когда необходимо найти лицо в базе из миллионов записей, полный перебор слишком медленен. Используйте поиск приближенных ближайших соседей, или ANN:
- FAISS (Facebook AI Similarity Search): стандартная библиотека. Поддерживает ускорение на GPU и несколько типов индексов: IVF, HNSW и PQ. Способна искать среди 1 млрд векторов за миллисекунды. Бесплатная, с открытым исходным кодом.
- Milvus: специализированная векторная база данных, использующая FAISS внутри и добавляющая постоянное хранение, масштабирование и уровни API.
- Qdrant / [Weaviate](https://weaviate.io/) / [Pinecone](https://www.pinecone.io/): управляемые векторные базы данных для тех, кто не хочет самостоятельно обслуживать инфраструктуру.
Для базы из 10 млн лиц хорошо настроенный индекс FAISS HNSW на одном GPU способен вернуть 10 лучших совпадений менее чем за 5 мс.
Выбор типа индекса FAISS имеет огромное значение. IVF-PQ обеспечивает отличное сжатие — 8–16 байт на вектор вместо 2 КБ, — но снижает точность для пограничных совпадений, когда ошибка квантования опускает настоящее совпадение ниже порога. HNSW сохраняет точность, но использует в 4–8 раз больше памяти, поскольку хранит полные векторы с плавающей точкой и структуру графа. Гибридные индексы IVF-HNSW обеспечивают лучший компромисс при масштабе от 10 млн до 1 млрд записей. Большинство команд сначала выбирают неправильный тип индекса, ориентируясь на рекомендации из учебных материалов, а через 6 месяцев, столкнувшись с ограничениями, вынуждены полностью перестраивать инфраструктуру индексации. Прежде чем выбрать тип индекса, протестируйте свою конкретную нагрузку на реалистичных объемах данных и шаблонах запросов.
Проблема холодного старта индексов ANN: для эффективной работы HNSW и IVF требуется минимальное количество векторов. При количестве менее примерно 10 тыс. векторов полный перебор фактически быстрее индексированного поиска, поскольку накладные расходы индекса — обход графа и сравнение центроидов — преобладают над вычислениями. На раннем этапе роста начните с полного перебора — FAISS IndexFlatIP — и переходите на индекс ANN, когда база превысит 50–100 тыс. векторов.
Предварительная фильтрация по бинарным кодам: вычисление бинарного хеша каждого эмбеддинга с помощью бинаризации или SimHash позволяет выполнить дешевую предварительную фильтрацию по расстоянию Хэмминга перед ресурсоемкими сравнениями чисел с плавающей точкой. Это может сократить набор кандидатов более чем на 90% при минимальной потере полноты. Идея состоит в том, чтобы вместе с каждым полным эмбеддингом хранить 256- или 512-битный бинарный код. Для запроса сначала вычисляется расстояние Хэмминга до всех бинарных кодов — чрезвычайно быстро с инструкциями CPU POPCNT, — затем выбираются лучшие 1–5% кандидатов, и точное косинусное сходство рассчитывается только для них. Такой двухэтапный подход особенно эффективен, когда набор данных превышает доступную память GPU.
Повторное ранжирование по атрибутам лица: первоначальный поиск по эмбеддингам возвращает кандидатов, а второй проход с использованием оценочных атрибутов — возрастного диапазона, пола, оттенка кожи и растительности на лице — позволяет отфильтровать очевидные ложные совпадения. Если лицо в запросе определено как 25-летняя женщина, а кандидат — как 60-летний мужчина, это почти наверняка ложное совпадение независимо от оценки сходства эмбеддингов. Эта простая эвристика способна сократить число ложных срабатываний на 30–50% при минимальных вычислительных затратах и остается одним из наиболее редко используемых методов в промышленном поиске лиц.
Временная согласованность в видео: если лица сопоставляются по видео, а не по отдельным изображениям, усреднение эмбеддингов по нескольким кадрам одного и того же отслеживаемого лица значительно повышает точность — зачастую на 5–10% в сложных тестах. Агрегация эмбеддингов на уровне трека однозначно лучше сопоставления отдельных кадров. Подход таков: используйте трекер лиц, например SORT или DeepSORT, чтобы связать обнаружения между кадрами, вычислите эмбеддинги для каждого обнаружения и объедините их в один «эмбеддинг трека» с помощью взвешенного по качеству усреднения, где весом служит оценка качества лица с этапа обнаружения.
Лучшие модели распознавания лиц с открытым исходным кодом (2026)
FaceNet512
Золотой стандарт. FaceNet512 — это вариант архитектуры Google FaceNet с 512-мерными эмбеддингами, обеспечивающий более крупное и различающее пространство эмбеддингов по сравнению с первоначальным 128-мерным вариантом.
from deepface import DeepFace

# Get face embeddings using FaceNet512
result = DeepFace.represent(img_path="face.jpg", model_name="Facenet512")
embedding = result[0]["embedding"] # 512-d list- Архитектура: базовая сеть Inception-ResNet-v2, создающая 512-мерные эмбеддинги
- Лицензия: MIT (разрешительная, допускает коммерческое использование)
- Точность на LFW: 99,65%
- Размер эмбеддинга: 512 измерений
- Возможности: работает со стандартными конвейерами обнаружения — MTCNN, [RetinaFace](https://github.com/deepinsight/insightface/tree/master/detection/retinaface) — для сквозного распознавания
- Python API: доступен через библиотеку
deepfaceили отдельные реализации
Вывод: если вы создаете систему распознавания лиц в 2026 году, FaceNet512 — надежная отправная точка. Она обеспечивает отличную точность, 512-мерные эмбеддинги с высокой различающей способностью, разрешительную лицензию MIT и широкую поддержку экосистемы.
FaceNet (Google, исходная 128-мерная версия)
Модель, популяризировавшая подход с эмбеддингами в 2015 году. Она представила обучение с триплетными потерями, при котором сеть учится, сравнивая тройки лиц «якорь/положительный пример/отрицательный пример».
- Исходная статья: «FaceNet: единый эмбеддинг для распознавания и кластеризации лиц» (Шрофф и др., 2015)
- Репозиторий: несколько реализаций (davidsandberg/facenet — классическая версия для TensorFlow)
- Лицензия: MIT
- Точность на LFW: 99,63% у исходной версии и до 99,75% при современном обучении
- Размер эмбеддинга: 128 измерений
- Архитектура: Inception-ResNet-v1 или Inception-ResNet-v2
Вывод: исторически важная модель, которая по-прежнему хорошо работает. 128-мерный эмбеддинг компактнее, но обладает немного меньшей различающей способностью, чем 512-мерный вариант FaceNet512. Используйте ее, если вам требуется меньший объем эмбеддингов или вы работаете в TensorFlow при ограниченной памяти.
DeepFace (Facebook/Meta)
Не путайте ее с Python-библиотекой deepface в нижнем регистре. DeepFace от Meta, представленная в 2014 году, была одним из первых подходов глубокого обучения к распознаванию лиц и достигла на LFW точности, близкой к человеческой.
Сегодня более актуален проект Python-библиотека deepface от Серенгила:
from deepface import DeepFace

# Verify two faces
result = DeepFace.verify(img1_path="face1.jpg", img2_path="face2.jpg", model_name="Facenet512")
print(result["verified"])  # True/False
print(result["distance"])  # 0.23

# Find a face in a database
results = DeepFace.find(img_path="query.jpg", db_path="./face_database/", model_name="Facenet512")- Репозиторий: github.com/serengil/deepface
- Лицензия: MIT
- Назначение: библиотека-обертка, предоставляющая единый API для нескольких моделей: FaceNet512, FaceNet, VGG-Face, OpenFace, DeepID, Dlib и SFace
- Возможности: верификация, поиск и анализ атрибутов лица — возраста, пола, расы и эмоций
- Удобство использования: чрезвычайно простой API
Вывод: лучший выбор для прототипирования и экспериментов. Единый API позволяет переключаться между моделями изменением одного параметра. В промышленной среде лучше использовать FaceNet512 напрямую, чтобы получить более высокую производительность и больше контроля.
dlib
Библиотека C++ с привязками для Python, которую сопровождает Дэвис Кинг. Включает модель распознавания лиц, обученную на наборе из 3 млн изображений.
import dlib
import numpy as np

detector = dlib.get_frontal_face_detector()
sp = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")
facerec = dlib.face_recognition_model_v1("dlib_face_recognition_resnet_model_v1.dat")

# Get embedding
dets = detector(image, 1)
shape = sp(image, dets[0])
embedding = np.array(facerec.compute_face_descriptor(image, shape))- Репозиторий: github.com/davisking/dlib
- Лицензия: Boost Software License (разрешительная)
- Точность на LFW: 99,38%
- Размер эмбеддинга: 128 измерений
- Обнаружение: на основе HOG — быстрое и удобное для CPU — и CNN — более точное
Вывод: исключительно надежная, проверенная в эксплуатации библиотека C++ с хорошими привязками для Python. Точность ниже, чем у FaceNet512, но стабильность очень высока. Хороший выбор для работы на C++ или когда требуется легкое решение без зависимостей от PyTorch/ONNX.
AdaFace
Более новая модель 2022 года, специально предназначенная для учета различий в качестве изображений. Стандартные модели обучаются на высококачественных изображениях и хуже работают на материалах с низким разрешением или размытием. AdaFace во время обучения адаптирует штраф за отступ в зависимости от качества изображения.
- Репозиторий: github.com/mk-minchul/AdaFace
- Лицензия: MIT
- Главное преимущество: превосходная работа с изображениями низкого качества — записями наблюдения и дальнобойными камерами
- Точность на LFW: 99,82%
- IJB-C, TAR@FAR=1e-4: 97,39% — превосходит большинство моделей с открытым исходным кодом в сложных тестах
Вывод: используйте ее для входных изображений низкого качества. В системах наблюдения, при анализе записей CCTV и в любых сценариях, где качество изображения невозможно контролировать, AdaFace дает измеримо лучшие результаты, чем стандартные модели.
Таблица сравнения производительности
| Модель | LFW (%) | Эмбеддинг | Скорость (мс/лицо) | Лицензия |
|---|---|---|---|---|
| FaceNet512 (IR-v2) | 99,65 | 512 измерений | ~10 мс (GPU) | MIT |
| FaceNet (IR-v1) | 99,63 | 128 измерений | ~12 мс (GPU) | MIT |
| AdaFace (R100) | 99,82 | 512 измерений | ~9 мс (GPU) | MIT |
| dlib ResNet | 99,38 | 128 измерений | ~25 мс (CPU) | Boost |
| VGG-Face2 | 99,43 | 2048 измерений | ~15 мс (GPU) | CC BY-SA |
LFW (размеченные лица в естественных условиях) — стандартный тест, но фактически эта задача уже решена. Каждая современная модель набирает более 99%. Реальные различия проявляются в более сложных тестах, таких как IJB-C с разнообразными условиями и TinyFace с низким разрешением.
О тестах и реальности: приведенные показатели скорости относятся к инференсу FP32 для одного лица на прогретом GPU. В промышленной среде с квантованием INT8 в ONNX Runtime можно ожидать ускорения в 2–3 раза. Однако помните, что полный конвейер — обнаружение, выравнивание, оценка качества и эмбеддинг — занимает в 3–5 раз больше времени, чем одно лишь извлечение эмбеддинга. Реалистичная сквозная производительность полного конвейера на одном GPU A100 составляет 200–400 лиц в секунду, а не тысячи, которые могут показывать тесты только эмбеддингов.
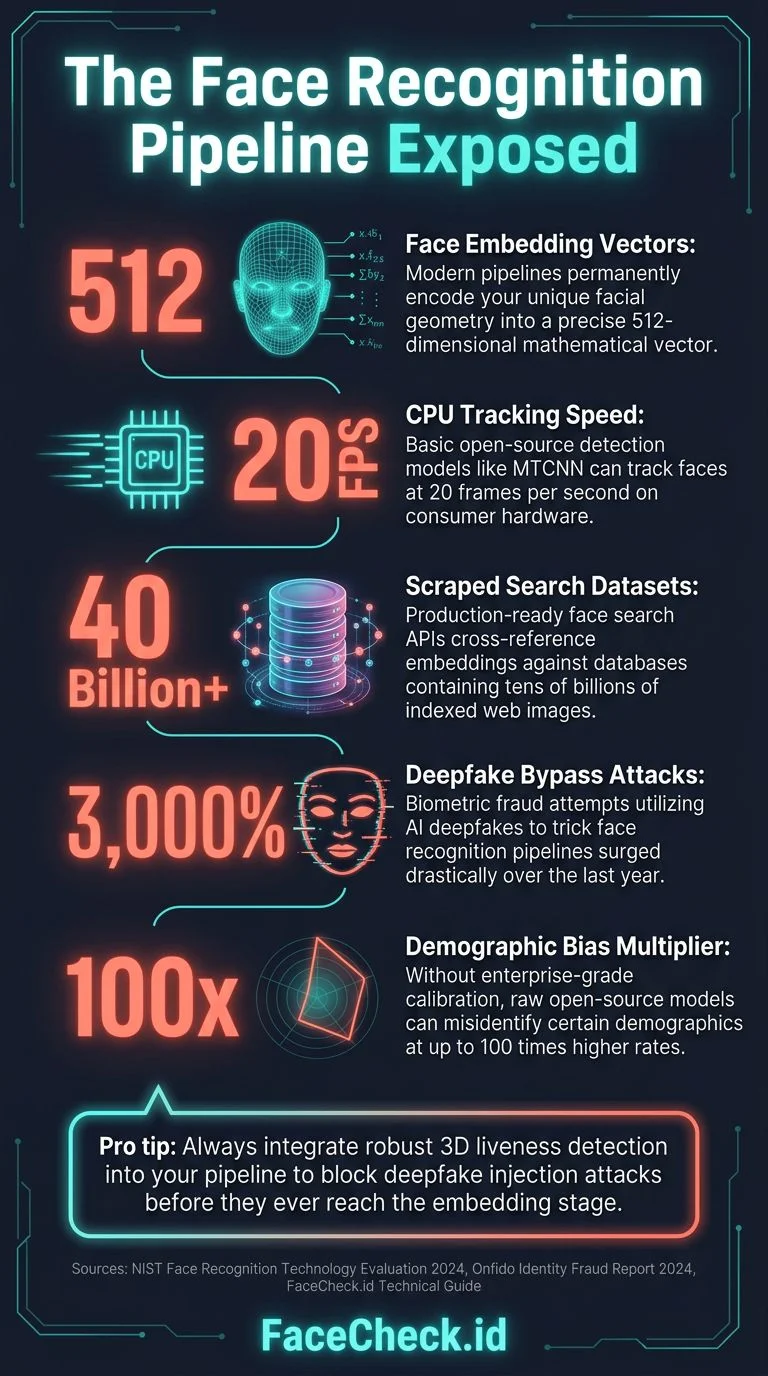
Разрыв между моделями с открытым исходным кодом и промышленными системами
Вот о чем не рассказывают учебные материалы: запустить модель распознавания лиц в Jupyter notebook — это легкая часть. Создание промышленной системы, действительно работающей в большом масштабе, требует решения длинного списка инженерных задач, которые ни одна модель не решит за вас. Большинство команд сильно недооценивают и стоимость, и сроки. Проект, который выглядит как «просто подключить модель», превращается в инженерную работу на 12–24 месяца, способную легко поглотить от 500 тыс. до более чем 2 млн долларов еще до готовности к промышленной эксплуатации, не считая последующих операционных расходов.
Счет за инфраструктуру
Вычисления на GPU для извлечения эмбеддингов. Обнаружение лиц и извлечение эмбеддингов из миллиардов изображений невозможно выполнить на ноутбуке. Один GPU NVIDIA A100 способен обрабатывать примерно 200–400 лиц в секунду через полный конвейер обнаружения, выравнивания и создания эмбеддинга. Чтобы обработать 1 млрд изображений за разумный срок, например менее чем за неделю, потребуется кластер из 40–80 GPU, работающих непрерывно. По облачным тарифам один проход обойдется в 50–150 тыс. долларов, а после улучшения модели или изменения конвейера данные придется обрабатывать заново. Покупка оборудования потребует 300–800 тыс. долларов на серверы с GPU, а также расходов на место в стойках, электричество, охлаждение и специалистов по обслуживанию.
Хранение в большом масштабе. 1 млрд эмбеддингов лиц по 512 чисел с плавающей точкой — по 2 КБ каждый — составляет примерно 2 ТБ одних только векторных данных. Добавьте исходные изображения, миниатюры, метаданные и структуры индексов — и получите от сотен терабайт до нескольких петабайт хранилища. Высокопроизводительное NVMe-хранилище для векторных индексов в облаке стоит 0,10–0,25 доллара за 1 ГБ в месяц. При 50 ТБ горячего хранилища это 5–12,5 тыс. долларов ежемесячно только на поддержание работы.
Инфраструктура векторного поиска. Один сервер с FAISS способен обслуживать примерно 100–500 млн векторов в зависимости от типа индекса и доступной оперативной памяти. При большем объеме необходим распределенный поиск по нескольким шардам с балансировкой нагрузки, репликацией для отказоустойчивости и достаточным объемом RAM для размещения индексов. Промышленное распределенное развертывание FAISS или Milvus для более чем 1 млрд векторов обычно требует 8–16 серверов с большим объемом памяти — не менее 256 ГБ RAM каждый — и обходится в 15–40 тыс. долларов в месяц за облачные вычисления.
Сеть и пропускная способность. Сбор миллиардов изображений означает загрузку петабайтов данных. При стоимости исходящего трафика 0,05–0,09 доллара за 1 ГБ у крупных облачных провайдеров одна передача данных может стоить десятки тысяч долларов. Кроме того, требуется высокопроизводительная внутренняя сеть между краулерами, узлами обработки на GPU и системами хранения.
Оценка общей стоимости инфраструктуры поисковой системы лиц веб-масштаба: 30–80 тыс. долларов ежемесячных облачных расходов либо 500 тыс.–1,5 млн долларов первоначальных затрат на оборудование плюс 10–20 тыс. долларов в месяц на электричество, пропускную способность и обслуживание. И это только инфраструктура — еще до того, как инженер напишет первую строку прикладного кода.
Сроки разработки
Создание промышленной системы поиска лиц — не проект для хакатона. Вот реалистичный график для команды из 3–5 опытных инженеров:
Месяцы 1–3: основной конвейер. Добиться надежной работы обнаружения, выравнивания и извлечения эмбеддингов. Создать базовый векторный индекс. Реализовать загрузку изображений из локальных файлов. Это «веселая» часть, когда все кажется успешным, а демонстрация выглядит впечатляюще.
Месяцы 3–6: инфраструктура веб-краулинга. Создать скраперы для крупных платформ. Разобраться с ограничением частоты запросов, CAPTCHA, страницами за авторизацией, динамическим рендерингом на насыщенных JavaScript сайтах, дедупликацией изображений и фильтрацией контента. Обнаружить, что каждая социальная платформа использует собственные меры против скрапинга, которые еженедельно ломают ваши краулеры. Создать мониторинг для обнаружения их незаметных сбоев. Этот этап сам по себе может занять больше времени, чем ожидалось, потому что интернет хаотичен и враждебен.
Месяцы 6–9: масштабирование и надежность. Прототип работал на 1 млн лиц. Теперь заставьте его работать на 100 млн. Обнаружьте, что индекс FAISS больше не помещается в RAM. Реализуйте шардирование. Исправьте состояния гонки в конвейере загрузки. Создайте логику повторных попыток для 15% изображений, которые не удается загрузить. Научитесь обрабатывать поврежденные изображения, файлы, выдающие себя за JPEG, изображения с флагами поворота EXIF и неполные загрузки. Добавьте мониторинг, оповещения и журналирование, чтобы знать о сбоях в 3 часа ночи.
Месяцы 9–12: качество и точность. Осознайте, что частота ложных срабатываний в большом масштабе неприемлема. Реализуйте оценку качества лица для фильтрации мусорных эмбеддингов. Настройте пороги для каждого сценария. Создайте механизм обратной связи, позволяющий отмечать и расследовать плохие совпадения. Обнаружьте, что модель дает разные результаты на разных архитектурах GPU из-за различий в точности вычислений с плавающей точкой, и потратьте две недели на поиск причины.
Месяцы 12–18: подготовка к промышленной эксплуатации. Создайте уровень API с аутентификацией, ограничением частоты запросов и учетом использования. Добавьте функции соответствия GDPR/CCPA: механизмы отказа, обработку запросов на удаление данных и аудит. Реализуйте кэширование результатов. Создайте административные инструменты. Напишите документацию. Пройдите аудит безопасности. Выполните нагрузочное тестирование. Исправьте утечки памяти, о существовании которых вы не знали.
Месяцы 18–24: текущая эксплуатация. Краулеры ломаются при изменении структуры сайтов. Модели деградируют при появлении новых типов изображений. Диски заполняются. Индексы требуется перестраивать. Пользователи сообщают о крайних случаях, которых вы не предусматривали. Кто-то обнаруживает, что система уверенно находит совпадения для мультяшных лиц, и приходится добавлять фильтр «настоящее лицо». Это никогда не заканчивается.
Полный список проблем, с которыми вы столкнетесь
Помимо инфраструктуры и сроков, ниже перечислены все основные проблемы, с которыми команды сталкиваются при создании систем распознавания лиц с нуля. Этот список основан на реальных промышленных системах, а не на теоретических опасениях.
Кошмары качества данных:
- Мусор на входе — мусор на выходе. Интернет полон мемов, лиц, созданных ИИ, рисунков, фотографий фотографий, журнальных обложек и статуй. Детектор найдет «лица» во всех этих материалах и создаст эмбеддинги, загрязняющие индекс. Вам потребуются классификаторы для фильтрации синтетических и нарисованных лиц, фрагментов с крайне низким разрешением и нефотографического контента. Создание и сопровождение этих фильтров — отдельный проект.
- Дубликаты и почти одинаковые изображения. Одна и та же фотография появляется на десятках сайтов с разными кадрированием, водяными знаками, степенью сжатия и цветокоррекцией. Без дедупликации одна вирусная фотография создаст сотни «совпадений», которые на самом деле являются одним изображением, скрывая реальные результаты. Перцептивное хеширование — pHash и dHash — помогает, но не идеально. Дедупликация нужна на нескольких уровнях: по URL — тривиально, по перцептивному хешу — для измененных по размеру и повторно сжатых копий, — и по эмбеддингам — для одного лица, снятого под немного разными углами. Каждый уровень находит то, что пропускают другие, и на дедупликацию уйдет больше времени, чем вы ожидаете.
- Изменения возраста и внешности. Эмбеддинг лица со студенческой фотографии может не совпасть с фотографией того же человека 15 лет спустя. Изменение веса, старение, косметические операции, растительность на лице и разные прически влияют на точность. Ни одна модель не справляется с этим идеально. Пользователи будут винить систему, если она не сопоставит человека с разницей в 20 лет.
- Демографическая предвзятость. Модели с открытым исходным кодом, обученные преимущественно на западных и европеоидных наборах данных, хуже работают с другими демографическими группами. Разрыв в точности между этническими группами больше, чем показывает LFW: примерно 77% лиц в LFW принадлежат европеоидам. При глобальном развертывании разница в точности между демографическими группами на сложных тестах может достигать 5–15%. Модели вроде FaceNet512, обученные на MS-Celeb-1M, наследуют его демографический перекос. Для справедливой работы важно дообучать модели на сбалансированных наборах, таких как BUPT-Balancedface, или использовать стратегии обучения с учетом демографии. Если не оценивать точность для разных расовых групп, можно выпустить систему, которая хорошо работает для одних пользователей и плохо — для других. Это не только этическая проблема, но и вопрос качества продукта и юридической ответственности.
- Обработка ориентации EXIF. Примерно 15–20% изображений в интернете имеют теги ориентации EXIF, игнорирование которых приводит к тому, что лица оказываются повернутыми набок или вверх ногами. Большинство детекторов не находят повернутые лица. Это незаметный убийца точности, который легко пропустить при тестировании на правильно ориентированных изображениях, но который разрушителен в промышленной среде. Всегда применяйте коррекцию ориентации EXIF на самом первом этапе обработки изображения.
- Ошибки декодирования прогрессивных JPEG и WebP. Некоторые библиотеки обработки изображений незаметно создают поврежденные пиксельные данные из частично загруженных прогрессивных JPEG или усеченных WebP. Детектор все равно может найти «лицо» в артефактах повреждения и создать мусорный эмбеддинг. Перед обработкой необходимо проверять целостность изображения: файл должен декодироваться без ошибок, а полученный пиксельный буфер должен иметь разумные размеры. Без этого поврежденные изображения будут незаметно загрязнять индекс.
Инженерные проблемы, которые сначала неочевидны:
- Версионирование эмбеддингов. После обновления модели — а вы обязательно будете ее обновлять, потому что улучшение точности важно — каждый эмбеддинг в базе становится несовместимым с выходными данными новой модели. Придется либо заново создать эмбеддинги всей базы — дорого, долго и требует хранения исходных изображений, — либо поддерживать параллельные индексы во время миграции — удваивая стоимость инфраструктуры, — либо сохранять обратную совместимость — что сложно и ограничивает улучшения. Хорошего решения нет, есть только менее болезненные.
- Детерминированность вычислений с плавающей точкой. Одно и то же изображение, обработанное на разных моделях GPU, в разных версиях CUDA или даже с разными размерами пакета, может создавать немного отличающиеся эмбеддинги из-за арифметики с плавающей точкой. Различия малы — от 1e-6 до 1e-4, — но накапливаются: совпадение с оценкой 0,401 на одном сервере может получить 0,399 на другом, изменив бинарное решение по порогу. При отладке это сводит с ума. Особую опасность представляют обновления драйверов GPU: драйверы NVIDIA способны менять поведение вычислений с плавающей точкой на уровне CUDA. Эмбеддинг, вычисленный с драйвером 535.x, может отличаться от результата того же изображения с 545.x. В промышленной среде версии драйверов необходимо фиксировать на всем парке оборудования и проверять согласованность эмбеддингов после каждого обновления.
- Параллелизм и состояния гонки. Несколько краулеров одновременно добавляют лица, пользователи выполняют запросы во время обновления индекса, а запросы на удаление поступают в момент формирования результатов. Векторные базы данных не обладают такой же зрелой поддержкой транзакций, как SQL-базы. Вы столкнетесь с ситуациями, когда лицо проиндексировано частично, запросы возвращают устаревшие результаты или удаление не распространяется на все шарды.
- Управление памятью. Индексы FAISS отображаются в память, но производительность запросов сильно зависит от того, какая часть индекса помещается в RAM. По мере роста индекса задержка непредсказуемо возрастает, когда ОС вытесняет страницы индекса из памяти. Процессы завершаются из-за нехватки памяти в самый неподходящий момент. Вам придется близко познакомиться с управлением памятью Linux, параметрами подкачки и топологией [NUMA](https://en.wikipedia.org/wiki/Non-uniform_memory_access). Прогрев после холодного запуска — еще одна проблема: индексы FAISS HNSW отображаются в память, поэтому после перезапуска сервера первые несколько сотен запросов выполняются в 10–100 раз медленнее, поскольку страницы индекса еще не загружены в RAM. Перед приемом промышленного трафика нужен этап прогрева, предварительно загружающий индекс, иначе первые пользователи после развертывания столкнутся с ужасной задержкой.
- Незаметные сбои. Краулер перестает работать из-за изменения HTML сайта. После обновления драйвера узел обработки на GPU начинает создавать эмбеддинги NaN. Диск заполняется, и новые лица незаметно перестают индексироваться. Эти сбои не вызывают ошибок, а просто постепенно ухудшают систему. Без комплексного мониторинга и обнаружения аномалий вы не узнаете о проблеме, пока не пожалуются пользователи.
- Проблема обновления FAISS. При добавлении новых эмбеддингов в индекс IVF ячейки Вороного становятся несбалансированными. Качество поиска постепенно ухудшается, пока квантователь не будет переобучен. В веб-масштабе переобучение требует нескольких часов работы GPU на полном наборе данных. Обычно команды пакетно добавляют данные и переобучают индекс еженедельно или ежемесячно, поэтому недавно добавленные лица не сразу доступны для поиска с полной точностью. Приходится постоянно выбирать между актуальностью и качеством поиска — бесплатного решения нет.
- Калибровка оценок между шардами индекса. При распределении индекса по нескольким серверам исходные оценки сходства из разных шардов нельзя сравнивать напрямую, поскольку распределение эмбеддингов в каждом шарде отличается. Для осмысленного объединения результатов требуется нормализация оценок по каждому шарду — когортная нормализация, Z-norm или T-norm. Без калибровки оценка 0,45 из шарда A может означать сильное совпадение, а 0,45 из шарда B — посредственное. Объединенные результаты становятся ненадежными.
- Проблема веерной рассылки в распределенном поиске. Поиск по N шардам означает N сетевых обращений на каждый запрос. Если один шард работает медленно из-за паузы сборщика мусора, скачка дискового ввода-вывода или сетевого сбоя, замедляется весь запрос. Задержка P99 определяется P99 самого медленного шарда и ухудшается по мере увеличения числа шардов. Для приемлемой хвостовой задержки необходимы такие методы, как дублирующие запросы — отправка копий и использование первого ответа — и адаптивные тайм-ауты.
Проблемы точности и сопоставления:
- Настройка порогов никогда не бывает «завершена». Оптимальный порог сходства меняется по мере роста базы. Для 1 млн лиц порог 0,45 обеспечивает хороший баланс точности и полноты. Для 100 млн лиц тот же порог дает в десять раз больше ложных срабатываний просто потому, что появляется больше похожих людей. Нужны адаптивные пороги или повторное ранжирование. Математика беспощадна: когда база растет с 1 млн до 100 млн и затем до 1 млрд лиц, распределение оценок сходства top-k смещается вверх из-за увеличения числа похожих кандидатов. Фиксированный порог, дающий 0,1% ложных срабатываний при 1 млн лиц, может дать 10% при 1 млрд. Необходимо моделировать это распределение и динамически корректировать пороги либо смириться со снижением точности при масштабировании.
- Распознавание в открытом и закрытом множестве. Большинство тестов оценивают работу в закрытом множестве, где человек из запроса гарантированно присутствует в базе. Реальный поиск лиц работает в открытом множестве: искомого лица в индексе может не быть. Для оценки открытого множества нужны совершенно другие метрики — TPIR при фиксированном FPIR вместо точности rank-1, — а типичной ошибкой становятся ложные совпадения, а не неправильное ранжирование. Система, набирающая 99% в тестах закрытого множества, при реальном развертывании в открытом множестве может иметь 10% ложных совпадений, поскольку уверенно возвращает «ближайшее» лицо даже при отсутствии настоящего совпадения. Правильно сообщить «совпадений не найдено» не менее важно, чем найти верное совпадение.
- Двойники и очень похожие люди. В базе из более чем 100 млн лиц существует множество пар неродственных людей с неожиданно близкими эмбеддингами. Чем больше база, тем больше ложных совпадений. Пользователи будут регулярно сообщать о результатах с «не тем человеком». Нужна стратегия: верификация по нескольким фотографиям, контекстные сигналы — имя и местоположение, — очереди для проверки человеком.
- Инвариантное к позе распознавание остается сложной задачей. Даже качество FaceNet512 значительно снижается при повороте головы более чем на 60 градусов в любую сторону. Точность сопоставления профиля с анфасом может быть на 10–20% ниже, чем анфаса с анфасом. В системах наблюдения большинство лиц снято под углом, поэтому реальная точность существенно ниже тестовых показателей. Модели, обученные с трехмерно-ориентированной аугментацией, или архитектуры вроде UV-GAN помогают, но увеличивают сложность. Если входные данные часто сняты под большим углом, считайте это ключевой проблемой точности, а не редким крайним случаем.
- Состязательные входные данные. Пользователи будут отправлять лица, созданные ИИ, дипфейки, морфированные изображения и фотографии с намеренными искажениями. Одни проверяют систему, другие пытаются манипулировать результатами. Системе нужна определенная устойчивость к таким данным, иначе она будет уверенно находить совпадения для поддельных лиц.
- Редактирование фотографий. Фильтры, приложения для улучшения внешности, плотный макияж и программы коррекции лица. Реальность Instagram и настоящая реальность. Эти изменения достаточно сильно меняют геометрию лица, чтобы повлиять на сходство эмбеддингов. Сильно отфильтрованное селфи может не совпасть с необработанной фотографией того же человека.
- Одно лицо — множество эмбеддингов. У одного человека в интернете могут быть сотни фотографий на разных платформах, снятых под разными углами и в разные годы. Возвращать их как отдельные совпадения или объединять в одну личность? Кластеризация в масштабе сотен миллионов лиц требует больших вычислительных ресурсов и создает собственные типы ошибок: избыточное объединение разных людей и недостаточное объединение фотографий одного человека.
Эксплуатационные трудности:
- Гонка вооружений против скрапинга. Все крупные социальные платформы активно блокируют скраперы. Они меняют структуру страниц, добавляют CAPTCHA, обнаруживают безголовые браузеры, ограничивают запросы по IP, создают отпечатки шаблонов запросов и иногда отдают ложный контент. Инфраструктура краулинга находится в постоянной гонке вооружений. Работающий сегодня скрапер может быть полностью заблокирован на следующей неделе. Сопровождение краулеров — постоянная инженерная статья расходов, а не разовая разработка.
- Моделирование частоты изменений. Разные источники обновляются с разной скоростью. На сайтах новостей о знаменитостях новые фотографии появляются каждый час, а личные профили в социальных сетях могут не меняться годами. Интеллектуальное планирование повторного обхода на основе исторической частоты изменений способно снизить затраты на трафик на 60–80%, сохраняя актуальность индекса там, где это важно. Без этого вы либо слишком часто обходите статичные источники, тратя трафик и деньги, либо слишком редко — динамические, выдавая устаревшие результаты.
- CDN и географические различия контента. Один URL может возвращать разные изображения в зависимости от местоположения, строки user-agent устройства или файлов cookie. Краулер может проиндексировать не то изображение, которое видит пользователь, что приводит к непонятным жалобам: «совпадение не похоже на результат». Некоторые CDN отдают миниатюры низкого разрешения, пока реальный браузер не прокрутит изображение в область просмотра. Необходимо обрабатывать эти крайние случаи либо принять определенный процент фантомных результатов.
- Рост стоимости хранения. Объем изображений растет линейно и никогда не перестает увеличиваться. Исходники нельзя удалять, если они могут понадобиться для повторного создания эмбеддингов. Миниатюры, метаданные, векторы эмбеддингов, файлы индексов, резервные копии. По мере зрелости системы счет за хранение растет все быстрее. Команды, заложившие бюджет на хранение первого года, бывают шокированы затратами третьего.
- Запросы о соответствии требованиям в большом масштабе. GDPR дает людям право требовать удаления своих данных. При поступлении запроса на отказ необходимо найти все эмбеддинги, созданные из лица этого человека во всей базе, удалить их, не допустить повторного добавления, когда краулеры снова найдут исходные изображения, и задокументировать удаление для аудита. В большом масштабе для этого нужны специализированные инструменты и инженерные ресурсы. [Регламент ЕС об ИИ](https://artificialintelligenceact.eu/) устанавливает дополнительные требования к системам ИИ высокого риска, включая распознавание лиц: обязательную оценку соответствия, тестирование на предвзятость, обязательства по прозрачности и механизмы человеческого контроля.
- Реализовать отказ сложнее, чем кажется. Нельзя просто удалить эмбеддинг: нужно предотвратить повторную индексацию, когда краулер снова встретит то же лицо. Для этого необходимо вести индекс «черного списка» эмбеддингов отказавшихся людей и проверять каждый новый эмбеддинг перед добавлением. Этот список должен быть быстрым, поскольку используется при каждой вставке, и создает собственные вопросы хранения данных: эмбеддинг лица отказавшегося человека приходится хранить постоянно, чтобы сопоставлять с ним новые данные. То есть биометрические данные сохраняются для выполнения запроса на их удаление. Это реальное юридическое противоречие, которое во многих юрисдикциях остается нерешенным.
- Проблема согласия при сборе общедоступных данных. Законное основание по GDPR для обработки биометрических данных из открытых профилей социальных сетей оспаривается в судах. Несколько европейских органов защиты данных уже вынесли решения против компаний, занимающихся распознаванием лиц, особенно в делах Clearview AI в ряде стран ЕС. Юридический риск зависит от юрисдикции, источника данных и сценария использования. Это не гипотетическая проблема будущего, а область активного правоприменения.
- Стоимость хранения аудиторских журналов. Если записывать каждый поисковый запрос и каждое возвращенное совпадение — чего могут требовать нормы соответствия, — аудиторские журналы способны расти быстрее самих данных лиц. Система, обрабатывающая 1 млн поисковых запросов в день с 10 результатами на каждый, ежедневно создает примерно 10 млн аудиторских записей. Требования к сроку хранения — часто от 1 до 7 лет в зависимости от юрисдикции — означают непрерывное накопление данных. Рассматривайте аудит как основную статью расходов на хранение, а не как второстепенную задачу.
- Реагирование на инциденты. Что произойдет, если система неверно сопоставит лицо и кто-то предпримет действия на основании ложного совпадения? Нужны аудиторские журналы, показывающие, как был получен каждый результат, возможность объяснить решение о совпадении и процедура рассмотрения споров. Когда кто-то оспаривает совпадение, объяснение «косинусное сходство составило 0,47 и превысило порог 0,42» не будет удовлетворительным. Такие методы, как GradCAM, могут показать, какие области лица определили совпадение, помогая разрешать споры и укреплять доверие. Это не просто хорошая инженерная практика: в некоторых юрисдикциях она может быть обязательной по закону.
- Устаревание моделей и зависимостей. Версии CUDA, Python, [ONNX Runtime](https://onnxruntime.ai/) и обновления операционной системы со временем меняются и могут незаметно нарушить конвейер инференса. Фиксация версий помогает, пока не понадобится установить исправление безопасности. На управление зависимостями и воспроизводимость среды уйдет удивительно много времени.
- Концентрация знаний в команде. Инженер, создавший уровень индексации FAISS, понимает логику шардирования. Инженер, настроивший краулеры, знает, какие сайты требуют особой обработки. Когда эти люди уходят — а в проекте длительностью 18–24 месяца смена сотрудников неизбежна, — критически важные знания уходят вместе с ними. Документация помогает, но никогда полностью не передает причины неочевидных решений.
Итоговая реальная стоимость
Для поисковой системы лиц веб-масштаба, выполняющей поиск в открытом интернете:
- Команда разработки: 3–5 старших инженеров на 12–24 месяца = 600 тыс.–2,5 млн долларов на зарплаты и накладные расходы
- Инфраструктура в первый год: 400 тыс.–1 млн долларов на облачные ресурсы или оборудование
- Текущая инфраструктура: 30–80 тыс. долларов в месяц, или 360–960 тыс. долларов в год
- Юридические вопросы и соответствие требованиям: 50–200 тыс. долларов на первоначальную оценку и последующие консультации
- Итого за первый год: 1,4–3,7 млн долларов
- Итого со второго года: 500 тыс.–1,2 млн долларов ежегодно на инфраструктуру и инженерное сопровождение
И это для системы, которая работает. Многие команды тратят 6–12 месяцев и более 500 тыс. долларов, прежде чем понимают, что задача сложнее ожидаемого, и переходят на решение через API.
Когда создавать свою систему, а когда использовать API
Создавайте собственную систему, если:
- У вас закрытый набор данных — пропуска сотрудников или фотографии клиентов — менее чем на 100 тыс. лиц
- Система должна работать локально или в изолированной сети
- У вас есть ML-инженеры, способные заниматься оптимизацией модели, настройкой порогов и крайними случаями
- Ваш сценарий — верификация 1: 1, а не поиск 1:N по интернету
- У вас есть бюджет и сроки для многолетнего инженерного проекта
Используйте API, если:
- Вам необходимо искать лица в открытом интернете — социальных сетях, новостях и на сайтах
- Вы не хотите создавать и сопровождать конвейер веб-скрапинга и индексации
- Результаты нужны сейчас, а не после 12–24 месяцев разработки
- Система должна учитывать новый контент, постоянно публикуемый в интернете
- Вы хотите, чтобы кто-то другой занимался соответствием GDPR, запросами на отказ и Регламентом ЕС об ИИ
- Вы хотите избежать первоначальных затрат на инфраструктуру и разработку свыше 1 млн долларов
- Поиск лиц не является основой вашего продукта, и инженерное время лучше потратить на сам продукт
API поиска лиц FaceCheck.id
Для разработчиков, которым нужен поиск лиц в открытом интернете без создания инфраструктуры с нуля, FaceCheck.id предлагает REST API, охватывающий весь конвейер: обнаружение, создание эмбеддинга и поиск по постоянно обновляемому индексу общедоступных изображений лиц из социальных сетей, новостных сайтов и интернета в целом.
FaceCheck.id использует собственную модель распознавания лиц, оптимизированную для поиска веб-масштаба. В отличие от моделей с открытым исходным кодом, которые пришлось бы самостоятельно развертывать и настраивать, их закрытая модель специально обучена и доработана для сложностей поиска лиц в интернете: крайне разного качества изображений, разнообразного освещения, демографического разнообразия и огромного масштаба постоянно обновляемого индекса. Собственный подход позволяет независимо улучшать модель и оптимизировать ее под конкретный поисковый конвейер способами, недоступными универсальным моделям с открытым исходным кодом. В систему вложены годы разработки, тестирования и совершенствования, позволившие достичь уровня, который было бы чрезвычайно сложно и дорого воспроизвести с нуля.
Что делает API:
Вы отправляете изображение лица, а API возвращает найденные в интернете совпадающие лица с оценками достоверности и URL источников. Сопоставление, индексация и инфраструктура веб-масштаба находятся на стороне сервиса. Все описанные выше кластеры GPU, конвейеры краулинга, инфраструктура векторного поиска, инструменты соответствия требованиям и постоянное обслуживание — их проблема, а не ваша.
Основные сведения об API:
- RESTful API с JSON
- Аутентификация по ключу API
- Передача изображения в кодировке base64 или URL изображения
- Возвращает массив совпадений с оценками сходства, URL источников и миниатюрами
- Ограничения частоты запросов и цена масштабируются в зависимости от использования
Типичная интеграция:
import requests
import time

def search_by_face(image_file):
    site = "https://facecheck.id"
    headers = {
        "accept": "application/json",
        "Authorization": APITOKEN
    }

    # Step 1: upload image
    with open(image_file, "rb") as f:
        files = {"images": f}
        upload = requests.post(f"{site}/api/upload_pic", headers=headers, files=files).json()

    if upload["error"]:
        return upload["error"], None

    search_id = upload["id_search"]

    # Step 2: keep checking until results are ready
    while True:
        result = requests.post(
            f"{site}/api/search",
            headers=headers,
            json={"id_search": search_id}
        ).json()

        if result["error"]:
            return result["error"], None

        if result.get("output"):
            return None, result["output"]["items"]

        time.sleep(1)
Сценарии использования API:
- Верификация в приложениях для знакомств: позвольте пользователям проверять, встречаются ли фотографии совпадения в настоящих профилях социальных сетей
- Защита бренда: проверяйте, не использует ли кто-либо фотографии вашей команды для поддельных деловых профилей
- Платформы комплексной проверки: добавьте поиск по лицу в процедуры проверки биографии или KYC
- Системы борьбы с мошенничеством: отмечайте учетные записи, использующие фотографии, которые встречаются в интернете под другими именами
- Инструменты OSINT: создавайте инструменты расследования с сопоставлением лиц в веб-масштабе
Почему стоит использовать это вместо собственной разработки:
Создание поисковой системы лиц для открытого интернета требует: (1) конвейера краулинга веб-масштаба, обнаруживающего и загружающего миллиарды изображений, (2) инфраструктуры GPU стоимостью в сотни тысяч долларов для обнаружения лиц и извлечения эмбеддингов, (3) распределенной системы векторного поиска с терабайтами RAM для запросов ко всему индексу в реальном времени, (4) постоянного повторного обхода для поддержания актуальности индекса, (5) инфраструктуры соответствия требованиям для отказов, запросов на удаление данных и нормативных обязательств, (6) команды из 3–5 инженеров, постоянно занимающихся сопровождением, и (7) 12–24 месяцев до выпуска первой пригодной версии. Это многомиллионный инженерный проект со значительными постоянными расходами. API на основе собственной модели FaceCheck.id и проверенной в эксплуатации инфраструктуры предоставляет все это одним HTTP-запросом.
Рассмотренные выше модели с открытым исходным кодом отлично подходят для закрытых систем распознавания лиц: контроля доступа сотрудников, организации фотобиблиотек и собственных процедур верификации. Но если ваш сценарий звучит как «найти в интернете, где встречается это лицо», инженерный разрыв между работающей моделью и работающим продуктом огромен. API FaceCheck.id устраняет этот разрыв, позволяя выпустить работающий продукт за несколько дней, а не лет.
Начало работы: посетите facecheck.id/en/Face-Search/API, чтобы ознакомиться с документацией, ценами и зарегистрировать ключ API.
Часто задаваемые вопросы
Какая модель распознавания лиц с открытым исходным кодом наиболее точна?
FaceNet512 с базовой сетью Inception-ResNet-v2 в настоящее время показывает отличные результаты в большинстве тестов, включая 99,65% на LFW. Для изображений низкого качества — наблюдения и CCTV — AdaFace лучше работает в сложных тестах вроде IJB-C, достигая TAR@FAR=1e-4 на уровне 97,39%.
Можно ли использовать модели распознавания лиц с открытым исходным кодом в коммерческих целях?
Да. FaceNet512, FaceNet, DeepFace, dlib и AdaFace выпущены под разрешительными лицензиями — MIT или Boost. Их можно использовать в коммерческих продуктах. Однако учитывайте юридические ограничения на обработку биометрических данных в вашей юрисдикции — GDPR, BIPA, Регламент ЕС об ИИ, — которые действуют независимо от лицензии программного обеспечения.
Сколько данных нужно для обучения собственной модели распознавания лиц?
Обучать модель с нуля не требуется. Перечисленные выше предварительно обученные модели были обучены на наборах из 5–12 млн изображений, охватывающих 100–500 тыс. личностей. Используйте эти модели и дообучайте их только при наличии специфической предметной задачи. Для дообучения обычно требуется 10–100 тыс. изображений. Обучение с нуля требует миллионов изображений и значительных ресурсов GPU.
Чем верификация лица отличается от поиска по лицу?
Верификация лица 1:1 отвечает на вопрос «на этих двух фотографиях один и тот же человек?», напрямую сравнивая два эмбеддинга. Поиск по лицу 1:N отвечает на вопрос «где встречается этот человек?», сравнивая один эмбеддинг с базой из миллионов записей. Верификация вычислительно проста. Для поиска необходима эффективная индексация ближайших соседей — FAISS, Milvus, — а для поиска веб-масштаба еще и огромная инфраструктура краулинга и индексации, создание и эксплуатация которой могут стоить миллионы.
Насколько точно распознаются лица на изображениях низкого качества?
С ухудшением качества изображения точность значительно снижается. На четких фотографиях анфас современные модели достигают точности более 99%. На размытых записях наблюдения или фотографиях, где ширина лица меньше 50 пикселей, точность может упасть до 80–90% и ниже. AdaFace специально разработана для лучшей обработки различий в качестве по сравнению со стандартными моделями. Для любой системы входные изображения более высокого разрешения дают значительно лучшие результаты. Поза также важна: точность для лиц в профиль может быть на 10–20% ниже, чем для лиц анфас, даже на изображениях высокого разрешения.
Сколько стоит создать поисковую систему лиц?
Для системы веб-масштаба, выполняющей поиск по открытому интернету, следует ожидать затрат в 1,4–3,7 млн долларов в первый год — команда разработчиков, инфраструктура и юридические расходы — и затем по 500 тыс.–1,2 млн долларов ежегодно. Для закрытой системы, выполняющей поиск по частной базе менее чем из 100 тыс. лиц, затраты значительно ниже: достаточно одного сервера с GPU и одного инженера. Стоимость зависит от размера поисковой базы и необходимости обходить интернет для ее наполнения.
Сколько времени занимает создание промышленной системы распознавания лиц?
Для простой системы верификации — сопоставления 1:1 с известной базой — опытный инженер может создать рабочий прототип за 1–2 недели и подготовить его к промышленной эксплуатации за 1–3 месяца. Для системы поиска лиц веб-масштаба — 1:N по интернету — потребуется 12–24 месяца работы команды из 3–5 инженеров, прежде чем решение станет достаточно надежным для промышленной эксплуатации. Краулинг, масштабирование и соответствие требованиям требуют огромного количества времени сверх основной работы с машинным обучением.
Создавайте то, что имеет значение. Для закрытой системы начните с FaceNet512. Но если вам нужен поиск лиц веб-масштаба, спросите себя: действительно ли вы хотите потратить 1,4–3,7 млн долларов, нанять команду старших инженеров и ждать 12–24 месяца до первого пригодного результата? Вместо этого можно полностью обойтись без кластеров GPU, кошмаров краулинга, сложностей соответствия требованиям и многолетней разработки, получить первые результаты поиска менее чем за 5 минут и начать всего с 1 доллара США благодаря API FaceCheck.id.
Читать далее о поиске по лицу
Бесплатные альтернативы PimEyes, которые действительно работают (2026)
PimEyes берёт 30 долларов в месяц и всё равно пропускает совпадения. Мы протестировали все бесплатные инструменты поиска по лицу в 2026 году и составили рейтинг по точности, скорости и охвату. FaceCheck.id занял первое место в поиске настоящих профилей в социальных сетях, а не только стоковых фотографий.
На тему на других языках
 Face Recognition Systems: How They Work, Best Open Source Models, and Production APIs
 Sistemas de reconhecimento facial: como funcionam, os melhores modelos de código aberto e APIs de produção
 人脸识别系统:工作原理、最佳开源模型与生产级 API
 Systémy rozpoznávání obličejů: Jak fungují, nejlepší open source modely a produkční API
 Gesichtserkennungssysteme: Funktionsweise, beste Open-Source-Modelle und produktionsreife APIs
 Sistemas de reconocimiento facial: cómo funcionan, los mejores modelos de código abierto y las API de producción
 Systèmes de reconnaissance faciale : fonctionnement, meilleurs modèles open source et API de production
 Sistemi di riconoscimento facciale: come funzionano, i migliori modelli open source e le API di produzione
 顔認識システム:仕組み、最良のオープンソースモデル、本番環境向けAPI
 얼굴 인식 시스템: 작동 원리, 최고의 오픈 소스 모델 및 프로덕션 API
 Systemy rozpoznawania twarzy: jak działają, najlepsze modele open source i produkcyjne API
 أنظمة التعرّف على الوجوه: كيف تعمل، وأفضل النماذج مفتوحة المصدر، وواجهات API الجاهزة للإنتاج
 Yüz Tanıma Sistemleri: Nasıl Çalışırlar, En İyi Açık Kaynak Modeller ve Üretim API'leri
Популярные темы
Дипфейк Идентичность Распознавание Лиц Facebook Instagram Профили В Социальных Сетях Поиск Лиц Поиск По Лицу Двойник Биометрический Поиск ЛицаЛучшие поисковые системы обратного поиска изображений: обзор PimEyes vs FaceCheck